


来源:空间视觉与三维建模
文章链接:https://mp.weixin.qq.com/s/xbTBlvqXUYFI5YTnwfelFg
✨导读: All-in-One Image Restoration希望一个模型同时处理去噪、去雨、去雾、去模糊和低照度增强,但现有Prompt-based方法通常给整张图使用同一个Global Prompt。当不同区域存在不同退化、甚至多种退化同时出现时,这种Image-level Guidance就显得过于粗糙。QuReC把Prompt进一步下沉到每个Spatial Query:先让每个位置自己匹配Degradation Prototype,再通过Local-Global Response Calibration决定该从局部细节还是全局上下文中取信息,从而实现更细粒度的统一图像恢复。
作者: Shen Zhou, Jinghui Zhang, Wenbo Huang, Xuwei Qian, Zhen Wu, Guangwen Peng, Zhiyuan Li, Ding Ding, Dian Shen, Fang Dong 单位: Southeast University;Hainan University 论文标题: QuReC: All-in-One Image Restoration with Query-Specific Guidance and Local-Global Response Calibration 发表信息: ACM Multimedia 2026 Paper: https://arxiv.org/pdf/2607.15097Code: https://github.com/zhoushen1/QuReC
? 1 Introduction|同一张图不同地方“坏得不一样”,为什么还要共用一个Prompt?
Image Restoration希望从Noise、Rain、Haze、Blur、Low-light等退化图像中恢复Clean Image。传统方法通常针对单一任务分别训练Denoising、Deraining或Dehazing模型,但真实环境中的退化类型并不固定,甚至会同时出现,因此近年来越来越多工作开始研究 All-in-One Image Restoration(AiOIR):只训练一个统一模型,同时处理多种退化。
PromptIR、InstructIR等方法进一步引入Degradation Prompt,让同一个Backbone根据输入退化类型动态调整恢复策略。但作者认为,现有Prompt-based方法依然存在两个核心问题:
整张图共用一个Prompt太粗: 真实退化往往具有Spatial Heterogeneity,例如图像一部分受到Rain影响,另一部分可能同时存在Haze或Low-light。如果所有Pixel共享同一个Degradation Representation,就无法针对不同区域进行差异化恢复。
知道“这里是什么退化”还不够: Image Restoration不仅要识别退化,还要决定当前Pixel应该从哪里获取恢复信息。Fine Texture更多依赖Local Neighborhood,而结构、颜色和大范围照明又需要Global Context。如果Local / Global Aggregation本身由受损Feature决定,同样可能产生不可靠响应。
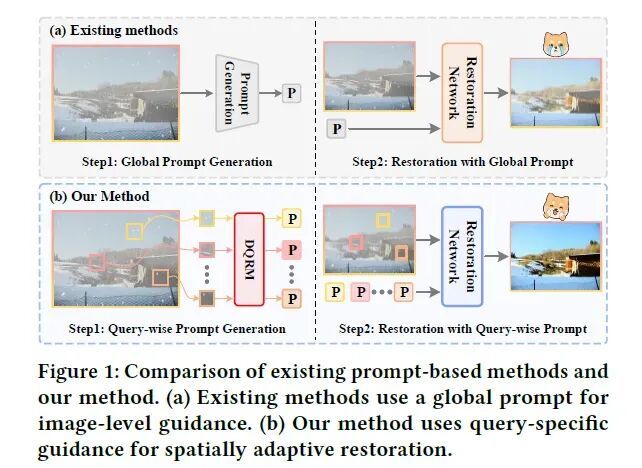
因此QuReC把问题拆成两个非常清楚的步骤:
DQRM解决“这个位置到底是什么退化?”
LGRCM解决“知道退化以后,这个位置应该怎样从Local和Global Feature中取信息?”
? 2 Related Work|All-in-One Restoration已经有Prompt和MoE,为什么还需要Query-level Guidance?
Single-Task Image Restoration|一个任务一个模型,精度高但不够通用
Denoising、Deraining、Deblurring、Dehazing和Low-light Enhancement已经分别发展出大量CNN和Transformer方法,Restormer、Uformer、SwinIR等都能在特定任务中取得很强表现。但这些模型往往围绕固定退化分布优化,一旦退化类型变化,就需要重新训练或切换模型。
All-in-One Image Restoration|真正难的不是“一个模型做五件事”,而是模型怎样知道当前该做什么
AirNet通过Contrastive Learning学习Degradation Representation,PromptIR利用Visual Prompt指导统一恢复,InstructIR进一步使用Text Instruction,MoCE-IR则通过Mixture-of-Experts为不同Case选择不同Expert。
这些方法已经证明:显式告诉模型“当前退化是什么”,通常比让Backbone自己隐式猜测更有效。
但它们的Degradation Guidance大多仍然是Image-level Shared Signal。QuReC真正进一步推进的地方,是把“整张图一个Prompt”改成:
每个Spatial Query都有自己的Degradation Representation。
这使模型开始具备处理Spatially-varying和Mixed Degradation的能力。
⚙️ 3 Method|先让每个位置自己判断退化,再决定该看局部还是全局
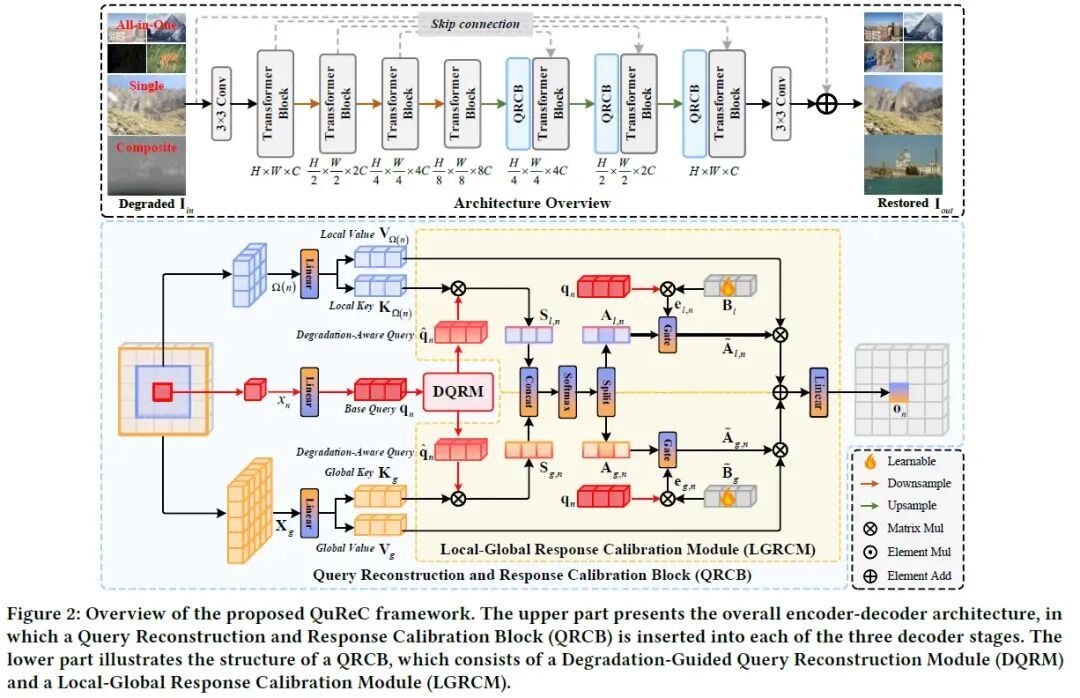
QuReC采用一个四阶段非对称Encoder-Decoder。输入退化图像首先经过 Convolution和多层Transformer Encoder逐步提取Compact Representation;Decoder则在三个不同Resolution Stage中插入 Query Reconstruction and Response Calibration Block(QRCB)。每个QRCB内部由DQRM和LGRCM组成:DQRM让每个Spatial Query从Degradation Prototype Bank中匹配当前最相关的退化语义,并重建Query-specific Representation;LGRCM再以该Query为中心,同时聚合Local Detail和Global Context,并通过Learnable Prior对Attention Response进行校准。因此整个恢复过程实际上遵循“先判断每个位置需要修什么,再决定从哪里找恢复信息”的两阶段逻辑。
3.1 Overall Pipeline|为什么QRCB要放在Decoder里逐级恢复?
Encoder负责从Degraded Image中提取越来越抽象的Feature,而真正的Image Reconstruction主要发生在Decoder阶段。QuReC因此没有在输入端只做一次Degradation Classification,而是在三个逐渐恢复Spatial Resolution的Decoder Stage中重复执行QRCB。
这样低分辨率阶段可以先恢复Global Structure,随着Resolution提高,再逐渐处理更加细粒度的Spatial Degradation。
每个QRCB的基本流程可以理解成:
Feature
→ DQRM:Query-specific Degradation Matching
→ LGRCM:Local / Global Response Aggregation
→ Calibrated Restoration Feature
3.2 Degradation-Guided Query Reconstruction Module|为什么不是“一张图匹配一种退化”,而是“每个Query自己匹配”?
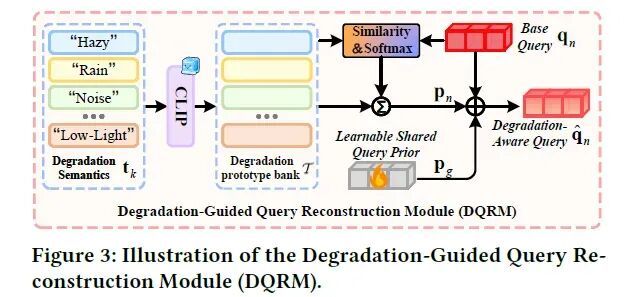
DQRM首先构建一个Degradation Prototype Bank:
其中表示第种Degradation Prototype。
这些Prototype并不是完全随机学习,而是先根据Training Setting构造不同Degradation Description,再通过Frozen CLIP Text Encoder得到对应Embedding。
对于第个Spatial Feature ,首先投影到Prototype Matching Space:
随后计算该Query与所有Degradation Prototypes之间的相似度,并进行Soft Matching:
这里并不是简单选一个最大概率的Prototype,而是根据Similarity对多个Prototype进行Soft Aggregation。因此在Mixed Degradation Region中,一个Query可以同时吸收多个退化语义。
随后:
得到该Spatial Location专属的Degradation Prompt。
作者还额外引入一个所有位置共享的Learnable Query Prior ,最终Query写成:
这里三项职责很清楚:
:当前Pixel本身的Feature
:这个位置对应的Degradation-specific信息
:跨任务共享的稳定Anchor
? QuReC真正把Prompt从“Image-level Task Label”变成了“Spatial Query的组成部分”。不同位置可以拥有完全不同的Degradation Awareness。
Weakly Supervised Prototype Matching|每个Query都自由选Prototype,会不会最后全部选同一个?
这是DQRM必须解决的另一个问题。
由于数据中没有Token-level Degradation Annotation,作者不能直接告诉某个Pixel“你这里一定是Rain”。如果只依赖最终Restoration Loss进行End-to-End Optimization,很容易出现 Prototype Collapse:大量Query全部集中匹配到少数几个Prototype。
因此作者加入Mixed Load Balancing Loss,同时约束Soft Usage和Hard Assignment:
Soft Term避免Probability Distribution长期偏向少数Prototype,Hard Term则进一步约束实际Argmax Assignment。
但“使用得均匀”并不意味着“语义正确”。因此作者继续利用Image-level Degradation Label构造Weak Supervision。例如一张图同时含Rain和Haze,就只要求整张图的平均Prototype Distribution主要落在Rain / Haze对应Prototype上,而不会规定每个Pixel具体是哪一种。
最终:
因此这里非常巧妙:
Image-level Label只负责“别选错大方向”,真正每个Pixel怎么分配,仍然交给Query自己决定。
3.3 Local-Global Response Calibration Module|知道“是什么退化”以后,为什么还要重新校准Attention?
DQRM已经解决了Degradation Awareness,但Restoration仍然需要从周围Feature中恢复丢失内容。
对于第个Query,LGRCM同时构建两条Branch:
Local Branch: 只看以当前位置为中心的 Window;
Global Branch: 在Spatially Reduced Global Sequence上寻找Long-range Context。
利用DQRM生成的分别计算:
与普通双Branch Attention不同,QuReC没有分别进行两个Softmax,而是先Concat:
这意味着Local和Global不是各自独立产生一套Attention后再相加,而是在同一个Probability Space里竞争。
如果当前任务是Denoising、Fine Texture比较重要,Local Branch可以获得更多Weight;如果是Haze或Large Blur等需要Global Structure的信息,Global Branch则可以获得更大响应。
Prior Calibration|Attention本身也是从退化Feature算出来的,凭什么完全相信它?
这又是QuReC比较细的一层设计。
即使Local / Global Attention已经根据Degradation Query动态计算,它们仍然来自受损Feature,因此Attention Weight本身也可能错。
作者因此额外设计两个Learnable Prior Banks:
值得注意的是,这里不使用带Degradation Prompt的检索Prior,而是重新使用原始Base Query :
这样做相当于刻意把两个角色拆开:
负责Degradation-aware Matching
负责检索Task-agnostic Structural Prior
随后利用有界Gate校准Attention Response:
最终:
? LGRCM最值得注意的不是“Local + Global”本身,而是它先让两种Context在Shared Softmax里竞争,再用独立Structural Prior进行二次校准。它解决的是“Attention知道该看哪里,但这个判断本身是否可靠”的问题。
? 4 Experiments|一个模型同时去噪、去雨、去雾、去模糊、提亮,真的不会互相干扰吗?
? 4.1 Experimental Settings
实验覆盖Denoising、Deraining、Dehazing、Deblurring和Low-light Enhancement五类任务,对应使用BSD68、Rain100L、SOTS、GoPro和LOL等Benchmark;同时还在CDD11上测试Low、Haze、Rain、Snow以及多种组合退化。
作者分别设置了三类实验:
Single-degradation
All-in-One
Composite Degradation
所有模型统一训练150 Epoch,并使用PSNR / SSIM作为主要评价指标。
4.2 和SOTA方法对比|任务越多,Query-specific Guidance的优势反而越明显
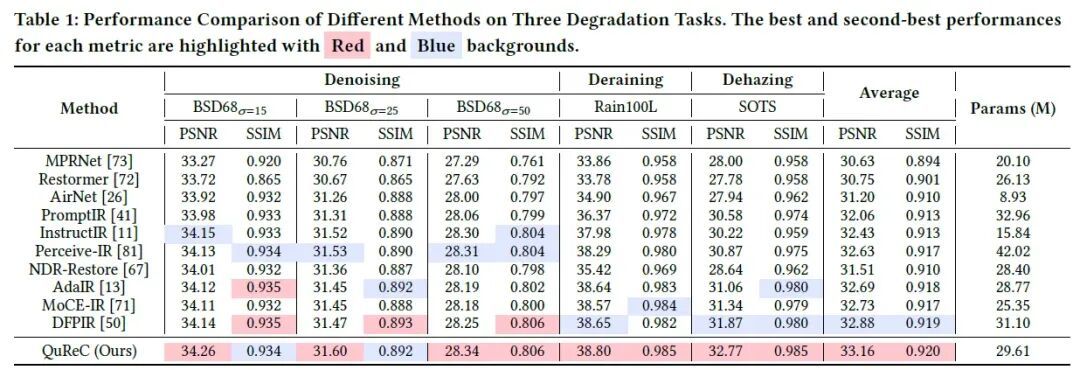
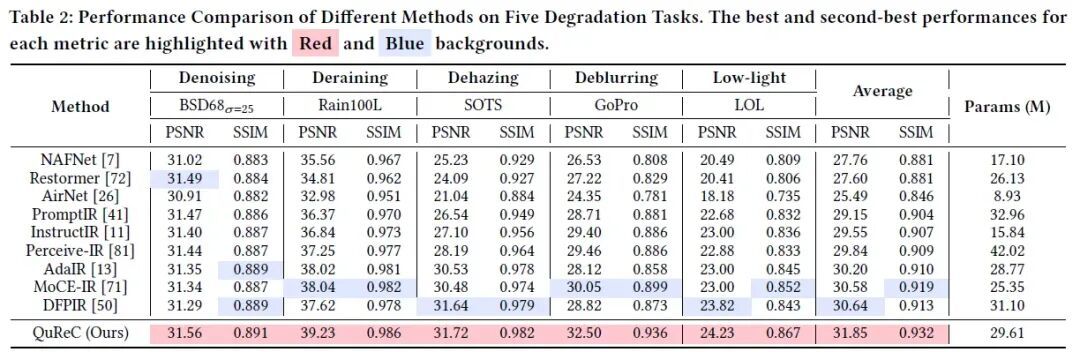
在三任务设置下,QuReC在Denoising、Deraining和Dehazing之间保持更均衡的表现;进一步扩大到Denoising、Rain、Haze、Blur和Low-light五任务后,QuReC仍然取得最强Overall结果,而且相比现有Prompt-based与MoE-based方法优势更加明显。
这一现象与论文Motivation非常一致:任务越多、退化差异越大,一个Image-level Global Prompt越难覆盖所有Spatial Query;Query-specific Guidance的价值反而更加突出。
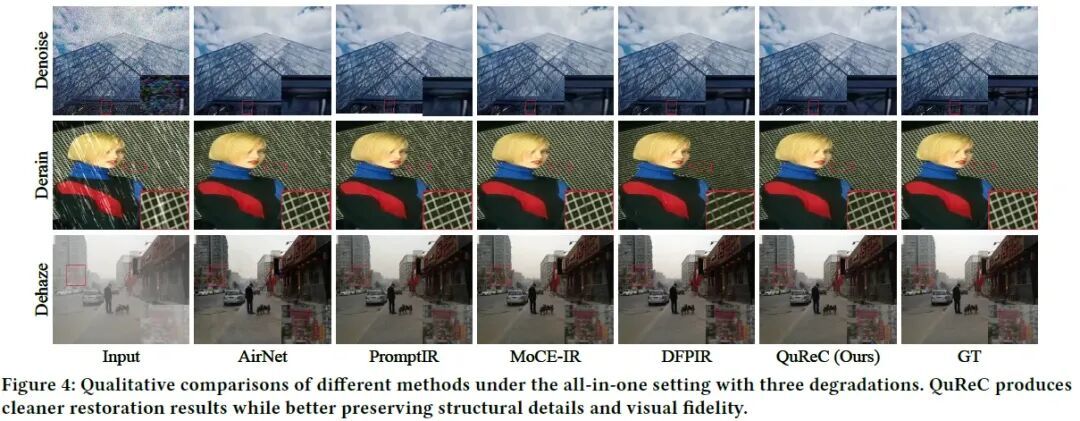
Figure 4中可以重点观察Fine Edge与Texture。部分方法在去噪时残留Noise或产生Oversmoothing,在去雨时容易损伤原本的Grid Texture,在Dehazing时远处Scene Contrast恢复不足;QuReC在去除退化和保留Structure之间更加稳定。
Composite Degradation|同一张图同时有多种退化,才是真正检验Query-level Prompt的场景
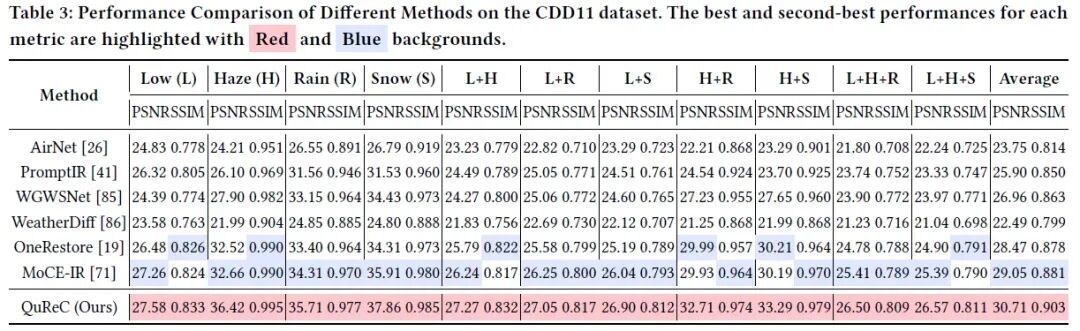
CDD11包含Low、Haze、Rain、Snow以及L+H、L+R、H+S、L+H+R等11种组合。QuReC在全部11种Setting中保持领先,尤其在Haze与其他退化叠加时优势更加明显。
这组实验实际上比普通All-in-One Benchmark更加重要,因为它真正对应了DQRM提出时的核心假设:
一张图不一定只有一种统一退化,甚至不同位置可能对应完全不同的Restoration Requirement。
? 4.3 Ablation Study|DQRM和LGRCM到底谁更重要?
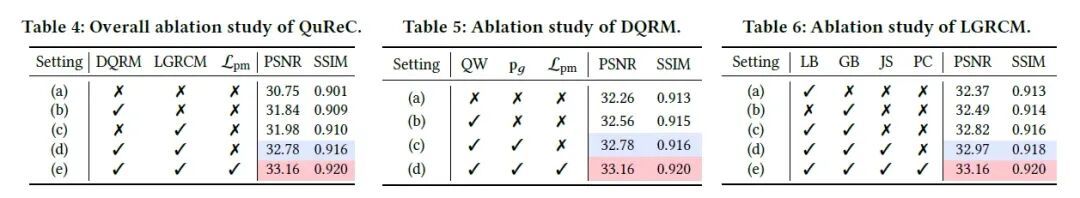
完整Ablation呈现出非常清晰的递进关系。
只加入DQRM,就能明显改善Baseline,说明“每个位置使用自己的Degradation Query”本身有效;只加入LGRCM同样可以获得较明显收益,说明Local / Global Aggregation Reliability也是All-in-One Restoration的重要问题。
两者同时加入后进一步提升,说明:
DQRM负责“What to restore”
LGRCM负责“How to gather information”
两者属于互补关系。
最后再加入后达到最佳结果,说明如果没有Stable Prototype Matching,Query-wise Guidance的能力无法被充分发挥。
DQRM消融|为什么还需要Shared Query Prior和Weak Supervision?
将Image-level Prompt改为Query-wise Prompt已经能够带来提升;加入Shared Prior 后进一步改善,说明完全依赖Local Prototype Matching会受到Noise影响,需要一个Task-general Anchor稳定Query Formation。
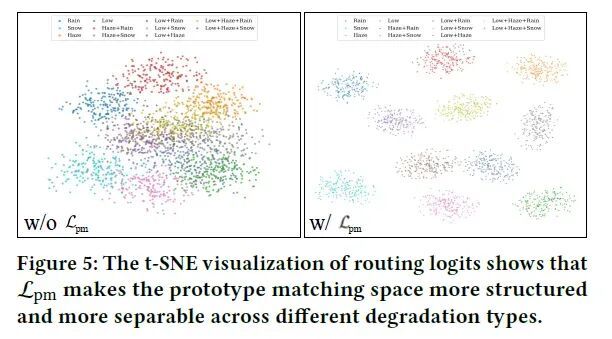
Figure 5的t-SNE更直观:没有时,不同Degradation的Routing Logits混在一起;加入以后,不同退化逐渐形成更加清晰的Cluster。
这说明Weak Supervision并不是为了直接做Degradation Classification,而是让Prototype Space拥有更加稳定的语义结构。
LGRCM消融|只看Local或只看Global为什么都不够?
单独使用Local Branch或Global Branch都能恢复一定信息,但两者组合后性能进一步提升,说明Fine Detail和Long-range Context确实互补。
继续加入Joint Softmax以后再次改善,因为Local与Global开始在一个统一Attention Space中动态竞争;最后加入Prior Calibration达到最佳结果,说明Degraded Feature直接计算出的Attention仍然存在不稳定性,需要额外Structural Prior进行校正。
? 整个消融其实验证了一条很完整的逻辑:先把“一个Prompt管整张图”拆成Query-level Degradation Matching,再把“普通Attention直接聚合”拆成Local-Global Competition + Prior Calibration。QuReC不是单独换一个Prompt,而是同时改了Guidance和Feature Aggregation两端。
? 5 Conclusion|All-in-One Restoration真正需要的,也许不是“一个更强的Prompt”,而是“每个位置都有自己的Prompt”
QuReC重新思考了Prompt在统一图像恢复中的粒度。现有方法通常先判断整张图的退化类型,再使用同一Guidance处理所有区域;QuReC则让每个Spatial Query独立匹配Degradation Prototype,从而构建Query-specific Degradation Representation。
在此基础上,LGRCM进一步让Local Detail和Global Context动态竞争,并利用Learnable Prior校准Attention Response,使不同区域能够根据自身退化状态选择不同的信息来源。
? 最值得带走的一点:当输入中的退化本身具有空间异质性时,“先判断整张图是什么任务”这个前提就已经过于粗糙。QuReC真正有价值的地方,是把All-in-One Restoration从Task-level Adaptation进一步推进到Query-level Adaptation——不再问“这张图该用哪个恢复策略”,而是问“这个位置此刻到底需要什么”。
