来源:公众号“AI上分搭子”
原文链接:https://mp.weixin.qq.com/s/M8hMiiMzQeIcRwwPe7eZ3Q
Dense Video Object Captioning,简称 DVOC。
它想做的事很细:
这篇 CVPR 2026 论文走了一条很干净的路线。
先造数据。
作者用 Gemini 2.0 Flash 给 LVIS 和 LV-VIS 生成 object-level captions,得到两个新数据集:LVISCap和LV-VISCap。
再训模型。
CaptionFormer 用 OVFormer / Mask2Former 做 clip-level segmentation,再把同一个物体在多个片段里的 query 聚合起来,交给 BLIP-2 风格的 captioning head。
结果也比较清楚:
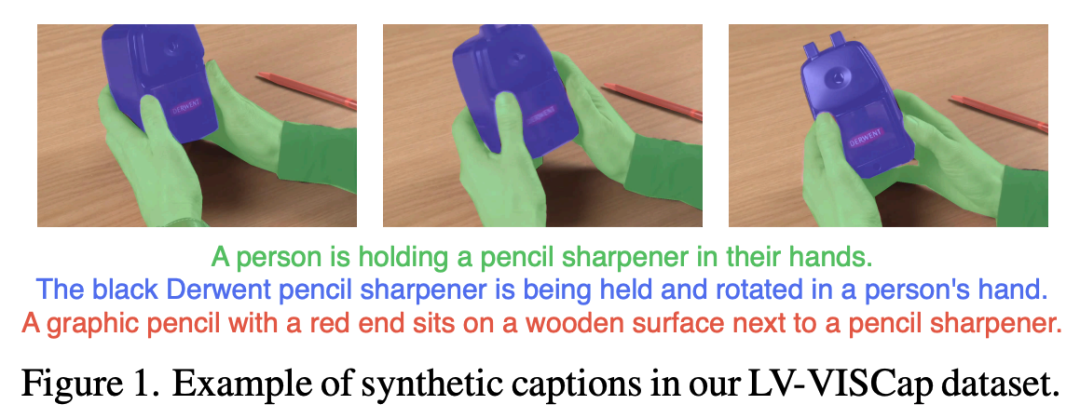
普通的视频检测任务,大多回答:
画面里有什么?
Tracking 再多问一句:
这个物体下一帧去哪了?
DVOC 要求更细。
它希望模型对视频里的每个物体都交出一份“小报告”:
比如一个人拿着削笔刀,模型不能只说“person”。
它最好能描述:
一个人正用手拿着并转动一个黑色削笔刀。
听起来只是多一句话。
但训练时会很贵。
因为每个视频都有多个物体,每个物体又跨越多个时间点。要给这些轨迹逐条写 caption,人工标注成本会迅速爆炸。
已有方法通常绕着走:
能跑。
但监督信号没有真正合在一起。
CaptionFormer 抓住的,就是这个数据缺口。
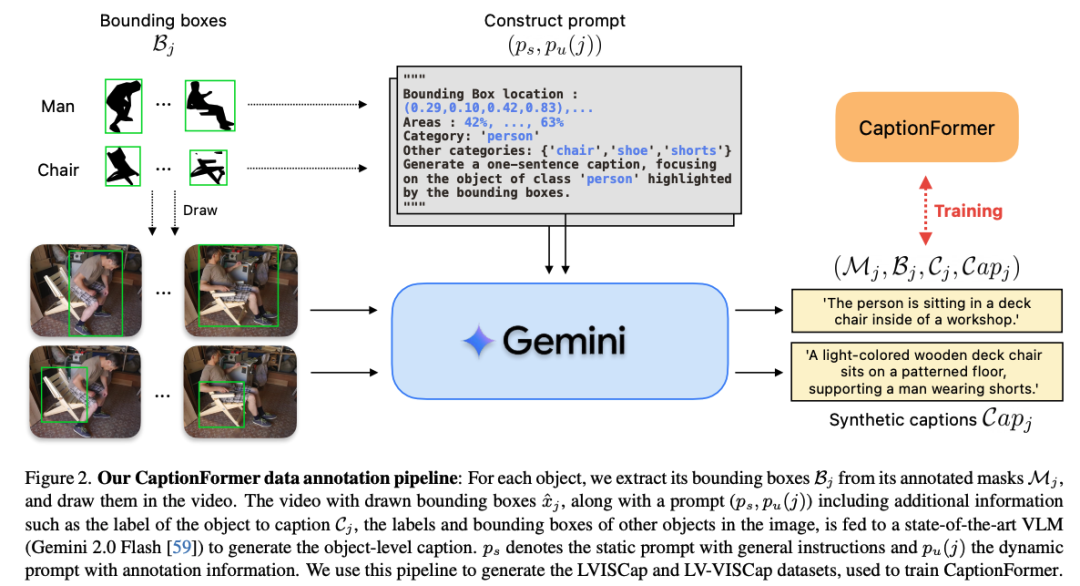
Figure 2 是这篇论文最值得先看的图。
它讲数据怎么来。
LVIS 和 LV-VIS 本来就有物体 mask、box 和 category。
缺的是 caption。
作者没有从零人工写 caption,而是把已有标注转成一个 VLM 能理解的问题:
请描述这个被框出来的物体。
做法并不绕。
先从 mask 提取 bounding box。
再把目标物体的 box 画到视频帧上。
然后把这些信息写进 prompt:
最后送给 Gemini 2.0 Flash,生成 object-level caption。
这样一来,原来的 segmentation 数据集被扩展成 DVOC 训练集:
这一步把问题换了一个形态:不再死磕昂贵人工标注,而是想办法稳定地产生细粒度监督。
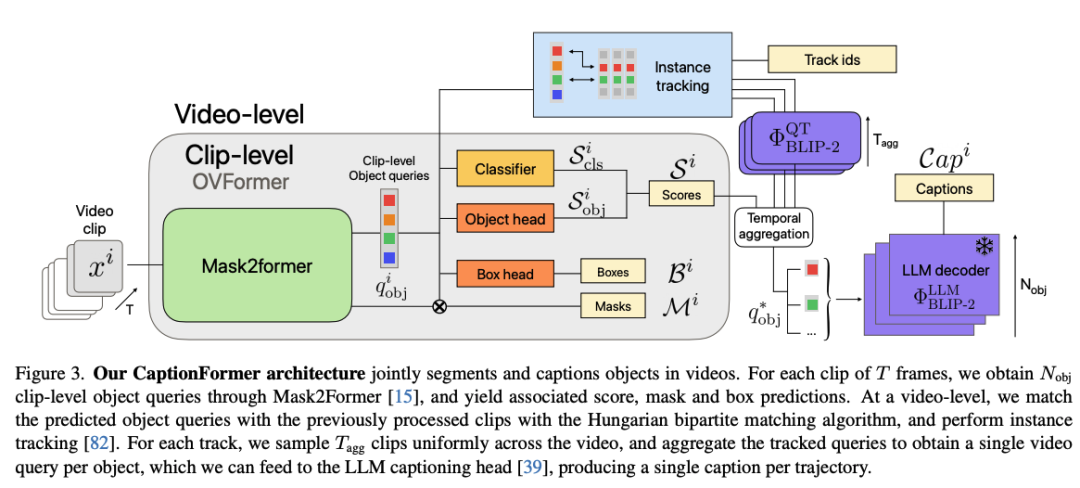
Figure 3 是方法图。
CaptionFormer 大致分三段。
第一段:clip-level 视觉理解
视频被切成若干 clip。
每个 clip 先经过 OVFormer / Mask2Former,输出 object queries。
这些 query 会对应:
第二段:跨 clip 跟踪
同一个物体会出现在不同 clip 里。
模型用 Hungarian matching 做 query matching,把这些片段接成轨迹。
这一步让模型能处理“物体消失又出现”的情况。
第三段:给轨迹写 caption
对每条物体轨迹,CaptionFormer 会从多个 clip 里取 query。
再做 temporal aggregation。
最后把聚合后的 video-level query 送到 BLIP-2 风格的 LLM decoder,生成一句 caption。
最后输出的是:
一条物体轨迹 + mask / box + caption。
DVOC 需要的几件事,在同一个模型里接上了。
这里保留三条公式。
不用细抠符号,看它们分别在做什么就够了。
- 把 mask 变成 VLM 能看的视觉提示
意思是:
第个物体的 bounding box 被画到第帧上。
VLM 看到的不是原始视频,而是“这个框里的物体”。
- 把多个 clip 的 query 聚合成一条轨迹表示
同一个物体在不同 clip 里会有不同 query。
CaptionFormer 用检测分数做权重,把它们汇总起来。
这就是 temporal aggregation。
- 训练时把视觉和语言监督放在一起
这里不用纠结某个 loss 的细节。
关键在于,captioning loss 也会回到 object query 上。
这让 caption 监督不只是最后接一个文字生成头,而是参与塑造物体表示。
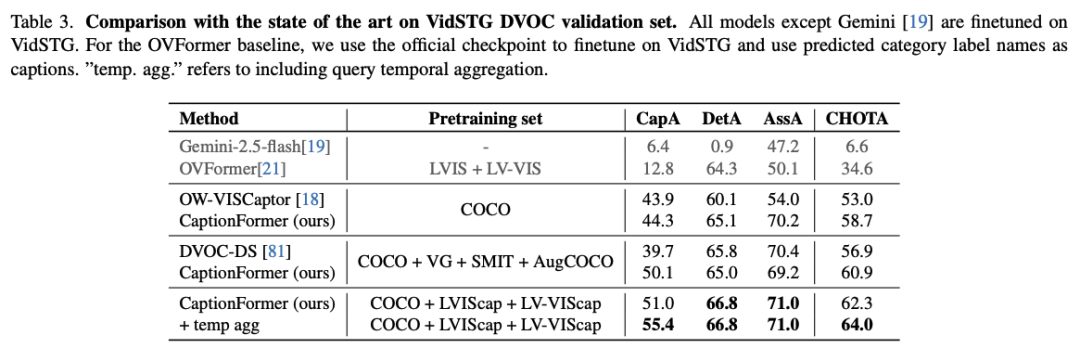
Table 3 是 VidSTG 上的主结果。
先看几组数字。
VidSTG 里,CapA 的提升尤其明显。
synthetic object captions 不是装饰性的文字补丁,它补的是 DVOC 最缺的监督。
再看 VLN。
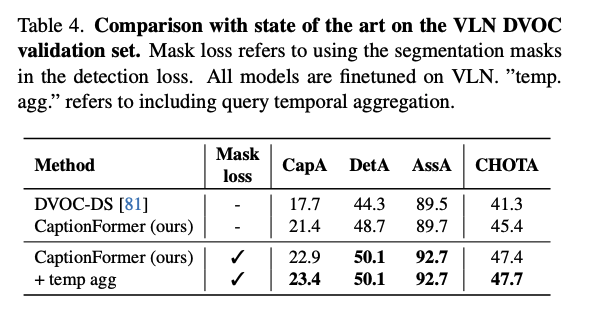
这张表还有一个细节。
加入 mask loss 后,DetA 从 48.7 到 50.1,AssA 从 89.7 到 92.7。
也就是说,把 DVOC 从 box 扩展到 segmentation mask,不只是形式上更细,指标也受益。
BenSMOT 上看 CIDEr。
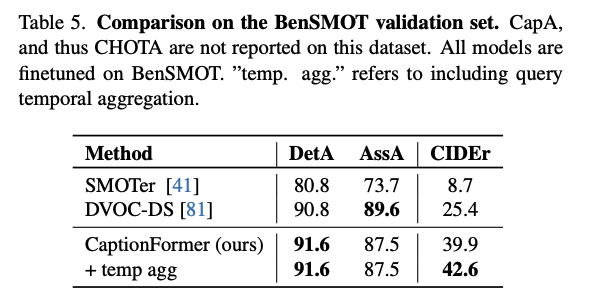
BenSMOT 主要关注人。
CaptionFormer 在这里的 CIDEr 提升很大,说明它对“物体轨迹描述”本身更有优势。
还有一个实际成本信息也值得留意。
作者写到,相比 DVOC-DS 的2032 GPU hours,他们的方法对应208 GPU hours。
如果这个数字在复现中能站住,CaptionFormer 不只是效果更好,也更容易被后续工作拿来用。
Ablation 部分可以看四个地方。
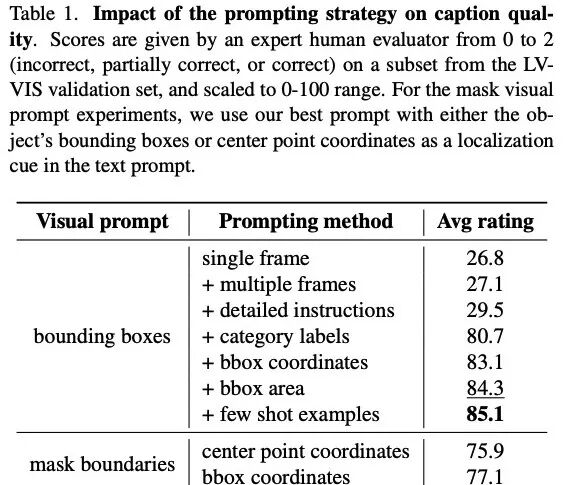
Table 1 很直观。
只给单帧或多帧,人工评分只有26.8 / 27.1。
加入 category labels 后,直接到80.7。
再加 bbox coordinates、bbox area 和 few-shot examples,最终到85.1。
这个差距很说明问题。
VLM 本身很强,但它不会自动知道你到底想描述哪个物体。
框、类别、面积、上下文,这些提示都在帮模型把注意力落到目标轨迹上。
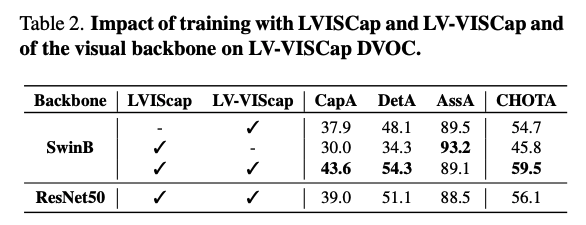
SwinB 设置下:
图像数据给规模。
视频数据给时间和轨迹语境。
两者合起来,模型表现最好。
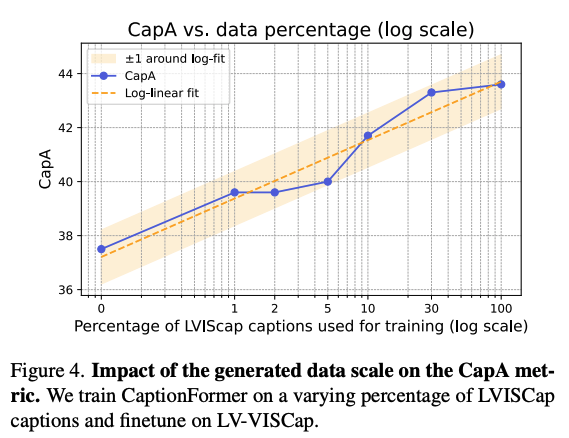
Figure 4 显示,CapA 和 LVISCap captions 数量呈 log-linear 相关。
换成更直白的话:
继续生成更多 caption,可能还有提升空间。
当然,前提是 caption 质量不能塌。
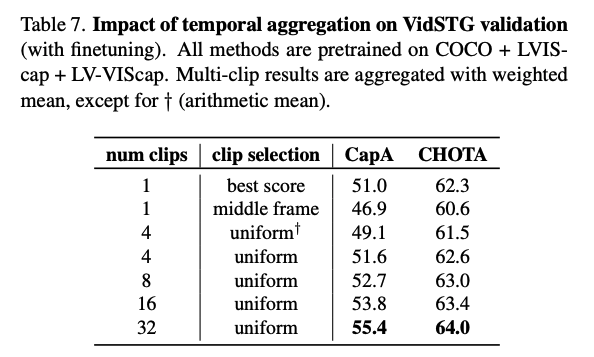
视频里的动作通常不是一帧能讲完的。
多个 clip 聚合后,captioning 的信息更完整。
Table 8 还有一个小惊喜。
加入 captioning loss 后,LV-VISCap 上 video instance segmentation 的 mAP 从31.7到34.2。
caption 监督反过来帮了视觉 query。
这也是本文一个挺有意思的副作用。
CaptionFormer 最值得记住的点,是它把 DVOC 缺的监督补齐了。
每个物体不再只有 mask、box、category。
它还有一条跨时间的 caption。
有了这份数据,模型就可以围绕 object query 同时学习:
这条路线的实用性很强。
先用强 VLM 批量生成细粒度监督。
再训练一个更专门、更可评估的视频模型。
对于长视频理解、视频编辑、机器人和交互式检索,这种“轨迹 + 描述”的输出会很有用。
代码 / 项目页:
论文正文写明:code 和 generated annotations 会在项目页提供。