


来源:具身智能之心
原文链接:https://mp\.weixin\.qq\.com/s/NFsKJ0AvASSQsaN6KEmcDQ
01.
现有导航评测到底缺了什么?
具身导航(Embodied Navigation)是具身智能的基石能力——让智能体在陌生环境中自主行动。从最初的视觉语言导航(VLN)和点目标导航(PointNav),到后来的物体目标导航(ObjectNav)、社交导航(SocialNav)、人类跟随(Human Following)和具身问答(EQA),任务类型越来越丰富。
然而,一个关键矛盾正在浮现:算法越来越"统一",评测却仍然"孤立"。
当前号称"统一导航"的模型(如 Uni-NaVid、OmniNav 等),在发布时往往需要在多个独立基准上分别测试——VLN 用 R2R,ObjectNav 用 HM3D-OVON,EQA 用 OpenEQA。这些基准之间没有任何交叉,每个评测只考察单一技能,完全无法验证一个关键问题:
当智能体需要在同一个任务中连续切换多种导航策略时,它还能正常工作吗?
更进一步,现有评测还存在两个系统性盲区:
行为真实性缺失:几乎所有基准都使用最短路径算法生成轨迹数据,这些"完美路径"缺少人类导航时天然的试探、犹豫和预判行为,导致模型学到的策略与真实部署场景严重脱节。
构型单一:评测通常只针对一种机器人形态(如轮式),无法预测同一算法在四足或人形机器人上的表现。
OmniNavBench 正是为解决这些问题而生。
论文信息
02.
OmniNavBench:一个怎样的基准?
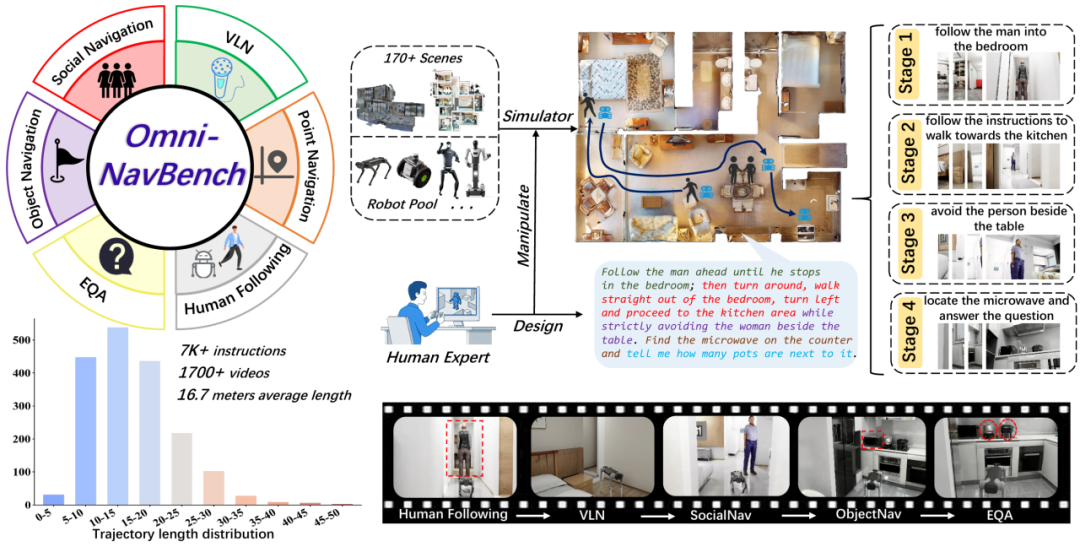
OmniNavBench 整体设计示意
OmniNavBench 的核心理念可以用三个关键词概括:跨技能协同、跨构型泛化、人类级行为监督。
1)组合式指令:
在一个 episode 中串联多种导航技能
与以往"一个 episode 只测一个任务"不同,OmniNavBench 构建了 组合式指令(Composite Instructions),每条指令至少包含两个异构子任务的有序组合。
举个例子,一条典型指令可能是这样的:
"跟随前方的人进入卧室;然后转身直行前往厨房,同时避开桌旁的女性;找到台面上的微波炉,告诉我旁边有几个锅。"
这条指令一口气涉及了 Human Following → VLN → SocialNav(并行约束) → ObjectNav → EQA,智能体必须在时空上连续执行,不能各做各的。
基准涵盖六种核心能力原语:
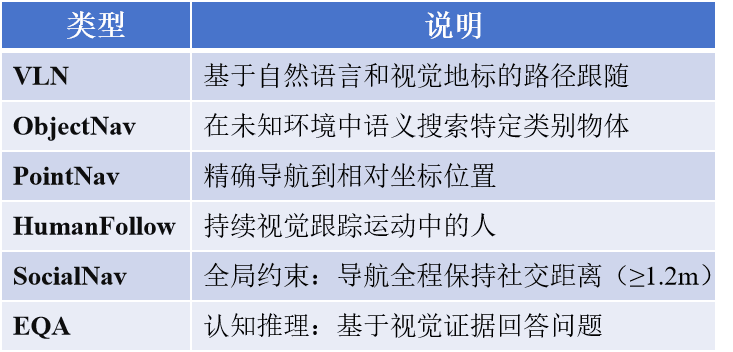
子任务数量从 2 个到 4 个以上不等,形成从易到难的系统性难度梯度。
2)多构型支持:同一指令,三种机器人
OmniNavBench 构建于 NVIDIA Isaac Sim 之上,支持三种形态截然不同的机器人——轮式、四足、人形各一台:
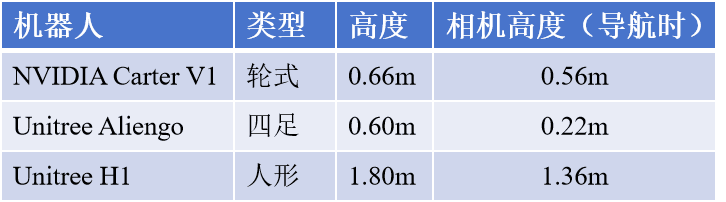
同一个算法可以在三种构型上零修改地运行评测,直接暴露其对运动学差异和视角变化的泛化能力。平台同时支持 waypoint 级控制和速度指令级控制,并提供离散动作接口。
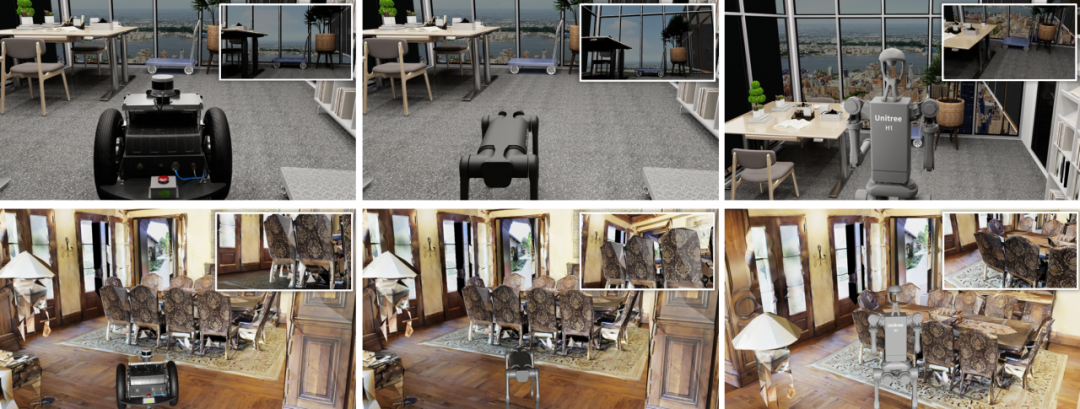
三种机器人在不同场景中的视角
3)人类遥操作轨迹:告别最短路径
OmniNavBench 的 全部1,779 条专家轨迹均由人类遥操作采集,而非算法生成。轨迹平均长度 16.7 米,保留了人类导航时的试探性扫视、预判性避让等真实行为模式——这些细节恰恰是最短路径算法生成不出来的。
研究表明,人类路径与最短路径在地标利用率等关键指标上存在显著差异(如 CityNav 中 36.3% vs 24.6%),这些行为细节对于训练鲁棒策略至关重要。
4)大规模指令与场景
在 1,779 条核心指令之上,借助 Qwen3-Max 生成了简洁版、第一人称版、详细版三种风格变体,总计 7,116 条 风格化指令,平均长度 42 词。场景方面,基准囊括 170 个场景——85 个 GRScenes 合成场景(家庭 + 商业)与 85 个 Matterport3D 真实世界扫描,覆盖从家居到办公的多种空间结构,支持跨域泛化评测。
03.
实验:现有"统一"模型的真实表现
研究团队对四个代表性统一导航模型进行了零样本评测:PoliFormer(基于 Transformer 的强化学习)、Uni-NaVid(视觉-语言-动作生成)、MTU3D(导航与探索统一)和 OmniNav(共享连续 waypoint 抽象)。整体结果如下表所示,关键发现总结如下。
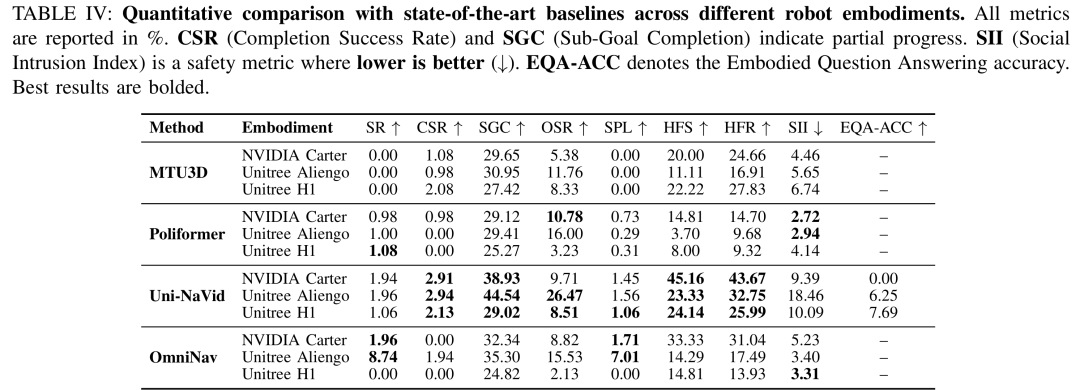
SOTA 统一导航模型在三种机器人构型上的定量对比
发现 1:全面的性能退化
所有模型在 OmniNavBench 上的表现都远低于其在单任务基准上的声称水平。最高成功率仅 8.74%(OmniNav,Aliengo),大多数配置低于 2%。这种退化在三种构型上一致出现,说明这是一个根本性的能力缺陷,而非平台特异性问题。
发现 2:子目标能完成,整体任务却失败
Sub-Goal Completion(SGC)与 Success Rate(SR)之间的巨大落差极具启发性——Uni-NaVid 在 Aliengo 上 SGC 达到 44.54%,但 SR 仅有 1.96%。这意味着模型能在单个子任务上取得不错的进展,但 无法在一个连续 episode 中顺序执行多个异构任务。瓶颈不在单项技能,而在技能之间的衔接与切换。
发现 3:导航到了目标附近,却不会停下来
Oracle Success Rate(OSR)远高于 SR(如 Uni-NaVid:26.47% OSR vs 1.96% SR),说明智能体经常能物理上到达目标附近,但 无法正确发出终止信号——这是端到端导航在真实部署中的"最后一厘米"问题。
发现 4:动态社交交互能力严重不足
Human Follow Success(HFS)和 Human Follow Ratio(HFR)在所有配置中都偏低。最好的 HFS 为 45.16%(Uni-NaVid,Carter),但在足式机器人上急剧下降。Social Intrusion Index(SII)普遍偏高,表明智能体缺乏基本的社交距离意识。
发现 5:对机器人构型高度敏感
同一算法在不同构型上的表现差异巨大——OmniNav 在 Aliengo 上 SR 8.74%,在 Carter 上骤降至 1.96%,在人形 H1 上则直接归零。人形平台由于需要持续主动平衡,任何策略瑕疵都会被放大为摔倒(Fall Rate 60-80%),而非轮式平台上的温和停滞。
04.
指令风格的影响
**
**
对 OmniNav 和 Uni-NaVid 的指令风格消融实验揭示了一个值得关注的现象:简洁版和第一人称版指令反而提升了成功率(如 OmniNav 从 8.74% 提升至 14.47%),而详细版表现持平或下降。这表明现有模型过拟合于特定句法模式,对语言多样性的泛化能力不足。
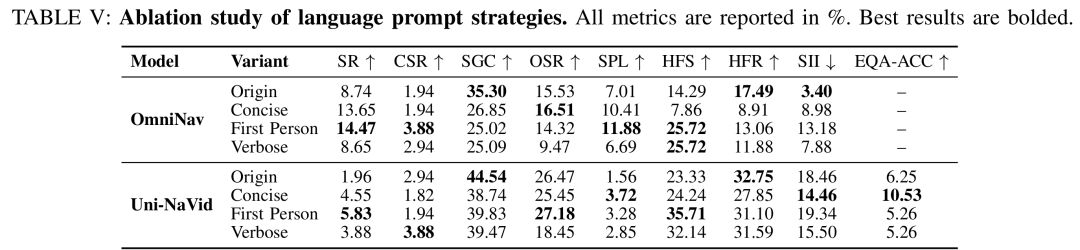
指令风格消融实验
05.
与现有基准的对比
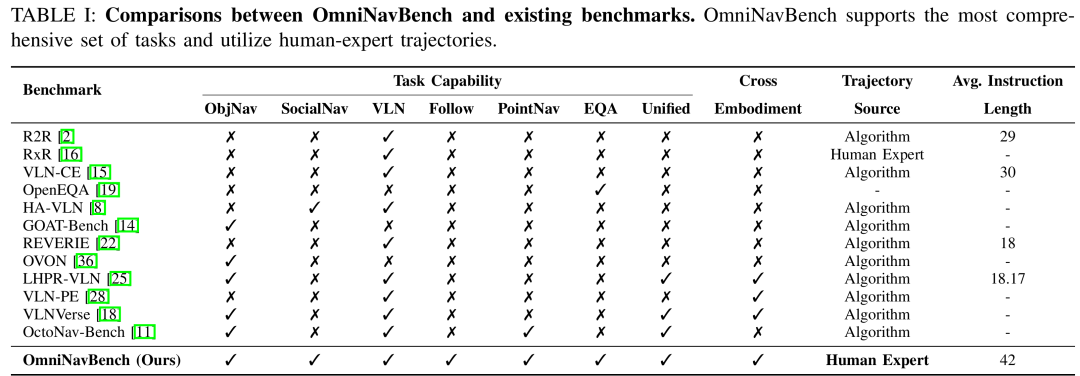
OmniNavBench 与现有导航基准的对比
OmniNavBench 是目前唯一同时覆盖六种任务、支持跨构型评测、并基于人类专家轨迹构建的统一导航基准。
总结与展望
OmniNavBench 的实验结果传递了一个清晰的信号:当前号称"统一"的导航模型,在面对真正的跨技能、跨构型、长时程组合任务时,仍然存在根本性的能力缺口。 实验揭示了两个最关键的突破方向:
鲁棒的顺序任务进度追踪:模型需要在多步组合任务中可靠地追踪执行进度,实现技能间的流畅切换
可靠的终止决策:弥合"到达目标"与"完成任务"之间的鸿沟——导航到位了却不知道该停下来,是当前端到端导航最突出的"最后一厘米"问题
更广泛地看,动态交互意识不足、构型适应性差、指令鲁棒性弱等问题同样亟待解决,这呼唤具备长时程推理能力的下一代通用导航智能体。
原文链接: https://www.leiphone.com/category/private/aR4EwBAU8zrdc67Y.html
