


来源:极佳科技GigaAI
原文链接:https://mp\.weixin\.qq\.com/s/cjSbnq0UIFfYEQqzeLOkhw
这13篇论文并非分散在不同方向上的单点成果,而是共同指向极佳视界长期布局的核心技术方向:通用世界模型。通用世界模型的目标,是让AI不止能够识别和生成视觉内容,更能够理解真实世界的空间结构、动态变化、交互规律与行动后果,从而支撑机器人、自动驾驶和通用内容创作等多类复杂任务。
本次入选的13篇论文,对应这条能力链上的三个关键层面:
面向具身智能的世界模型、VLA推理与部署效率;
面向自动驾驶的多模态世界生成、闭环强化学习训练与导航评估;
面向通用世界的3D/4D重建、视频生成与物理建模。
这些工作并非零散的单点突破,而是在共同回答同一个问题:如何让 AI 不仅能够理解世界,还能够推演世界、作用于世界,并在世界中可靠地学习。以下依次介绍本次入选的13篇论文。
一、具身智能与世界模型
01
GigaWorld-Policy:面向高效
部署的动作中心式世界-动作模型
论文名称:GigaWorld-Policy: An Efficient Action-Centered World-Action Model
代码链接:https://github\.com/open\-gigaai/giga\-world\-policy
论文链接:https://arxiv\.org/abs/2603\.17240
项目主页:https://gigaai\-research\.github\.io/GigaWorld\-Policy/
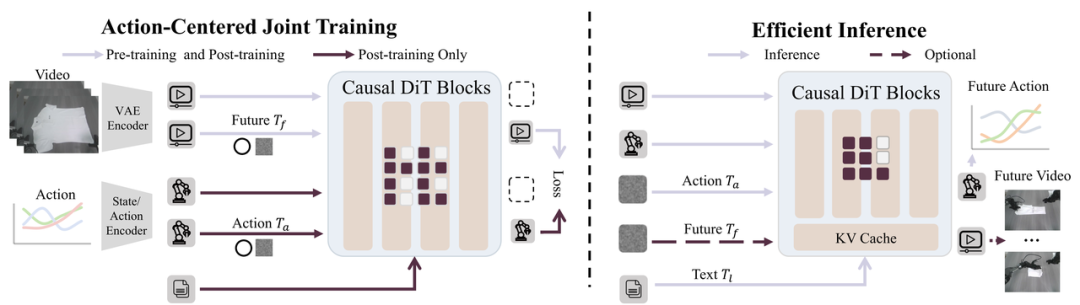
研究问题:机器人在抓取、整理、装配等任务中,不能仅依赖当前画面直接输出动作,而需要理解当前状态、预判未来变化并评估动作后果。现有World-Action Model 通常将未来视频生成与动作预测深度耦合,导致推理链路长、计算开销大;一旦未来画面预测出现偏差,动作输出也容易随之漂移。
核心方法:我们提出GigaWorld-Policy,一种以动作为中心的高效World-Action Model。其关键设计在于将“世界理解”更多置于训练阶段完成:训练时同时学习动作预测与未来视频生成,使未来视觉动态为动作学习提供更强监督;部署时则直接解码动作,无需显式生成未来视频。
关键结果:这一设计同时兼顾了策略质量与部署效率。实验显示,GigaWorld-Policy在真实机器人平台与仿真基准上均取得更优的效率与成功率表现:相比强基线Motus,推理速度更快、任务成功率更高;在RoboTwin 2.0基准上,相比pi-0.5亦取得明显提升。
产业意义:GigaWorld-Policy的价值不仅在于提供了一个更高效的机器人模型,更在于为世界模型在真实控制任务中的落地提供了一条务实路径:世界模型可以服务于动作学习,但无需将高成本的视频生成过程完整带入部署阶段。
02
DVG-WM:解耦式视频生成,兼顾
具身世界模型的推理效率与视觉质量
论文名称:DVG-WM: Disentangled Video Generation Enables Efficient Embodied World Model for Robotic Manipulation
论文链接:https://arxiv\.org/abs/2606\.32028
项目主页:https://zyshan0929\.github\.io/DVGWM/
研究问题:通过视频世界模型对未来进行"预演",是具身智能的一条重要技术路线,但现有方法长期受制于一个根本矛盾:准确的动作预测需要细粒度时序推理以捕捉接触、滑动、遮挡等物理变化;高清晰度画面又要求高分辨率视觉生成。两者绑定在同一模型中,往往导致系统既慢又不稳定。
核心方法:我们联合南洋理工大学等机构提出DVG-WM,将具身世界模型中的视频生成过程解耦为两个阶段:先在低分辨率下快速生成“想象轨迹”,判断物理交互是否合理、是否符合语言指令;再以极少步数将该草稿精修为高清视频。由此,时序推理与高保真合成分别在各自最适合的分辨率上完成。
关键结果:在LIBERO仿真基准与多个真实机器人平台上,DVG-WM在提升视频质量的同时,推理速度最高提升3.97倍;配合动作专家后,真实操作平均成功率相比纯视觉策略提升约25个百分点。
产业意义:DVG-WM表明,具身世界模型无需在“预测准确”与“生成逼真”之间二选一。通过解耦建模,世界模型可以同时兼顾规划效率与视觉质量,更适合在真实机器人系统中被高频调用。

03
VLA-R1:以可验证强化学习
增强VLA 模型的推理与执行能力
论文名称:VLA-R1: Enhancing Reasoning in Vision-Language-Action Models
项目主页:https://gigaai\-research\.github\.io/VLA\-R1/
论文链接:https://arxiv\.org/abs/2510\.01623
代码链接:https://github\.com/GigaAI\-research/VLA\-R1
研究问题:真实机器人任务远比“看见目标即执行”复杂。面对相似颜色、遮挡干扰、重复目标与多容器选择等场景,传统VLA模型常出现理解正确但执行偏差的问题,其本质在于推理、定位与动作执行之间未被真正打通。
核心方法:我们联合中国科学院自动化研究所等机构提出VLA-R1,一个面向机器人操作的视觉-语言-动作基础模型。它通过链式思维监督使模型学会显式推理,再利用基于可验证奖励的强化学习进一步优化执行,使模型在输出推理过程的同时,生成可供性区域与运动轨迹。
关键结果:为支撑训练,团队构建了VLA-CoT数据引擎与1.3万条视觉-语言-行动数据,并从空间对齐、轨迹一致性与输出格式三个维度设计奖励。实验表明,引入强化学习后,可供性IoU提升至36.51,轨迹平均误差降至91.74;在真实餐桌场景中,模型在相似颜色、遮挡与目标扰动条件下仍能保持较好的判断与执行成功率。
产业意义:VLA-R1将“推理能力”与“操作能力”从两个割裂的环节,整合为一条可优化、可验证、可部署的统一链路,为家居整理、仓储拣选、轻工装配与机器人教学评测提供了更具解释性与可靠性的技术基础。

04
SAFE-Pruner:面向未来层的视觉
token 剪枝,推进 VLA 模型实时部署
论文名称:SAFE-Pruner: Semantic Attention-Guided Future-Aware Token Pruning for Efficient Vision-Language-Action Manipulation
论文链接:https://arxiv\.org/abs/2605\.29662
研究问题:机器人控制要求模型实时响应,但现有VLA模型计算开销大、推理延迟高。已有视觉token剪枝方法多依据浅层注意力做删除决策,容易提前裁掉深层推理所需的关键信息,导致速度提升的同时,动作稳定性与任务成功率随之下降。
核心方法:SAFE-Pruner 提出一种“面向未来层”的视觉token剪枝框架。研究团队观察到,VLA模型在连续执行过程中会稳定关注同一语义实体,据此设计了深层token 重要性的前瞻预测机制,并通过自适应子任务划分捕捉注意力切换时刻,从而在加速的同时尽量保留后续决策真正需要的视觉线索。
关键结果:作为可插拔的加速框架,SAFE-Pruner在仿真与真实场景中均显著降低了VLA推理开销,最高实现1.89倍加速,同时将任务成功率下降控制在1.7%以内,在速度与效果的平衡上优于已有方法。
产业意义:这项工作的价值不止于提升推理速度,而是将VLA的实时部署问题向前推进了一步:机器人系统需要的不仅是更强的模型,还需要更稳定、更可控、更符合真实时延约束的推理机制。

05
UniDriveDreamer:面向
自动驾驶的单阶段多模态世界模型
论文名称:UniDriveDreamer: A Single-Stage Multimodal World Model for Autonomous Driving
论文链接:https://arxiv\.org/abs/2602\.02002
研究问题:自动驾驶模型训练始终面临一个现实约束:关键场景最为稀缺,真实采集成本最高。暴雨夜路、复杂路口、行人突然横穿等高价值数据,难以依靠车队反复路测获取。而现有多模态数据生成方法大多仍采用分阶段建模,摄像头画面与 LiDAR 数据各自生成,容易彼此失配。
核心方法:我们联合中国科学院自动化研究所等机构提出UniDriveDreamer,一个面向自动驾驶的单阶段多模态数据生成模型。它在同一生成过程中,同时生成多视角摄像头视频与LiDAR序列,使图像外观与三维几何天然保持一致。
关键结果:相比“先生成一种模态、再补齐另一种模态”的两阶段方案,UniDriveDreamer以统一的生成过程实现了更稳定的跨模态一致性。更重要的是,这些生成数据不仅在视觉上接近真实数据,加入训练后还能显著提升下游3D目标检测表现,证明其确实为自动驾驶感知模型提供了有效增量。
产业意义:UniDriveDreamer将世界模型的价值从“生成更逼真的虚拟道路”推进到“生成真正可用于训练的多模态驾驶数据”,为自动驾驶数据引擎提供了更高质量、更低成本的合成能力。

06
ReconDreamer-RL:基于扩散
场景重建的自动驾驶闭环强化学习
论文名称:ReconDreamer-RL: Enhancing Reinforcement Learning via Diffusion-based Scene Reconstruction
项目主页:https://recondreamer\-rl\.github\.io/
论文链接:https://arxiv\.org/abs/2508\.08170
代码链接:https://github\.com/GigaAI\-research/ReconDreamer\-RL
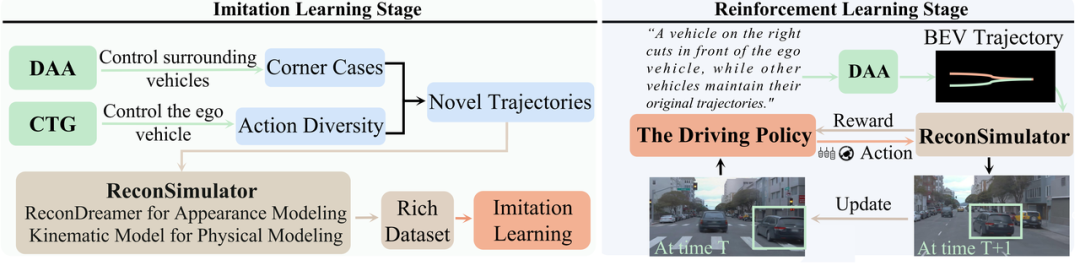
***研究问题:端到端自动驾驶若仅依赖模仿学习,难以覆盖突然加塞、急刹、复杂交互等关键长尾场景;若转向强化学习,训练效果又高度依赖仿真环境的真实程度。环境失真时,模型在闭环中习得的策略很可能无法迁移到真实道路。*
***核心方法:我们联合北京大学等机构提出ReconDreamer-RL,将视频扩散模型的先验能力引入驾驶场景重建,构建面向强化学习的闭环仿真环境ReconSimulator。同时,方法引入Dynamic Adversary Agent主动生成加塞、切入等挑战行为,并利用Cousin Trajectory Generator扩展原本偏向简单路线的轨迹分布。*
***关键结果:ReconDreamer-RL并非将真实道路简单复刻为静态数字孪生,而是让智能体能够在更真实、更困难、交互更充分的环境中反复驾驶、试错、修正与学习。实验结果显示,它能够有效提升端到端自动驾驶模型的闭环训练效果,并相较模仿学习显著降低碰撞率。*
***产业意义:这项工作进一步表明,世界模型在自动驾驶中的价值不仅在于生成更逼真的画面,更在于为强化学习提供一个真实且富有挑战性的训练场,将虚拟经验切实转化为驾驶能力。*
07
OmniNWM:统一状态-动作-奖励
三要素的全景导航世界模型
论文名称:OmniNWM: Unifying the State-Action-Reward Triad for Closed-Loop Panoramic Driving Navigation World Models
项目主页:https://arlo0o\.github\.io/OmniNWM/
论文链接:https://arxiv\.org/pdf/2510\.18313
代码链接:https://github\.com/Ma\-Zhuang/OmniNWM
***研究问题:自动驾驶世界模型长期存在一个共性问题:状态生成、动作控制与奖励评估往往被分开处理。其结果是,部分模型能够生成短视频,却难以支撑长时导航;部分模型具备感知能力,却无法对安全性与规则遵循进行闭环评估。*
***核心方法:OmniNWM提出一个全景式导航世界模型,统一建模状态、动作与奖励三要素。它能够同时生成RGB、语义、度量深度与3D occupancy等多模态状态,并利用归一化全景Plücker ray-map将输入轨迹编码为像素级控制信号,使世界生成过程更精确地响应车辆规划轨迹。*
***关键结果:更进一步,OmniNWM不再依赖外部图像模型间接学习奖励,而是直接利用生成的3D occupancy构建面向安全与规则遵循的稠密奖励。论文结果表明,该方法在视频生成质量、控制精度与长时距稳定性上均取得领先表现。*
***产业意义:OmniNWM将驾驶世界模型从“能够模拟”推进到“能够闭环验证”。这意味着世界模型不再只是离线合成工具,而有望成为导航策略设计、验证与评估的核心基础设施。*

三、通用世界重建、生成和物理建模
08
MoGe4D:
几何感知的单图动态 4D 场景生成
论文名称:Geometry-Aware Single-Image 4D Synthesis via Dense Trajectory Generation
项目主页:https://ivg\-yanranzhang\.github\.io/MoGe4D/
论文链接:https://arxiv\.org/abs/2512\.05044
代码链接:https://github\.com/Zhangyr2022/MoGe4D
***研究问题:从单张静态图片生成时序连贯、几何可信的动态4D场景,是VR/AR、数字内容创作与空间智能中的核心问题。现有方案通常将三维几何建模与运动生成割裂处理,容易出现物体漂移、结构崩坏与动作僵硬等问题。*
***核心方法:针对这一问题,团队提出几何感知的单图4D生成框架MoGe4D,打通几何重建与动态推演两大环节。为支撑该方向,研究团队自建了TrajScene-60K数据集,包含6万组带稠密4D点轨迹的真实视频;在方法层面,4D-STraG负责轨迹生成,4D-ViSM负责新视角动态渲染。*
***关键结果:对比4Real、Free4D、DimensionX等主流方法,MoGe4D在物体一致性、时空稳定性与画面美学等量化指标上全面占优,并显著降低轨迹误差;单张A100显卡约6分钟即可生成49帧 512×368分辨率的4D视频,在效果与效率之间取得了较好平衡。*
***产业意义:这项工作为单一输入生成高保真动态三维世界提供了更统一的技术范式,可广泛服务于虚拟直播、沉浸式影视、数字资产生成与空间内容生产等场景。*

09
RhymeFlow:
免训练的视频生成异步去噪加速
论文名称:RhymeFlow: Training Free Acceleration for Video Generation with Asynchronous Denoising Flow Scheduling
代码链接:https://github\.com/Simon\-Dcs/RhymeFlow
论文链接:https://arxiv\.org/pdf/2606\.06309
项目主页:https://simon\-dcs\.github\.io/Website\-of\-RhymeFlow/
***研究问题:随着DiT类视频生成模型画面质量不断提升,推理时间与算力成本也同步上升。已有加速方法大多仅在单步去噪内部做稀疏化,但默认所有帧都必须完整执行全部去噪步骤,因此仍存在大量冗余计算。***
**
**
*******核心方法:RhymeFlow的思路是改变“所有帧同等对待”的调度方式:先识别决定语义演化的关键帧,使关键帧保留完整、密集的去噪过程,其余非关键帧则异步跳过部分步骤;同时引入latent trajectory projection等机制,保证异步调度下的时序一致性。*****
*****关键结果:在无需额外训练的前提下,RhymeFlow为视频扩散模型提供了一条新的推理加速路径。实验表明,相比已有基线,它能够同时获得更快的生成速度与更好的视觉质量,并可与现有单步内加速策略形成互补。***
*****产业意义:对大规模视频模型而言,训练成本高,推理成本同样关键。RhymeFlow代表了一类更具产业价值的优化思路:不改动模型主体,即可直接提升线上推理效率。***

10
VolSplat:体素对齐的
前馈式 3D Gaussian Splatting
论文名称:VolSplat: Rethinking Feed-Forward 3D Gaussian Splatting with Voxel-Aligned Prediction
代码链接:https://github\.com/ziplab/VolSplat
论文链接:https://arxiv\.org/abs/2509\.19297
项目主页:https://lhmd\.top/volsplat/
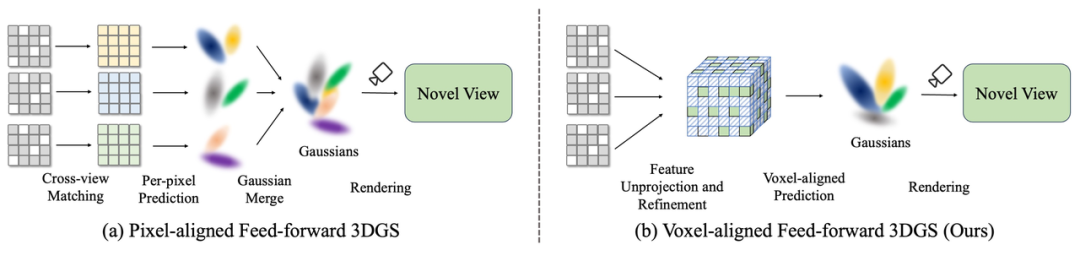
*研究问题:前馈式3DGaussian Splatting能够从多张图像中快速构建可渲染的3D场景,但现有方法多采用“像素对齐”范式:先从2D像素预测Gaussian,再投回三维空间。这一方式在遮挡、低纹理与视角不一致场景中容易出错,也难以根据真实场景复杂度灵活调整Gaussian密度。*
*******核心方法:我们联合浙江大学等机构提出 VolSplat,先将多视角图像特征通过深度估计与反投影置入统一的3D体素网格,再由稀疏3D解码器在体素空间中直接预测 Gaussian参数。换言之,模型不再从2D像素出发生成点,而是在真正的三维空间中理解场景后再生成表示。*****
*****关键结果:这种从2D对齐转向3D对齐的建模方式,显著提升了跨视角一致性与几何可信度。实验结果显示,VolSplat在常用新视角合成基准上取得了更好的渲染质量与更稳定的几何表现。***
*****产业意义:VolSplat为前馈式3DGS提供了一条更符合空间结构本质的技术路线,有望进一步推动3D内容生产从“能够快速生成”走向“能够稳定生成、可信生成”。***
11
2K Retrofit:熵引导稀疏增强,
将几何基础模型高效升级至 2K 分辨率
论文名称:2K Retrofit: Entropy-Guided Efficient Sparse Refinement for High-Resolution 3D Geometry Prediction
论文链接:https://arxiv\.org/abs/2603\.19964
核心方法:我们联合北京航空航天大学等机构提出2KRetrofit,一种面向高分辨率几何预测的熵引导稀疏增强框架。它无需修改或重训原始backbone,而是先利用冻结基础模型生成稳定的全局粗几何结果,再利用熵信息定位最值得修正的少量关键区域,对这些区域执行高分辨率增强。
关键结果:这种“全局稳态 + 稀疏精修”的思路,既保留了原始基础模型的几何泛化能力,又避免了全图密集计算带来的巨大开销,为2K级几何预测提供了一条更轻量、更高效的实现路径。
产业意义:2KRetrofit 代表了一种极具现实意义的升级方式:无需从零训练新模型,也无需承担全分辨率推理成本,即可将现有基础模型快速推进到更高精度、更高分辨率的生产级应用场景。

12
AnchorSplat:面向 3DGS
资产的快速结构一致性细节增强
论文名称:AnchorSplat: Fast and Structure Consistent Detail Synthesis for Gaussian Splatting
论文链接:https://arxiv\.org/abs/2607\.01290
代码链接:https://github\.com/zhude233/AnchorSplat
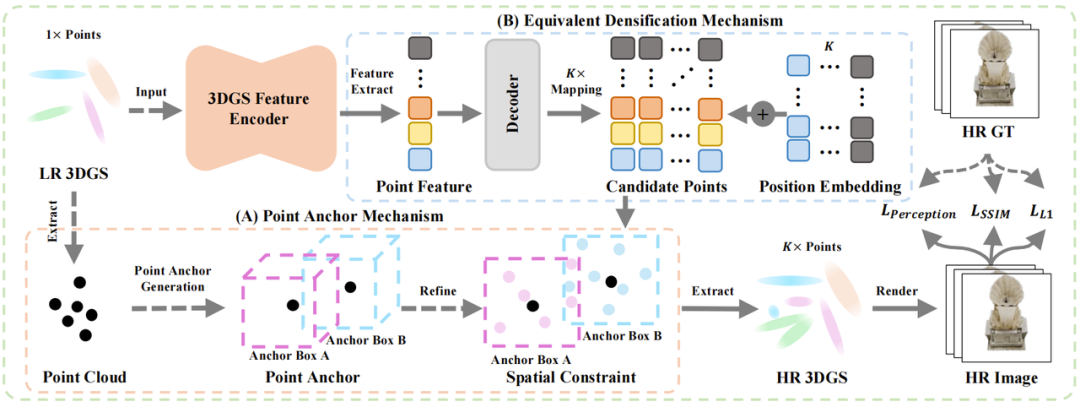
研究问题*:3DGaussian Splatting在高质量渲染方面进展迅速,但从低分辨率输入构建资产时,仍容易出现几何稀疏、纹理噪声与细节缺失等问题。传统增强路线通常需要“先渲染为2D、再超分、再回到3D”,流程冗长、代价高,且容易破坏多视角一致性。*
*****核心方法:我们联合中国科学院自动化研究所、上海科技大学等机构提出AnchorSplat,一个完全在3D空间中完成细节增强的资产增强网络。它直接输入低质量3DGS资产,通过“点锚机制”约束新生成高斯粒子在局部空间内生长,并以"单次倍增"替代传统迭代式密化,一步完成粒子增殖与修剪。***
*****关键结果:AnchorSplat在新构建的3DGS-SR基准上取得领先效果,并可零样本泛化至多类生成模型输出与真实扫描数据。更重要的是,它仅需单次前向、约0.01秒即可输出高保真细节版本,速度相比传统优化方法快了多个数量级。***
*****产业意义:这项工作将3DGS资产增强从“耗时的优化问题”转变为“即时处理能力”,为大规模3D内容生产、资产修复与空间媒体生成提供了更具普适性的基础工具。***
13
ReconPhys:从单目视频
前馈重建外观、几何与物理属性
论文名称:ReconPhys: Reconstruct Appearance and Physical Attributes from Single Video
项目主页:https://chuanshuogushi\.github\.io/ReconPhys/
论文链接:https://arxiv\.org/abs/2604\.07882
代码链接:https://github\.com/chuanshuogushi/ReconPhys
研究问题:让机器人在仿真中学习真实世界中的非刚体物体,难点不仅在于重建物体的外观形态,更在于恢复其质量、刚度、阻尼、摩擦等可交互的物理属性。现实中,这些因素与外观、形变及动力学行为深度耦合,仅依靠普通视频反推往往既困难又低效。
***核心方法:我们联合中国科学院自动化研究所、清华大学等机构提出ReconPhys,一个从单目视频中前馈式重建非刚体外观、几何与物理属性的统一框架。它将3D Gaussian Splatting与弹簧-质点物理系统相结合,在恢复视觉外观的同时,联合估计可用于仿真的关键物理参数。*
***关键结果:相比以往针对单个场景进行长时间优化、甚至依赖多视角输入与人工标注的方法,ReconPhys将整个过程大幅前移至高效前馈推理阶段:输入一段单目视频,不到一秒即可生成绑定物理属性的3DGS资产,并在未来状态预测与交互仿真中表现出更合理的物理行为。*
***产业意义:ReconPhys将“物理重建”从高成本的定制流程,推进为可规模化的基础能力,为机器人操作、真实到仿真的数据生成、图形仿真与物理世界建模提供了更高效的入口。*

总结与展望
从GigaWorld-Policy、DVG-WM、VLA-R1 与 SAFE-Pruner 所代表的具身智能与世界模型能力,到 UniDriveDreamer、ReconDreamer-RL、OmniNWM 所代表的自动驾驶世界生成、闭环训练与评估,再到 MoGe4D、RhymeFlow、VolSplat、2K Retrofit、AnchorSplat、ReconPhys所对应的通用世界的重建、视频生成与物理建模基础能力,这13篇论文共同勾勒出极佳视界在AI时代的技术版图:**
**
以通用世界模型为核心,让 AI 具备理解世界、推演世界、作用于世界并在世界中持续学习的能力。
通向AGI的道路仍然漫长,当前的技术体系还有许多问题有待解决。未来,我们将继续围绕通用世界模型推进基础研究与产业落地,并持续与学术界、产业界分享我们的最新探索成果。
**
**
极佳视界是全球领先的「世界模型和具身智能」公司,「世界模型-具身基模-原生本体-泛化场景」四位一体,推动通用机器人进入千家万户、千行百业,引领物理AGI的爆发。
公司核心团队包括清华、北大、中科院、中科大、WashU、CMU等全球知名院校顶尖研究人员,以及来自微软、三星、地平线、百度、博世等全球知名企业高管,核心团队在物理AI方向兼具业内领先的研究能力和大规模的产业落地经验。
极佳视界是国内第一家布局世界模型的科技公司,以世界模型平台 GigaWorld、通用具身大脑 GigaBrain、原生本体 Maker 构建闭环生态,致力实现10-100倍以上的数据、训练、测试全链路效率提升,推动通用具身智能机器人、通用自动驾驶等物理AGI大规模爆发。
原文链接: https://www.leiphone.com/category/private/0L2iV9dtqvThezJR.html
