


来源:机器人解剖师
原文链接:https://mp\.weixin\.qq\.com/s/t\-27VnWDfrcyJ8gz72CmoQ
RSS 2026近期在澳大利亚召开,会上颁布了最佳论文《FlashSAC: Fast and Stable Off-Policy Reinforcement
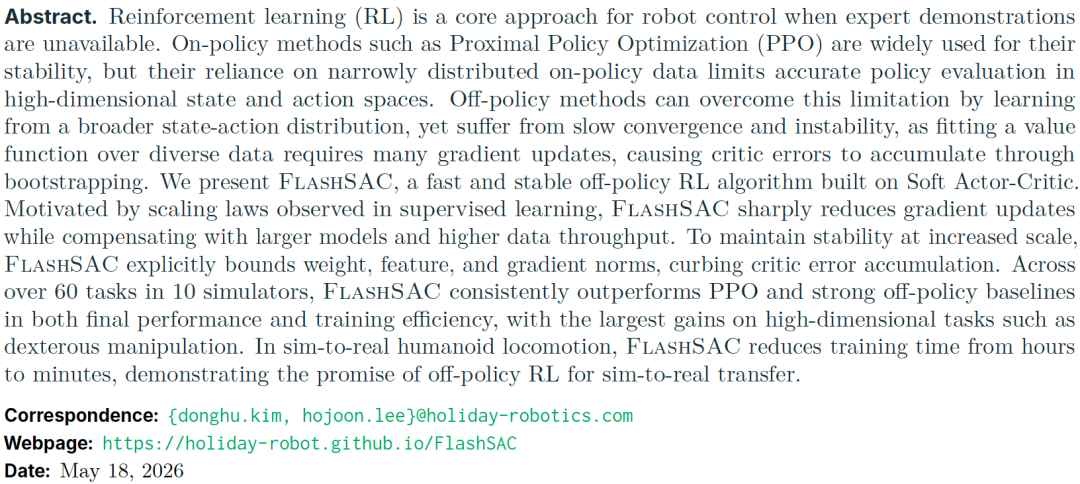
Learning for High-Dimensional Robot Control》,改文章提出高效强化学习策略FlashSAC,主要内容摘要如下,
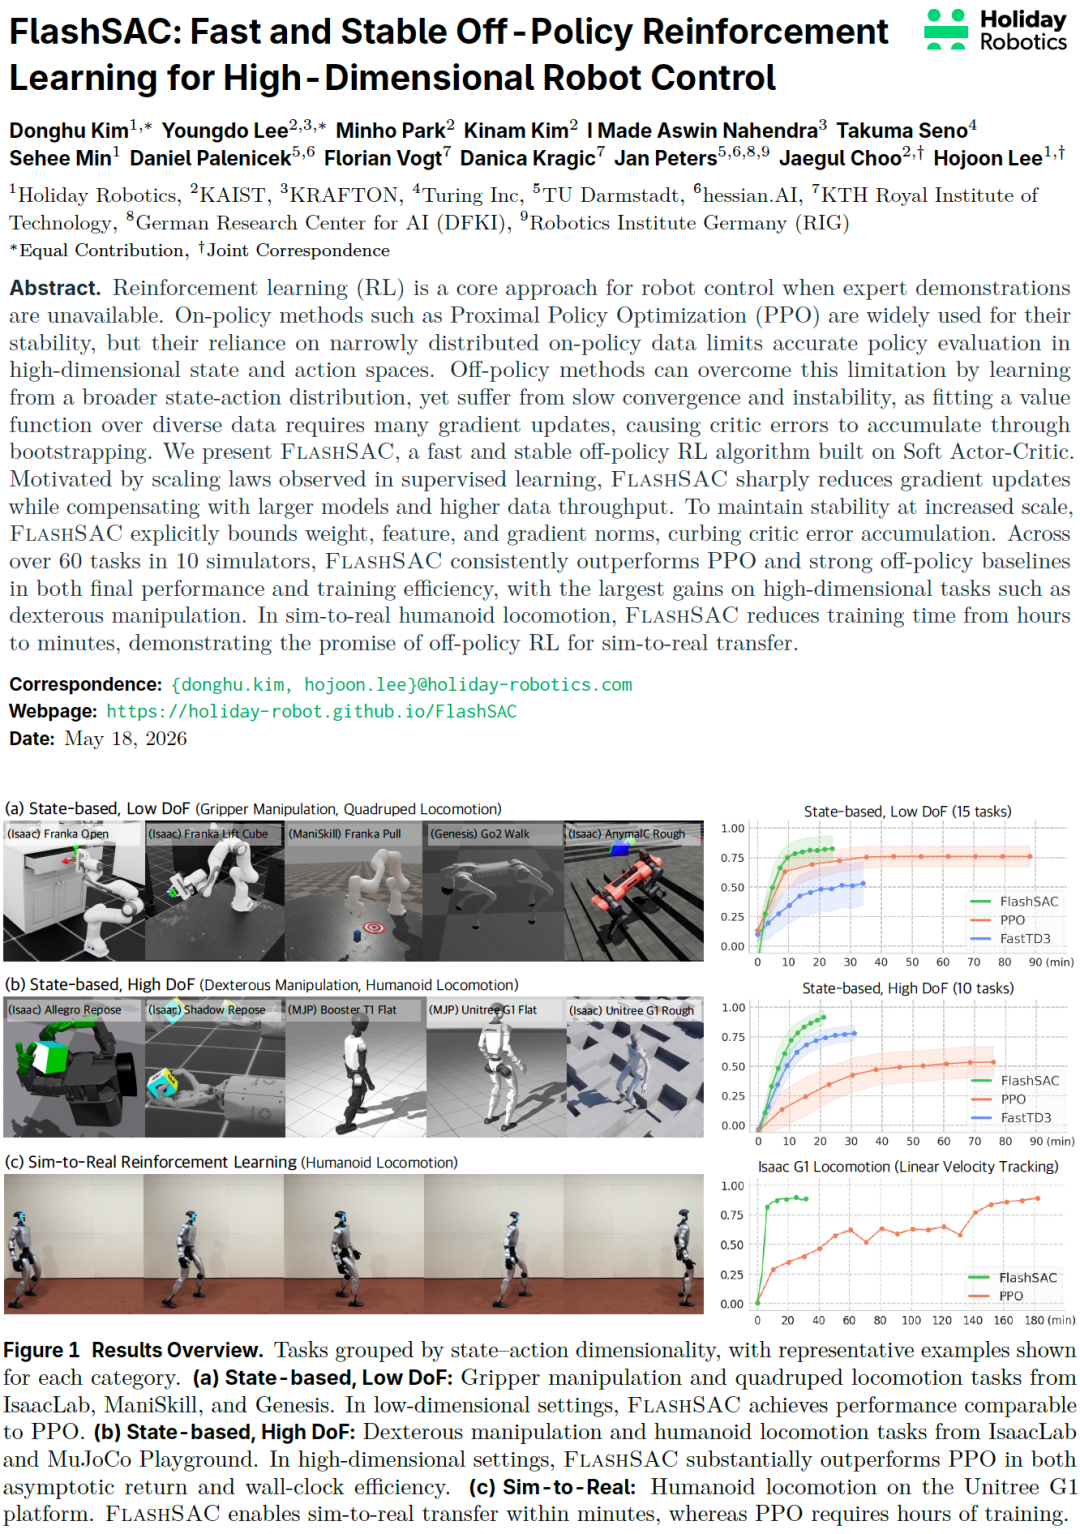
1️⃣ 背景:强化学习通过试错学习,可以不需要任何人工标记数据,完全从零开始学习。不过强化学习监督信号弱,收敛慢,不稳定。而且RL一般通过bootstrapping学习,也会造成critic的错误通过提督更新不断传播。强化学习算法与理念受人喜爱,工业上却并不好用。
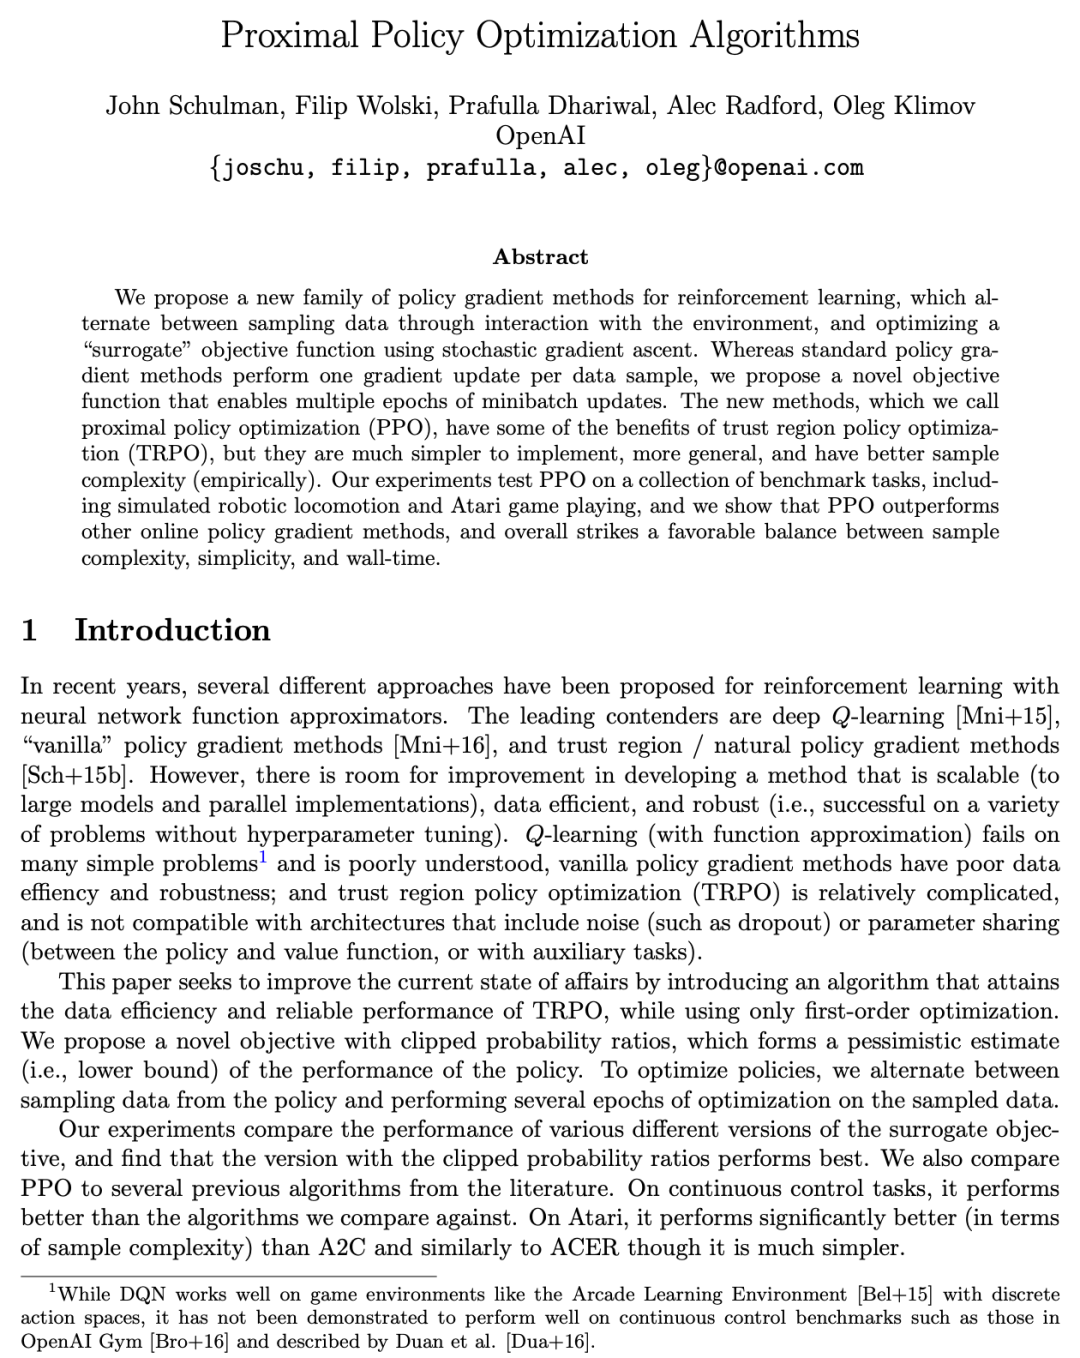
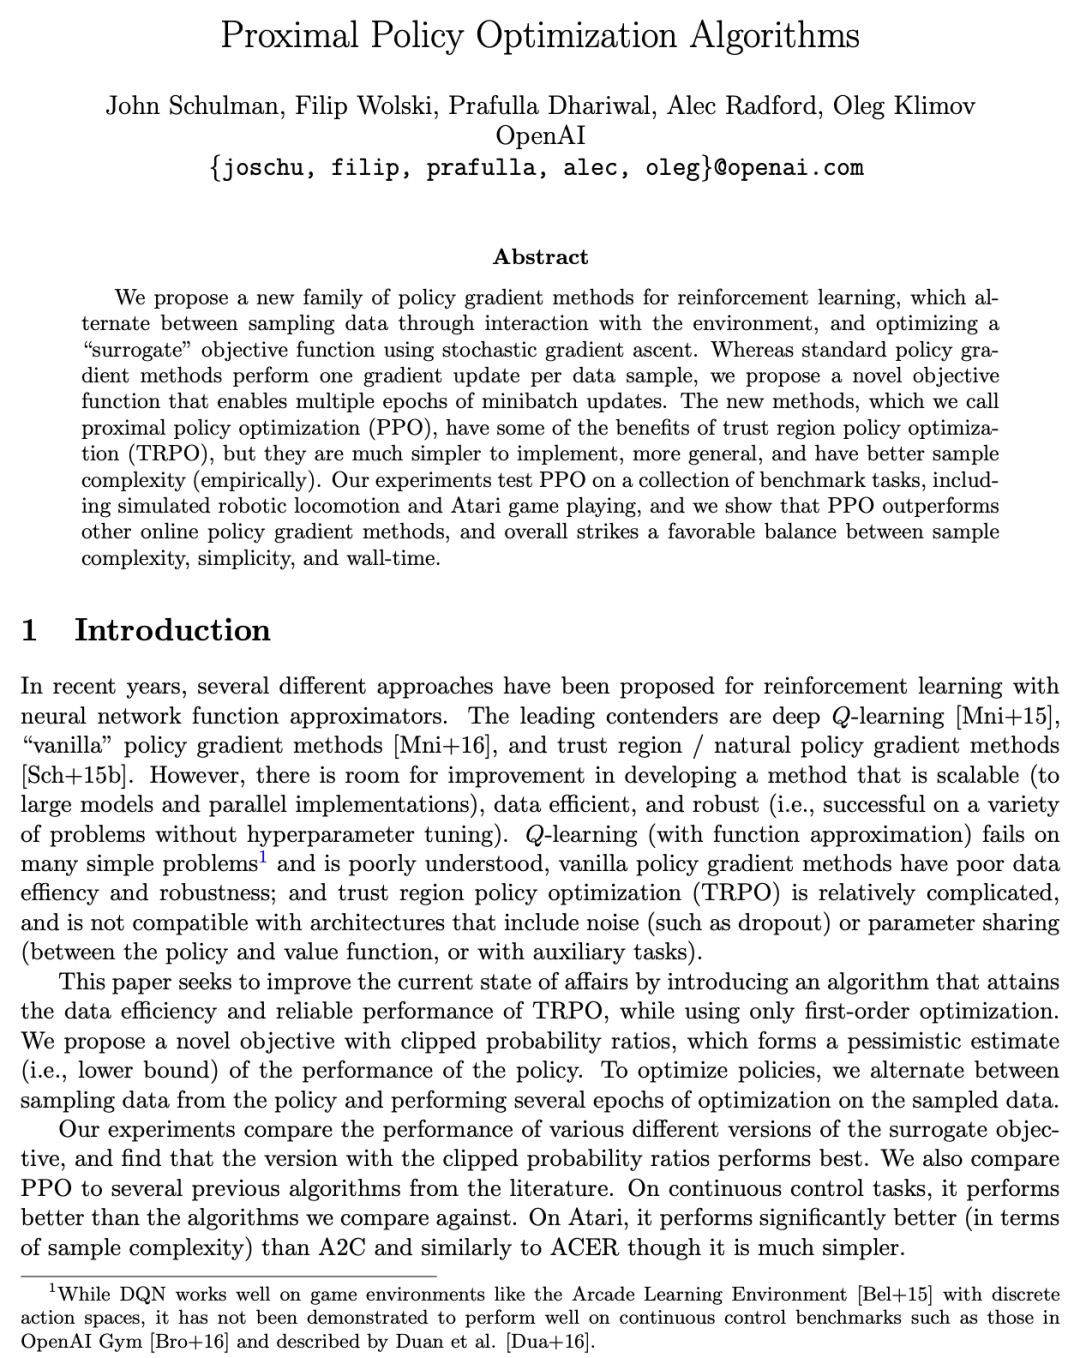
2️⃣ 特别是高纬度任务,由于传统小步快跑的更新策略,很容易收敛到局部最优解,使得整体效果很差,而且训练不稳定。此前OpenAI提出了PPO强化学此算法,PPO的思路是通过CLIP机制,限制每次更新的步伐使RL收敛更稳定。不过PPO的学习效率比较低,存在瓶颈。
3️⃣ 文章提出快速且稳定的离线强化学习算法FlashSAC,主要借鉴于监督学习的scaling law思路,通过更大的模型与更高的batch来减少梯度更新频次,训练效率与效果得到极大的提升。
4️⃣ FlashSAC就如其名,简单来说算法可以拆分成Flash和SAC两部分。
1)Flash表示Fast与Stable,即通过一些策略使训练更高效更稳定,收敛速度更快。
2)SAC表示Soft Actor-Critic算法,是加州大学伯克利分校之前Pieter Abbeel与Sergey Levine团队提出的强化学习算法,
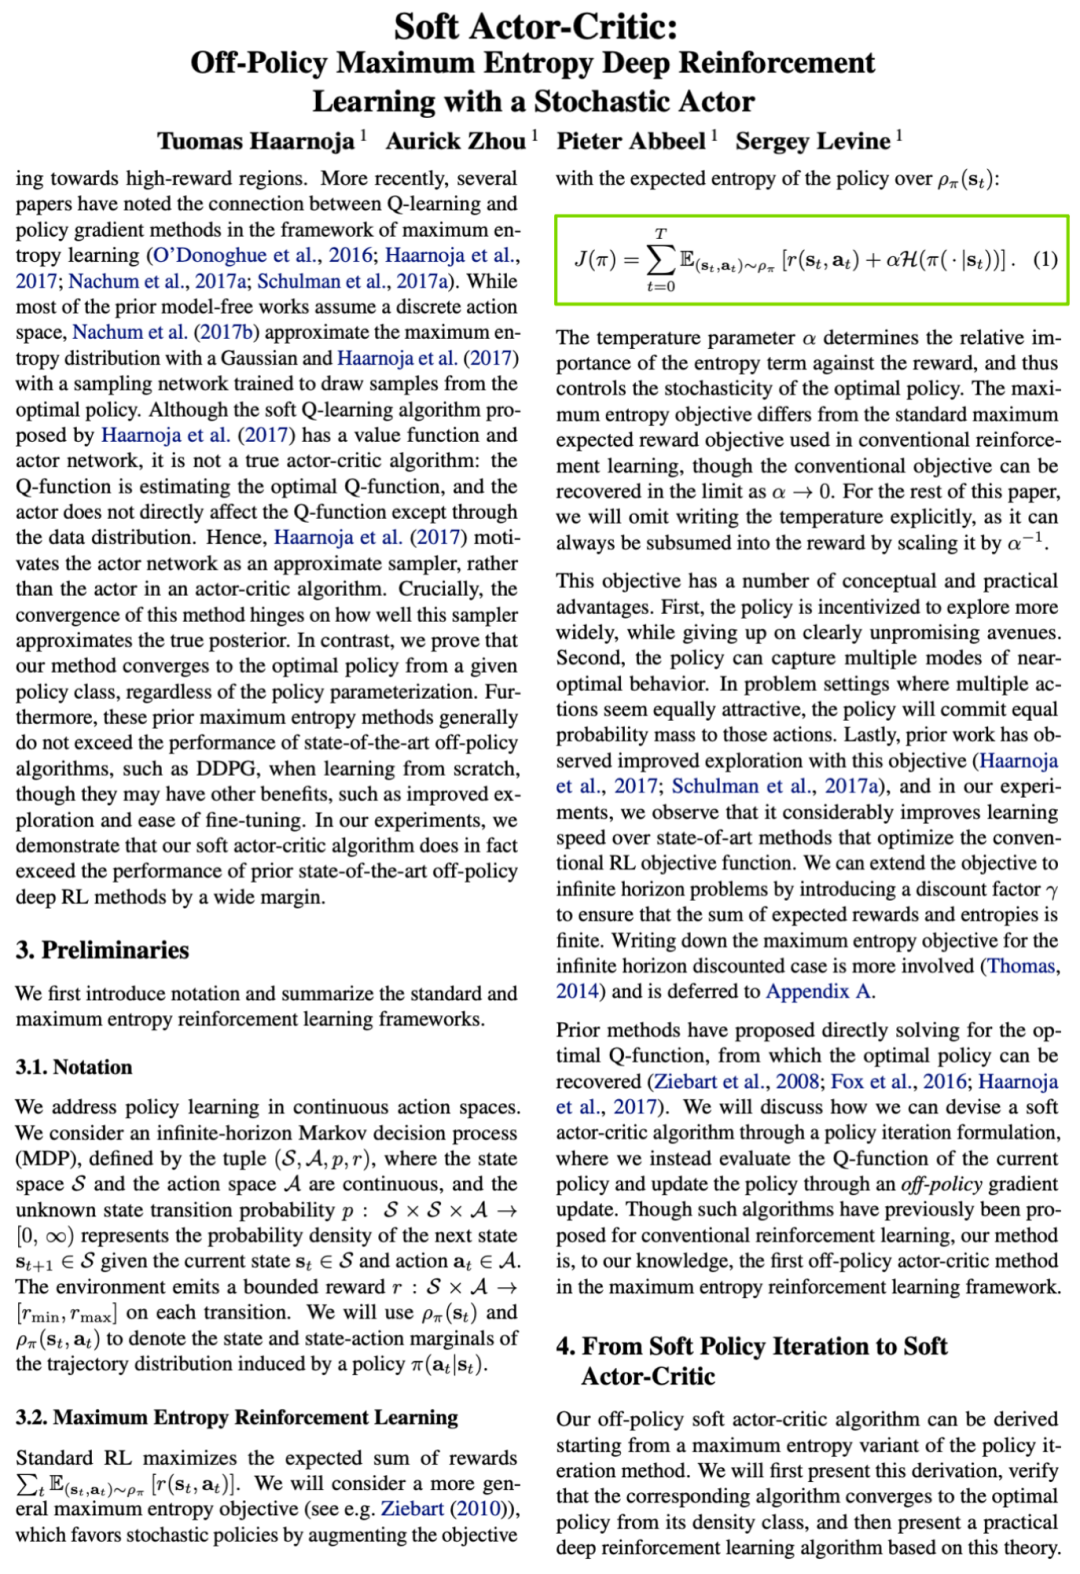
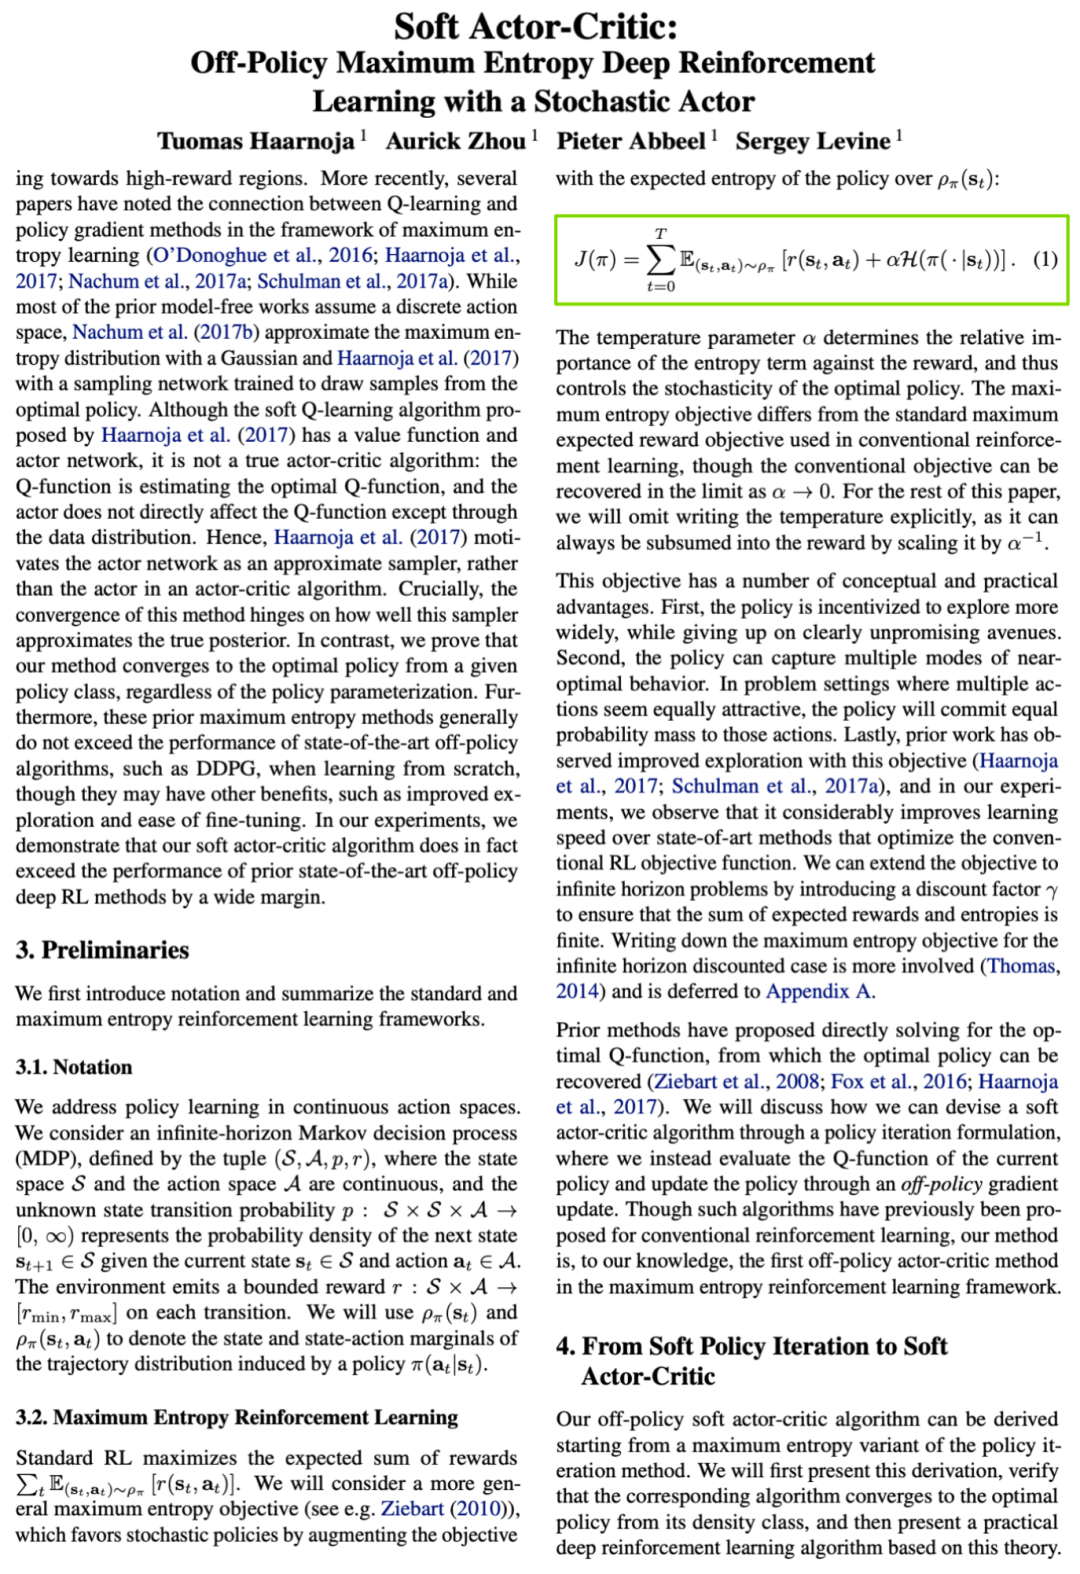
5️⃣ SAC强化学方法与传统强化学习方法的一些比较,
1)SAC在传统强化学习最大化累积奖励的基础上,额外加入最大化策略熵的目标。
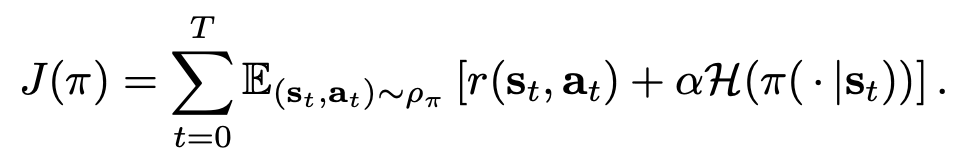
2)其中H为策略熵,一般定义如下
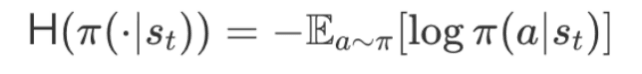
Exploration:以ε的概率选择其它非最优的action
Exploitation:以(1-ε)的概率,选择评价函数计算出的最优Action
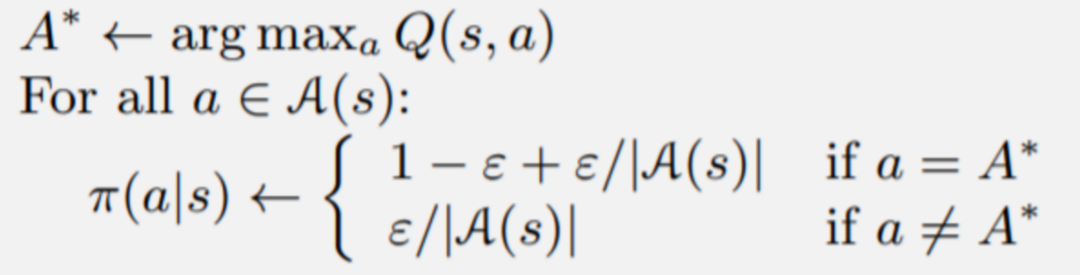
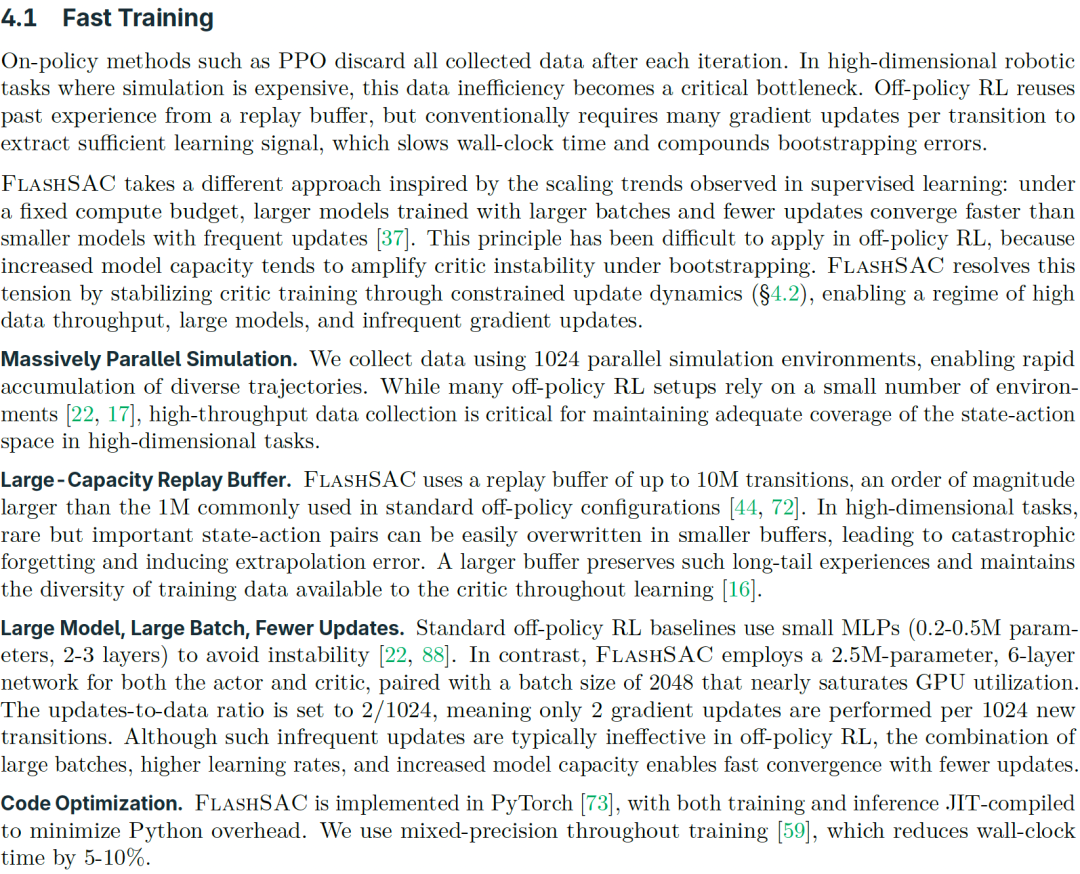
6️⃣ Flash部分中的Fast Trainging
Fast Trainging:通过巨大的仿真并行度、大的Replay Buffer、大的模型、大的Batch Size、以及较少的参数更新频次、以及一些JIT相关代码优化,加快训练和收敛速度。
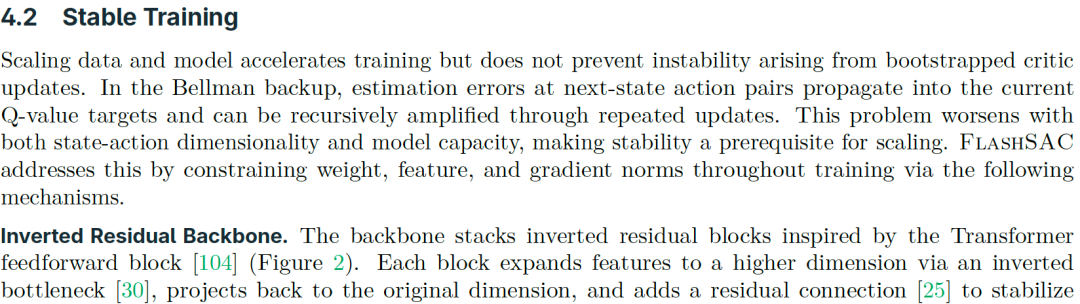
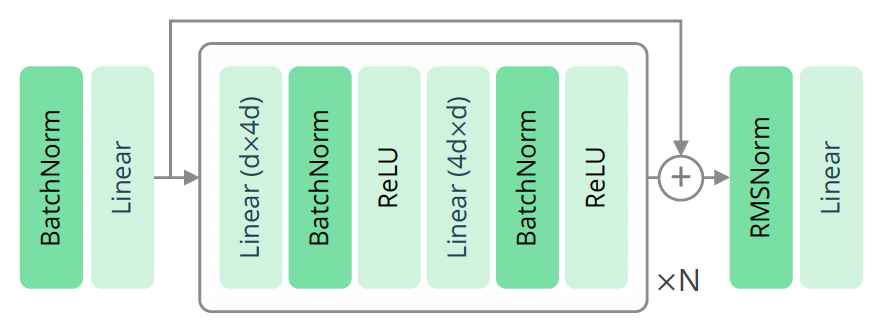
7️⃣ Flash部分中的Stable Trainging :通过特殊的网络结构、Batch Normalization、Cross Batch、Distributional Critic等机制,使训练更stable,可以缓解传统强化学习由于小步快跑带来的价值评估函数不稳定的问题

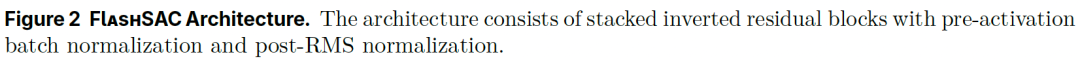
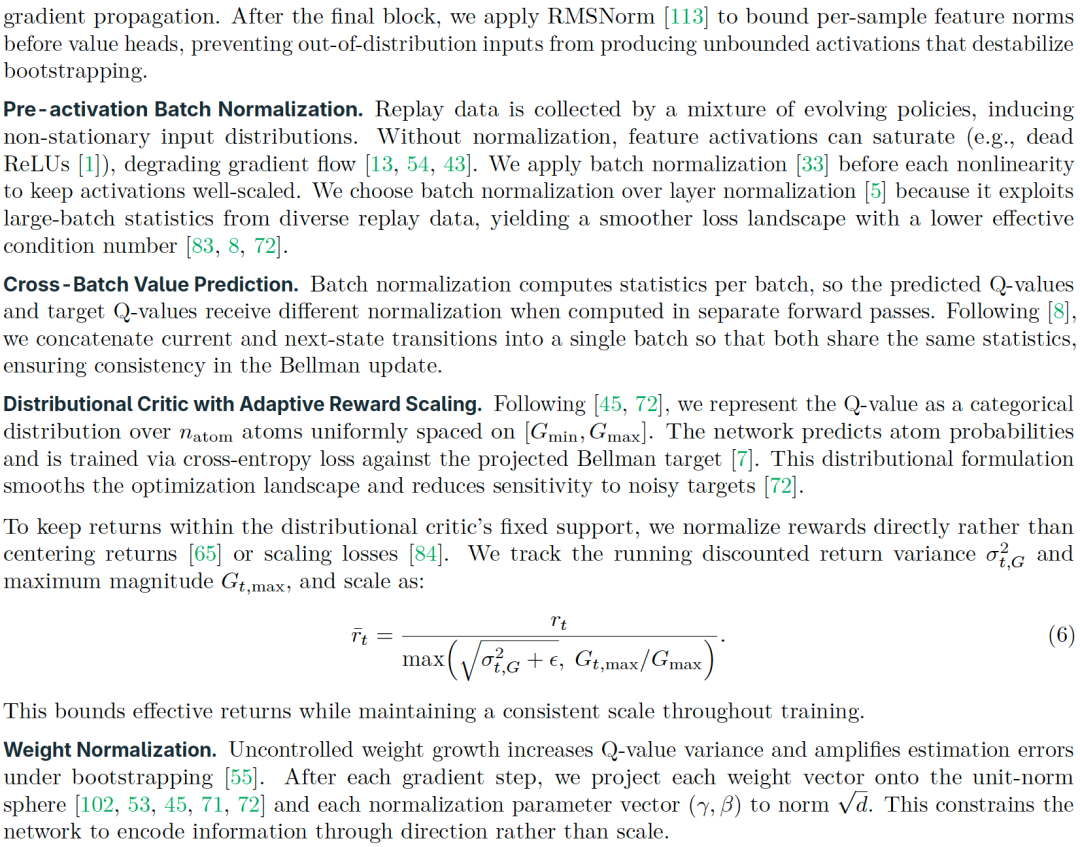
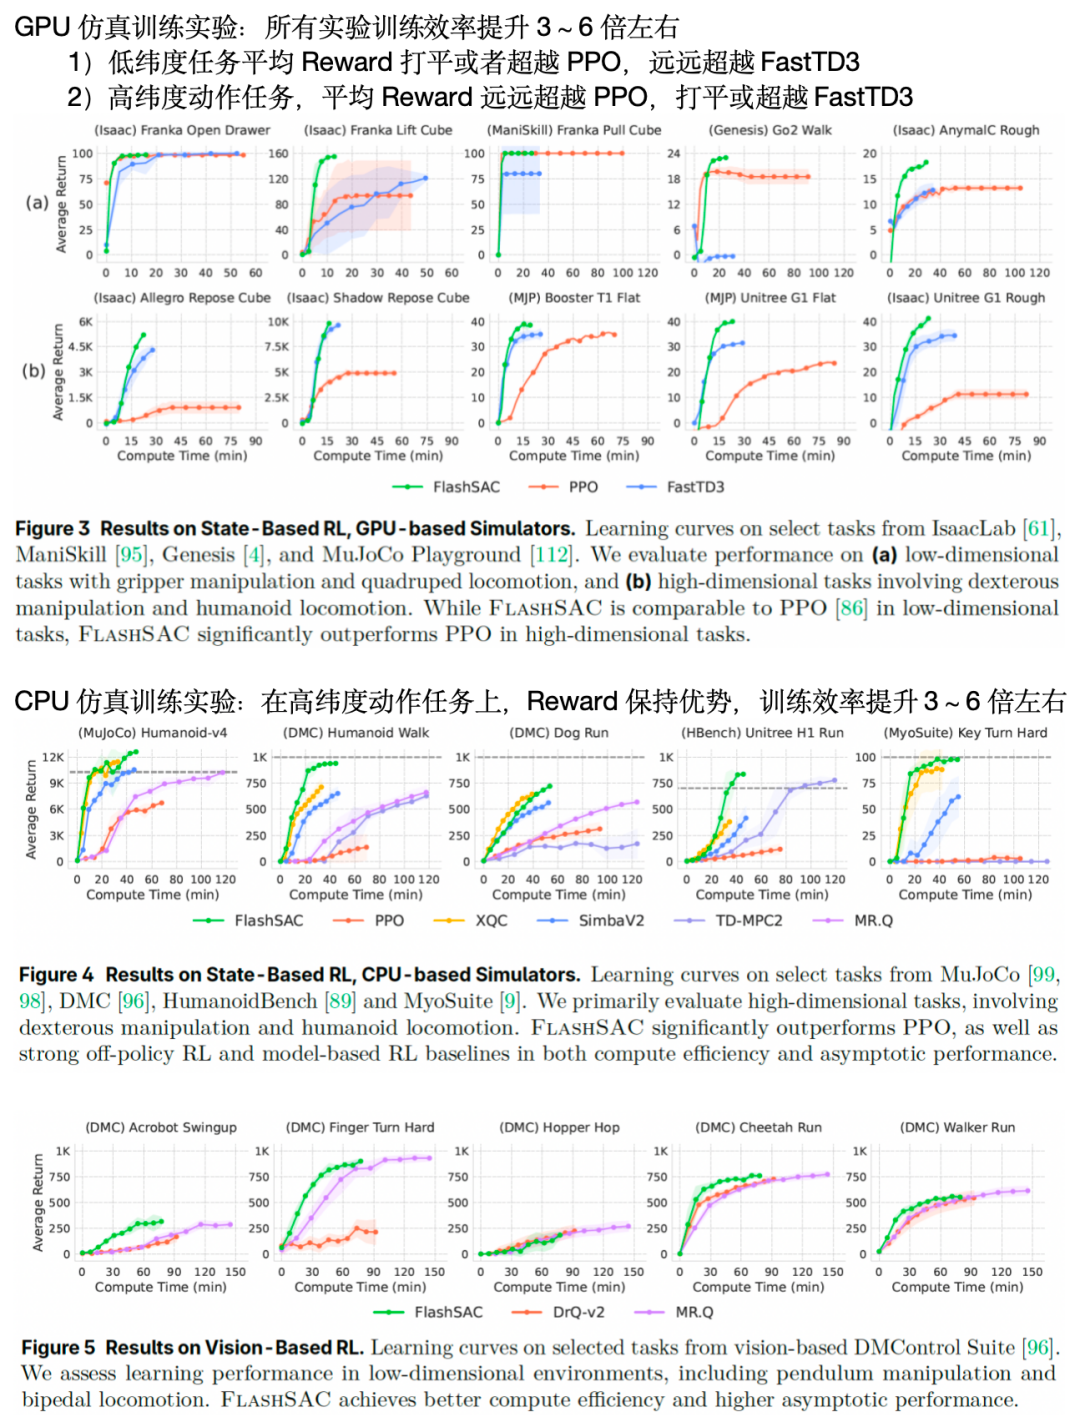
8️⃣ 文章做了各种仿真实验,特别是高纬度任务上,学习效率相比PPO提升高达3~9倍,
1)低纬度任务平均Reward打平或者超越PPO,远远超越FastTD3
2)高纬度动作任务,平均Reward远远超越PPO,打平或超越FastTD3
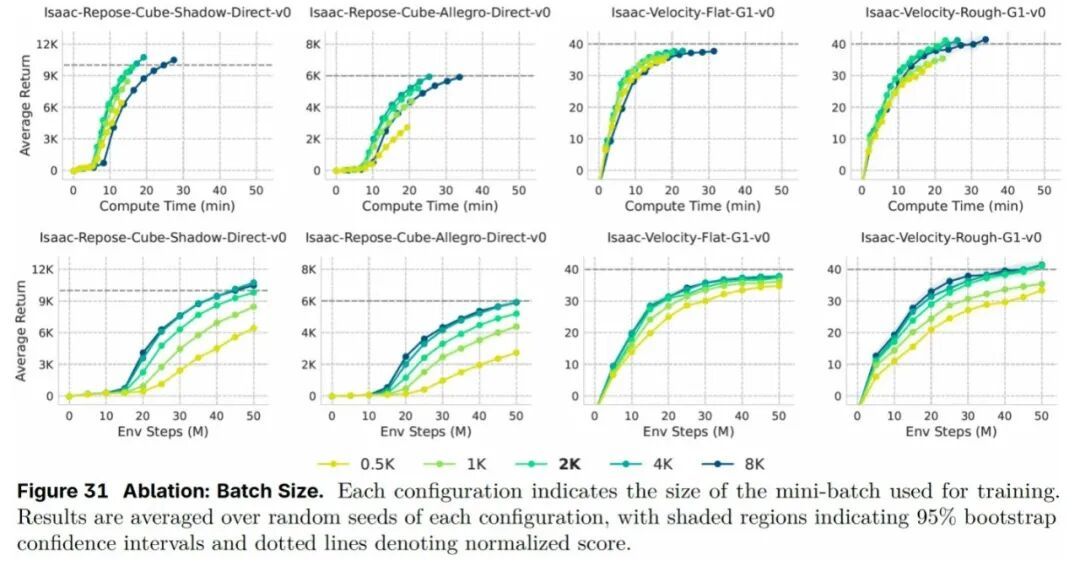
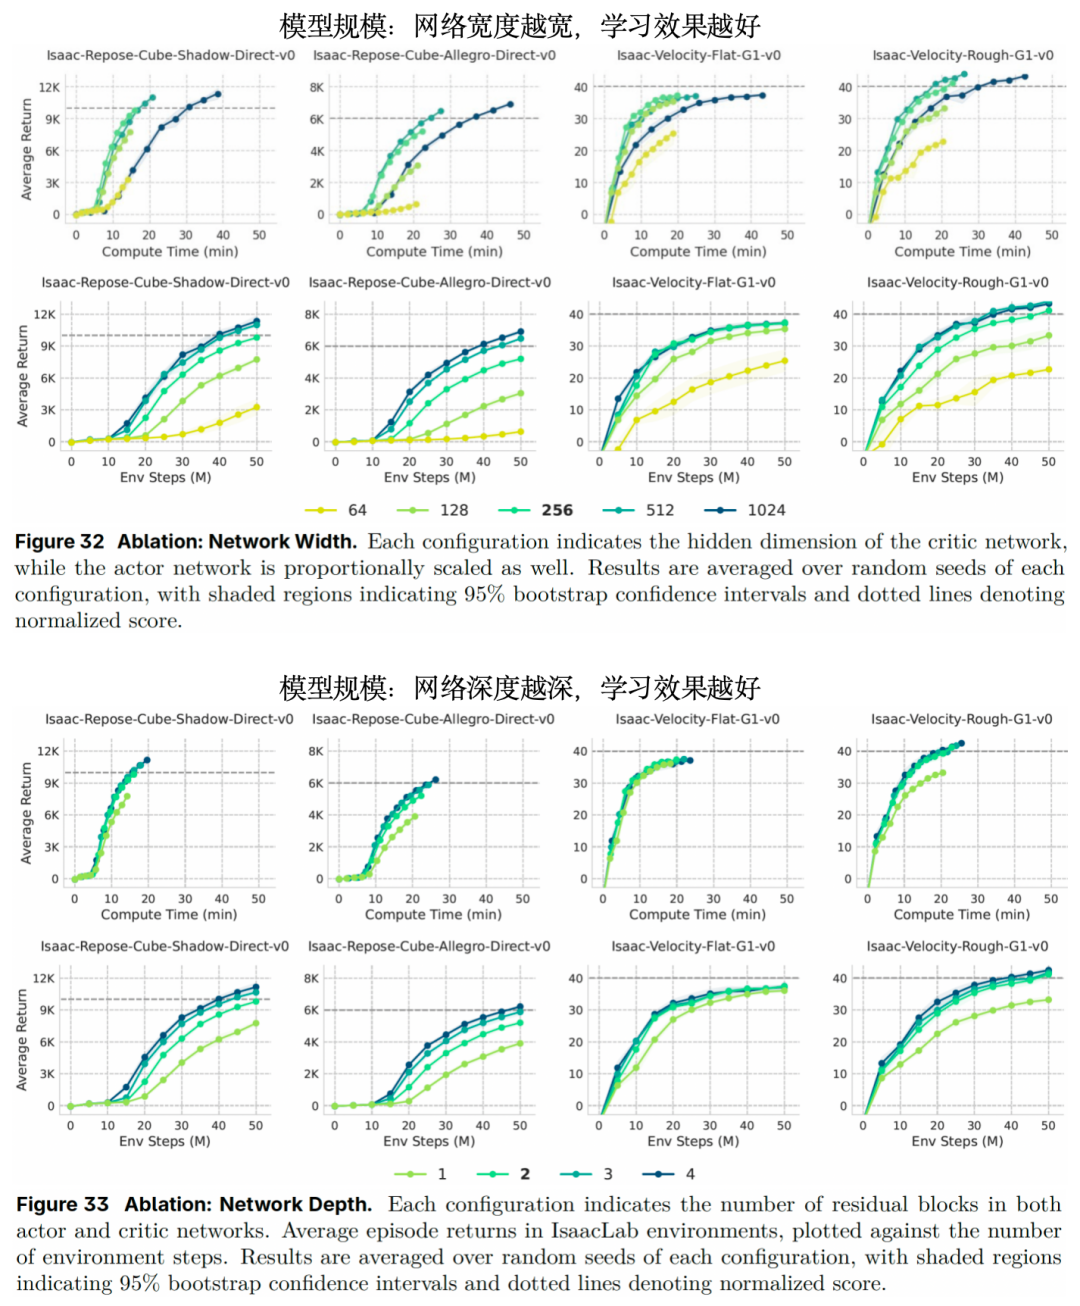
9️⃣ 文章做了Buffer Size与Batch Size消融实验如下,
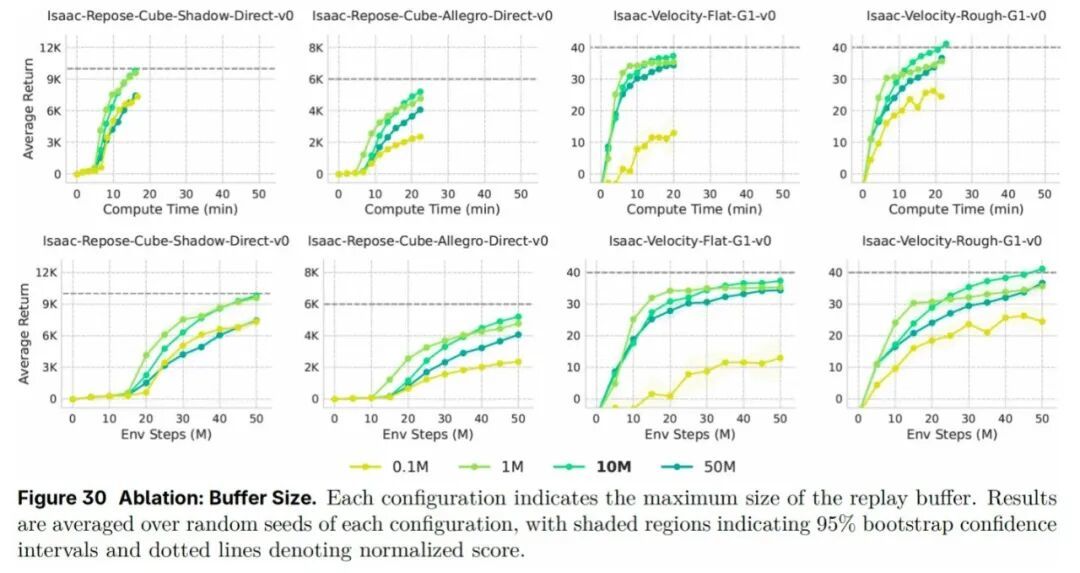
BatchSize 消融实验,Batch size越大效果越好,8K的batch size远远好于0.5K,
原文链接: https://www.leiphone.com/category/private/PCK3EjGOjtoVIVZv.html
