


来源:HUS Media Lab
文章链接:https://mp\.weixin\.qq\.com/s/OwHVh\-5cU6NOE26mz6Psrw
是视频太长,模型"看不远"?还是历史太多,模型"看不广"?
我们发现,这两个瓶颈并不独立,而是会相互放大。据此,我们提出 STAP,让模型在统一框架里既"看得远",又"看得广"。
论文标题:Seeing Further and Wider: Joint Spatio-Temporal Enlargement for Micro-Video Popularity Prediction
研究机构:华中科技大学等
录用会议:ACM MM 2026
代码链接:https://github\.com/AI4SS/STAP
论文链接:https://arxiv\.org/abs/2604\.20311
时间维度上,主流方法通常只对 20 帧左右的短窗口稀疏建模。但一条微视频动辄上百帧,与流行度预测密切相关的语义亮点——一次反转、一个高光片段——往往稀疏散布在整个时间线上,短窗口很容易整段错过;想要全序列稠密建模,计算代价又不可接受。
空间维度上,检索增强方法将历史样本存入扁平记忆库,记忆库随样本量线性膨胀:检索代价与检索噪声同步上升,冷启动场景尤其乏力。
更麻烦的是,这两个瓶颈会相互放大:时间感知不足会降低查询表示的质量,检索随之失准;充满噪声的检索又会把误导性上下文引入时间建模。由此,时间感知与空间检索形成了相互放大的负反馈循环。
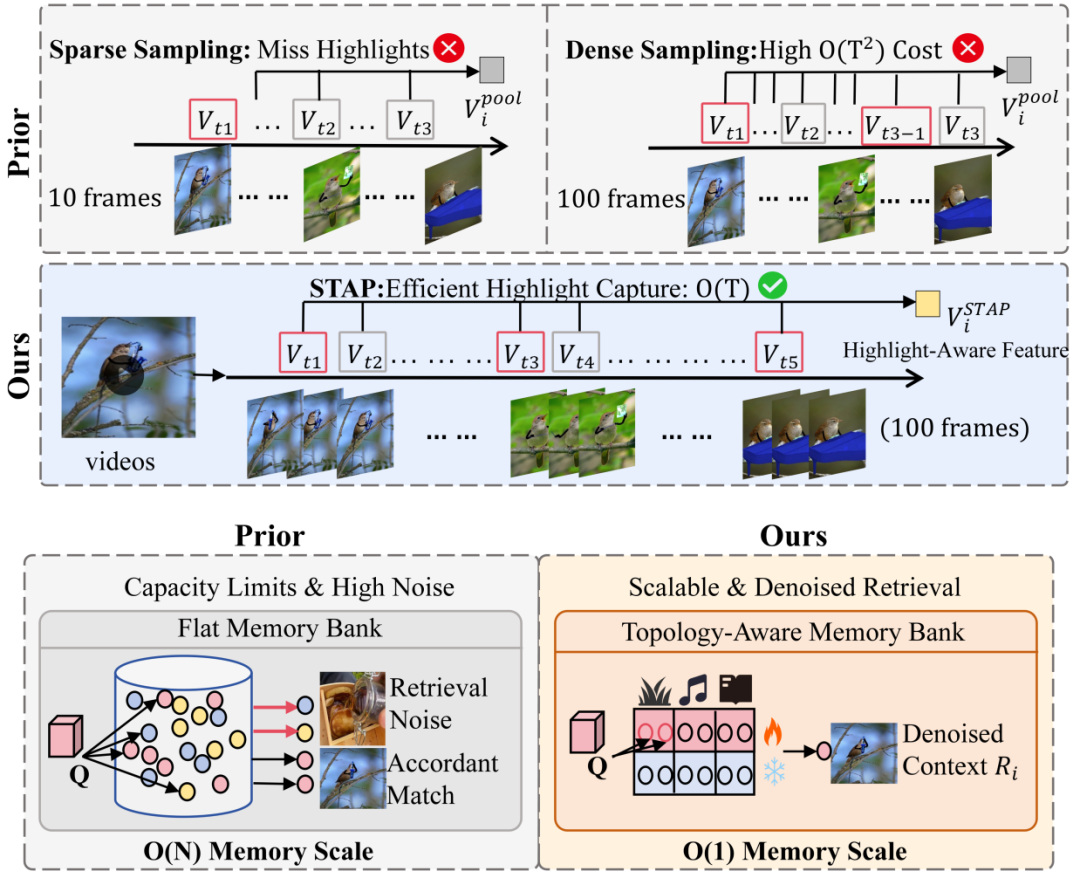
论文给出的答案,不是把两个瓶颈分开修补,而是在同一个框架里联合扩展:
时间扩展的关键是"亮点感知":不把计算资源平均分摊给每一帧,而是先识别哪些帧对流行度预测最重要,再对关键帧密集计算、对平淡片段快速略过,在可控计算开销下,将时间建模范围从典型的约 20 帧扩展至最高 100 帧。
空间扩展的关键是"拓扑感知":模型不再面对随历史样本数量线性增长的扁平记忆库,而是在固定大小的"流行度 × 主题"原型网格中完成路由,仅聚合 Top-5 个最相关记忆槽位,从而降低大规模历史检索带来的冗余与噪声;随着历史知识持续积累,记忆槽位规模无需随历史样本数量线性增长。
两条通路深度耦合:时间扩展产出的查询表示,正是空间检索的输入。两者由原本相互拖累的负反馈关系,转变为相互支撑的协同增益:更完整的时间表示提升检索质量,更可靠的历史上下文又进一步改善最终预测。
STAP 整体分三步:先做时间扩展,把长视频编码成"亮点感知"的视觉特征;再做空间扩展,从拓扑感知记忆库里检索相关历史;最后融合视觉、文本、检索三类特征预测流行度。
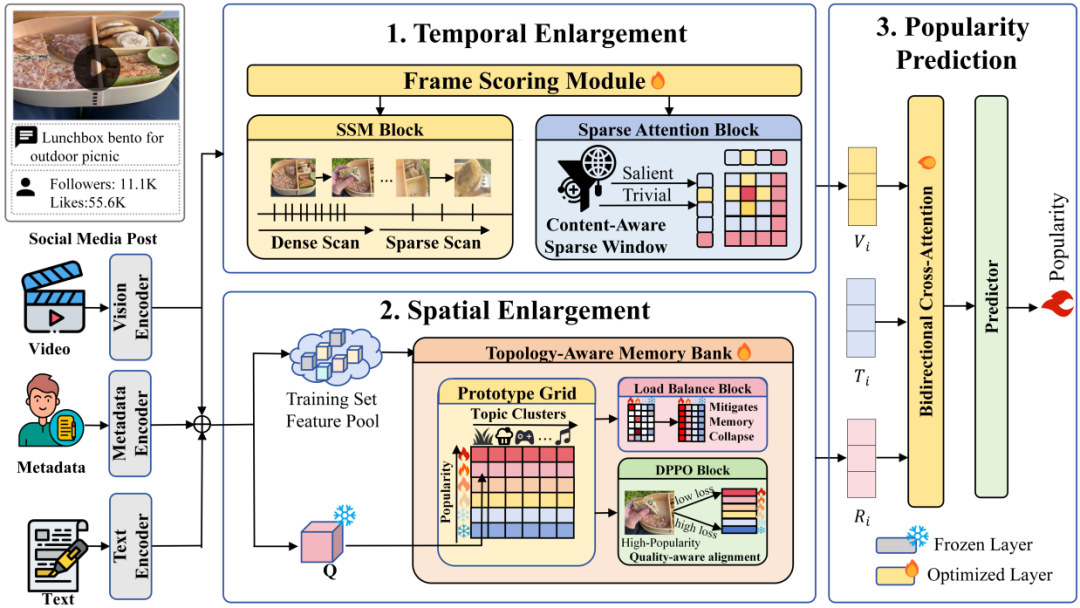
时间扩展:亮点感知的长序列建模
时间扩展要解决的矛盾是:微视频的流行度亮点稀疏散布、语义密度极不均匀——固定稀疏采样会错过亮点,全序列稠密建模代价又不可接受。
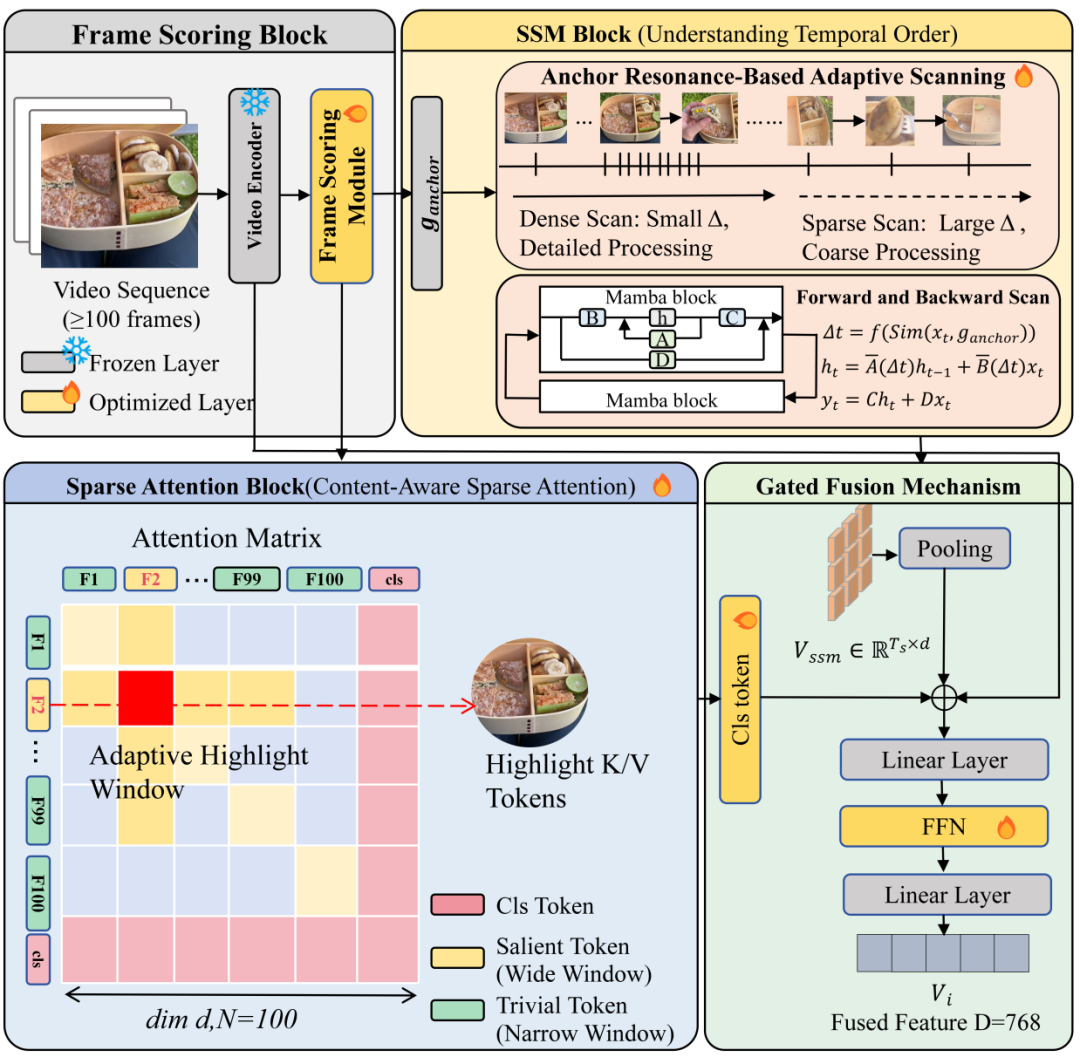
相邻帧变化越明显,通常意味着新的视觉信息出现。STAP 利用轻量 MLP 为每帧计算重要性分数:相邻帧变化越大权重越高,静态冗余帧权重被降低,再由所有帧加权聚合成一个全局语义锚点。
SSM 分支负责保留长程时序,并根据"锚点-帧相似度 + 帧重要性"动态调整扫描粒度:重要帧细看,平淡片段快速略过;稀疏注意力分支则捕捉显著帧之间的远距离交互,为重要帧分配更大的注意范围,避免全局注意力随序列长度产生平方级计算开销。最后,两路特征通过门控机制自适应融合,形成最终的视频表征。
空间扩展:拓扑感知记忆库
空间扩展针对的是长尾分布下的检索失稳。STAP 构建拓扑感知记忆库(Topology-Aware Memory Bank):
STAP 不再将历史视频简单堆叠进扁平记忆库,而是先按真实流行度划分为 6 个分区,再在每个分区内部聚成 32 个主题簇,构建"流行度 × 主题"的二维原型网格,将大规模历史样本组织成结构化知识。
面对新视频,模型在原型网格中完成路由,仅聚合 Top-K 个最相关的记忆槽位;新的历史知识到来时,也无需不断新增槽位,而是更新已有原型表示,因此记忆槽位规模无需随历史样本数量线性增长。训练过程中,负载均衡与 DPPO 进一步稳定路由并增强其对流行度排序的感知能力。
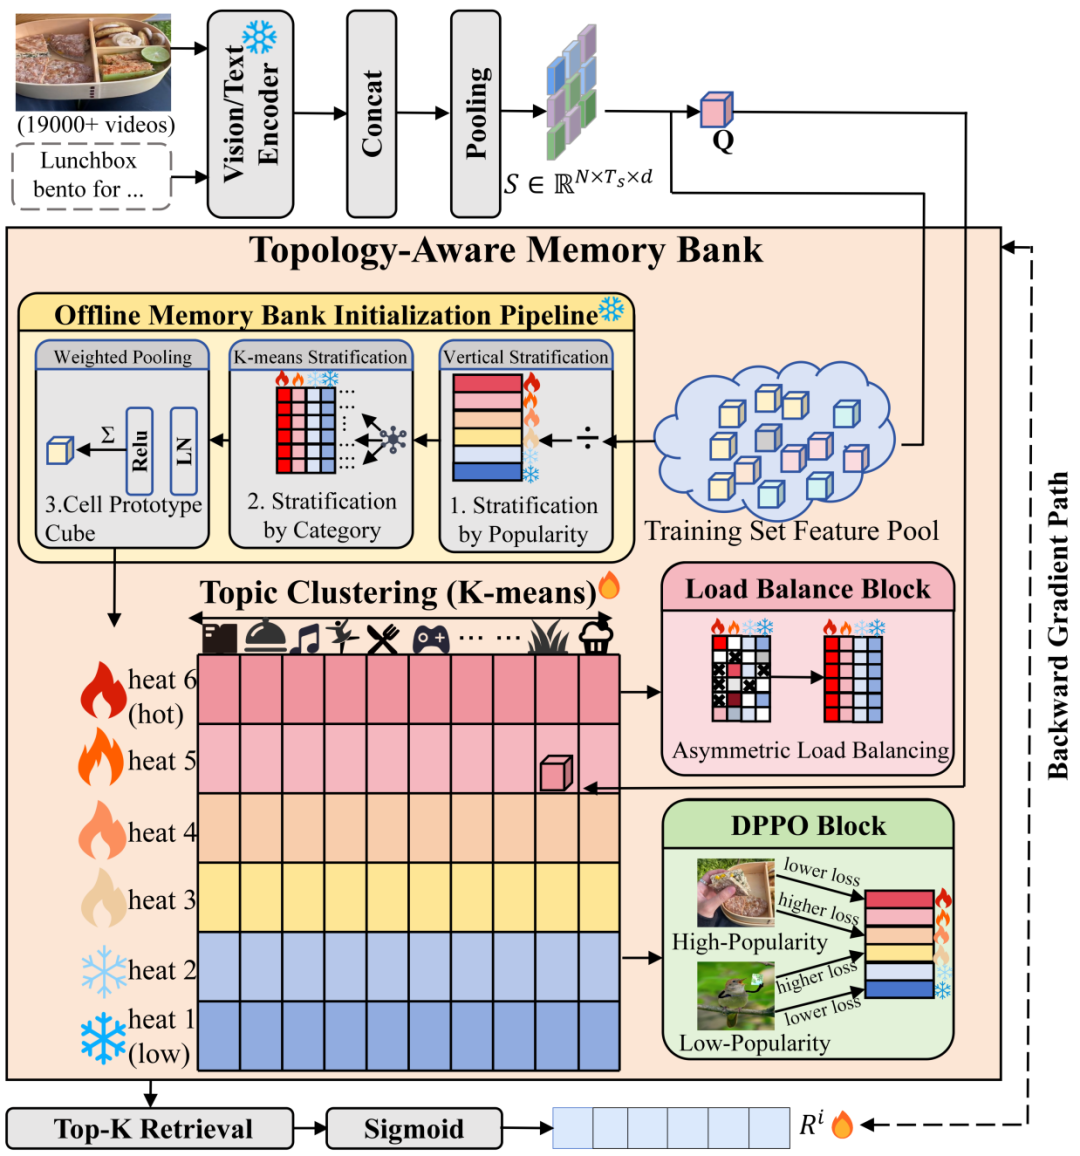
最终,STAP 将时间扩展得到的视频表示与空间扩展检索到的历史知识共同融合,并结合文本等多模态信息完成最终的流行度预测,整个框架进行端到端联合优化。
实验在三个真实数据集上展开:MicroLens(19,307 条)、SMPD-video(4,000 条)、Informs(1,846 条),对比特征工程与深度多模态两类共 11 个基线,指标为 nMSE、MAE 和 SRC。
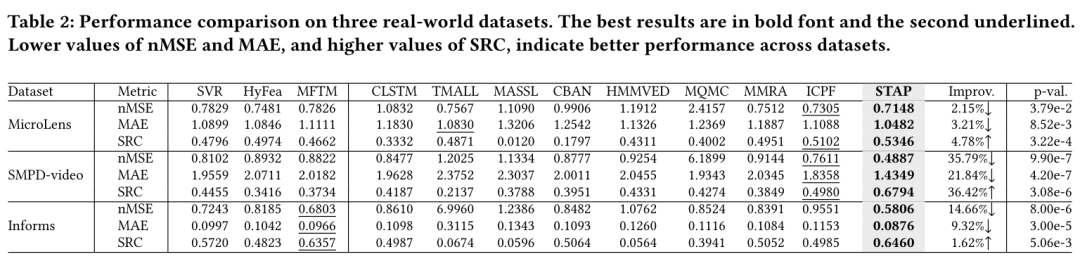
实验结果显示,STAP 在三个真实数据集、三类评价指标上均取得最佳结果。其中在 SMPD-video 上,相较最优基线,nMSE 降低 35.79%、MAE 降低 21.84%、SRC 提升 36.42%。此外,在历史视频不超过 3 条的冷启动用户中,STAP 仅使用 Top-5 检索,MAE 与 SRC 便已超过采用 Top-10 检索的 MMRA 与 ICPF。
消融实验进一步表明,各关键组件均对最终性能有所贡献;去掉任一模块或压缩记忆库容量都会带来不同程度的性能退化;且训练数据越少,STAP 相对基线的优势越明显。
总的来说,STAP 的思路很直接:一边让模型把视频"看得更远",一边让它从历史内容中"看得更广"。实验结果也表明,这种时间与空间的联合建模,能够带来更准确、更稳定的微视频流行度预测。
原文链接: https://www.leiphone.com/category/private/Y8bQurWXwqcQdkAW.html
