


来源:林叔说事
原文链接:https://mp\.weixin\.qq\.com/s/dF\_niCtYfqjwld2AKRJwVw
拿起手机,对着你的房间随手录一段10秒钟的视频。
几分钟后,屏幕里出现了一个活生生的三维物理世界,原先的像素录像成了可以交互的场景。
桌子、椅子、花盆、甚至一只正在扑腾翅膀的鹦鹉,全都被拆解成了独立的实体网格。
你可以把一台虚拟机械臂丢进去:推一把花盆,花盆会顺着桌面滑行、跌落、摔在地上;
把椅子换个摆法,碰撞、倾倒和重力支撑全部被物理引擎从头计算。
原视频没有被倒放或快进,现实世界被“数字化克隆”成了一个可以肆意交互的物理沙盘。
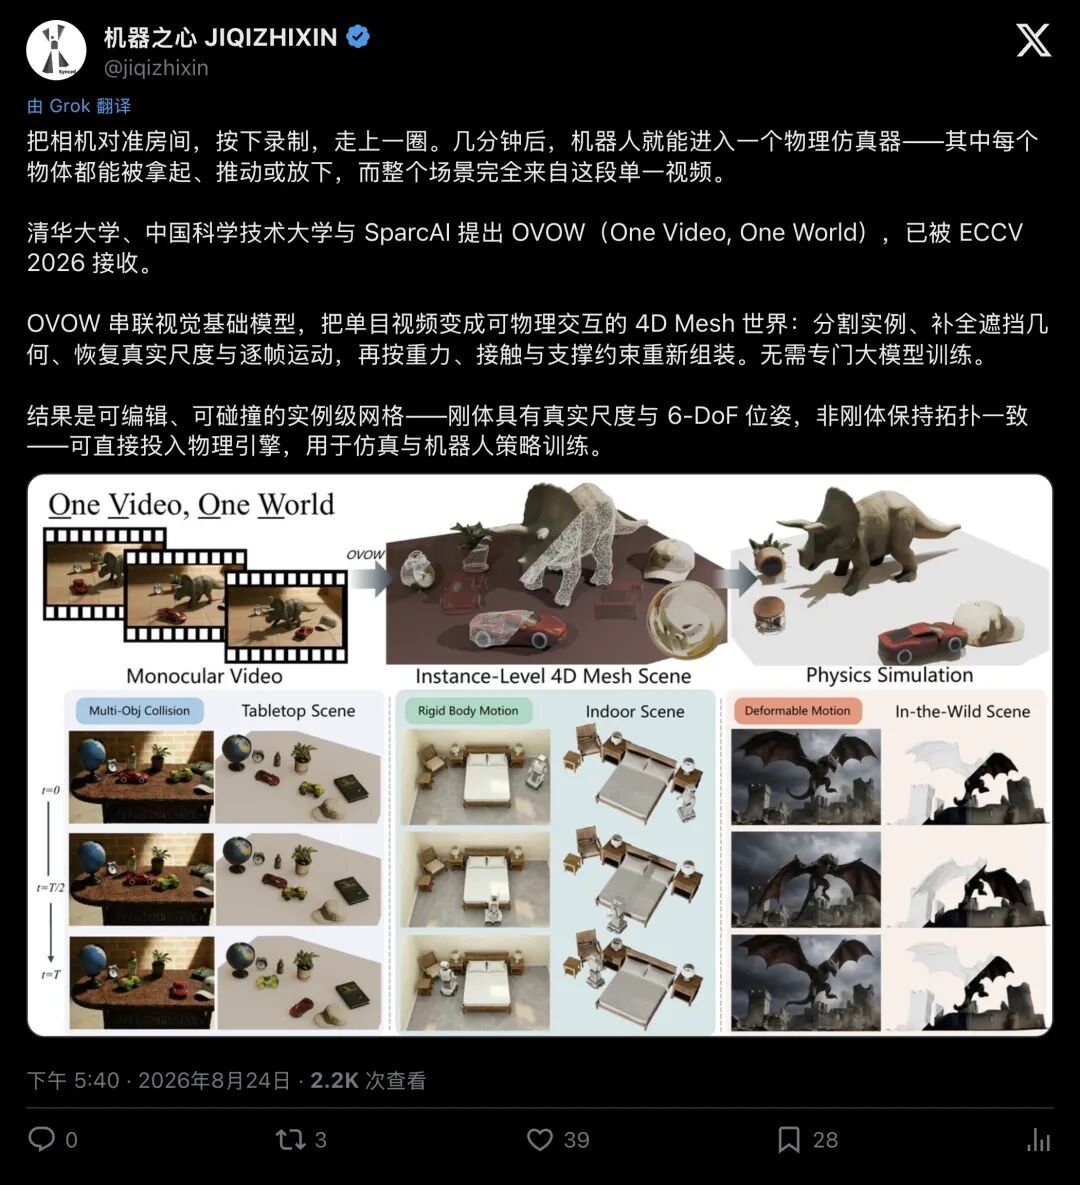
▲ 机器之心英文推文:从单目视频一键生成物理可交互的4D仿真世界
这项由清华大学、中国科学技术大学与 SparcAI 联合团队推出的重磅研究,OVOW (One Video, One World),刚刚被计算机视觉顶级会议 ECCV 2026 接收。
项目公开后,海外科技博主很快注意到它:系统完全免训练(Training-free),输入只需普通相机拍摄的视频,就能把现实场景转成物理引擎可用的资产。
致命落差:好看的“海市蜃楼”,救不了真实的机器人
为什么这项工作会让整个具身智能(Physical AI)领域如此兴奋?
因为过去几年,我们全被“视觉欺骗”了
看看过去大火的神经辐射场(NeRF)和3D高斯(3DGS):哪怕是一段单目视频,算法也能生成光影绚丽、能360度随意旋转视角的动态场景。
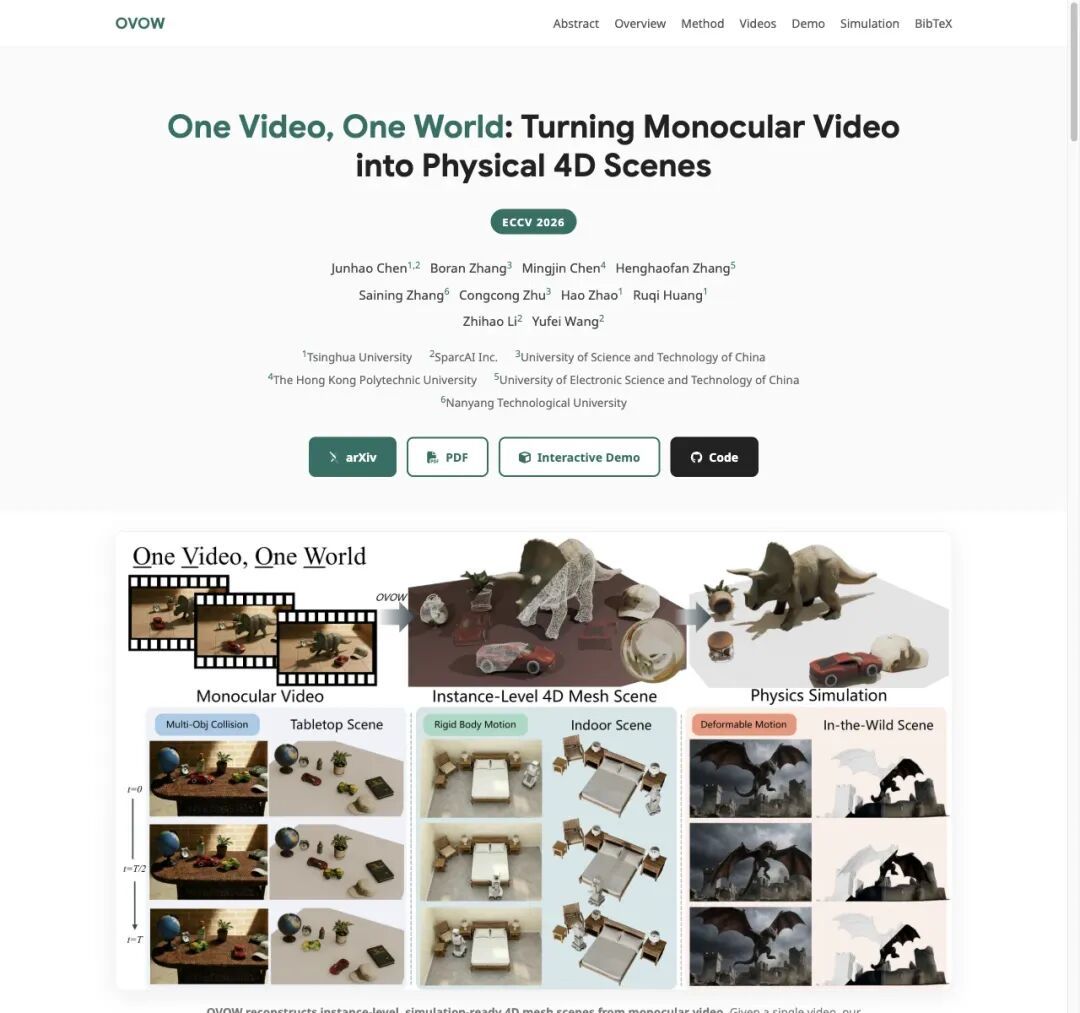
▲ OVOW 官方项目主页:输入单目视频,输出可物理交互与编辑的4D Mesh
但如果你把这个场景丢给机器人,悲剧立刻发生:
它只是一团没有厚度的发光粒子。
它无法拆分实体。
它不懂物理规律。
这就好比你给机器人看了一幅极其逼真的《蒙娜丽莎》油画,却命令它:“把画里女人的项链摘下来。”
机器人继续进化的瓶颈,在于它能否“摸得着”。
物理仿真引擎(如 MuJoCo、Isaac Gym、PyBullet)需要严格封闭的水密网格(Watertight Mesh)、带有真实物理尺度的独立物体,以及符合重力与接触关系的装配结构,发光的点云无法满足这些要求。
OVOW 做到的,正是填平这个横跨在“视觉感知”与“物理动作”之间巨大的断桥。
暴力美学:不用炼丹,把世界大模型拆解重组
很多人第一反应是:这得烧多少张 H100,训练多大的通用世界大模型?
答案却让所有人大跌眼镜:OVOW 竟然是完全免训练(Training-free)的!
团队没有从零烧钱炼制黑盒大模型,而是以一种极致精妙的系统工程思维,把当前全球最顶尖的视觉基础模型串成了一条严丝合缝的“四级火箭”。
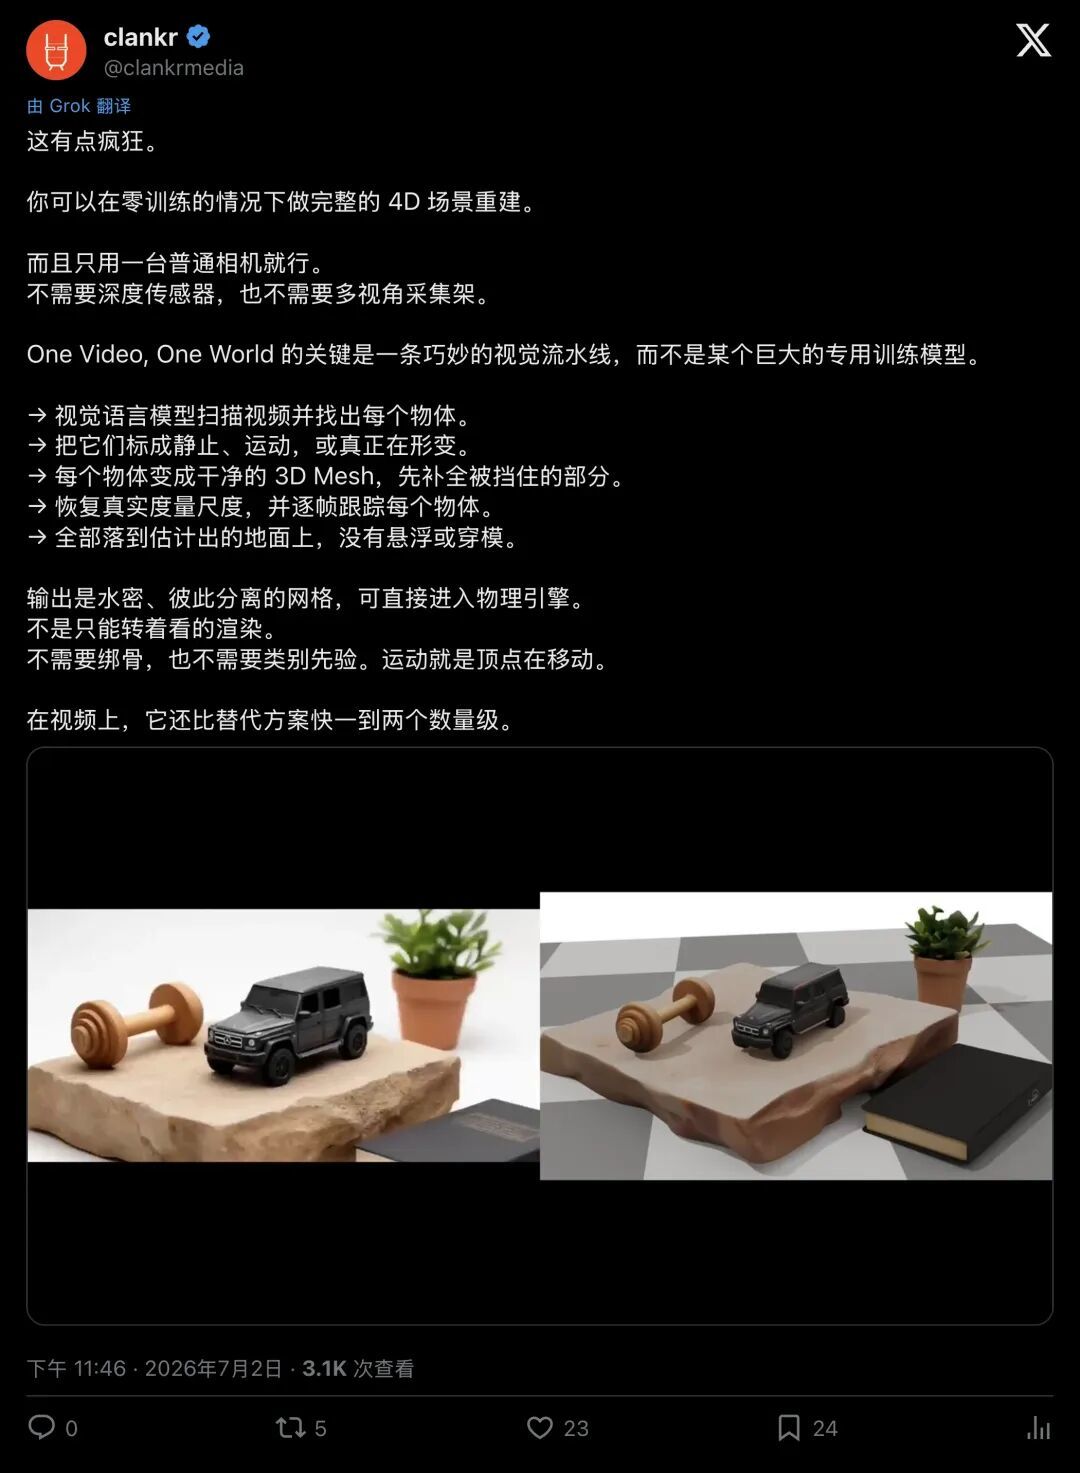
▲ 科技博主 clankr 拆解 OVOW 的核心优势:零训练、全流程自动化、速度碾压同类
整个流水线的运转就像一家全自动化的三维数字化工厂:
第一步:视觉脑力识别(谁是谁?怎么动?)
多模态大模型(如 Qwen3-VL)扫过视频,像侦探一样标记出画面中的每一个物体,给它们起名,并把运动模式严格分类:静止的、刚体运动的(如滑动的玩具车),还是发生非刚性形变的(如拍翅膀的飞鸟)。
接着,分割模型(SAM3)精准切下每一帧中物体的像素掩码。
第二步:遮挡脑补与单体重建(给物体造一副好皮囊)
现实中物体往往会被桌子、双手挡住一部分。
系统自动挑选物体露出面积最大的关键帧,利用生成模型补全被遮挡的背面,再生成完整的规范3D网格。
针对动物或人体等形变物体,系统通过拓扑一致性算法,保证同一只动物在所有时间帧内的网格顶点始终对齐,绝不会发生这一秒长出三只角、下一秒四肢乱飞的恐怖畸变。
第三步:时空位姿与非刚性追踪(捕捉每一帧的骨骼与运动)
不做繁琐的人工骨骼绑定,也不预设物体的关节模板。
系统通过“渲染,匹配,优化”的循环迭代,恢复出物体每一帧的 6 自由度位姿(平移与旋转),将整体运动与局部顶点形变干净利原地剥离。
第四步:物理法则接地(让一切稳稳落在地面上)
这是整套管线最神来之笔的一步
刚重建出来的物体往往会在空中漂浮,或者互相穿模。
OVOW 会自动估算场景的真实地面与重力方向,施加物理接触约束:悬空的下压贴地,穿模的弹开分离,错误的支撑关系被强制校正。
最终导出的,是一套可以直接拖进物理引擎的 URDF 与全场景带动画 GLB 资产包!
▲ GitHub 上公开的 SparcAI-Inc/OVOW 代码仓库
反事实推演:从“录像回放”到“平行宇宙”
看懂了上面的流程,你就能明白 OVOW 带来的一场质变:它赋予了视频资产以“反事实推演”的能力。
以往你看一段视频,小车从左开到右撞倒了积木。
但在 OVOW 重建出的世界里,你可以随心所欲地修改剧本:
按下物理引擎的运行键,全新的碰撞轨迹、倾倒角度与反弹路径会被物理引擎重新计算出来。
这就是具身智能梦寐以求的 Real2Sim(现实到仿真) 闭环。
以往训练机器人,要么靠人类工程师手动在仿真软件里辛辛苦苦“建模打光摆零件”,效率极低;
要么让实体机器人在真实世界里摔打几万次,成本极其高昂。
未来若能批量处理日常家庭视频、工厂监控和户外记录,这条流水线有望生成大量可交互、可碰撞、可重新组合的机器人虚拟训练场。
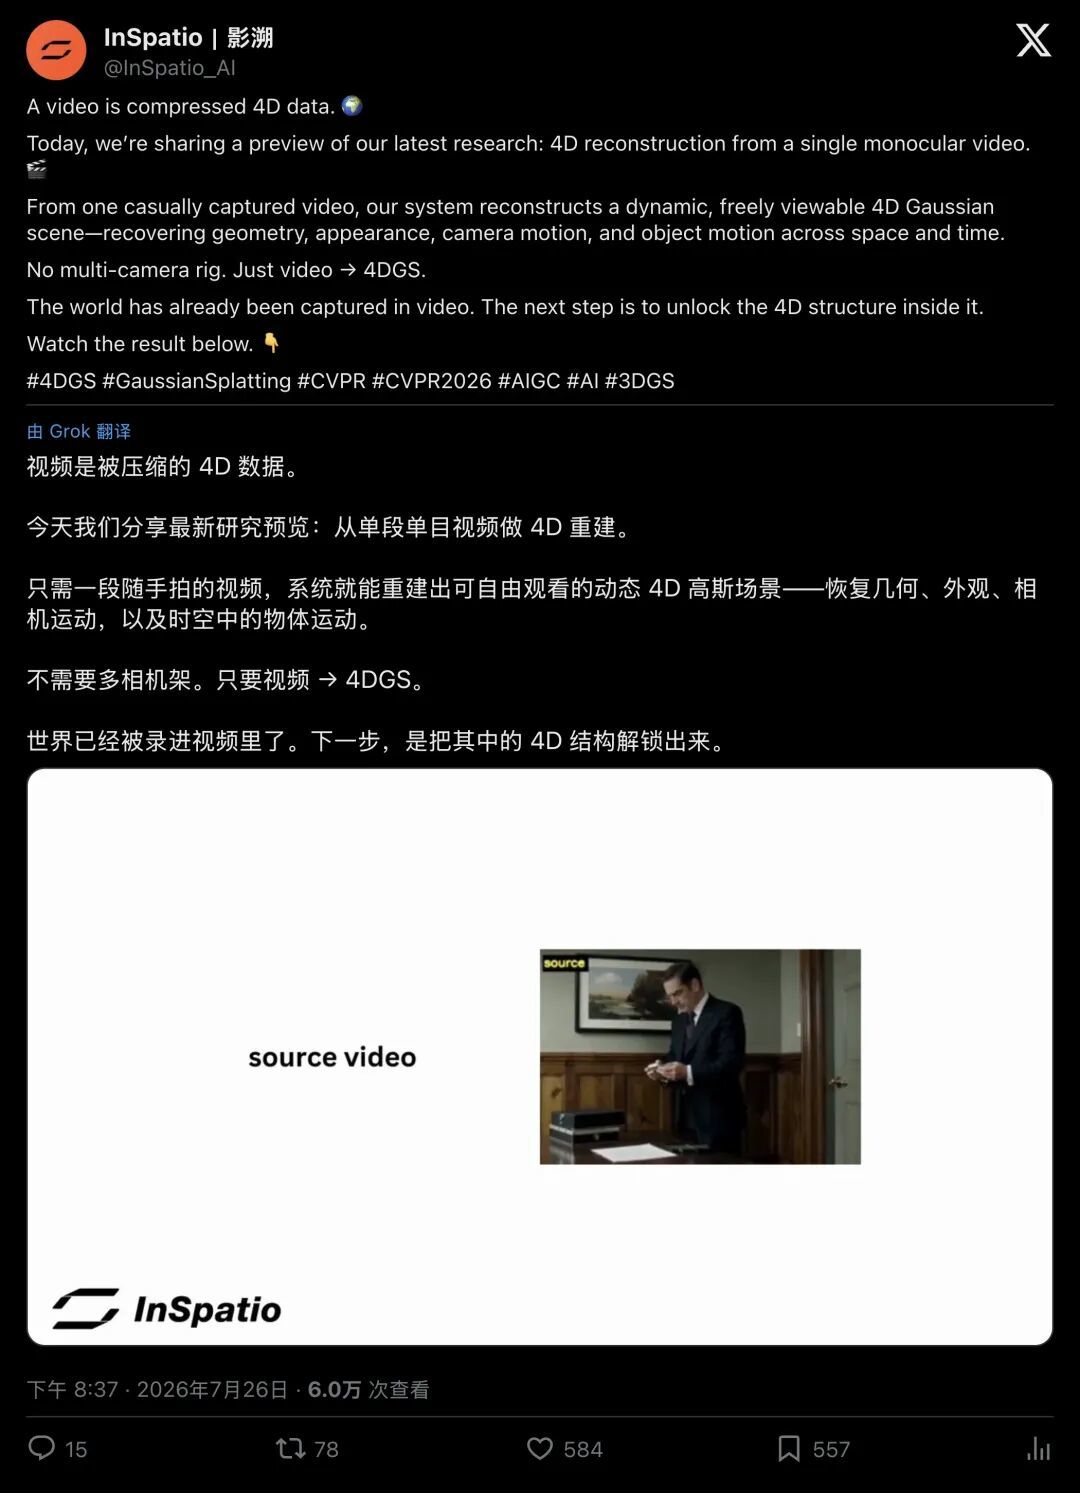
▲ 社区中并行的4D高斯路线(如InSpatio),主打视觉观赏,而OVOW主攻物理级交互
数据说话:比传统方案快一到两个数量级
为了证明系统的硬核实力,研究团队在合成与真实基准上进行了全方位评测。
在包含刚体运动的 4D 场景基准(OVOW-4D-Scene-Bench)上,以往的顶尖方案因为无法理解时序连续性,只能单帧独立抽取处理,不仅耗时漫长,生成的物体在时间轴上更会疯狂抖动。
而 OVOW 将计算成本大幅分摊,达到了惊人的 约 3.35 秒/帧,比基线方案快了整整 1 到 2 个数量级!
运动分类准确率
时空位姿恢复率
重力仿真稳定率
不论是桌面上错落摆放的咖啡杯、玩具车,还是户外飞驰的飞机与摆渡车,OVOW 都能以极高的成功率还原出符合物理逻辑的独立网格世界。
坦白局:系统仍有明确边界
当然,论文作者非常诚恳地指出了这套系统的边界。
作为一套依赖下游基础模型的流水线,它具有典型的“短板继承效应”:
分类错误会雪崩
极端光学仍是死穴
复杂微观物理尚未覆盖
不包含背景全局建模
它无法瞬间生成《黑神话:悟空》的完整开放世界,目前的定位是一台从真实视频生产交互物理资产的高效自动化机床。
终局之战:人类的世界,正在被解压缩
回顾过去一年的 AI 演进,一条暗线清晰得令人战栗:
有人在卷 4D 视觉重建(如 Shape of Motion,追求每一束光的折射);
有人在卷 单图物理资产生成(如 PhysX-Anything,单张图拆解机械关节);
还有人在卷 交互式世界模拟器(如 Interactive World Simulator,尝试在像素空间预测未来)。
而 OVOW 的出现,标志着这场大混战正在合流。
视频,本质上是人类对四维物理世界进行的一场高度压缩。
过去的几十年,我们用摄像头把丰富绚烂、充满重量、阻力与重力的三维现实,降维压成了一张张平面的 2D 像素胶片。
而现在,以 OVOW 为代表的空间智能革命,正在把这层被压缩了几十年的像素外壳暴力撕开,
把光影还给空间,把重量还给物体,把未来还给物理。
一个只要举起手机拍一圈,就能随意创造、肆意推倒的数字物理大航海时代,已经轰然撞门而入
原文链接: https://www.leiphone.com/category/private/kP3iWMdazfLkqQUr.html
