


来源:公众号“无界动力”
原文链接:https://mp.weixin.qq.com/s/sI0EiAur3PbDQ54ka_SJ5Q
作为深耕通用具身智能技术研发的团队,无界动力联合上海交通大学人工智能学院 AutoLab 团队,正式推出全新通用导航评测基准OmniNavBench,相关成果已被机器人领域顶会 RSS 2026 收录。该基准直击当前具身导航领域评测体系碎片化、仿真与真实场景脱节、机器人适配性单一等行业痛点,打造出业内首个支持跨技能协同、跨机型泛化、真人行为驱动的一体化评测平台,为通用导航算法的迭代与落地树立全新标准。
论文标题:Beyond Isolation: A Unified Benchmark for General-Purpose Navigation
论文地址:https://arxiv.org/abs/2605.09441
项目主页:http://omninavbench.cloud-ip.cc
开源仓库:https://github.com/AutoLab-SAI-SJTU/OmniNavBench
- 现存导航评测体系,究竟存在哪些短板?
具身导航是支撑各类智能机器人运行的核心基础能力,发展至今已衍生出丰富的任务形态:从早期的视觉语言导航(VLN)、点位目标导航(PointNav),逐步拓展至物体目标导航(ObjectNav)、社交导航(SocialNav)、人机跟随(Human Following)以及具身问答(EQA)等多元场景。
如今,业内已经涌现出 Uni-NaVid、OmniNav 等一批主打 “通用统一” 的导航模型,算法层面正朝着多任务融合的方向稳步前进。但与之相悖的是,行业配套的评测体系依旧处于各自孤立的状态。
目前主流评测基准均为单一任务定制开发:视觉语言导航依托 R2R 数据集测试,物体导航使用 HM3D-OVON 基准,具身问答则基于 OpenEQA 开展验证。各个平台相互独立,仅能考核模型的单项技能,完全无法模拟真实场景中,智能体需要连贯切换多项导航能力的复杂工况。
除此之外,现有评测体系还存在两大核心短板: 第一,行为模式脱离真实应用。绝大多数基准的运动轨迹由最短路径算法自动生成,这类理想化轨迹缺少人类导航过程中试探观察、预判避让、路径微调等自然行为,导致模型在仿真环境中表现优异,落地到真实机器人后性能大幅下滑。 第二,机器人机型适配性单一。现有评测大多仅针对轮式机器人设计,无法检验同一套导航算法在四足、人形等不同构型机器人上的运行效果,难以评估算法的通用泛化能力。
而我们此次打造 OmniNavBench,核心目标就是补齐上述短板,构建一套贴合产业落地需求、全面客观的通用导航评测新标准。
- 全面解读:OmniNavBench 一体化评测基准
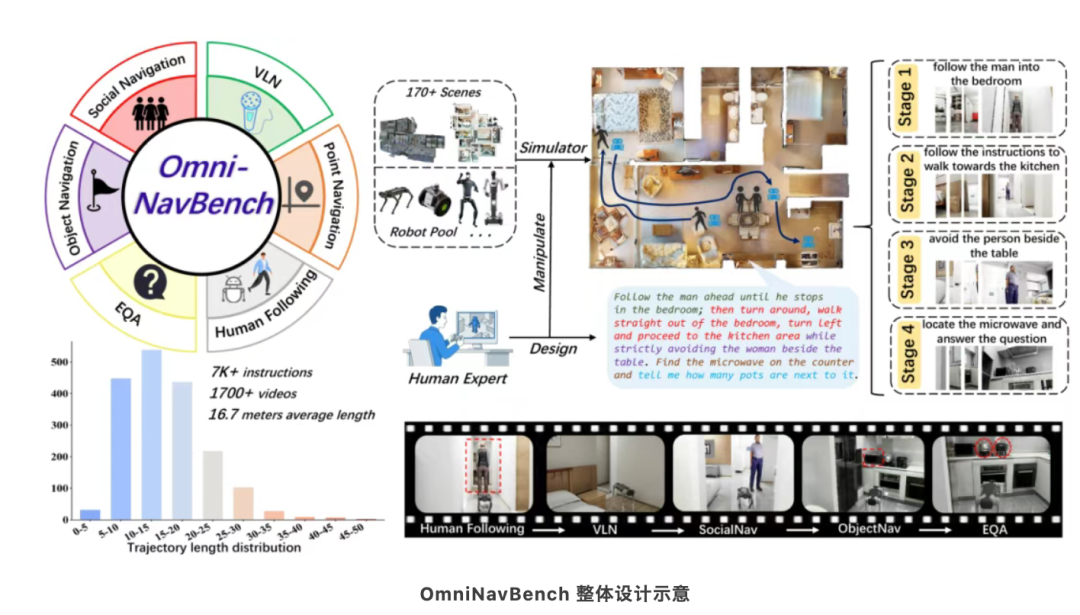
组合式指令:单任务串联多项导航技能
区别于传统基准 “单任务单指令” 的模式,OmniNavBench 创新性采用组合式指令设计,单条任务指令会整合 2 至 4 种及以上不同类型的导航子任务,要求智能体在连贯的流程中依次完成。
举个典型示例:“跟随前方人员走进卧室,随后转身直行前往厨房,途中避让餐桌旁的行人,找到台面上的微波炉并清点周边锅具数量。” 这条指令依次涵盖人机跟随、视觉语言导航、社交导航、物体目标导航、具身问答六大能力原语。整套基准按照子任务数量划分难度梯度,能够层层递进地检验模型多任务衔接、长时序规划的综合能力。
多机型兼容:一套指令适配三类主流机器人
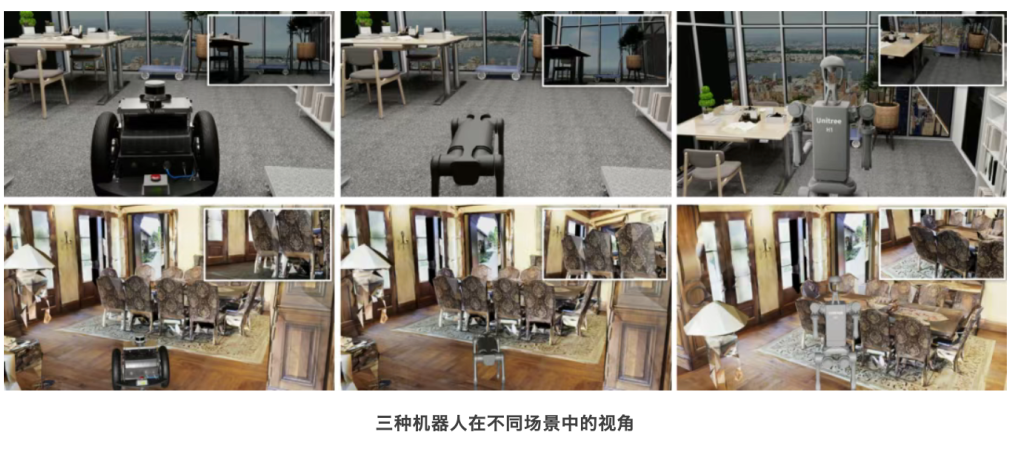
OmniNavBench 基于 NVIDIA Isaac Sim 仿真平台搭建,原生支持轮式、四足、人形三种形态差异极大的机器人。同一套测试指令无需修改算法代码,即可在三类机器人上完成全流程评测,直观检验算法对不同运动结构、不同视觉视角的适配能力。
平台同时兼容航点级控制、速度指令控制以及离散动作三大主流控制接口,全面覆盖当前机器人主流控制方案,进一步提升评测的通用性。
真人遥操作轨迹:还原真实导航行为
整套基准包含1779 条专家轨迹,全部由工作人员通过遥操作方式实地采集,摒弃了传统算法生成的最短路径。轨迹平均行驶长度达 16.7 米,完整保留人类导航时环视观察、预判避障、临时调整路线等真实行为特征。
实测数据显示,人类行驶轨迹与算法最短路径在地标利用等关键维度存在明显差异(如 CityNav 场景中占比 36.3% vs 24.6%),这类细节是训练高鲁棒性导航策略的关键,也是衔接仿真与真机落地的重要纽带。
大规模场景与多样化指令:强化跨域泛化测试
场景层面,基准共计收录170 个场景,由 85 个 GRScenes 合成场景(家居、商业空间)与 85 个 Matterport3D 真实扫描场景组成,覆盖居家、办公、商圈等主流环境,可充分验证算法的跨场景泛化能力。 指令层面,我们基于 1779 条核心指令,借助通义千问 3-Max 大模型生成简洁版、第一人称视角版、详细版三类风格变体,最终形成7116 条风格化指令,单条指令平均长度为 42 个词汇,全方位考核模型对不同语言表达形式的理解能力。
- 实测验证:主流通用导航模型的真实能力边界
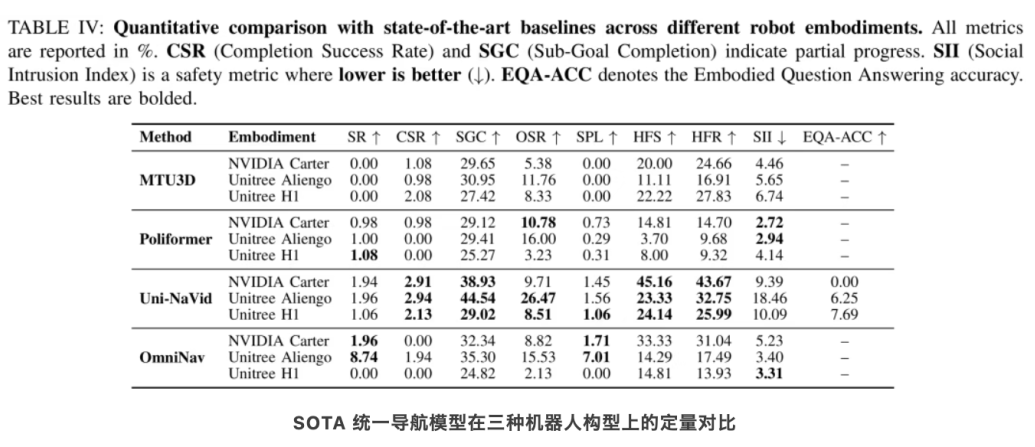
我们选取 PoliFormer、Uni-NaVid、MTU3D、OmniNav 四款业内代表性通用导航模型开展零样本评测,测试结果直观暴露了当前通用导航算法存在的多项核心问题:
结论 1:复杂组合任务下,模型性能出现大幅衰减
所有参与测试的模型,在 OmniNavBench 上的表现远低于其在单任务基准中的测试结果。四款模型整体最高任务成功率仅为 8.74%(OmniNav,四足机器人 Aliengo),多数测试场景成功率不足 2%。该现象在三类机器人构型中普遍存在,证明这是当前通用导航算法的共性短板,并非单一平台适配问题。
结论 2:单项技能达标,多任务衔接能力严重不足
数据显示,多款模型的子任务完成率(SGC)与整体任务成功率(SR)差距悬殊。以 Uni-NaVid 在 Aliengo 机器人上的表现为例,其子任务完成率可达 44.54%,但整体任务成功率仅 1.96%。这说明现有模型能够独立完成各类单一导航任务,但无法在连续流程中顺畅切换多项技能,多任务时序衔接是核心瓶颈。
结论 3:“抵达目标” 不等于 “完成任务”,存在落地最后一环缺陷
模型理论最优成功率(OSR)远高于实际任务成功率,依旧以 Uni-NaVid 为例,其 OSR 为 26.47%,但实际成功率仅 1.96%。这一现象表明,智能体大多可以物理抵达目标区域,但无法精准判断任务终止时机,这也是端到端导航算法在真机落地过程中普遍存在的 “最后一厘米” 难题。
结论 4:动态社交交互能力薄弱,缺乏安全避让意识
人机跟随成功率(HFS)、人机跟随占比(HFR)两项数据整体偏低,四款模型中最优人机跟随成功率仅为 45.16%(Uni-NaVid,轮式机器人 Carter),且在足式机器人上进一步下降。同时,社交入侵指数(SII)普遍偏高,反映出当前导航模型缺少基础的社交距离感知能力,动态场景交互安全性不足。
结论 5:算法对机器人构型高度敏感,跨机型泛化能力差
同一算法在不同机器人上的表现天差地别:OmniNav 在四足机器人 Aliengo 上任务成功率为 8.74%,在轮式机器人 Carter 上降至 1.96%,部署于人形机器人 H1 时成功率直接归零。人形机器人需要持续保持机身平衡,算法的微小缺陷都会引发摔倒问题(摔倒率高达 60%-80%),相比轮式机器人,容错空间大幅缩小。
04 指令风格消融实验:模型语言泛化能力有待提升
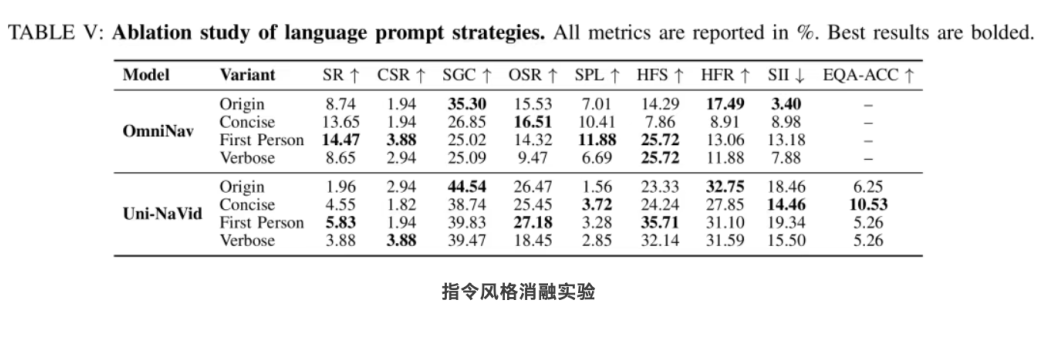
我们针对 OmniNav、Uni-NaVid 两款模型开展指令风格消融实验,测试不同句式表达对模型性能的影响。结果发现,简洁版、第一人称视角指令能够小幅提升模型任务成功率,其中 OmniNav 的成功率从 8.74% 提升至 14.47%;而细节丰富的长指令则会让模型表现持平甚至下降。
这一结果印证,当前导航模型存在句式过拟合问题,对多样化自然语言指令的理解与泛化能力仍有较大优化空间。
- 指令风格消融实验:模型语言泛化能力有待提升
我们针对 OmniNav、Uni-NaVid 两款模型开展指令风格消融实验,测试不同句式表达对模型性能的影响。结果发现,简洁版、第一人称视角指令能够小幅提升模型任务成功率,其中 OmniNav 的成功率从 8.74% 提升至 14.47%;而细节丰富的长指令则会让模型表现持平甚至下降。
这一结果印证,当前导航模型存在句式过拟合问题,对多样化自然语言指令的理解与泛化能力仍有较大优化空间。
- 横向对比:OmniNavBench 重塑导航评测标准
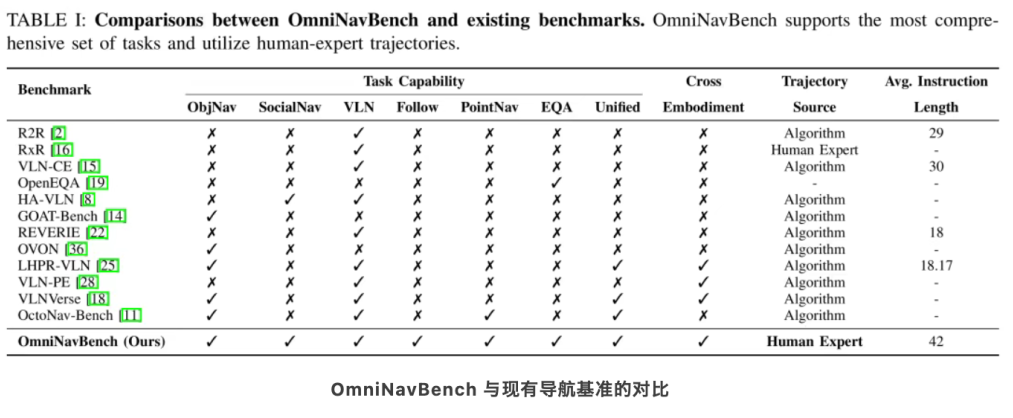
对比业内现有主流导航评测基准,OmniNavBench 是目前唯一一个同时实现六大导航任务全覆盖、支持多机型跨构型评测、基于真人遥操作轨迹搭建的一体化通用导航基准。彻底打破了过往评测体系碎片化、脱离真实应用的局限,为行业提供了统一、客观、贴近落地场景的评测标尺。
总结与未来展望
通过 OmniNavBench 的实测数据可以清晰看到:现阶段主打 “通用” 的导航模型,在面对跨技能组合、跨机型部署、长时序连续任务等真实场景时,依旧存在显著的能力短板。结合实验结果,我们梳理出下一代通用具身导航算法的核心突破方向:
强化长时序任务进度追踪能力,实现多项导航技能的流畅切换与有序执行;
优化任务终止决策逻辑,解决 “抵达目标却无法停止” 的落地难题;
提升动态社交交互能力,让智能体具备安全避让、社交距离感知等基础行为能力;
增强算法跨机型泛化性,降低不同机器人构型带来的性能波动;
优化语言理解模块,摆脱单一句式依赖,提升对多样化指令的适配能力。
未来,无界动力将持续联合上海交通大学 AutoLab 团队,依托 OmniNavBench 这套评测基准,持续推进通用具身导航技术的研发与迭代。同时我们将持续开放平台能力、完善数据集与工具链,携手行业伙伴,共同推动具身导航技术从实验室走向规模化落地,助力通用具身智能产业高质量发展。
