来源:公众号“应用机器学习”
原文链接:https://mp.weixin.qq.com/s/orC_RX6lDrBMmZrJkByv0w?scene=1&click_id=34
近日,机器学习领域的顶级国际学术会议 ICML 2026(43rd International Conference on Machine Learning)公布了论文接收结果。今年 ICML 2026 的整体录用率为26.6%,其中2.2%的论文被选为 Spotlight 展示。AML Lab 师生共有 3 篇论文成功入选,其中1篇为Spotlight。ICML 是人工智能及机器学习相关领域的顶级国际学术会议,旨在讨论如深度学习、强化学习、大语言模型、智能体及生成式模型等方向的最新研究成果、技术创新及系统应用。ICML 2026 将于 2026 年7月6日至7月11日在韩国首尔举办。
此外,人工智能领域的顶级国际学术会议 IJCAI 2026(35th International Joint Conference on Artificial Intelligence)也公布了论文接收结果。AML Lab 师生共有 1 篇论文成功入选。IJCAI 是人工智能及相关交叉学科领域的顶级国际学术会议,旨在讨论人工智能、机器学习、多智能体系统及自然语言处理等方向的最新研究成果、技术创新及系统应用。IJCAI 2026 将于2026年8月15日至8月21日在德国不来梅举办。
论文介绍
论文题目:Towards Pareto-Optimal Tool-Integrated Agents with Pareto Ranking Policy Optimization(ICML Spotlight)
作者:Junyi Li, Xiaowei Qian, Yingyi Zhang, Wenlin Zhang, Guojing Li, Sheng Zhang, Xiao Han, Yichao Wang, Xiangyu Zhao
论文概述:
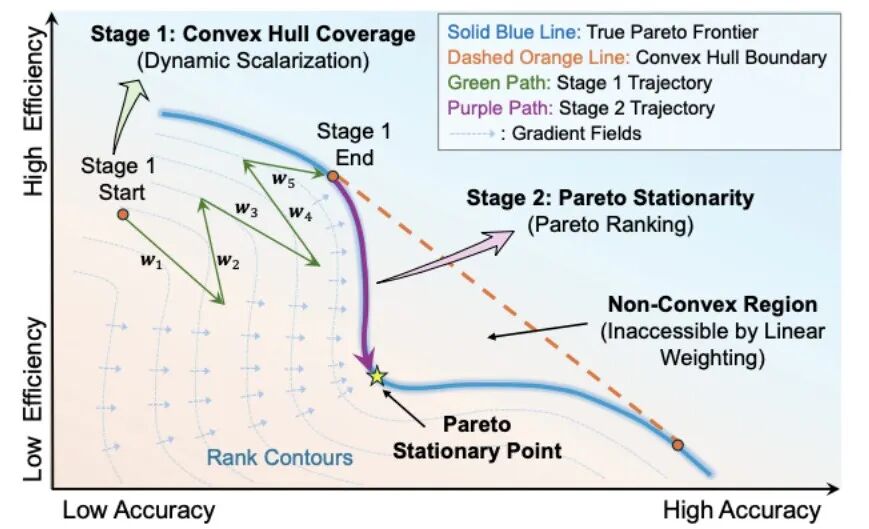
现有工具集成语言智能体已能借助搜索引擎、Python 解释器等外部工具完成复杂推理任务,但主流强化学习对齐方法往往过度关注最终答案准确率,忽视工具调用效率、推理成本与过程级决策质量,导致模型在实际部署中可能出现冗余调用、资源浪费或效率—性能失衡等问题。为此,本文提出 ParetoPO,一种面向工具增强的大模型智能体的两阶段多目标优化框架,旨在同时提升任务表现与工具使用效率。第一阶段通过超体积引导的动态标量化方法,根据 Pareto 前沿的全局推进情况自适应调整不同目标的奖励权重,从而更充分地探索准确率与效率之间的多样化权衡;第二阶段进一步引入基于 Pareto 排名的优势估计机制,利用非支配排序对轨迹进行 dominance-aware 信用分配,使策略更新更加偏向 Pareto 最优行为,而不依赖固定的线性奖励组合。实验覆盖数学推理与多跳问答任务,结果表明,ParetoPO 相比 ToRL-GRPO、OTC-GRPO、MO-GRPO、Search-R1 等基线方法,能够在保持甚至提升答案准确率的同时显著减少工具调用次数,展现出更优的准确率—效率 Pareto 权衡能力。消融实验和训练动态分析进一步验证了动态标量化与 Pareto 排名优化的互补作用,说明该方法为高效、可控的工具增强智能体训练提供了一种有效范式。
代码链接:https://github.com/Applied-Machine-Learning-Lab/ICML2026_ParetoPO
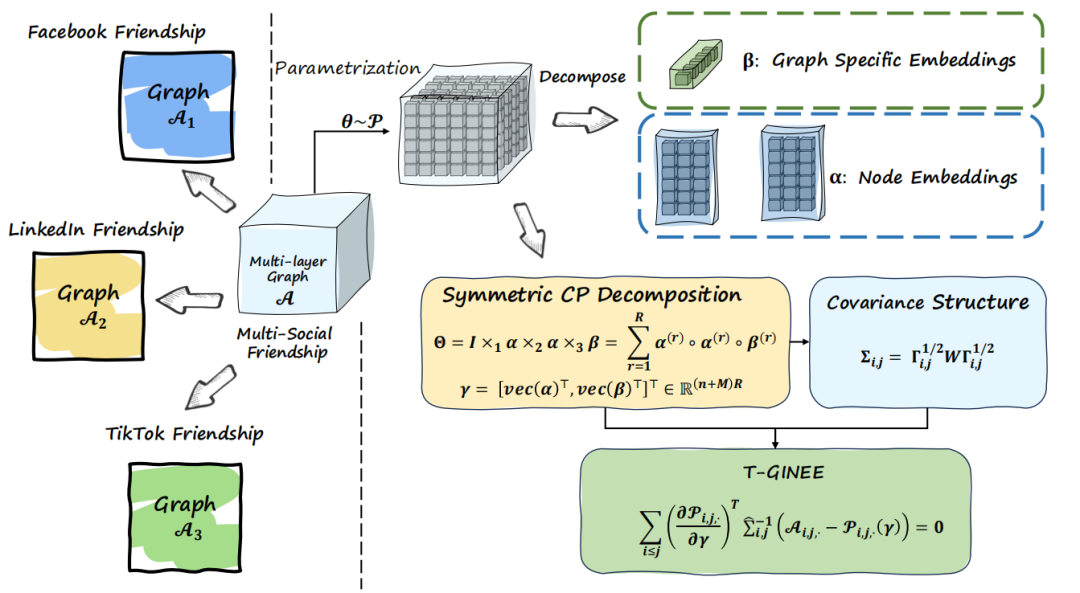
论文题目:T-GINEE: A Tensor-Based Multilayer Graph Representation Learning (ICML)
作者:Maolin Wang , Xuhui Chen, ZiTing Mai, Zhiqi Li, Tianshuo Wei, Yutian Xiao, Wenlin Zhang, Wanyu Wang, Ruocheng Guo, Haoxuan Li, Zenglin Xu, Xiangyu Zhao
论文概述:针对现实世界中多层网络(Multilayer Networks)分析现有方法往往独立处理各层或简单聚合,未能有效捕捉层间复杂依赖关系且缺乏严谨理论支撑的问题,本文提出 T-GINEE,一种基于张量的广义多层图估计方程框架。该方法结合张量CP分解与广义估计方程(GEE),通过共享潜在因子显式建模跨网络相关性,并利用工作协方差矩阵处理层间依赖。T-GINEE 在温和条件下建立了估计的一致性和渐近正态性理论保证。在合成数据及多个真实世界数据集(包括社交、生物及大规模网络如DBLP和Stack Overflow)上的实验表明,T-GINEE 在链路预测等任务中显著优于现有的张量分解及矩阵分解基线方法,且在处理百万级节点的大规模稀疏网络时具有良好的可扩展性。。
代码链接:https://github.com/Applied-Machine-Learning-Lab/ICML2026_T-GINEE
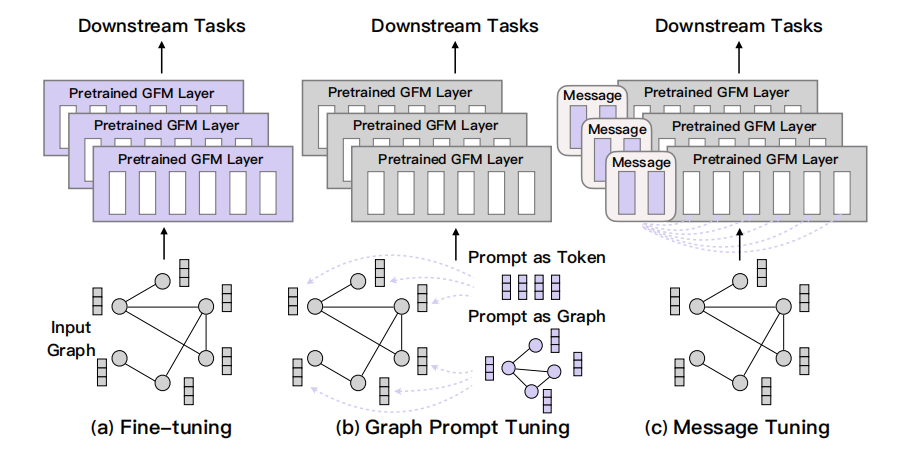
论文题目:Message Tuning Outshines Graph Prompt Tuning: A Prismatic Space Perspective (ICML)
作者:Yancheng Chen, Dun Ma, Shuai Zhang, Yang Liu, Xixun Lin, Xiangyu Zhao , Wenguo Yang, Wei Chen, Chuan Zhou
论文概述:针对图基础模型(GFMs)适配中主流的图提示微调(Graph Prompt Tuning)方法缺乏严格的适应能力度量标准,且仅在输入空间操作导致受限于冻结主干网络的“棱镜效应”压缩问题,本文提出棱镜空间理论(PS-Theory),用于量化适配方法的容量并确立图提示微调的理论上限。基于此理论,本文进一步提出消息微调(Message Tuning for GFMs, MTG),一种轻量级适配方法,通过在GNN主干的每一层注入可学习的消息原型(Message Prototypes)来动态引导消息融合,而不更新预训练权重。理论证明 MTG 的适配容量可超越图提示微调的理论上限。在ProG基准上的广泛实验显示,MTG 在少样本节点/图分类任务中一致优于最先进的图提示基线方法,并展现出更强的鲁棒性和更低的负迁移率。
代码链接:https://anonymous.4open.science/r/MTG
论文题目:PoemDirector: A Multi-Agent Context-Adaptive Instructional Mode Selection Framework for Chinese Classical Poetry Video Generation (IJCAI)
作者:Tengteng Cheng, Xiaoli Zeng, Jialu Huang, Mingliang Hou, Zitao Liu, Xiangyu Zhao, Weiqi Luo
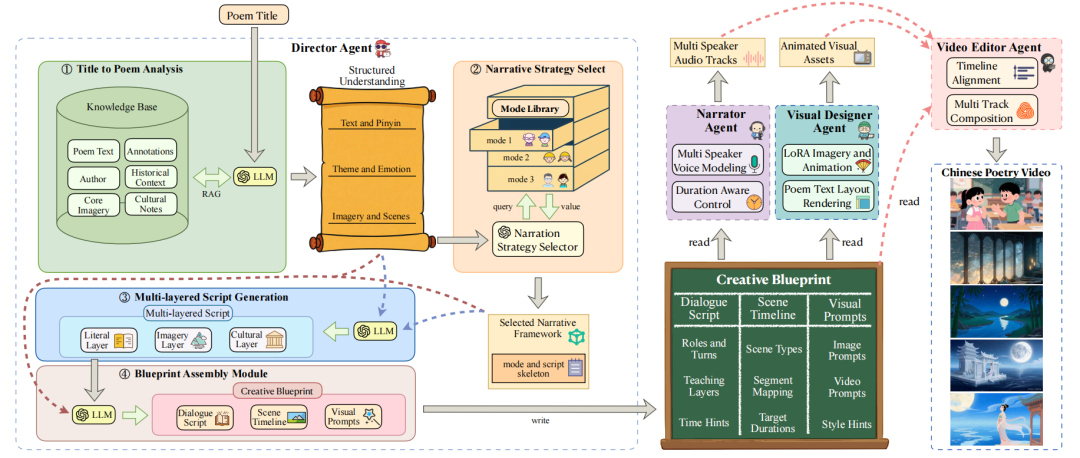
论文概述:针对中国K-12教育中古典诗词教学视频制作成本高、现有自动化方法缺乏系统性教学设计导致解释浅显且逻辑不清的问题,本文提出 PoemDirector,一种面向古典诗词视频生成的多智能体上下文自适应教学模式选择框架。该框架受现实创意团队启发,以导演智能体(Director Agent)为认知核心,根据诗词内容和情境创建结构化的创意蓝图,并协调视觉设计、旁白合成及视频编辑等专用智能体协同工作。PoemDirector 引入了三层教学法解释结构(字面、意象、主题)和上下文自适应的模式选择机制,解决了高质量教学与大规模生产之间的冲突。实验结果表明,该方法在显著降低人力成本的同时,在解释深度、知识准确性及诗意意象还原等多项指标上优于基线方法,甚至接近人工制作视频的水平。
代码链接:https://anonymous.4open.science/status/poem_dataset-1B40