


来源:视觉语言导航
原文链接:https://mp\.weixin\.qq\.com/s/5tL0YhzMFU93Tq\-uxNk2ww
✨ 导读: 在动态环境中,无人机如何从「看见障碍」走向「预见碰撞」?华中科技大学团队被 IROS 2026 录用的工作 ARR-Fly(Anticipatory Risk-Guided Reinforcement Learning)给出了一条极具辨识度的路线——把航海/航空碰撞预警里的经典物理先验 CPA(最近接近点) 蒸馏进视觉策略,让无人机不检测行人、不维护轨迹、不算光流,仅凭一段深度序列就能预判「未来哪个方向最危险」。在构建的六组高密度场景中,ARR-Fly 的成功率均为最高,并在全部场景取得最大的最小安全间距。部署到 Jetson Orin NX 后,策略单次推理约 5ms;无需真实数据微调,也不依赖域随机化,即可在树林、箱阵和行人横穿等未见场景中完成 zero-shot 真机飞行。
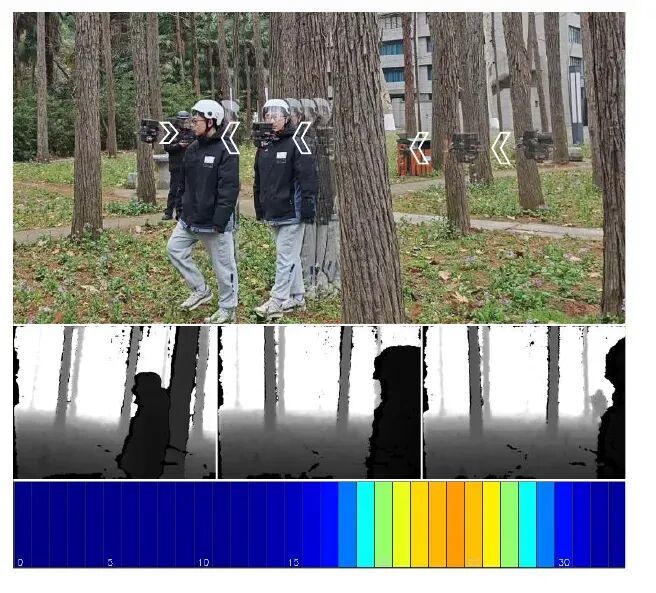
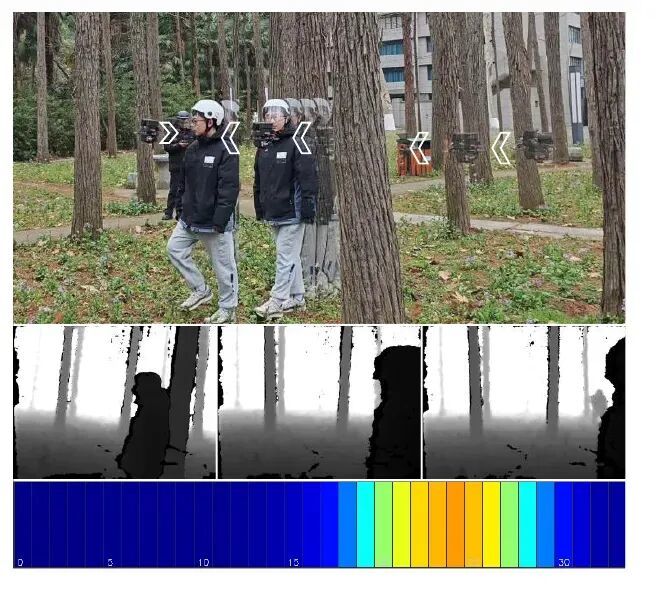 图 1|无人机面对动态行人时,不仅感知当前深度,还会输出一维方向性未来碰撞风险图。颜色越「热」,代表该方向的潜在碰撞威胁越高。
? 研究背景
静态避障主要回答一个问题,「障碍在哪里」。
到了动态环境,系统还得回答另一个问题,「它接下来会出现在哪里」。
同一个行人,此刻可能都没有挡在航线上。可如果他正在远离,无人机可以继续前进;如果他正在横穿,无人机就需要提前减速或侧移。两次看起来近似的单帧观测,背后可能对应完全相反的避障决策。
动态避障真正难的,正是从当前观测中读出相对运动,并进一步判断双方何时最接近、到那一刻还剩多少安全距离。
现有方法通常沿着两条路线解决这个问题。
经典模块化方法依次完成目标检测、跟踪、轨迹预测、规划与控制。它的好处是每一步都清楚,但链路越长,遮挡、误检和跟踪误差就越容易向后传递,多目标环境下的计算开销也会随之增加。
端到端强化学习绕开了显式检测与跟踪,可以直接从传感器观测输出控制指令。但许多方法主要依赖任务级标量奖励,网络只知道这一步是「更接近目标」还是「发生碰撞」,却很难从中学到危险来自哪个方向、又会在何时发生。
结果往往是,策略能够避开障碍,却习惯在危险逼近后才做出激烈机动。
飞得不慢,安全余量却很小。
所以,ARR-Fly 想解决的问题可以归结为一句话。
能不能不检测、不跟踪,也让视觉策略提前知道,未来哪个方向最危险?
能不能不检测、不跟踪,也让视觉策略提前知道,未来哪个方向最危险?
? 三大核心贡献
?️ 时空表征:倒置球面深度序列与 TCN 编码
运动趋势无法从单帧中恢复。ARR-Fly 将原始深度图转换为几何一致的倒置球面距离图,再保留最近 15 帧观测,让网络从连续变化中读取障碍物的运动趋势。
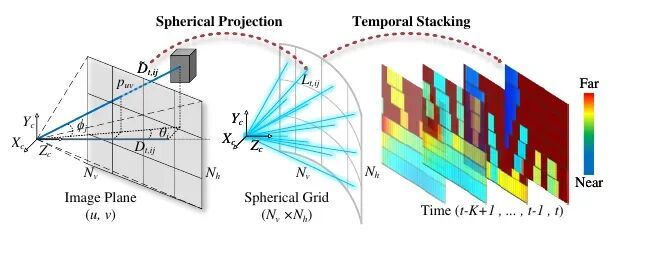
图 2|几何一致的球面投影削弱了相机边缘畸变;时间堆叠让网络能从连续变化中读取动态线索。
1. 倒置球面距离变换
原始深度记录的是沿相机光轴方向的距离。经过最小池化和球面几何校正后,第 个方位角、第 个俯仰角对应的倒置距离为:
其中, 是该方向上的光轴深度, 是传感器最大可靠量程。距离越近, 越大,近距离威胁因而得到更强响应。
2. 连续 15 帧时序堆叠
将最近 帧倒置球面距离图沿时间维堆叠,得到:
这里 、,因此输入既保留不同方向上的空间结构,也显式记录障碍物在短时间窗内的位置变化。
3. 共享 CNN 与 TCN 编码
共享 2D CNN 首先从每帧距离图中提取空间特征 ,随后由 TCN 沿时间维完成聚合:
这样得到的 同时编码障碍物的方位、距离及短时运动趋势。全程不需要检测框、目标 ID、显式轨迹或在线光流估计。
这种紧凑表示弱化了纹理差异,将仿真与真实观测统一到以几何和距离为核心的输入空间,也为后续 zero-shot Sim-to-Real 提供了基础。
?️ 风险建模:基于 CPA 的方向性未来碰撞风险
ARR-Fly 借用了航海与航空防碰撞中的经典概念 Closest Point of Approach(CPA,最近接近点)。
CPA 关心的并不只是「现在离得多远」,而是按照当前的相对运动继续下去,双方会在什么时候最接近,到那一刻又会有多近。一个障碍物可能离无人机很近,却正在快速远离;另一个障碍物虽然暂时较远,却正在横向切入航线。只看当前距离,前者似乎更危险,真正需要提前避让的却可能是后者。
1. 最近接近时间与最小间隔
对于第 个障碍物,记它相对无人机的位置和速度为 与 。在短时相对速度近似不变的假设下,CPA 的三个核心量可以写为:
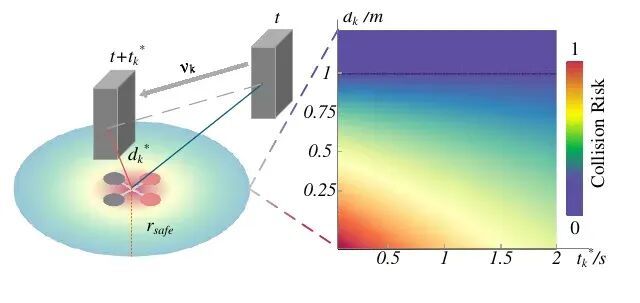
其中, 是理论最近接近时间, 将其限制在预测时域 内, 则是该时域内的最小间隔。它们分别回答「多久后最危险」和「到那一刻还剩多远」。
2. 连续未来碰撞风险
ARR-Fly 将时间紧迫度与空间接近度共同映射为连续风险:
其中, 由无人机半径、障碍物半径和额外缓冲距离共同构成。危险发生得越早、预测间距越小,风险值越高;若最小间隔没有进入安全半径,风险则为零。
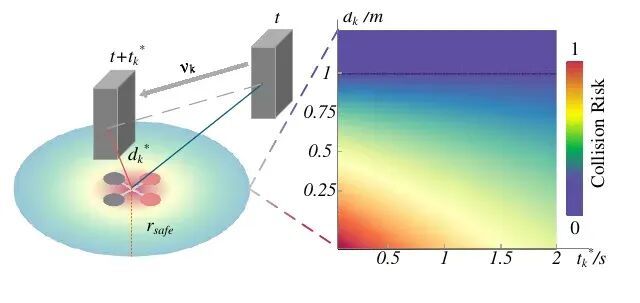 图 3|CPA 风险同时考虑时间紧迫度与未来空间接近度。相比只看当前距离,它能够识别由相对运动带来的潜在碰撞。
3. 从二维风险图到一维方向风险
每个障碍物的风险首先被投影到与相机视场对齐的二维球面网格 。随后,通过 Log-Sum-Exp 沿俯仰方向聚合,第 个水平方向的风险为:
其中, 控制聚合结果对最大风险的逼近程度。这样,风险不再只是一个全局分数,而是进一步告诉策略,危险来自哪个方向,哪里还留有安全空间。
? 训练范式:非对称 Actor-Critic 与特权风险蒸馏
CPA 风险标签依赖障碍物的位置、速度和半径等真值状态。这些信息在仿真器中容易获得,真机部署时却无法直接访问。ARR-Fly 通过非对称 Actor-Critic 解决这一矛盾。
训练阶段,Critic 可以访问完整特权信息,仿真器则生成 CPA 风险标签,监督辅助风险预测头从视觉时序特征中重建未来风险。Actor 始终只使用部署时可获得的深度序列、自身速度和相对目标位置。推理时,真值风险与特权 Critic 全部移除,仅保留轻量视觉策略及其自主预测的风险表示。
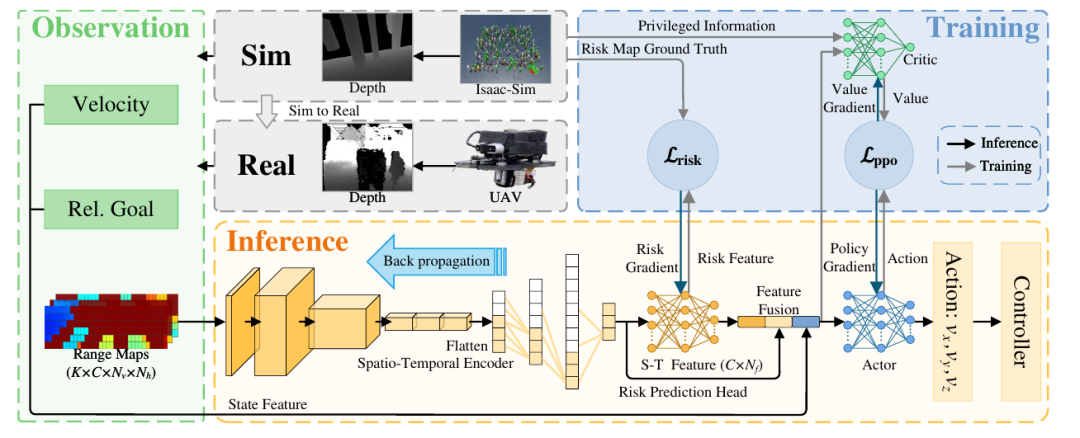
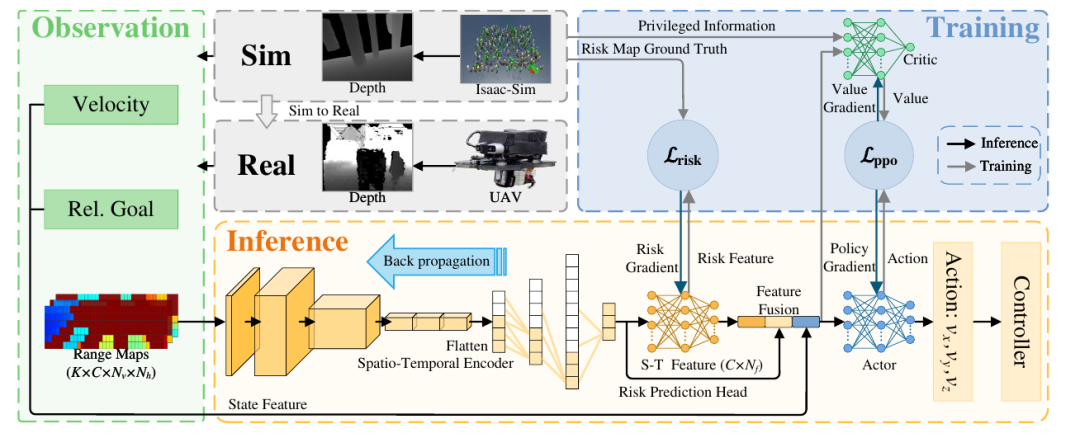 图 4|训练阶段借仿真「上帝视角」构造风险真值;部署阶段完整拆除特权模块,Actor 依靠机载观测与内部化的风险表示,直接输出三维速度指令。
1. 风险预测与 stop-gradient
辅助预测头根据时空特征自主重建一维未来风险 ,再与时空特征和本体状态共同输入 Actor。预测结果进入策略网络前使用 stop-gradient:策略梯度不会反向破坏风险头已经学习到的物理语义,但风险监督仍能更新风险头和共享时空编码器。
2. 安全约束与联合训练
奖励函数仍负责平衡目标趋近、飞行安全与控制平滑性。其中最关键的安全惩罚同时考虑当前最小间距与最危险方向的未来风险:
第一项在无人机接近任何物理边界时迅速增大,约束当前几何安全;第二项提前惩罚未来可能发生的动态碰撞,使策略在危险真正迫近前减速或绕行。
在此基础上,PPO 目标与辅助风险预测损失进行联合优化:
其中, 是网络预测风险, 是仿真器生成的特权风险真值。CPA 风险没有替代 PPO 奖励,而是补充了具有方向与时间结构的监督。部署时,特权 Critic、风险真值和在线 CPA 计算全部移除,只保留视觉 Actor 与自主预测的风险表示。
? 实验结果:六组高密度场景基准
实验设置
论文构建了六组 30 m × 10 m 高密度走廊,动态障碍速度为 1–5 m/s,每组进行 20 次随机化测试。对比方法包括 FAPP、NavRL 和 P2M,评价成功率、最小安全间距、端到端延迟与平均飞行速度。
ARR-Fly 与 P2M 均以 5 m/s 为参考速度,但 P2M 使用 360° 全向 LiDAR,ARR-Fly 使用前向深度相机,感知范围与传感器信息量更少。
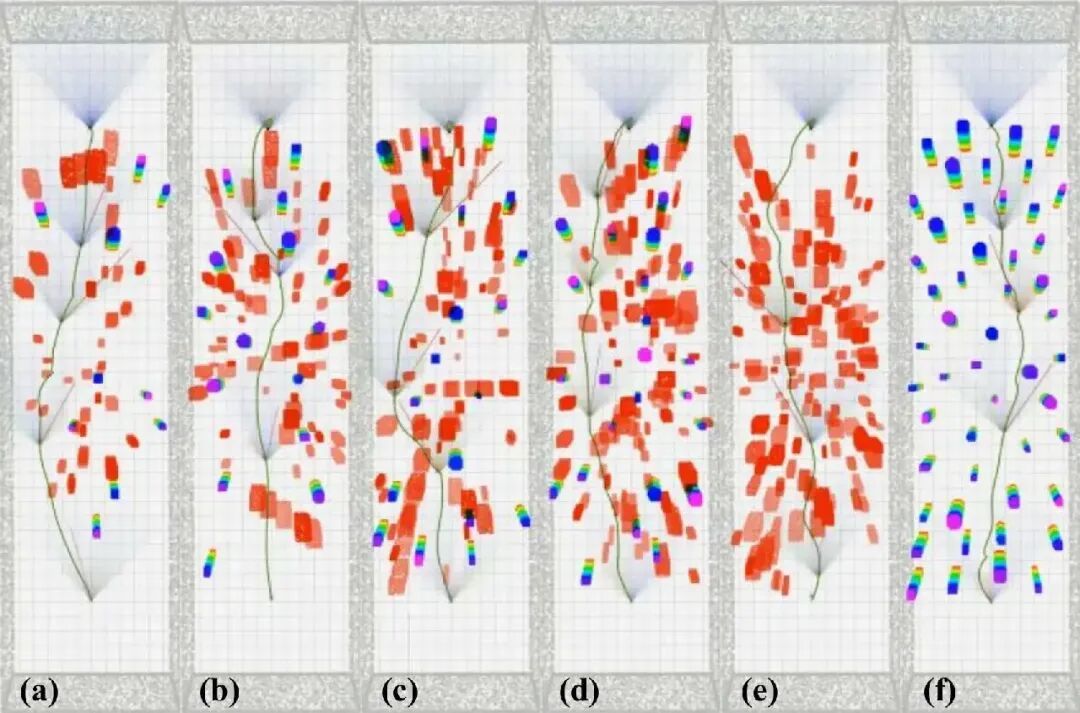 图 5|六组仿真基准场景中的无人机俯视飞行轨迹。子图(a)至(f)依次对应六种障碍物密度与动静态组合。
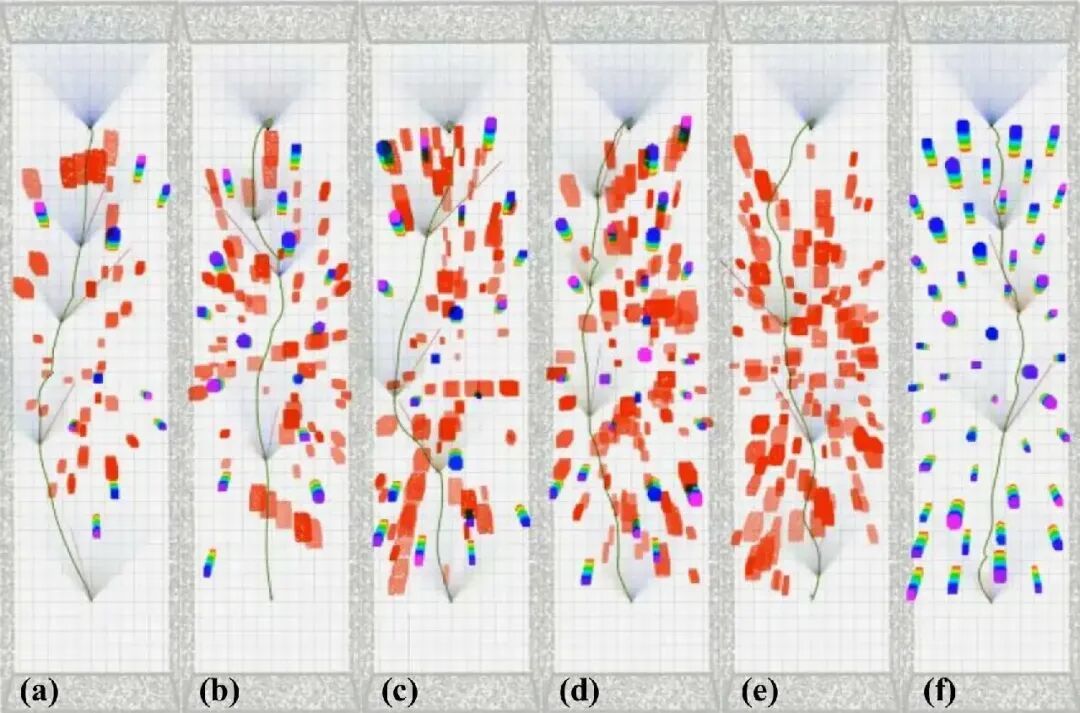
定量结果
➤ 25 静态 + 25 动态的极密集场景(对比同为高速设定的 P2M)
➤ 35 个纯动态障碍场景
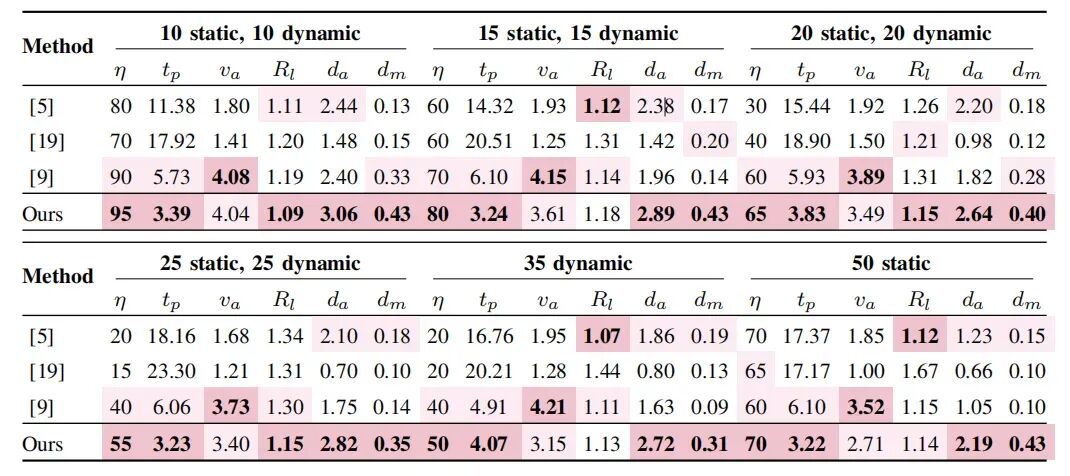 图 6|六组基准中,ARR-Fly 成功率全部取得最高或并列最高,并在所有场景保持最大的最小安全间距;端到端延迟稳定在约 3.22–4.07 ms。
在最拥挤的纯动态场景中,ARR-Fly 会适当降低速度、提前绕行,以换取更大的安全余量,体现出明确的安全—效率权衡。
? 消融实验
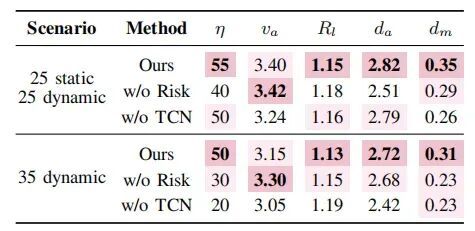
为验证风险监督与时间建模的作用,作者分别移除风险模块和 TCN。在 35 个纯动态障碍场景中,完整模型成功率为 50% ;移除风险监督后降至 30% ,移除 TCN 后进一步降至 20% 。两种消融版本的最小安全间距也从 0.31 m 降至 0.23 m。
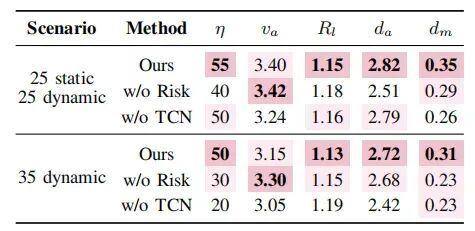 图 7|风险监督负责把运动趋势翻译成「未来是否危险」,TCN 负责读懂障碍物「正在怎么动」,二者缺一不可。
? 真机部署:零样本 Sim-to-Real
论文将策略部署在搭载 NVIDIA Jetson Orin NX 与 Intel RealSense D435i 的四旋翼上,由 VINS 提供自身状态估计,PX4 跟踪连续速度指令。经 TensorRT 加速后,策略单次推理约 5 ms。
整个部署过程不使用真实场景微调或域随机化,也不显式跟踪行人。策略仅依赖结构化深度时序、自身状态和内部预测的风险表示,实现 zero-shot Sim-to-Real。
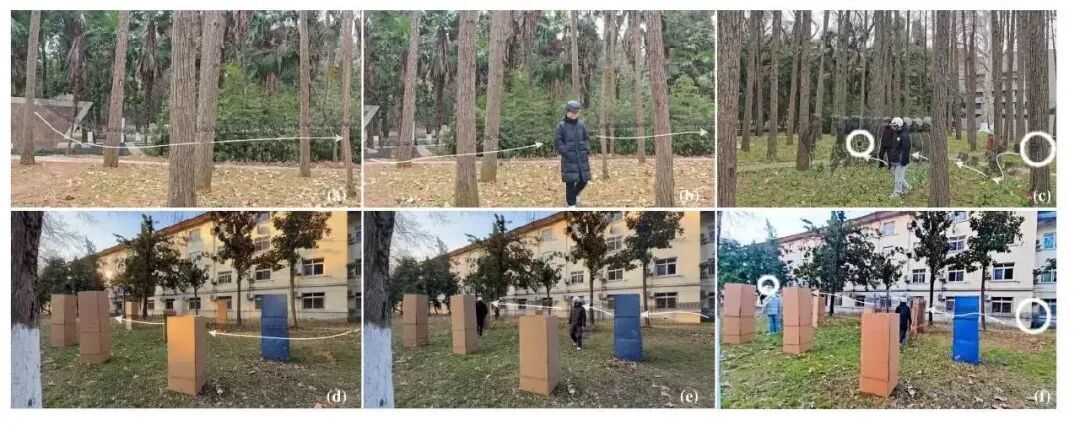
真机测试覆盖未见过的树林、箱阵和动态行人场景。ARR-Fly 能够在树木与箱体间自主穿行,并根据行人的相对运动提前调整轨迹;当行人从遮挡区域突然进入航线时,策略会先制动至悬停,再执行侧向绕行。
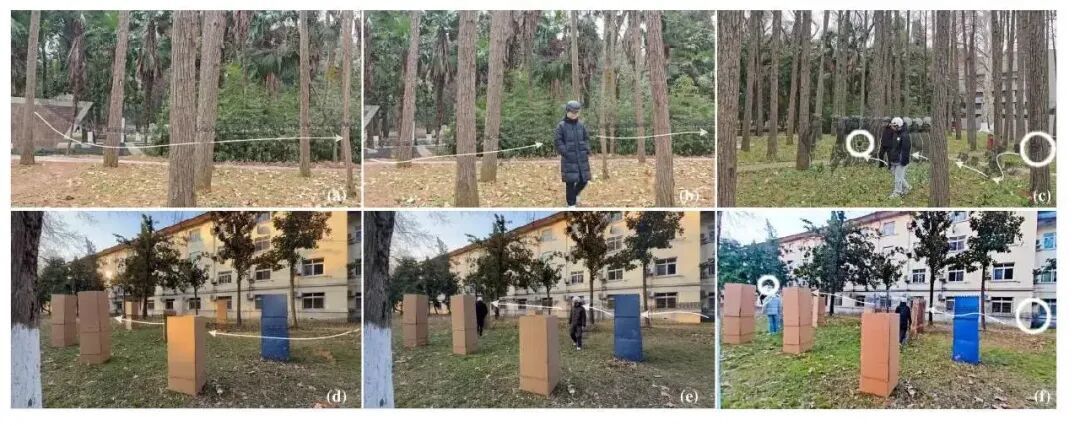 图 8|上排展示无结构树林,下排展示箱阵环境;多组画面覆盖静态穿行、动态行人横穿与遮挡突发测试。白色曲线表示无人机的飞行轨迹。
? 全文总结
核心结论
方向性未来风险建模。 ARR-Fly 将 CPA 物理先验转化为风险监督,使策略能够判断碰撞可能在何时、从哪个方向发生。
特权训练、轻量部署。 仿真真值仅用于训练,部署时仅依靠深度序列、自身速度和相对目标位置,无需检测、跟踪或光流估计。
安全高效的零样本迁移。 六组高密度场景成功率最高或并列最高,安全间距均最大;Jetson Orin NX 上约 5 ms 推理,无需微调即可 zero-shot 上真机。
未来优化方向
后续将聚焦非线性轨迹预测、全向感知,以及与 VLM/VLA 高层任务规划的协同。
不是把无人机训练得更莽,而是让它更早知道危险。
不是把无人机训练得更莽,而是让它更早知道危险。
原文链接: https://www.leiphone.com/category/private/fW8iEHFCNiPSZ6GO.html
