


来源:JOJO极致算法
原文链接:https://mp\.weixin\.qq\.com/s/JVTMXHb3LIW5JkqTlxKJAQ
视觉-语言-动作(VLA)模型虽然在通用机器人控制上展现出巨大潜力,但走向真实物理世界时却面临诸多落地阻碍。频繁的冗余动作严重拖慢了执行节奏,缺乏三维直觉使其容易陷入多相机协作下的视觉死角,而在复杂环境中的碰撞风险则暴露了模型在安全交互上的缺失。
为了跨越这些现实鸿沟,本文梳理了近期被ECCV 2026和CoRL 2026接收的三篇前沿文献。它们分别通过强化学习剔除执行中的无效冗余动作、建立严格的物理与语义安全评估体系,以及向底层视觉特征中巧妙注入相机几何先验。这三项关键研究直击痛点,推动具身大模型克服环境的不确定性,迎来向开放世界真实部署的实质性质变。
目前我已梳理好了“几何归纳偏置+视觉-语言-动作模型”方向相关论文,包含CVPR、ICSRS、ESWA、ICCV、AAAI等顶刊成果,且附有相应源码。如果你想发论文,那我建议拿一份当做参考,可助你快速定位创新点。
PolicyTrim: Boosting Intrinsic Policy Efficiency of Vision-Language-Action Models (ECCV 2026)
【亮点速览】
打破算力优化局限:现有研究多关注于模型量化或视觉Token剪枝等“计算效率”优化,而忽视了模型本身的“策略内在效率(Intrinsic Policy Efficiency)”。PolicyTrim首次指出,动作块(Action Chunks)尾部预测的不可靠性和冗余的物理执行步骤,才是制约VLA系统部署效率的核心瓶颈。
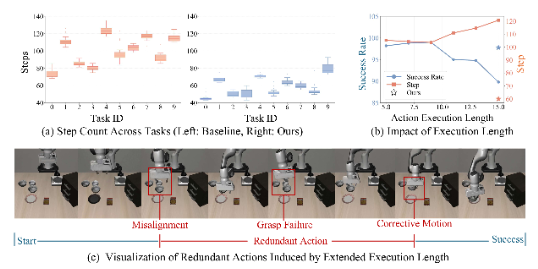
图1:VLA模型部署中的“策略内在低效”现象。
图示揭示了当前VLA模型存在的两大痛点:(a)相同任务多次执行的步数差异巨大,说明模型存在更简洁的执行路径但仅靠偶然触发;(b)强制延长动作块执行长度会导致成功率下降和物理步数激增;(c)尾部预测误差会引发对齐错误或抓取失败,迫使机器人产生大量冗余的纠正性动作。
【创新点】
动态探索策略(Dynamic Exploration Strategy):在强化学习后训练框架下,为不同轨迹分配固定窗口大小,通过奖励成功执行更长动作块的模型,逐步将可靠的预测范围推向极限,有效延长了动作块的可用长度。
冗余感知奖励(Redundancy-aware Reward):设计了一种专门针对“步数效率”的奖励机制,直接偏好用更少物理步骤完成任务的轨迹,同时利用稳定性正则化惩罚不可复现的捷径,从根本上消除了冗余的纠正性动作。
【成果】
LIBERO-Safety: A Comprehensive Benchmark for Physical and Semantic Safety in Vision-Language-Action Models (ECCV 2026)
【亮点速览】
直击安全盲区: VLA模型虽然操作能力惊人,但在严格约束下的运行安全却鲜少得到验证。LIBERO-Safety填补了这一空白,提出了一个全面的物理与语义安全基准,涵盖了从静态空间避障到动态人机交互的多维风险场景。
【创新点】
关键姿态驱动的数据生成管线(Keypose-Driven Data Generation):为了突破人类遥操作收集数据的可扩展性瓶颈,研究团队开发了一套自动化的数据生成流水线,高效合成了19.7K个严格无碰撞、具有广泛领域随机化的高质量演示数据。
跨范式系统评估:全面评估了8种VLA模型和2种具身基础模型,揭示了“泛化与安全”之间的核心矛盾:虽然高多样性的训练能促使模型生成更安全的轨迹,但任务成功率依然受限于次优的轨迹合成和语义不对齐。
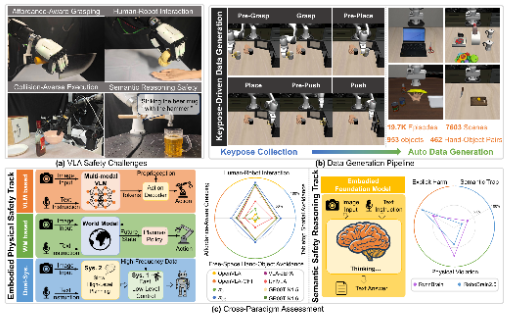
图2:LIBERO-Safety基准与自动化数据生成管线。
左侧(a)展示了VLA部署面临的物理避障与语义陷阱等安全挑战;中间(b)展示了为突破人类遥操作瓶颈而设计的“关键姿态驱动(Keypose-Driven)”自动化数据生成流水线,能够高效合成严格无碰撞的演示数据;右侧(c)则展示了针对现有大模型的跨范式安全评估体系。
【成果】
G3VLA: Geometric inductive bias for Vision-Language-Action Models (CoRL 2026)
【亮点速览】
赋予VLA三维空间直觉:现有的VLA模型大多基于2D图像坐标,在多相机系统中无法利用已知的相机内外参几何结构。G3VLA通过将校准的相机几何结构直接注入预训练VLA的视觉Token流,完美解决了语义理解与空间精度难以兼得的痛点。
【创新点】
轻量级几何注入模块:由三个核心组件构成:条件化的光线嵌入(将ViT的Patch Token与其反投影视角方向绑定)、投影位置编码(PRoPE,编码跨视角的投影关系)以及双向跨视角融合。
无损预训练架构:该方法无需修改原有的VLA骨干网络、动作空间或模仿学习目标。几何监督信号可以来自真实的深度点图,或者在没有深度传感器时,由π3X教师模型生成的置信度门控点图进行知识蒸馏(无需人工3D标注)。
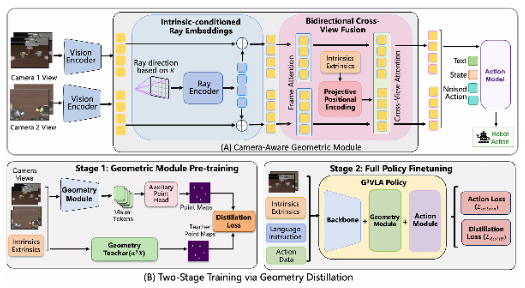
图3:G3VLA的三维几何归纳偏置注入架构。
图(A)展示了在完全不改变预训练骨干网络和动作目标的情况下,通过条件化光线嵌入和投影位置编码(PRoPE)将校准的几何结构无缝注入视觉Token流;图(B)展示了无需人工3D深度标注,直接利用教师模型()蒸馏密集点图来进行几何感知预训练与微调的两阶段流程。
【成果】
回顾这三项前沿工作,研究者们正致力于解决具身智能大模型在实际应用中遇到的具体阻碍。PolicyTrim着眼于模型自身的执行逻辑,通过优化动作块的利用率来大幅削减不必要的物理操作,从而有效提升了整体部署速度。LIBERO-Safety则将目光投向了人机交互的底线,建立了一套严格的评估体系来检验模型在避障和指令理解上的可靠性,暴露出当前大模型在复杂环境中的潜在风险。与此同时,G3VLA针对多相机协作时感知精度下降的问题,巧妙地将相机几何参数融入视觉特征,弥补了模型在三维空间理解上的先天不足。
总而言之,这三篇文献分别从底层的空间感知、中层的执行效率以及整体的行为安全切入,对现有的VLA架构进行了务实的修补与增强。这些探索不仅让大模型在控制机器人时变得更加高效和精准,也为其未来真正走进复杂多变的人类生活环境做好了必要的技术储备。
原文链接: https://www.leiphone.com/category/private/Vpm5iMlSOgPGxcrx.html
