


来源:多模态论文每日速递
原文链接:https://mp.weixin.qq.com/s/7AF4xQBnRxTsqgNY8i8uoQ
GMoT: Gated Motion-Aware Tokenization for Fine-Grained Micro-Gesture Video Reasoning with Multimodal LLMs
作者单位:哈工深
论文链接:https://arxiv.org/pdf/2607.16322
01
—
Introduction
微动作识别需要检测到那些短暂出现的、具有空间定位特性的运动现象,因为这些运动往往会被主要的静态景象和背景噪音所掩盖。虽然多模态大型语言模型在整体视频理解方面表现出色,但它们在处理细微的运动学信息时却存在困难,通常依赖于静态姿态的先验知识。为此,我们提出了 GMoT 这一基于运动感知的标记化模块。该模块能够将从稀疏的运动学信息中提取出的数据压缩成简洁的序列,以便进行后续的时间建模处理。GMoT 通过空间加权聚合技术动态突出与动作相关的区域,提取相邻帧之间的时间差异以捕捉精确的运动能量,并采用保守初始化的语义门控机制,将这些线索自适应地融合到视觉流中。为了从简单的分类过渡到基于证据的推理,我们还引入了渐进式的奖励引导策略优化方法,以提供更强的支持。该模型采用半监督注释流程进行训练,能够生成以解剖结构为中心的注释。在 iMiGUE 和 SMG 等比较模型中,我们的模型取得了最高的 Top-1 准确率,分别为 67.32%和 73.11%。此外,我们的模型还将身体区域定位功能作为基于正确预测的代理机制,使得 Qwen3-VL-8B 基线的准确率分别提高了 6.80 点和 3.11 点。我们还引入了基于解剖结构定位的跨域迁移协议,使得 iMiGUE 和 SMG 之间的跨域迁移效果也得到了改善。广泛的评估表明,我们的模型在领域内准确率方面表现优异,即使在标签保持性受损的情况下也能保持显著的性能提升,同时在明确的小样本分割条件下,其跨域迁移能力也得到了提升。在保持高度的解剖学结构基础的同时,提供合理的推理依据。
02
—
Motivation
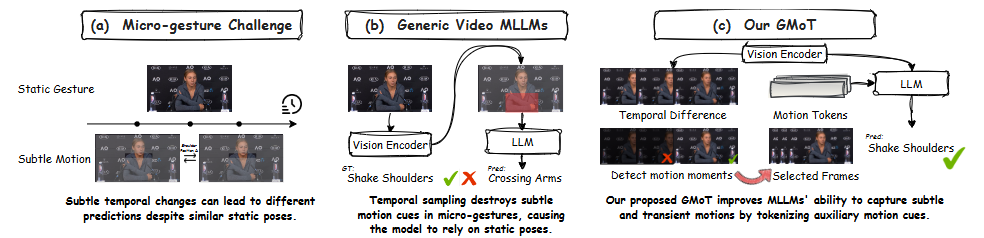
图 1:问题设定与动机说明。通用视频中,许多机器学习模型过于强调静态外观的呈现;而 GMoT 则能够将较弱的局部运动信息提炼为简洁的运动感知标记,从而进行基于证据的微手势推理。
理论上,大型语言模型为微手势识别提供了有力的基础,它不仅能输出通用的类别标签,还能将视觉证据与基于语言的解释相结合,从而揭示出是什么导致了某种动作以及它是如何发生变化的[23, 25]。
然而,直接将现有的大型语言模型应用于微手势识别时,往往会得到不理想且具有误导性的结果。这是因为这些模型依赖于密集的帧级空间提取方式,导致微弱且稀疏的运动信号被忽略,或者被时间聚合过程所稀释[2, 9]。如果没有足够的时间敏感性,模型往往会陷入所谓的“草率猜测”,即基于一些明显但粗糙的外观特征做出快速但不可靠的判断,而忽略了更精细的运动信息,例如,在识别交叉手臂姿势时,却忽略了其他可能的动作。不过,这种基于分类的手指敲击行为其实是一种歧视性的做法。
更糟糕的是,因为标准的方法只关注最终的分类准确性,正如图 1 所示,这样的模型会被诱导产生看似合理但实际上缺乏实际依据的推理过程。此外,大多数现有的评估方式都只关注数据集内部的 Top-1 准确率,这就使得我们无法确定模型是否真的能够捕捉到可迁移性的微观动态,还是仅仅记住了特定数据集中的外观偏见。
—
Contribution
动态感知的标记化技术。我们提出了 GMoT 算法,该算法能够将运动检测、重要区域合并、相邻帧差异分析以及门控融合这些功能整合到 MLLLM 中,而不会破坏其预训练的视觉语言接口。
以推理为导向的训练方法。我们实现了半自动的 CoT 监督机制,并采用了渐进式的奖励机制来引导改进过程,从而促使标签表述更加准确、解释更加合理,同时还能有效避免那种仅仅依赖表面现象进行猜测的做法。
更广泛的评估方面,我们引入了 BRG Recall 作为一种基于解剖学特征的中介机制,同时它也是一种在 iMiGUE 和 SMG 之间实现跨域传输的协议。在 GMoT 模型中,分别达到了 67.32%和 73.11%的 Top-1 准确率;在测试的各种标签保持性损坏情况下,其性能仍然优于其基于 Qwen3-VL 的骨干系统。
04
—
Method
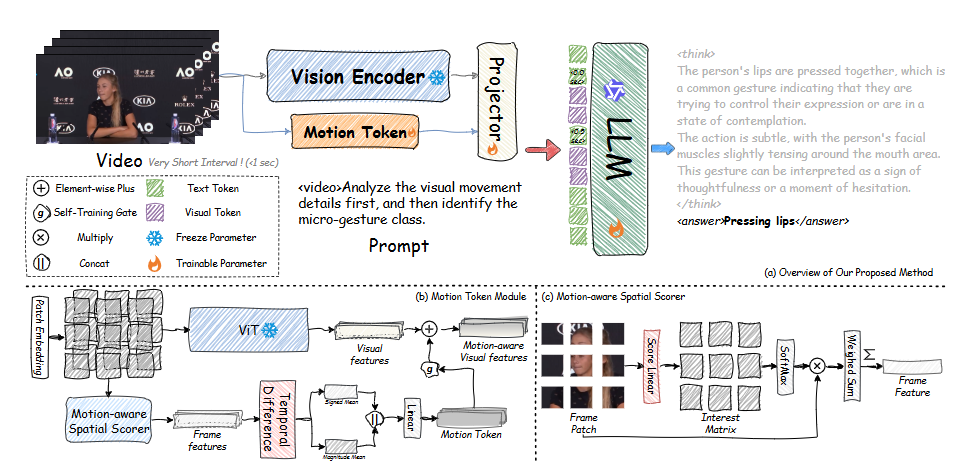
在本节中,我们首先介绍多模态大语言模型的相关基础知识。随后,我们介绍了 GMoT 这一基于运动感知的令牌模块。该模块能够将帧级视觉信息转化为紧凑的运动表示,从而使普通的 MLLM 模型能够捕捉到微动作视频中的微妙时间线索。最后,我们提出了一种四阶段训练策略,该策略逐步整合分类功能、塑造思维链模式,并通过基于奖励的策略优化来提升微动作推理能力。
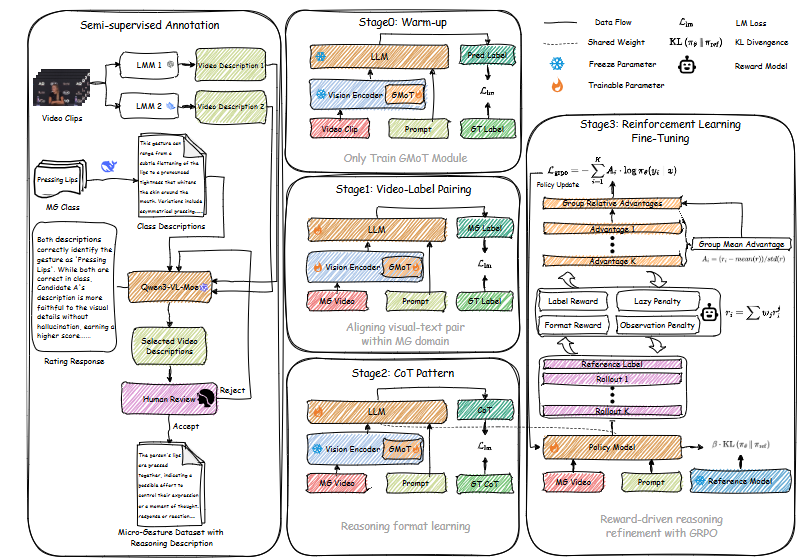
图 3:四阶段训练计划的概述。训练过程依次经历 GMoT 热身阶段、微手势领域适配阶段、CoT 风格推理学习阶段,最后是通过奖励引导的强化微调来提升推理能力。
我们采用图 3 左侧所示的半自动流程来构建基于推理意识的监督机制。对于每个标注过的视频片段,两个独立的 LMM 会生成候选的运动描述,这些描述会排除背景和身份相关的信息,而只关注与动作相关的身体部位。然后,Qwen3-VL-MoE[3]会根据类别正确性、视觉定位以及无幻觉等标准,选择最佳的候选描述。对于边缘情况,我们会进行人工审核。基于这些被接受的样本描述所进行的人类验证研究,会在附录 A 中详细说明。最终得到的注释将用于指导标签预测以及基于证据驱动的 CoT 生成过程。
更具体地说,对于每一个片段,使用两个候选项可以提升多样性,同时降低因单一案例而导致的细节描述不足或幻觉现象的风险。在提示中,我们明确不鼓励对任何背景或场景上下文进行描述。
或者与身份相关的面部信息。相反,这些模型需要专注于与动作相关的区域,主要关注手部和手臂的动作用,并且只能描述那些能够支持“男性角色”标签的可观察运动模式。我们还提供了来自 Deepseek[40]的类别级描述作为参考,其中总结了每个“男性角色”类别的典型视觉模式和关键区域。这一描述可以作为语义锚点,以检查类别一致性并减少标签的漂移。
基于动作提示的空间显著性分析。考虑到局部化的需求,微手势的识别过程中,空间上均匀化的汇总方式会稀释那些具有辨识度的线索,因为无关的背景噪声会干扰对这些微小区域的识别。与其依赖大语言模型在密集的图像块中隐式寻找这些区域,GMoT 采用了一种轻量级的空间评分机制,来明确突出与运动相关的区域。具体来说,我们将来自视觉编码器的每个图像块令牌通过线性层进行投影,以获得一个相关性评分。然后应用空间型 softmax 函数产生标准化的注意力权重,通过加权求和将图像块的特征动态汇总为帧级表示。这种机制就像一个学习到的空间滤波器,它能够积极放大局部特征,同时抑制视觉上的冗余信息。
基于运动学的时序差分方法。为了捕捉在微动作发生的确切时刻,模型必须能够敏感地捕捉时间上的梯度变化,而不仅仅是静态的外观特征。虽然标准的视频变换方法依赖于复杂的时间混合处理,但我们认为,明确的时间差异处理能够为微妙的运动提供更直接且稳健的归纳偏好。我们不是将这种差异视为一个单一的特征,而是将其分解为两个流形的运动表示。我们计算出运动能量的平均值,同时保留方向性的运动信息。通过连接这些分离的流形,并应用一种可学习的投影方法,我们可以将原始的时间梯度压缩成固定长度的密集运动标记。这种设计使得网络能够专注于视觉上的变化,从而有效地将微妙的动态与静态的人体外观分离开来。
语义保持型自适应门控机制。在调整预训练的 MLLMs 时,一个关键的挑战是,突然引入新的模态标记可能会破坏原有的视觉-语义空间结构。因此,我们采用一种近似封闭的门控残差机制作为稳定化手段,而不是将门控本身视为一种独立的创新设计。用?表示在时间?时的原始视觉特征,用?表示学习到的门控参数,用?表示提取的运动标记。我们通过将这些参数融合在一起来实现我们的目标。
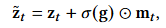
该方法在保留预训练的表示模型的同时,允许模型自行决定引入多少运动信息。GMoT 的贡献在于它能够根据任务需求定制局部空间评分的算法,实现明确的时间区分,并在进行语言推理之前先对结果进行适度的调整。
在基于注释的处理流程和 GMoT 的基础上,我们采用了分阶段的处理方案,将运动标记的学习、领域适应、推理格式获取以及策略优化这四个步骤分开进行,如图 3 所示。这种分步骤的处理方式可以避免产生破坏性干扰,因为对于新引入的运动标记,单纯的标签监督往往不够有效。具体来说,我们采用了四个阶段的处理流程。
阶段 0:GMoT warmup。我们从一个预训练的 MLLM 开始,然后逐步引入所提出的 GMoT 模块进行热身训练。在这个阶段,我们冻结 LLM 和视觉编码器,只更新 GMoT 模块在通用视频数据集上的训练。给定一段视频片段和一个提示,模型会被训练以在标准语言建模损失下预测真实的标签标记。
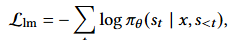
这一做法促使 GMoT 能够生成具有运动感知功能的代币,同时又能保持预训练模型的稳定性。
第一阶段:视频与标签的配对。接下来,我们将该模型应用于微手势领域,通过监督式微调技术在 MG 视频上构建标签对。这一阶段的工作就完成了。我们允许 MLLM 组件在 LoRA[19]框架下进行训练,同时继续优化语言建模目标,以使视觉表示与 MG 特定的标签语义相契合。这一阶段主要提升了领域适应性,并缩小了通用视频理解能力与微手势识别能力之间的差距。
第二阶段:CoT 格式的文本生成。接下来,我们借助 CoT 风格的注释来教会模型一种一致的推理模式。我们会固定视觉编码器的结构,以避免视觉特征发生漂移;同时,我们会与 GMoT 一起对 LLM 进行微调,从而在语言建模损失的基础上生成目标 CoT 文本。我们的监督机制侧重于可观察到的运动线索,而非背景或身份相关的线索。这样,模型就能学会一种基于证据驱动的推理方式,而这种能力将在第三阶段得到进一步强化。
第三阶段:基于奖励的策略优化。在第二阶段之后,模型已经遵循了结构化的推理流程,但 SFT 仍然优化的是代币级别的概率分布,而不是直接选择全局上更优的响应方式。因此,我们在这个阶段采用基于奖励的策略优化方法,通过分组部署和参考式正则化更新目标[16, 40]来提升推理的可靠性,并减少在微妙微动作执行过程中出现错误的情况。
—
Experiment
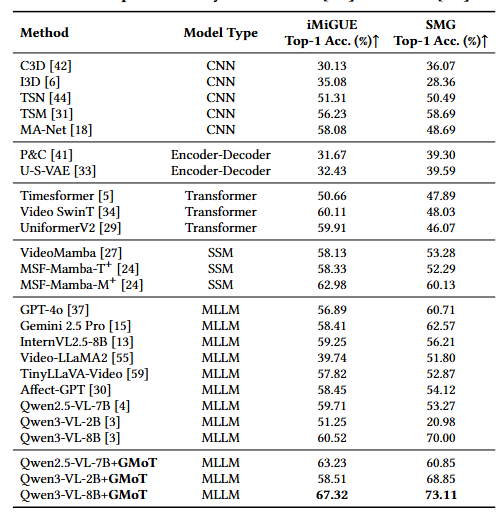
表 1:iMiGUE [33]和 SMG [11]上的最高准确率排名。
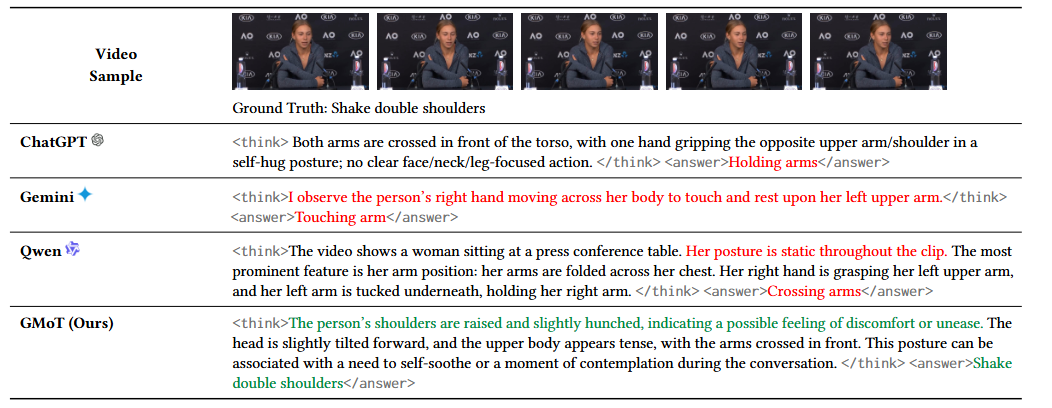
表 4:在具有挑战性的 Shake 双肩动作片段中,不同推理方法的比较。错误的推理以红色标出,而正确的答案则以绿色标出。
为了更好地理解为什么 GMoT 能够改善微手势推理能力,我们针对几个具有代表性的 MLLMs,从定性角度比较了它们生成的推理理由和预测结果。表 4 展示了一个具有挑战性的案例。该片段被标记为“摇晃双肩”,其中的动作识别非常微妙,主要集中在肩部区域。同时,整体姿势中表现出一种强烈的、但具有误导性的手势——双臂交叉。如表 4 所示,一般的 MLLM 模型通常会依赖显著的外观特征来进行预测,并生成在时间上不敏感的推理结果。这些模型不会专注于识别关键的肩部动作,而是认为该片段在时间上基本保持不变,因此会预测出一些在视觉上合理但与动作无关的类别,比如“持握手臂”、“触摸手臂”或“交叉手臂”。相比之下,我们的方法能够产生基于运动的解释,明确地将决策归因于诸如肩膀的姿势变化等因素。同时,该方法还能正确预测出“Shake”动作下的肩膀变化。这与我们的设计目标一致:将与运动相关的信息浓缩成简洁的序列,然后再进行时间建模。通过强调随时间变化的特征,并忽略静态背景线索,GMoT 能够减少由那些并非具有辨别力的外观特征引起的干扰,从而在定性分析中得出更符合运动特性的解释。附录 D 提供了更多的示例和局限性说明。
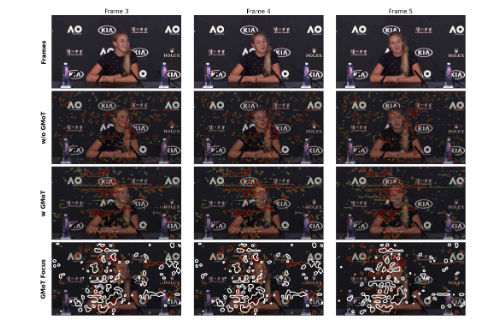
图 4:移动躯干样本上的定性可视化效果。与不使用 GMoT 的情况相比,使用 GMoT 的模型在头部和躯干区域呈现出更为集中的视觉反应。GMoT Focus 线表示了两种模型之间的反应差异图。
图 4 展示了带有和不带 GMoT 模型的两种模型在代表性“移动躯干”样本上的定性比较结果。与不带 GMoT 的模型相比,带有 GMoT 的模型能够更集中地捕捉到与身体运动相关的信号,同时减少了对无关背景区域的激活。响应差异图进一步表明,GMoT 主要增强了与运动相关的线索的显著性,这说明了它在引导模型关注细微区域方面的有效性。
