


来源:高德地图
原文链接:https://mp\.weixin\.qq\.com/s/RbjfT1V632UQwraqHspU7w?scene=1&click\_id=630311600
大会介绍
ECCV(European Conference on Computer Vision,欧洲计算机视觉国际会议)是计算机视觉领域重要的顶级国际学术会议之一,与CVPR、ICCV并称计算机视觉三大会议。本届大会共收到 10,473篇有效投稿论文,最终录用 2,883篇,录用率约为 27.5%;高德地图6篇论文被收录。ECCV 2026将于2026年9月8日至12日在瑞典马尔默举办。
*以下为中稿论文成果,排名不分先后
中稿成果速览
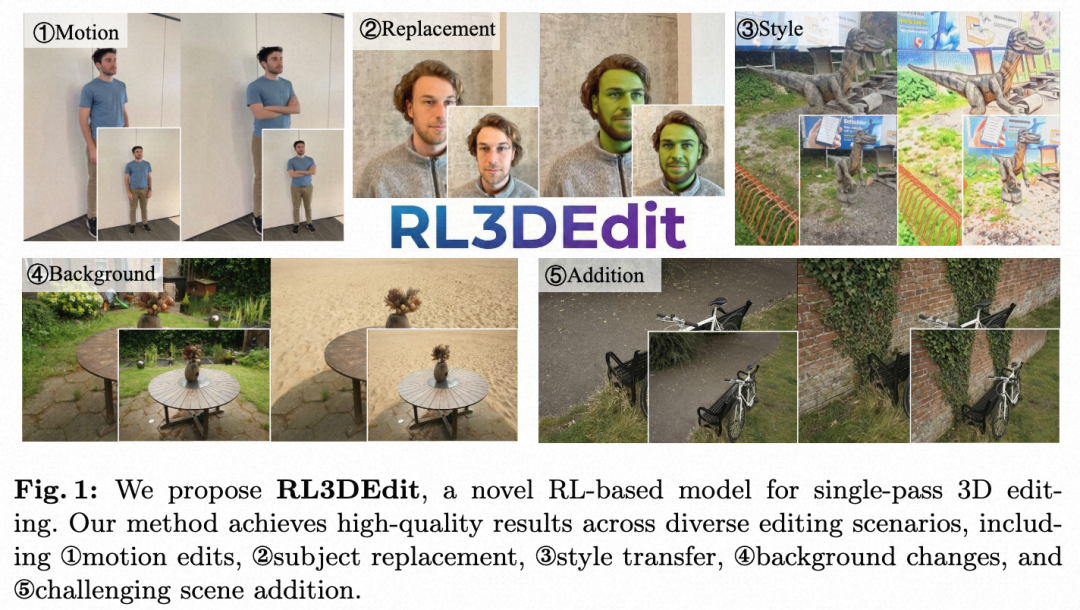
论文01|Geometry-Guided Reinforcement Learning for Multi-view Consistent 3D Scene Editing
技术领域|计算机视觉 / 生成式 AI / 三维内容编辑
论文地址|https://arxiv\.org/pdf/2603\.03143
项目地址|https://github\.com/AMAP\-ML/RL3DEdit
利用二维扩散模型的先验能力进行三维编辑,已成为一个颇具前景的研究范式。然而,在编辑结果中保持多视角一致性仍然十分具有挑战性;与此同时,具备三维一致性的编辑配对数据极其稀缺,这使得监督微调(SFT)这一编辑任务中最有效的训练策略难以实施。
在本文中,我们观察到:尽管生成多视角一致的三维内容非常困难,但验证三维一致性相对可行。这一天然特性使得强化学习(RL)成为一种可行的解决方案。基于这一动机,我们提出了 RL3DEdit:一个由强化学习优化驱动的单次前向框架,并设计了来自三维基础模型 VGGT 的新型奖励信号。
具体而言,我们利用 VGGT 从海量真实世界数据中学习到的鲁棒先验,将编辑后的图像输入 VGGT,并使用其输出的置信度图以及相机位姿估计误差作为奖励信号。通过强化学习,这些奖励能够有效地将二维编辑先验锚定到一个具备三维一致性的流形上。
大量实验表明,RL3DEdit 能够实现稳定的多视角一致性,并在编辑质量方面优于现有最先进方法,同时具备较高的效率。为推动三维编辑领域的发展,我们将开源代码和模型。
论文02|OmniDance: Multimodal Driven Dance Video Generation with Large-scale Internet Data
技术领域|计算机视觉 / 视频生成 / 数字人
论文地址|https://arxiv\.org/abs/2606\.30019
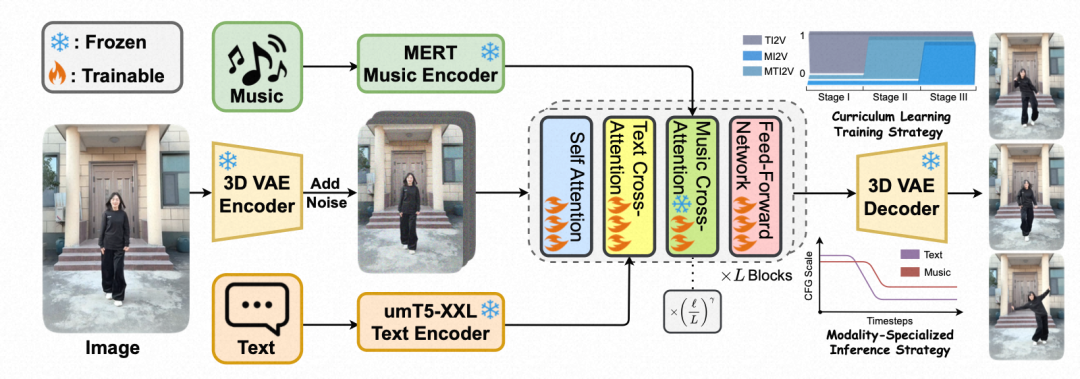
舞蹈视频生成需要在保持人物身份、画面质量和时序稳定性的同时,使人体动作与音乐节奏、情绪和舞蹈语义保持一致。现有方法虽然在姿态驱动动画、说话人生成和音乐驱动三维舞蹈等方向取得进展,但仍难以同时实现高质量视觉效果和富有表现力的全身舞蹈动作,主要受限于缺乏大规模高质量舞蹈视频数据,以及缺少将音乐有效融入视频生成基础模型的统一框架。为此,论文提出 CIPE-Dance 数据集和 OmniDance 框架。CIPE-Dance 通过渐进式专家筛选流水线从互联网构建,包含约30万个高质量片段、超过400小时视频,并覆盖多样舞者、场景和舞种,同时提供舞蹈编排感知文本标注。OmniDance 基于视频生成基础模型,引入音乐交叉注意力、音乐-文本渐进专门化结构、由易到难的课程学习策略,以及模态专门化 CFG 推理策略,实现文本-图像到视频、音乐-图像到视频和音乐-文本-图像到视频的统一生成。实验表明,该方法在视觉质量、动作质量和音乐/文本对齐方面均取得领先表现,具备较强的多模态融合能力。
论文03|CoMaTrack: Competitive Multi-Agent Game-Theoretic Tracking with Vision-Language-Action Models
技术领域|视觉语言导航
论文地址|https://arxiv\.org/abs/2603\.22846
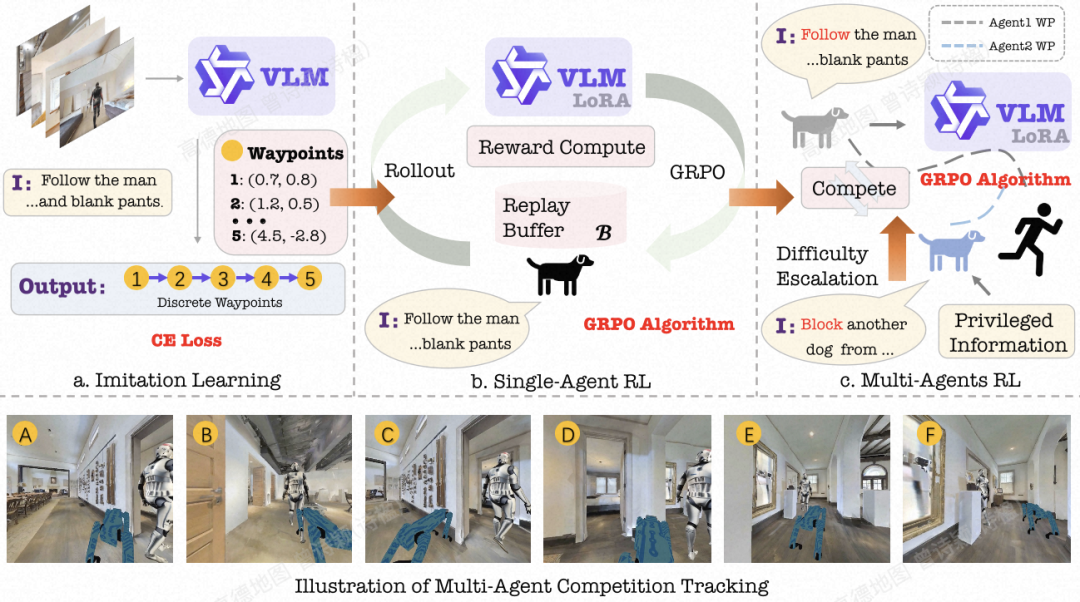
具身视觉目标跟踪要求智能体在第一人称视角下,根据自然语言指令持续跟随动态目标。现有方法大多采用单智能体模仿学习范式,依赖专家演示数据,在训练分布外的场景中泛化能力有限,且缺乏自主进化机制。
受自然界竞争驱动能力演化的启发,本文提出 CoMaTrack——一种竞争性多智能体博弈强化学习框架。该框架将 EVT 从静态数据驱动的模仿学习转变为对抗交互驱动的动态学习:跟踪智能体与自适应对手在多样化环境中展开博弈对抗,对手策略的持续升级为跟踪器提供自动递进的课程学习压力,迫使其发展出更强的预判规划和抗干扰能力,形成自增强的"军备竞赛"式训练循环。
同时,本文提出 CoMaTrack-Bench,首个面向竞争性 EVT 的基准测试平台,包含跟踪器与自适应对手在多场景、多语言指令下的动态对抗场景,填补了现有评测缺乏主动对抗交互的空白。
实验表明,CoMaTrack 在标准基准和对抗基准上均取得最优性能。值得注意的是,仅 3B 参数的视觉语言模型经本框架训练后,在高难度的 EVT-Bench 上超越了此前基于 7B 模型的单智能体方法,在简单跟踪(STT)、干扰跟踪(DT)和对抗跟踪(AT)三项任务上分别达到 92.1%、74.2% 和 57.5% 的成功率。
论文04|ConceptWeaver: Weaving Disentangled Concepts with Flow
技术领域|计算机视觉 / 视频生成
论文地址|https://arxiv\.org/pdf/2603\.28493
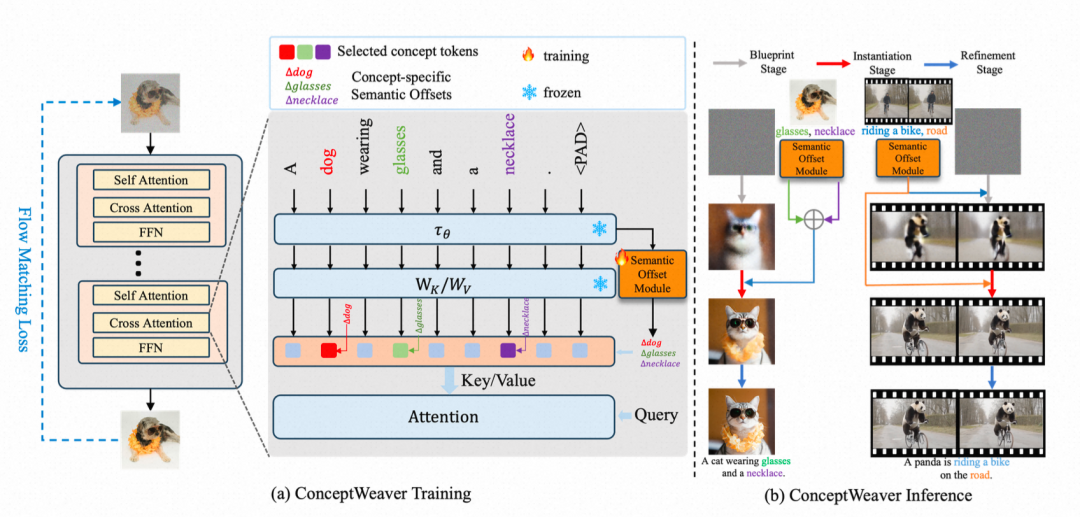
随着文生图/视频生成模型的发展,预训练 flow-based 模型已经能够生成复杂、高质量的视觉内容,但如何从单张真实参考图像中精准提取并解耦不同视觉概念,再将其组合到新场景中,仍是个关键难题。现有个性化生成方法通常面临概念保真度与文本可控性之间的权衡,部分方法还依赖特定 DiT 架构中的调制空间,泛化性有限,并且缺少对“何时操控概念”这一时间维度的建模。
本文提出 ConceptWeaver。作者首先设计差分 probing 方法,分析单个概念 token 对 flow 模型速度场的动态影响,发现生成过程可分为 Blueprint、Instantiation 和 Refinement 三个阶段:早期建立结构,中期内容概念最强且自然解耦,后期细化纹理。基于该发现,ConceptWeaver 从单张参考图像中学习概念特定的语义 offset,并通过阶段感知优化和 ConceptWeaver Guidance 在合适生成阶段注入这些 offset。实验表明,该方法在单概念生成、多概念组合、参考到视频生成、运动概念迁移和图像编辑中均能实现较高的概念保真度、组合可控性和视觉质量。
论文05|Towards High-Resolution Visual Perception via Hierarchical Entity Exploration
技术领域|多模态agent/高分辨图像感知
论文地址|后续更新
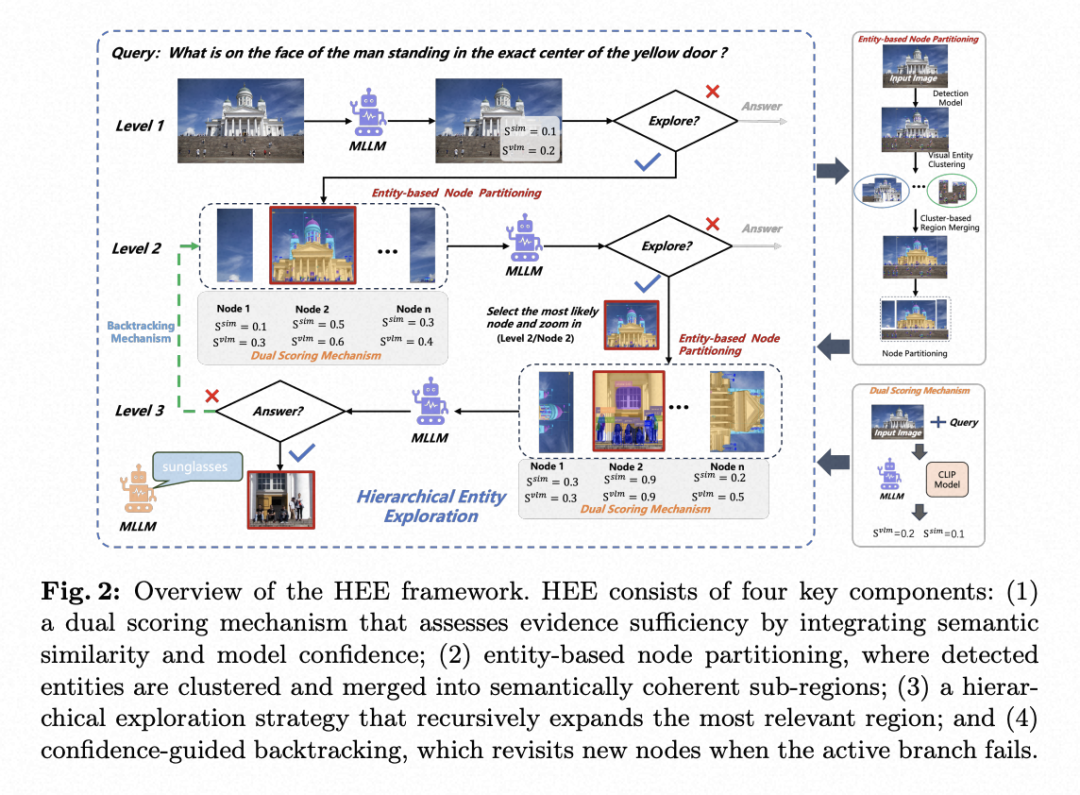
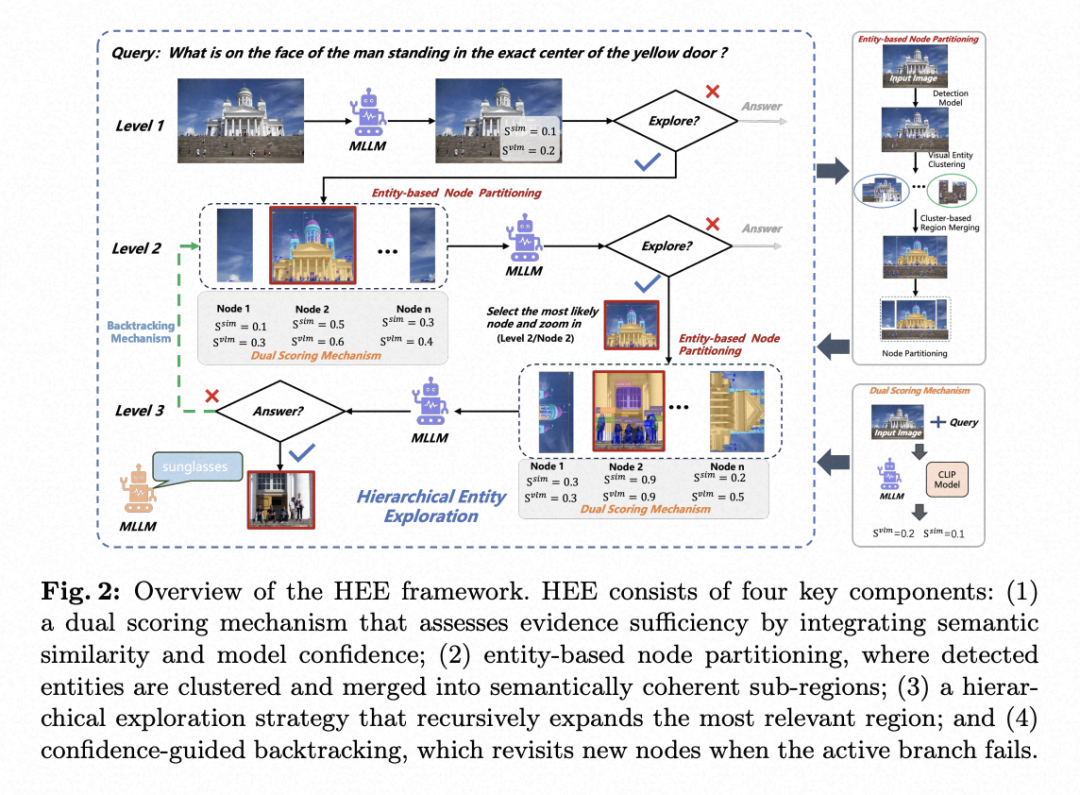
高分辨率图像理解要求多模态大语言模型在有限输入分辨率下仍能主动定位并利用细粒度视觉线索。现有 MLLMs 通常采用固定输入分辨率,直接缩放高分辨率图像会造成几何变形和细节丢失,影响视觉定位、OCR 等依赖精确视觉证据的任务。已有方法多采用“定位再放大”的视觉探索范式,其中基于训练的多模态 agent 通过工具调用或强化学习学习选择关键区域,但训练成本高、部署复杂且跨架构迁移性有限;无需训练的agent方法如 ZoomEye 和 RAP 虽然具备一定的区域搜索能力,但仍依赖几何划分或固定尺度裁剪,无法感知真实物体边界,容易导致实体被切碎并引入无关背景。论文通过分层解耦实验发现,裁剪带来的主要收益并非简单放大目标,而是减少背景干扰:背景遮挡可稳定提升准确率,而向目标区域外扩展无语义背景会降低性能。基于这一发现,论文提出 Hierarchical Entity Exploration(HEE),一种无需训练、模型无关的多模态视觉探索 agent 框架。HEE 将高分辨率图像理解建模为一个层级式感知与决策过程:agent 使用冻结目标检测器发现实体级候选区域,通过双重评分判断当前视觉证据是否足以回答问题,并在证据不足时继续围绕完整物体进行聚类、合并和递归探索,同时利用置信度引导的回溯机制避免单一路径搜索失败。实验表明,HEE 在 Visual Probe、HR-Bench 和 MME-RealWorld 等多个高分辨率基准上显著提升 Qwen2.5-VL、LLaVA-OneVision 等开源 MLLMs 的性能,并优于 RAP、ZoomEye 等无需训练的agent方法,同时具有更低计算开销。
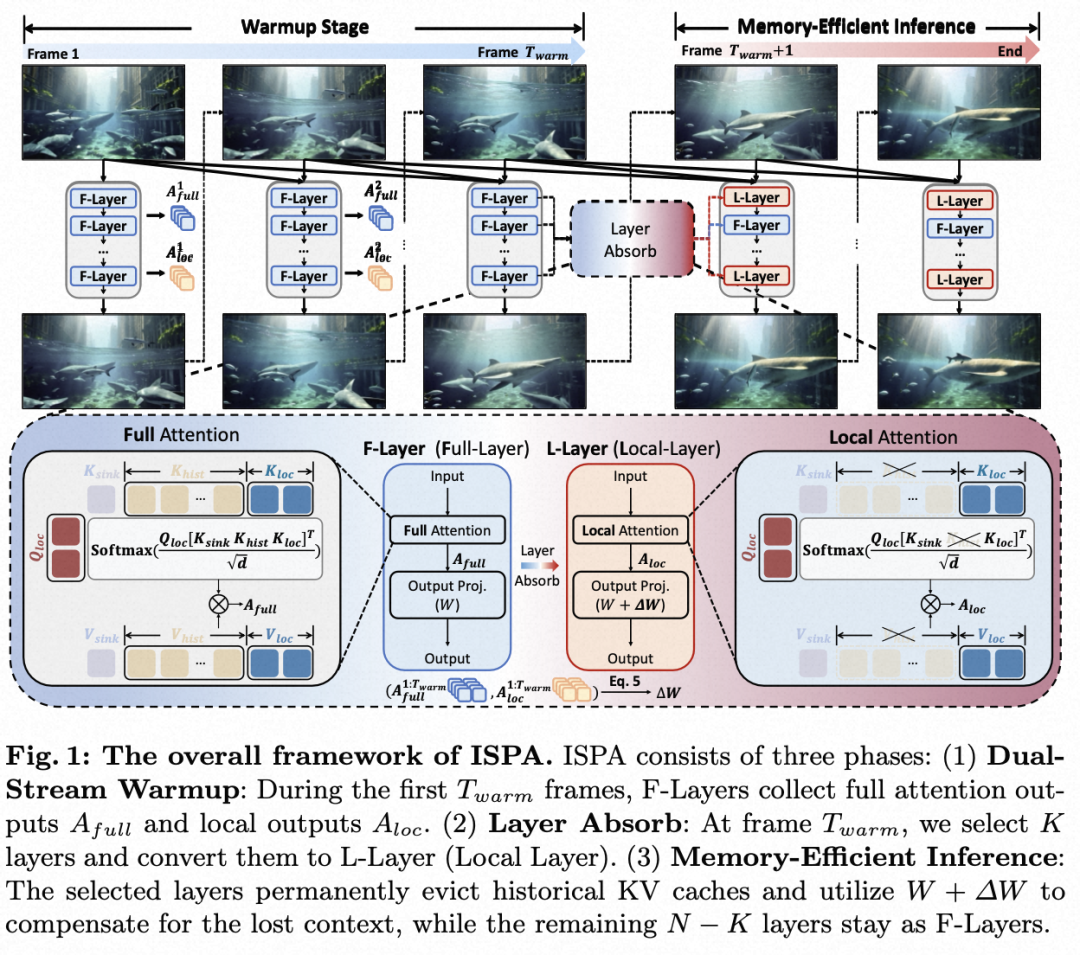
论文06|Towards Memory-Efficient Autoregressive Video Generation via Instance-Specific Parametric Absorption
技术领域|计算机视觉 / 视频生成
论文地址|后续更新****
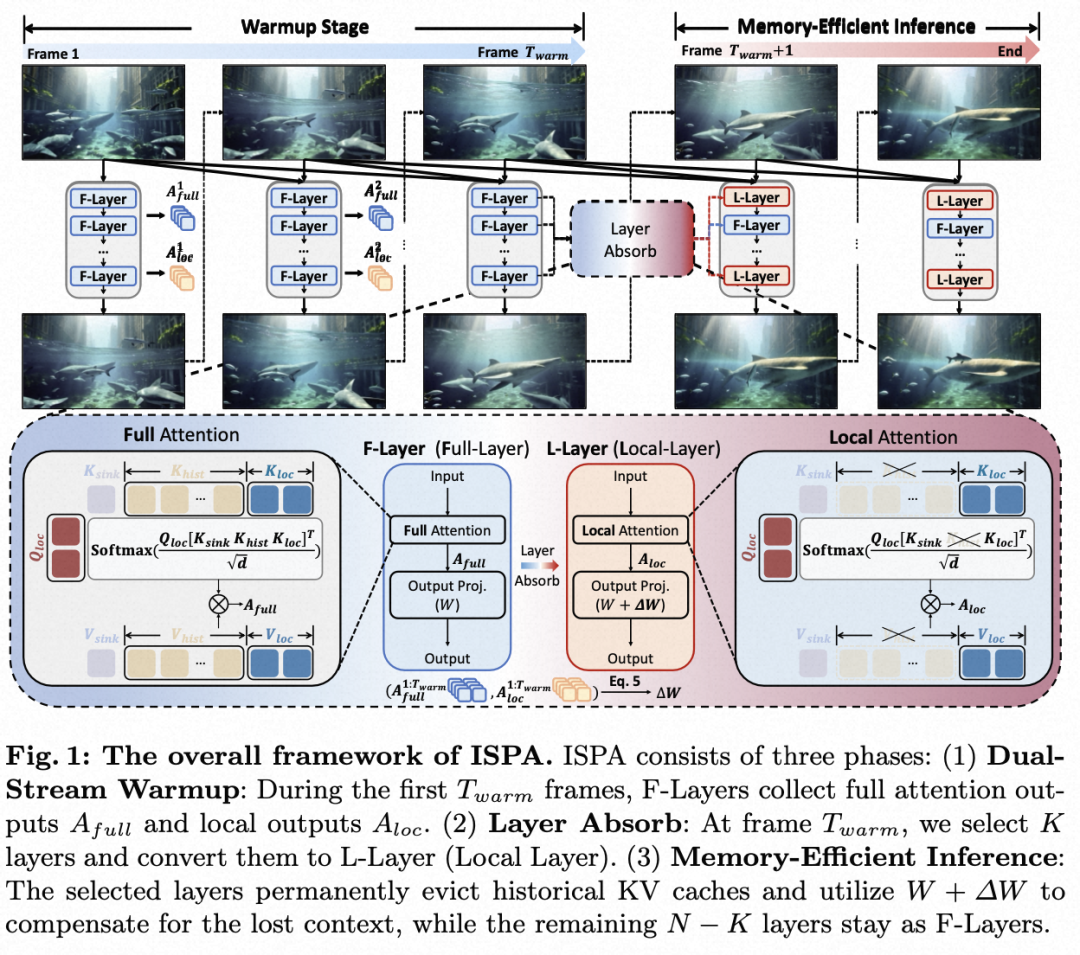
长视频生成正逐渐从离线整段生成转向自回归流式生成,以支持更长时序甚至近实时的视频合成。然而,自回归模型依赖持续累积的 Key-Value(KV)缓存来传递历史信息,随着生成长度增加,KV Cache 会造成显存占用线性增长和推理吞吐下降。现有压缩方法多通过丢弃冗余 KV token 缓解内存压力,但在动态视频信号中容易破坏长程依赖,导致背景闪烁、结构失真和主体身份漂移。为此,我们提出 Instance-Specific Parametric Absorption(ISPA),将 KV Cache 压缩从“裁剪历史”转变为“吸收历史”。具体而言,ISPA 在短暂 warmup 阶段同时收集全局注意力与局部注意力输出,并将二者差异建模为重建问题,通过闭式最小二乘解计算实例特定的权重调制,将部分全局注意力层转换为局部注意力层,同时用更新后的投影权重补偿被移除的历史上下文。我们还设计了基于 Online Softmax 和 LSE 状态的可分解注意力机制,以低开销完成信号收集。实验表明,ISPA 可在文本到视频和语音到视频等任务、多种 1.3B 至 14B 架构上移除最高约 50% KV Cache,并保持近无损视觉质量;结合 W8A8 量化后,可实现整体 1.86 倍推理加速。
原文链接: https://www.leiphone.com/category/private/nvr9UffdIzRDYPpH.html
