


来源:公众号“AI档案室
当你在一个项目中和 AI 助手持续协作了几周,
突然有一天它忘了上次你们定好的截止日期是 5 月 30 日而不是 6 月 1 日,
你会不会有一种「从头再来」的无奈?
这恰好是当前 AI Agent 面临的最核心瓶颈之一:
大语言模型本质上是「无状态」的,每次对话都是从零开始。
长任务中,
信息要么以原始文本碎片堆砌在一起,要么被粗暴压缩为模糊摘要而丢失关键细节。
2026 年 6 月 29 日,
Microsoft Research 正式对外公布了针对这一问题的解决方案:
一个名为 Memora 的 Agent 长期记忆系统。
论文已被 ICML 2026 接收,
arXiv 预印本早在今年 2 月上线,
代码也已于 6 月 16 日在 GitHub 以 MIT 协议开源。
更值得注意的是,
这套系统在 LoCoMo 和 LongMemEval 两个主流的 Agent 长期记忆基准上均达到了当前最优水平。
回看现有记忆方案,无论是 RAG(检索增强生成)还是 Mem0、Zep、GraphRAG,
本质上都陷入了「鱼和熊掌不可兼得」的困境。
一类方案直接嵌入提取的事实或文本片段,能保留细节,
却产生大量孤立、脆弱的条目,丧失叙事连贯性;
另一类方案将全部经验压缩为紧凑摘要,虽然高效,
却把约束条件、边界情况和数值细节一并丢弃。
基于知识图谱的方案虽然增加了一层结构,
却依赖于刚性本体论,难以跨领域泛化。
Memora 的核心洞察在于将「存储什么」与「如何检索」这两件事彻底拆开。
每个记忆条目由三个组件构成:记忆值(Memory Value)完整保留原始信息而不做任何压缩;
主抽象(Primary Abstraction)是一个 6 到 8 词的短语,
捕捉记忆的核心内容,作为更新和聚合的单元;
线索锚点(Cue Anchors)则是从记忆中提取的多个短小标签,
提供从不同角度找到同一条记忆的路径。
关键设计原则是只索引抽象层和线索锚点,
不直接索引原始记忆值,
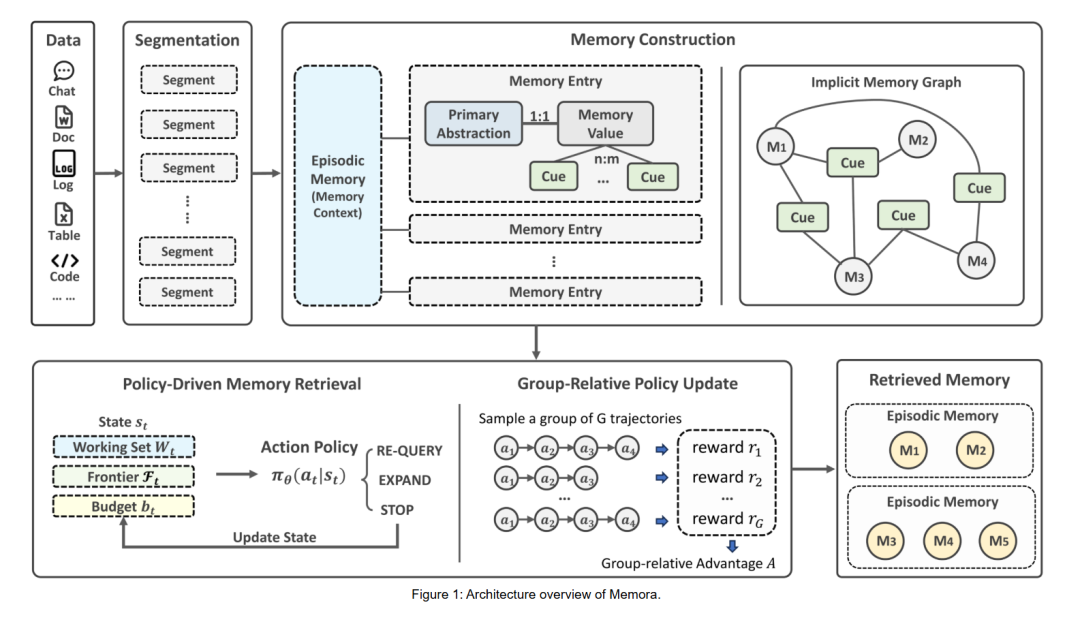
这样既保留了完整的细节信息,又避免了直接索引原始内容带来的噪音。
这套设计在处理真实工作场景中常见的「半结构化、充满例外」的信息时尤其有优势。
比如用户说了一句「Dave 和 Sarah 同意将原型推迟到 4 月 1 日、试点到 5 月 2 日、MVP 到 5 月 30 日」,
传统知识图谱需要预定义实体类型和关系,
任何新关系都需要扩展模式;
而 Memora 的做法是生成主抽象「Dave 和 Sarah 就 Orion 项目更新后的时间表达成一致」,
再附加多条线索锚点如「Dave 的 Orion 项目更新」「Orion 项目原型排期」等。
无论后续查询是「Dave 最近做了什么」还是「原型什么时候交付」,
都能通过不同的锚点路径导航到同一条底层记忆。
在检索层面,Memora 同样跳出了一次性 top-k 语义搜索的惯性思维,
将检索过程形式化为一个马尔可夫决策过程(MDP)。
检索器不是一次性返回最相似的结果,而是在多步交互中逐步调整:
它可以重新表述查询(Refine)、从关联记忆中扩展搜索范围(Expand)、在信息足够后主动停止(Stop)。
这种策略可以由强模型驱动,也能通过强化学习蒸馏到小型模型。
团队已经在 Qwen-2.5-3B-Instruct 上验证了这套训练方案,
GRPO 训练后的检索器准确率达到 0.841,而基础模型基线仅为 0.836。
论文在附录中给出了完整的数学证明框架。
传统 RAG 实际上是 Memora 的一个特例:
主抽象等于原始内容,线索锚点为空,策略只执行一步查询加停止。
隐式和显式知识图谱检索也同样被证明是 Memora 的特例。
更重要的是,论文证明了存在某些检索函数,
无法被固定 top-k 的扁平相似度搜索或固定单种子扩展的知识图谱检索所实现,
而 Memora 可以:这赋予了它理论上超越传统方法的能力。
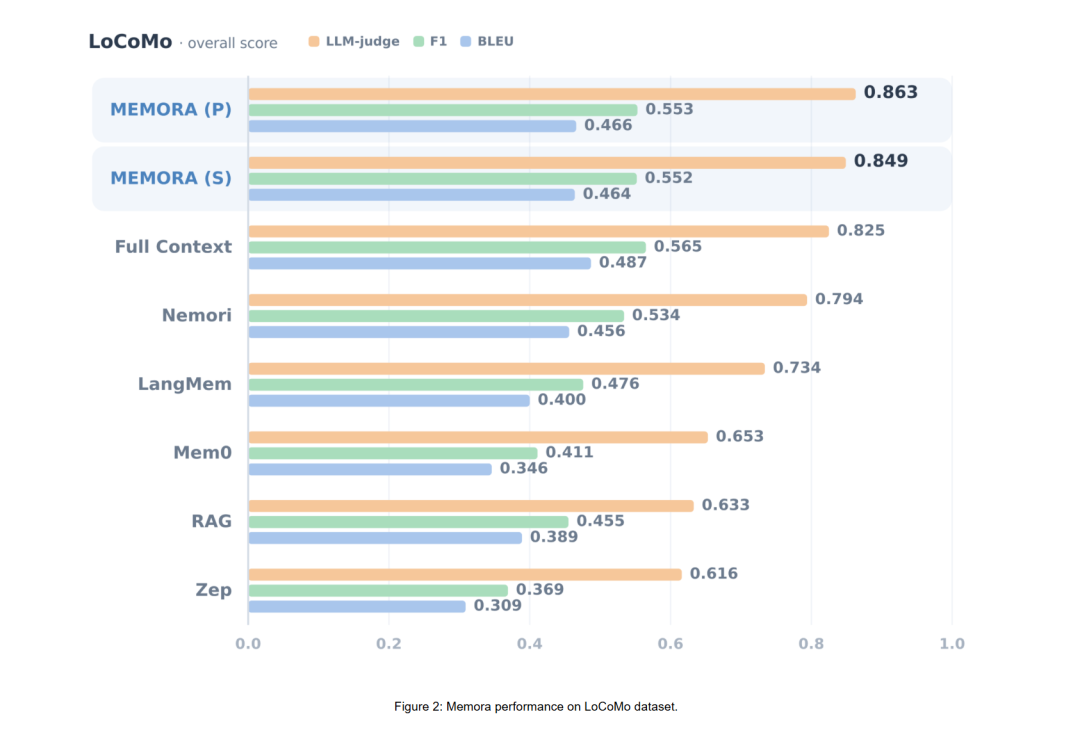
在 LoCoMo 基准上(平均 600 轮对话,约 20000 个 token,涵盖单跳、多跳、时间推理和开放域四类任务),
Memora 的策略检索模式以 0.863 的 LLM-Judge 评分登顶,
显著优于完整上下文方法(0.825)、Nemori(0.794)、LangMem(0.734)、Mem0(0.653)、RAG(0.633)和 Zep(0.616)。
在 LongMemEval 基准上(500 个问题覆盖 5 种记忆能力,上下文长达 115000 个 token),Memora 以 87.4% 的准确率大幅领先全上下文推理的 65.6%,
而消耗的上下文 token 从 115000 降到了 2900,减少了约 98%。
在「知识更新」子任务上,Memora 达到 97.4% 的准确率,
而全上下文方法仅为 76.9%;在「时间推理」上也是 89.5% 对 60.2% 的显著优势。
在效率方面,每个对话平均只存储 344 条记忆条目,约为 Mem0(651 条)的一半。
消融实验还揭示了一个有趣的现象:
策略检索器优于语义检索器,但一旦移除线索锚点,这个优势就消失了:
说明优势来自锚点提供的多路径导航能力,而非策略本身的复杂性。
上下文粒度实验则显示,
原始片段情景记忆加事实记忆的组合(0.863)优于摘要情景记忆加事实记忆(0.838),再优于仅事实记忆(0.833),证明情景与事实记忆之间存在互补效应。
原文链接: https://www.leiphone.com/category/private/Be2LPXPoAjG1nwkh.html
