


来源:原文链接:
https://mp\.weixin\.qq\.com/s/tFfBQaXAMH4HM9obaSqjYg
让机器人在真机上靠自己越练越好,是这两年具身圈最主流的一条路,做法是让策略先从离线示范里学个底子,再靠一个奖励信号在真机上反复迭代。整条链路的成败几乎都取决于这个奖励信号,可它偏偏是最难拿的一环。
难处在于,一件长活儿的“好”从来不止一个维度。让一台 Franka 摆餐具,你要它把盘子放对位置,还要它放得稳、下手轻、不磕不碰。可现有的偏好学习只让标注员回答一个问题,这两段视频整体哪段更好。一段快、却中途把吐司掉在了台面,另一段稳当、却慢吞吞,这两段哪段更好根本答不上来,人心里明明攥着好几把尺子,被逼着只报一个总分,收上来的标签既模糊又互相打架,机器人拿这样一批监督去学,自然学不明白。
真问题就一句话,机器人做长活儿时,“好”本就是多维的,而现有的监督方式,偏偏逼着人把这几个维度压成一个数。
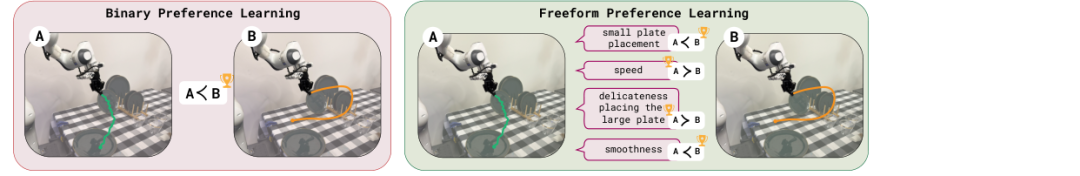
Figure 1,二元偏好 vs 自由形式偏好的对比
01真机 RL 想自我改进,奖励到底从哪来
奖励信号难拿,前人试过四条路,各自都在同一个地方受阻。
最省事的一条,是稀疏的成功标签,SERL、QT-Opt 那一系用的就是它。人判定一件事成没成非常容易,标注负担也轻,可它只给出一个 0 或 1 的结果,把全部学习负担都转嫁给了强化学习算法本身。长程任务里成功本就稀少,这种信号太弱,策略几乎学不动,更管不了过程做得漂不漂亮这一层。
于是有人转去学一个稠密的标量奖励,也就是塑形奖励,近来一批基于视觉语言模型的奖励模型都属于这一类。信号确实稠密了,能给任务进度连续打分,可它盯着的仍然只有任务进度这一个维度,忽略了任务是被怎样完成的,而且塑形奖励一旦不够准,策略很擅长钻它的空子。
真正把监督问题往前推了一大步的,是偏好学习。Christiano 那篇 2017 年的工作立下了范式,不用手工设计奖励,只让人比较两段轨迹哪段更好,就能反推出一个稠密奖励,这套思路后来在大模型的 RLHF 上被反复验证有效。
但它有一个前提假设,要求标注员把心里的多个判断塌缩成一个整体偏好。语言模型里一句回答好不好还勉强能整体判断,可机器人做一件长活儿,一条更快、另一条更安全,哪条整体更好根本答不上来,偏好学习在长程操纵上受阻的地方恰恰就在这一步。
还有一类相邻的做法,是固定的多奖励或多目标强化学习,比如 Promptable Behaviors,它允许你在测试时用一组权重向量去调不同目标,也可以给每个类别各训一个奖励模型。问题是它得事先把一组轴固定下来,速度、快、高效这些意思相近的说法,在它眼里成了彼此独立的类别,跨语义泛化的能力受限。
这四条路各有各的好,也各自止步在同一个地方,要么把监督压成一个太粗的信号,要么逼着人在多个维度上强行报一个总分。这篇论文要解决的,正是前人绕不过去的那一点,怎么让人给出的监督既稠密、又不含糊。
02FPL 怎么做,让标注员自己定义要比较的维度
这套方法叫自由形式偏好学习(Freeform Preference Learning,简称 FPL),来自 Stanford 的 IRIS Lab。一作 Marcel Torne 主导了算法、奖励模型,还搭了整套仿真基准,此前在 MIT 做过不少机器人强化学习和人在环反馈的工作。
更值得留意的是通讯作者 Chelsea Finn。她是 Stanford 副教授,同时负责 IRIS Lab,元学习方法 MAML 由她提出,她也是具身大模型公司 Physical Intelligence 的联合创始人,从 π0、π0.5 到 π\*0.6 的整条 VLA 系列都出自她这里。
这个作者组合和这篇工作是对得上的。Finn 组一边在做能真机跑起来的 VLA 基础模型,一边长期深耕从人类反馈和偏好里学习,一直做到 DPO 的共同作者,FPL 正好落在这两股专长的交汇处,拿自家的 VLA 当策略底座,把偏好学习从单一整体偏好推进到用自然语言定义的多维偏好。
FPL 的核心动作,简单来说就是不再逼标注员给一个整体分,而是让他自己用一句自然语言定义要比较的维度,再在这根维度上逐对给偏好。这个维度,论文里叫偏好轴,一根轴就是标注员心里评判好坏的一个具体角度,比如快不快、摆得正不正、轻不轻手,用一句话写出来即可。
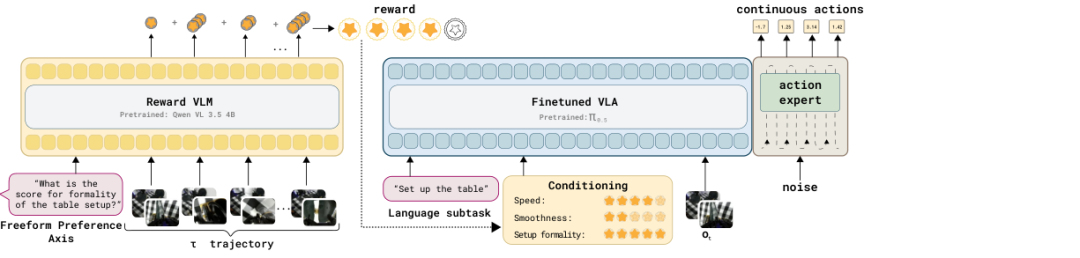
Figure 2,FPL 方法总览,语言条件多维奖励模型 + 奖励条件策略
03方法的两块骨架,轴条件奖励模型和奖励条件策略
把这件事拆到机制上,FPL 由两块拼起来。
第一块是一个轴条件的单一奖励模型。它的底座是 Qwen VL 3.5 4B 这个多模态 Transformer,读进一整条轨迹加上一个轴标签,输出这条轨迹在这根轴上的分数。同一个模型,换一个轴标签,就是在给另一根轴打分,所有的轴共用这一个模型。
具体到公式,论文把经典的 Bradley-Terry 偏好模型做了一次扩展。原本的 Bradley-Terry 只学一个单维奖励,FPL 让奖励函数额外读入一个自然语言轴标签,对同一对轨迹按每根轴分别算偏好损失,这就是 Eq.3。而一条完整轨迹的奖励怎么算,用的是 Eq.4,把轨迹的每一个前缀观测都打一次分再求和,等于是在整段观测历史上打分,而不是只看最后一帧,这样才抓得住动作在时间上的依赖关系。
第二块是奖励条件策略。这里的条件不是让策略去把某个奖励最大化,而是把一组目标当成输入送给它,告诉它要在哪几根轴上、各达到多高的奖励,策略要学的就是在这组目标下该怎么动。到了测试时换一组目标条件,行为就跟着换。这块的底座是 π0.5,也就是 Physical Intelligence 那个 VLA,训练时把所有轴的描述连同各轴的目标奖励一起作为条件送进去,让策略学会在这些奖励目标下该怎么动,对应 Eq.5。
整套流程是离线加批量在线的,既能拿离线数据练,也能上真机边采边更新,比 PPO 在真机上省样本。
04为什么这么设计,而不选更省事的那种
这套方法里有两个设计选择,作者都主动否定掉了一个更直觉的替代方案,这两处才是真正拉开差距的地方。
第一个问题,既然要按轴打分,为什么不干脆给每根轴单独训一个奖励模型,像那些按类别分模型的做法一样。原因在于固定 K 个轴根本不通用。标注员嘴里的速度、快、高效意思几乎一样,可要是各自为政地训成独立模型,它们之间的相通性就全丢了。FPL 把轴的文字描述直接作为条件送进同一个模型,借的正是 Qwen VL 这个视觉语言底座的语言表示,让这些近义描述在表示空间里自然共享。
一个模型,承接无限多根轴,这才是它能泛化的原因。
第二个问题更关键,既然手里已经有了多根轴的奖励,为什么不把它们加权求和成一个标量,再上标准的强化学习,那样后面全是现成的。答案是塌缩成单标量要付出两重代价。
一是更容易被策略钻空子,也就是 reward hacking,多个维度压成一个数之后,策略总能找到某种在数值上得分高、实际上很糟糕的做法。二是一旦求和,组合性和测试时的可操控就都没了,而保留分解的多维结构,恰恰是后面那些好性质的来源。
05真机上赢了多少
先看总账。在四个真机任务上,FPL 平均比第二好的基线高出 38 个百分点,这是绝对差距,把成功率整体抬高了一大截,不是换算出来的相对提升。
四个任务里,前两个是把方块放进目标碗、叠短裤,后两个是给吐司装盘、摆餐桌,全都跑在 DROID 平台的 Franka 机器人上,两路相机分别装在腕部和第三人称视角,用关节速度控制,每个任务都从质量参差、策略也参差的离线示范起步。
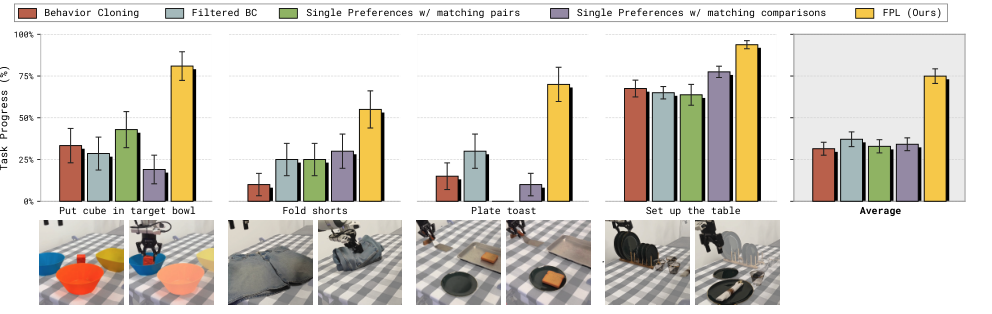
Figure 3,真机四任务上 FPL 平均领先第二名 38 个百分点
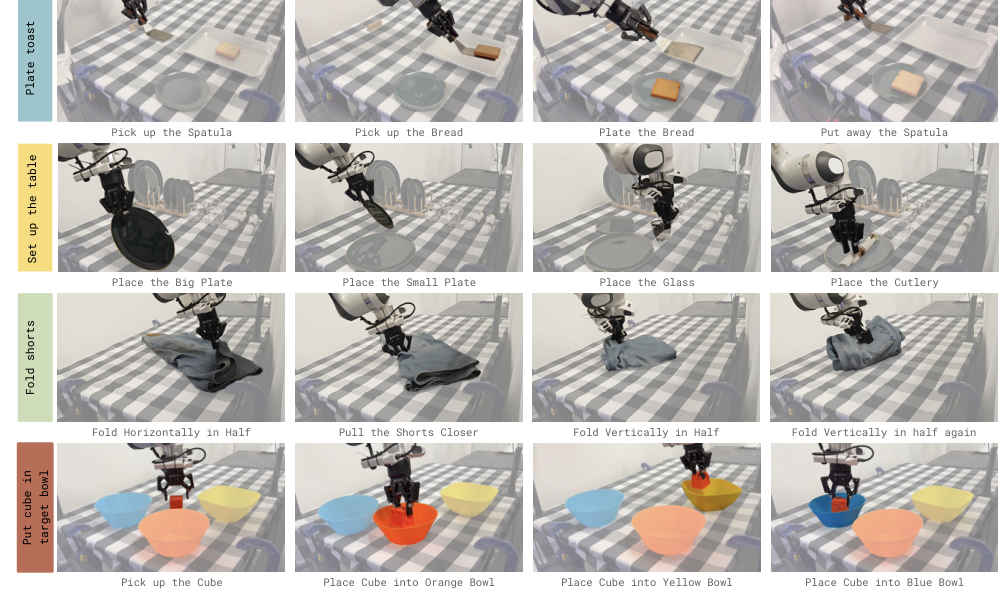
Figure 7,四个真机任务套图
仿真里的数字更能看清它赢在哪。在物体重排这个长程任务上,离线数据里完整成功的例子很少,FPL 的成功率是 0.84,复现自 Physical Intelligence π\*0.6 的 Advantage Conditioning 基线只有 0.17,纯行为克隆更是低到 0.04。
数据这一侧还有个反直觉的发现。以给吐司装盘为例,295 对轨迹比较,在自由形式的方式下被拆出了超过 1477 条轴级比较,覆盖 41 个不同的轴标签。同样是这 295 对视频,二元偏好只能收上来 295 条整体判断,拆成轴之后监督密度差了将近五倍。
还不只是密度。因为看一遍视频的成本被多条轴级判断分摊,自由形式偏好平均每条标签比一条二元偏好快约 50%。人在评价一台机器人时,本来就会不自觉地动用一大堆不同标准,FPL 只是把这些标准接住了。
除了跑分,论文还给出三个定性发现。
第一个是组合性,指的是训练数据里没直接演示过的行为组合,模型能自己拼出来。在 bimodal square 这个测试里,离线数据的左桩既有快的示范也有慢的,右桩却只有慢示范,结果 FPL 在右桩上做出了比训练数据更快的轨迹,一个数据里压根不存在的组合,而单偏好基线只能复刻已有行为,超不出去。
它的吞吐在正版和反转版上分别是 1.19 和 1.24,双双超过 1.0,也就是比示范本身还快,基线则统统停在 0.7 上下。
第二个是可操控,指同一个训好的策略不用重训,只改测试时给的奖励目标,就能切换成另一种行为。在反转版 bimodal square 上,同一个策略只改一下条件,就能从把螺母放右桩切成放左桩。FPL 是唯一在原版和反转版上都拿高分的方法,原因是它训练时不过滤经验回放缓冲区,策略见过每根轴上的高分行为,也见过低分行为,两头都学到了。
第三个是信用分配,也是最能说明问题的一个,指的是把最终的好或坏正确地摊派到过程中的哪一步动作上。在摆餐桌任务里,论文并没有给机器人显式切分子任务,可 FPL 学到的轴奖励,会在放大盘、放小盘、放杯、放餐具这些子任务事件附近自动出现时间上的局部峰值。反观二元偏好学到的奖励,却在整段视频的末尾出现一个大峰,而那个时刻其实并没有完成任何关键子任务,这是一次明显的信用分配错误,奖励升错了地方。
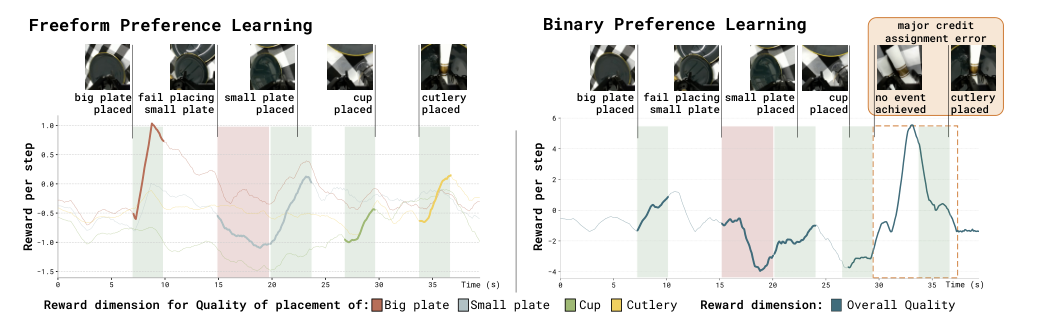
Figure 6,摆餐桌任务奖励对比,FPL 轴奖励随子任务时间局部化,二元偏好末尾误升
06放到行业坐标里,它对位的是谁
FPL 有一个非常清楚的对位对象,就是 Physical Intelligence 的 π\*0.6,那篇 a VLA that learns from experience,本文的 Advantage Conditioning 基线就是照它复现的。两者其实在解同一件事,真机 VLA 如何从经验里自我改进,分歧只在监督信号长什么样。
π\*0.6 的信号来自成功失败加上 time-to-go 推出的价值函数,最后塌缩成一个二值的 advantage 标量,好处是几乎全自动、不需要人逐条标偏好,代价是维度单一,而且在成功稀少的长程任务上信号稀疏。
FPL 反过来,信号来自人给的自然语言多维偏好,保留多根轴分别打分,稠密而且自带时间局部化,代价是重新把人放回了环里,稍微贵一点。就是这个取舍上的差别,换来了仿真物体重排上 0.84 对 0.17 的结果。
对不同玩家,这篇的启示不太一样。对自建得起 VLA 的大厂,比如 PI、英伟达这类,它提示的是与其一味追求全自动的单标量奖励,多维偏好可能才是长程任务的突破口,而且人力标注成本可控,还能省下一半。对预算有限的学术组,它给了一个能上手的真机 RL 方案,四个真机任务加两个仿真就跑出结论,偏好采集比大规模真机数据采集轻得多。对要求可控的工业落地方,测试时的可操控直接有用,同一个策略不重训就能按现场需求切行为,部署侧省下重训成本。
真机 RL 的胜负手,正在从优化算法那一侧,移到监督信号的形态这一侧。此前梳理 Finn 组这方面的工作时就有过一个判断,谁能低成本地评估、便宜地监督,谁才能把模型持续训好,EXPO 在优化侧取的巧、π0.5 从想象中拿评估,都是这个判断的不同侧面,FPL 是它在奖励这一侧的延续。
07边界在哪
这套方法的代价也要正视。它比全自动的方案更贵,因为始终要人来提供逐轴偏好,虽然每条标注省了一半时间,人终究没有离开这个环。验证的规模也还有限,四个真机任务加两个仿真任务都是桌面级操纵,还没延伸到时间更长、接触更复杂的开放场景。标注员定轴的过程里有多少主观漂移、长期迭代会不会引入偏置,论文也留了口子没有细究。
但方向上,FPL 把一个被绕了很久的问题重新摆正了。机器人做长活儿时,人心里本来就有好几把尺子,过去的做法非逼着他合成一把,FPL 让他把这几把尺子分开来,一根一根地量。单标量奖励的天花板,也许就止步在它把太多东西压成了一个数。
原文链接: https://www.leiphone.com/category/private/dxFA9Sdud4bDzfqI.html
