


来源:深度学习研究生
原文链接:https://mp\.weixin\.qq\.com/s/LXcUJQZW93VOteOFdpj8QA
✨导读:通用多模态检索常用对比学习,但它把负样本简单当成“不是答案”,容易忽略查询里的细粒度实体、属性和动作。ELVA 把检索训练改成 ranking-driven RL:不用额外 reward model,而用可验证排序奖励和 margin reward 让模型学习负样本之间的相对层级。ELVA-7B 在 M-BEIR 平均 Recall 达到 58.7,在多粒度 MRBench 上比 LamRA 提升 13.1%。
• 作者: Yuhan Liu, Pei Fu, Hang Li, Yukun Qi, Chao Jiang, Jingwen Fu, Zhen Liu, Bin Qin, Zhenbo Luo, Jian Luan, Jingmin Xin
• 单位: 西安交通大学人工智能与机器人研究所;MiLM Plus, Xiaomi Inc;Zhongguancun Academy
• 论文标题: ELVA: Exploring Ranking-Driven Universal Multimodal Retrieval
• 论文链接: https://arxiv\.org/abs/2606\.20280v2
• 发表信息: ECCV 2026
“找一张类似图片”很简单,但“找一张同一角色、正在喷火、背景类似的图片”就不只是正负样本问题了。一个 query 里可能同时包含实体、动作、颜色、场景、关系等多个 grain。传统对比学习只拉近正样本、推远负样本,容易让模型满足于最显眼的 grain,而忽略次级但关键的信息。
论文把这个问题称为 grain blindness:当 dominant grain 已经足够区分正负样本,其他 grain 的梯度信号就被“饿死”。结果是模型看似检索准确,但面对多属性、多意图、多模态组合 query 时,会抓住一个大概方向,却漏掉决定答案的细节。
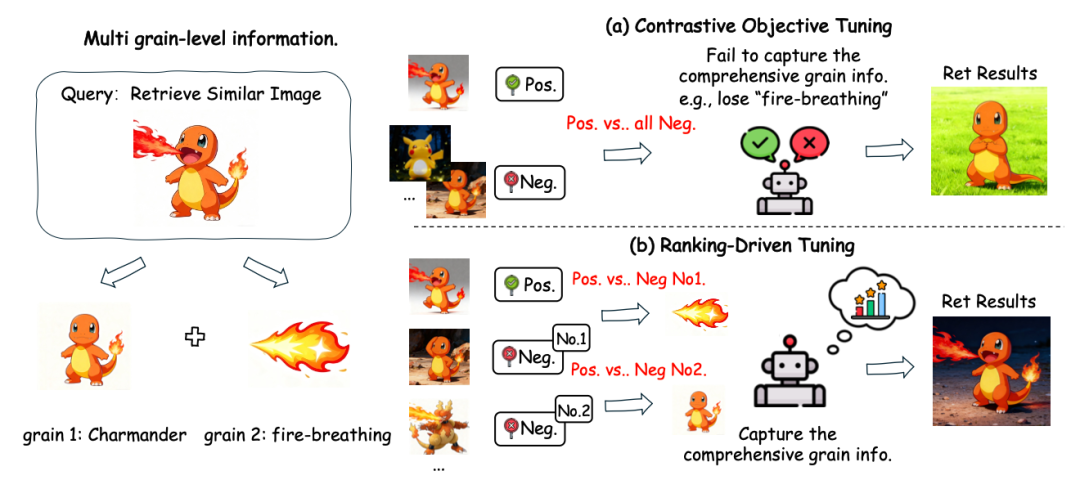
图注:原文 Figure 1。该图用 Charmander/fire-breathing 例子说明,普通 contrastive objective 容易只学到主实体,而 ELVA 通过排序驱动训练,让模型同时保留实体和动作等多个 grain。
ELVA 的直觉很检索工程:越像正样本的负例,越应该被模型认真区分。它沿用三阶段路线:前两阶段做预训练和 instruction tuning,第三阶段引入 RL with Verifiable Rewards。
为了让 RL 能探索 embedding 行为,ELVA 不再只抽取固定 prompt token 的 hidden state,而是让模型先生成输入摘要,再输出特殊 token [RET],取 [RET] hidden state 作为 embedding。这样,同一个 query-candidate 组合可以产生多组 rollouts,用 GRPO 比较不同排序行为。
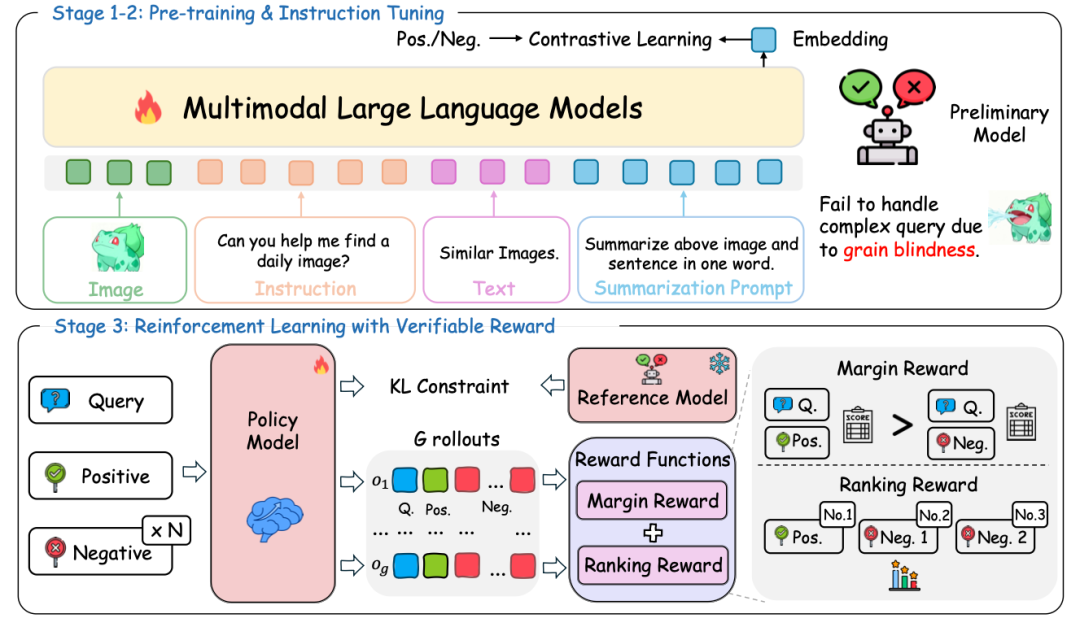
图注:原文 Figure 2。该图展示 ELVA 的三阶段框架:在已有检索模型基础上,policy model 对 query、positive 和多个 negatives 生成 embedding rollouts,再用 ranking reward 与 margin reward 进行 GRPO 更新。
ELVA 不训练额外 reward model,而是把检索指标转成可验证规则。两个奖励互补:
1.Ranking Reward:鼓励正样本排在更靠前的位置,同时让负样本按相似度形成合理次序,思想接近 NDCG。
2.Margin Reward:关注正样本和 hardest negative 的相似度 gap,避免模型把最容易混淆的负例放得太近。
此外,ELVA 还设计了 balanced negative sampling,过滤掉过难负例,避免训练早期被噪声或 false negative 扰乱。这样做的目标不是让模型背排名标签,而是在没有人工 ranking labels 的情况下,自动探索更合理的候选层级。
核心定义里,grain blindness 被写成:d(f(q), f(q \ {g_k})) < delta。也就是说,如果删掉某个关键 grain 后 embedding 距离几乎不变,模型就没有真正保留这个粒度信息。
训练设置分三步。第一阶段做检索预训练,第二阶段 instruction tuning,第三阶段 RL。M-BEIR 覆盖 8 类检索任务、10 个数据集、约 1.1M 训练样本;RL 阶段从各数据集采样 1% 构造 11K instances。实现基于 PyTorch 和 Qwen2-VL-7B,预训练用 8 张 H20、batch size 576、学习率 4e-5、2 epochs;instruction tuning 用 16 张 H20、batch size 960、学习率 1e-4、1 epoch;RL 用 8 张 H20、学习率 1e-6、8 rollouts、beta=0.2、1 epoch。视觉编码器冻结,语言模型用 LoRA 微调。
在 M-BEIR test set 上,ELVA-7B 平均 Recall 达到 58.7,高于 LamRA-Ret-7B 的 56.6、PUMA-3B 的 54.4、MM-Embed-7B 的 52.7。ELVA-2B 平均 53.8,也能超过不少更大模型。
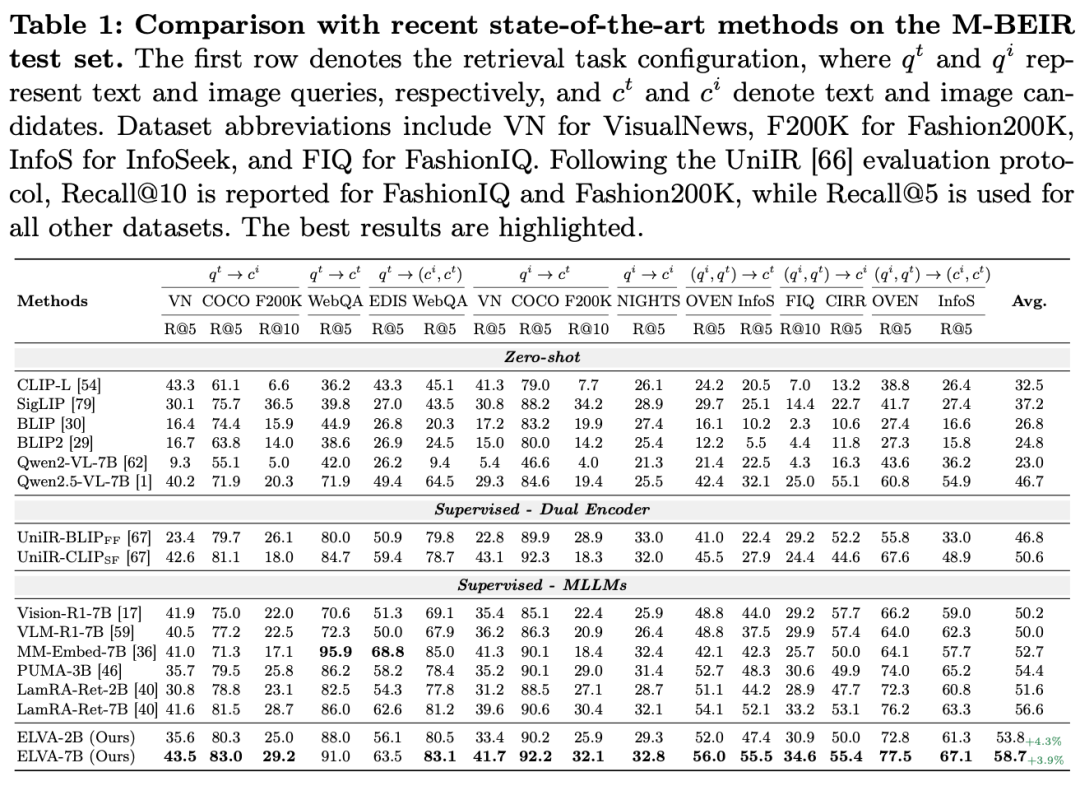
表注:原文 Table 1。该表覆盖 text-to-image、text-to-text、image-to-text、composed image retrieval 等 16 个子任务,显示 ELVA 在多数设置中达到新的 SOTA。
在未见数据集上,ELVA 也保持泛化。ShareGPT4V、Urban1K、Flickr、CIRCO、GeneCIS、Visual Dialog、MT-FIQ、CC-Neg、SugarCrepe 等任务中,ELVA-7B 多数指标领先;在 ITM 任务上相对其他方法有超过 9.7% 的提升。
为了专门测多粒度 query,作者又构建了 MRBench。它从 M-BEIR 派生而来,先用 Qwen2.5-VL-7B 自动筛选至少包含两个 grain-level attributes 的 query,再人工抽样验证,最终得到 1K queries,覆盖 3 个数据集和 4 个检索任务。
在 MRBench 上,Qwen2-VL-7B 平均 34.3,LamRA-Ret-7B 为 38.1,ELVA-7B 达到 43.2。论文总结为相对前 SOTA LamRA 提升 13.1%,这正对应它要解决的 grain blindness。
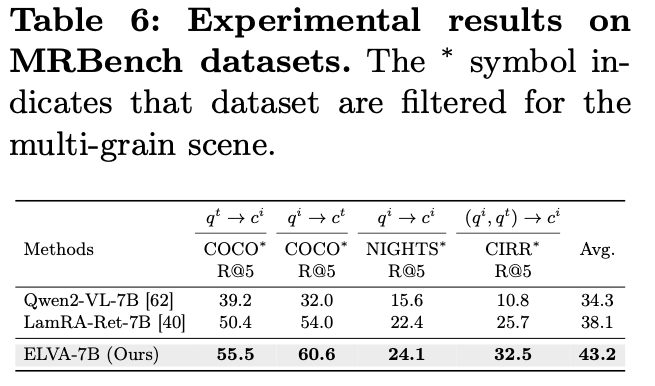
表注:原文 Table 6。该表展示 MRBench 的多粒度检索结果,ELVA 在 text-to-image、image-to-text、image-to-image 和 composed image retrieval 上整体领先。
消融同样支持奖励设计。去掉 Ranking Rewards,平均从 58.7 降到 57.2;去掉 Margin Rewards 降到 58.1;去掉 Negative Ranking 或采样策略也会下降。说明排序质量、正负间隔和负例难度都在共同起作用。
ELVA 的贡献不是把检索模型又做大一点,而是指出了对比学习的一个结构性盲点:复杂查询需要模型保留多个 grain,简单正负对比很容易把细节压没。通过可验证排序奖励,模型能在无显式 ranking labels 的情况下学习更细的候选层级。
局限也在任务边界里:ELVA 仍依赖候选池质量和规则奖励设计,视频检索虽然有 zero-shot 扩展结果,但没有使用视频数据进行专门微调。对于未来的统一多模态检索系统,ELVA 提供了一个值得借鉴的方向:不要只问“是不是正样本”,还要问“这个负样本为什么接近正样本”。
原文链接: https://www.leiphone.com/category/private/ntO5kxjRCcdemnNi.html
