


来源:华科大认知计算与智能信息处理
原文链接:https://mp\.weixin\.qq\.com/s/3OsxWHUocRd\_sWSunk\-\-iA

近日,计算机视觉领域的顶级国际会议ECCV 2026论文录用结果揭晓,华中科技大学认知计算与智能信息处理实验室24级研究生袁嘉晟同学论文“Wavelet-based Intra-video Counterfactual Reasoning for Video Question Grounding”被全文录用。European Conference on Computer Vision (ECCV)是计算机视觉领域的顶级国际会议,是中国计算机学会CCF推荐的B类国际学术会议。ECCV 2026计划于2026年9月8日至12日在瑞典马尔默召开。这次ECCV 2026 共有10,473篇投稿,最终2,883篇被主会录用,录用率27.52%。
论文介绍
**
**
01
论文标题:Wavelet-based Intra-video Counterfactual Reasoning for Video Question Grounding (ECCV 2026)
论文作者:JiaSheng Yuan(24级硕), Wei Wei*(导师)
论文概述:视频问题定位(Video Question Grounding, VideoQG)是多模态理解中的关键任务,要求模型不仅准确回答关于视频内容的问题,还需精确定位支撑答案的关键时间片段。然而,现有的视频多语言模型普遍面临“答案正确但依据不可靠”的幻觉陷阱。在**视频问题定位(VideoQG)**任务中,模型极易依赖视频中的表面视觉相似性或训练数据中的统计偏置进行推理。尤其在单个视频内部,大量帧或片段在外观上高度相似,但对问题答案的因果贡献却大相径庭。这种“视频内时序偏置”严重削弱了模型的定位准确性与推理可解释性,制约了其在高可靠性场景(如自动驾驶、医疗诊断、司法取证等)中的部署。
为应对这一挑战,CCIIP团队提出 WICI(Wavelet-based Intra-video Causal Intervention) ——一种从表征学习与决策机制双重维度提升视频问题定位可靠性的新范式。WICI 核心思想是:解耦视频中的静态语义与动态因果信号,并通过视频内部反事实干预显式建模因果贡献。具体而言,WICI 包含两个核心模块:
(1)在表征层面,设计了小波动态建模模块(Wavelet-based Dynamic Modeling, WDM):利用小波分解将视频特征解耦为低频外观语义信息和高频动态变化信息,有效增强模型对细粒度动作变化、状态转移及关键事件演化过程的感知能力;
(2)在决策层面,进一步提出视频内部反事实挖掘模块(Intra-video Counterfactual Mining, ICM),通过自动构造由易到难的反事实时间片段,并引入基于间隔约束的判别损失,从而引导模型区分真正支撑答案的因果证据与视觉相似但具有误导性的干扰片段,从而显著提升推理过程的可靠性和可解释性。
通过在两个权威视频问题定位基准——NeXT-GQA 与 STAR 上实验表明,WICI 在定位精度与问答准确率上均显著优于现有最先进方法,尤其在复杂动态场景和长视频理解任务中优势更为突出。更重要的是,可视化分析证实 WICI 能够聚焦于真正支撑答案的因果事件,而非被视觉冗余所误导。
本工作不仅为视频多模态推理提供了新的因果建模范式,也为构建可信、可解释的下一代视频智能系统奠定了技术基础,有效推动了视频理解向更高阶的认知推理迈进。
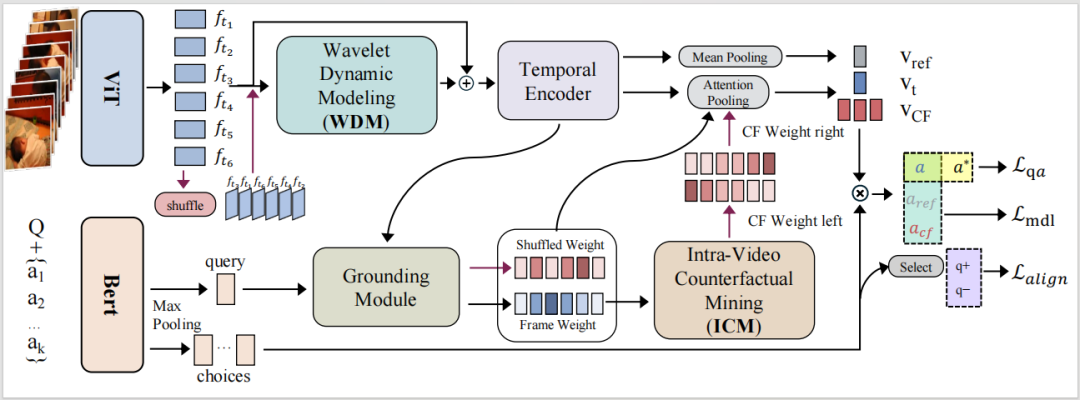
图1 WICI模型框架图
原文链接: https://www.leiphone.com/category/private/sntwEBFwLtFRSVJx.html
