


联合编译:Blake、高斐
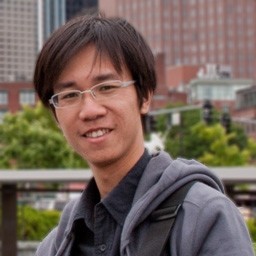
雷锋网注:何凯明博士,2007年清华大学毕业之后开始在微软亚洲研究院(MSRA)实习,2011年香港中文大学博士毕业后正式加入MSRA,目前在Facebook AI Research (FAIR)实验室担任研究科学家。曾以第一作者身份拿过两次CVPR最佳论文奖(2009和2016)——其中2016年CVPR最佳论文为图像识别中的深度残差学习(Deep Residual Learning for Image Recognition),本文为何凯明博士在ICML2016上的tutorial演讲以及相关PPT整理。相比学术论文,他在演讲PPT中深入浅出地描述了深度残差学习框架,大幅降低了训练更深层次神经网络的难度,也使准确率得到显著提升。
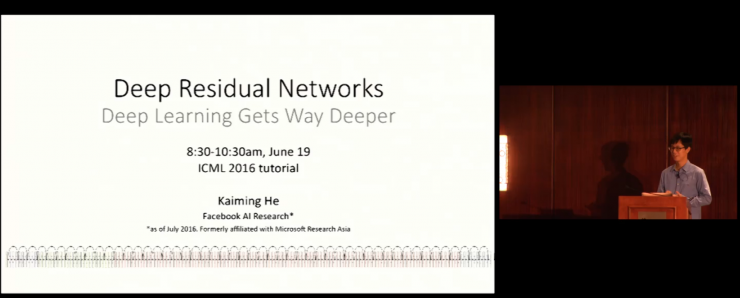
深度残差网络——让深度学习变得超级深
ICML 2016 tutorial
何凯明——Facebook AI Research(8月加入)
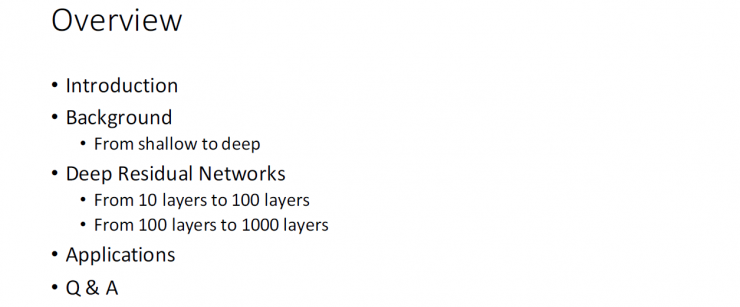
概览
介绍
背景
从浅到深
从浅到深
深度残差网络
从10层到100层
从100层到1000层
从10层到100层
从100层到1000层
应用
Q & A
| 介绍部分
介绍——深度残差网络(Resnet)
“用于图像识别的深度残差学习” CVPR2016
一个能够用来训练“非常深”的深度网络又十分简洁的框架
在以下几个领域中都能实现当下最好的表现
图像分类
对象检测
语义分割
等等
图像分类
对象检测
语义分割
等等
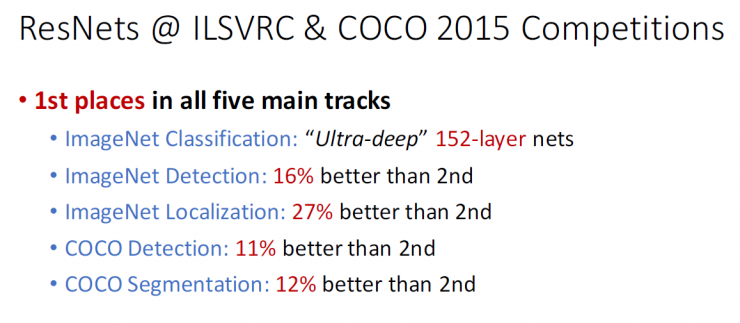
Resnet在ILSVRC 和COCO 2015上的表现
在五个主要任务轨迹中都获得了第一名的成绩
ImageNet分类任务:“超级深”的152层网络
ImageNet检测任务:超过第二名16%
ImageNet定位任务:超过第二名27%
COCO检测任务:超过第二名11%
COCO分割任务:超过第二名12%
ImageNet分类任务:“超级深”的152层网络
ImageNet检测任务:超过第二名16%
ImageNet定位任务:超过第二名27%
COCO检测任务:超过第二名11%
COCO分割任务:超过第二名12%
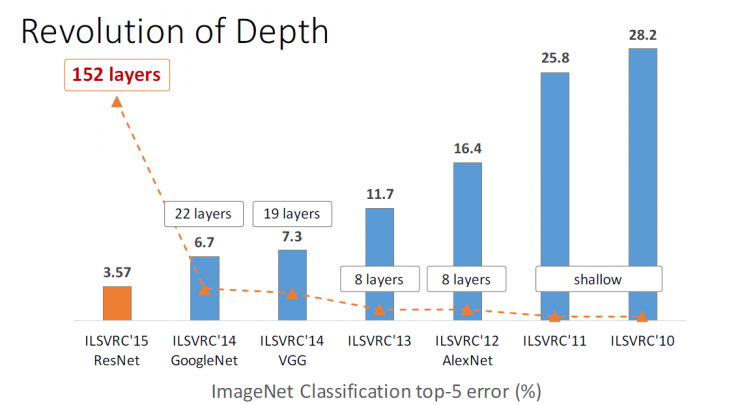
深度网络的革命(从浅层到越来越深的层级)
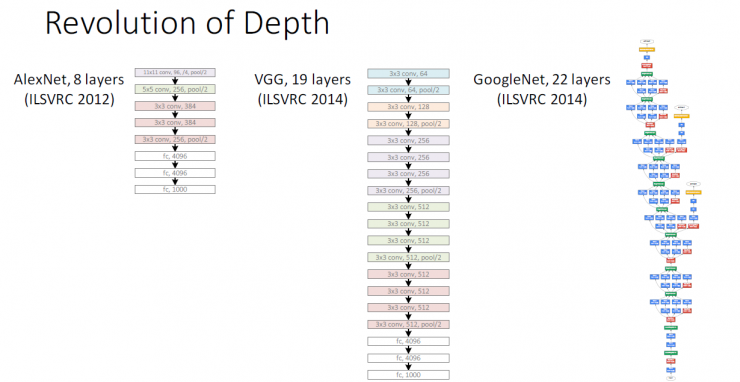
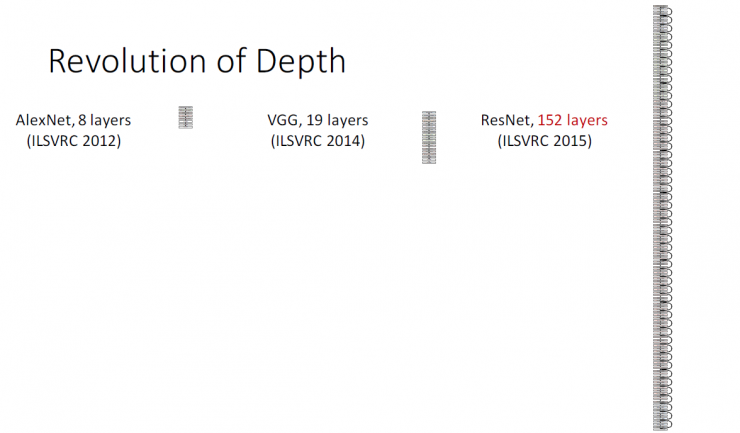
在ILSVRC2010年左右还主要是浅层网络,大部分需要手动调教特征。在ILSVRC2012年时,出现了8层的网络——AlexNet,降低了10%的错误率。而后ILSVRC2014出现的VGG和GoogleNet是相当成功的,它们分别将层级提到了19层、22层,错误率也降低到了7.3、6.7。到去年的ILSVRC2015,我们的ResNet将层级提到了152层,将错误率降到了3.57。
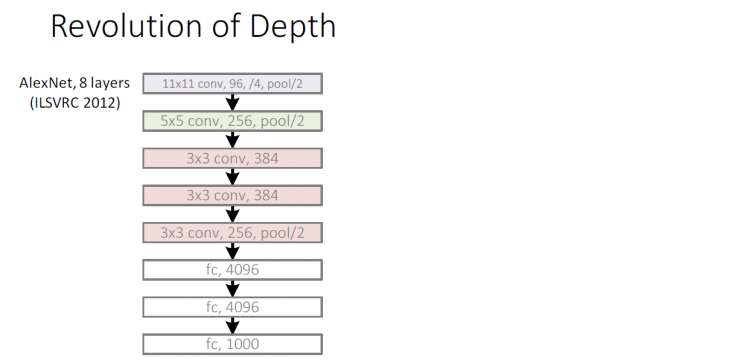
深度网络的革命
AlexNet, 8层 (ILSVRC 2012)
深度网络的革命
AlexNet, 8层 (ILSVRC 2012)
VGG, 19层 (ILSVRC 2014)
GoogleNet, 22层 (ILSVRC 2014)
AlexNet, 8层 (ILSVRC 2012)
VGG, 19层 (ILSVRC 2014)
GoogleNet, 22层 (ILSVRC 2014)
深度网络的革命
AlexNet, 8层 (ILSVRC 2012)
VGG, 19层 (ILSVRC 2014)
ResNet, 152 层 (ILSVRC 2015)
AlexNet, 8层 (ILSVRC 2012)
VGG, 19层 (ILSVRC 2014)
ResNet, 152 层 (ILSVRC 2015)
深度网络的革命
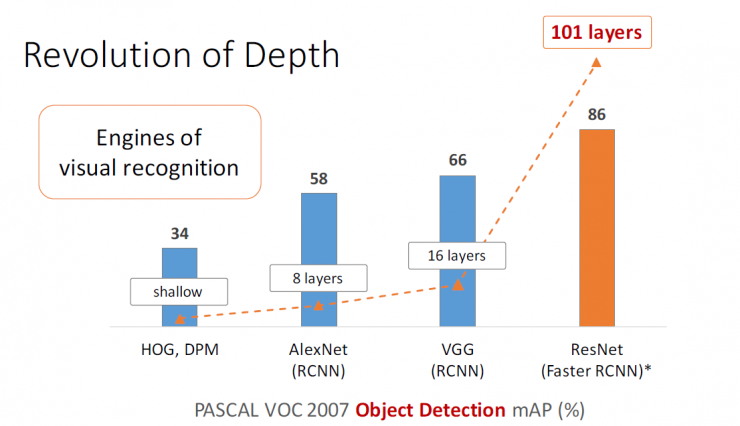
PASCAL VOC 2007——中间层数代表视觉识别的层数
HOG, DPM——浅层——34%的对象检测率
AlexNet (RCNN)——8层——58%的对象检测率
VGG (RCNN)——16层——66%的对象检测率
ResNet (Faster RCNN)——101层——86%的对象检测率
HOG, DPM——浅层——34%的对象检测率
AlexNet (RCNN)——8层——58%的对象检测率
VGG (RCNN)——16层——66%的对象检测率
ResNet (Faster RCNN)——101层——86%的对象检测率
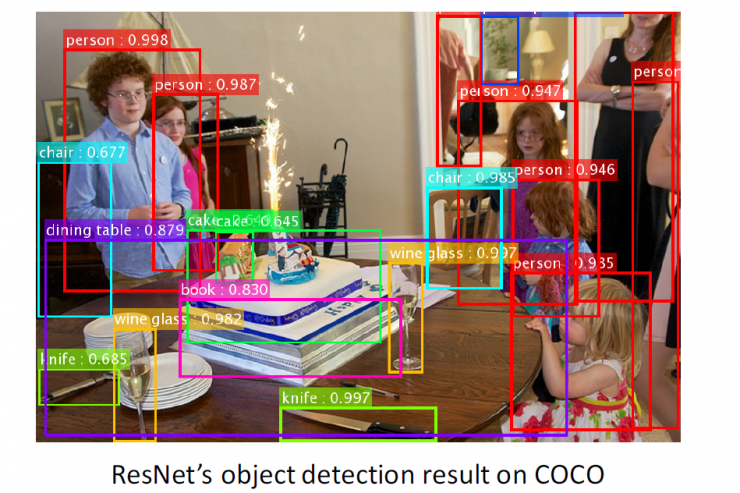
ResNet在COCO测试中的对象检测成绩
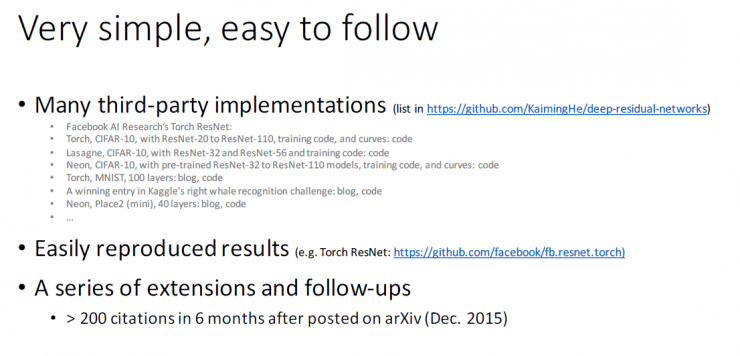
ResNet十分简单,且容易学习
许多第三方实现工具
Facebook AI Research’s Torch ResNet
Torch, CIFAR-10,使用 ResNet-20到 ResNet-110, 训练代码等
Lasagne, CIFAR-10, 使用 ResNet-32 和 ResNet-56 以及训练代码等
Neon, CIFAR-10, 使用预训练的 ResNet-32到 ResNet-110 模型、代码等
Torch, MNIST, 100层
Neon, Place2 (mini), 40层
Facebook AI Research’s Torch ResNet
Torch, CIFAR-10,使用 ResNet-20到 ResNet-110, 训练代码等
Lasagne, CIFAR-10, 使用 ResNet-32 和 ResNet-56 以及训练代码等
Neon, CIFAR-10, 使用预训练的 ResNet-32到 ResNet-110 模型、代码等
Torch, MNIST, 100层
Neon, Place2 (mini), 40层
容易重现结果
一系列的扩展和后续工作
6个月内超过200词引用(在2015年12月发布在arXiv上后)
6个月内超过200词引用(在2015年12月发布在arXiv上后)
深度残差网络——从第10层到100层
逐层深入
初始化算法
批归一化算法
学习更好的网络是否与堆叠层数一样简单?
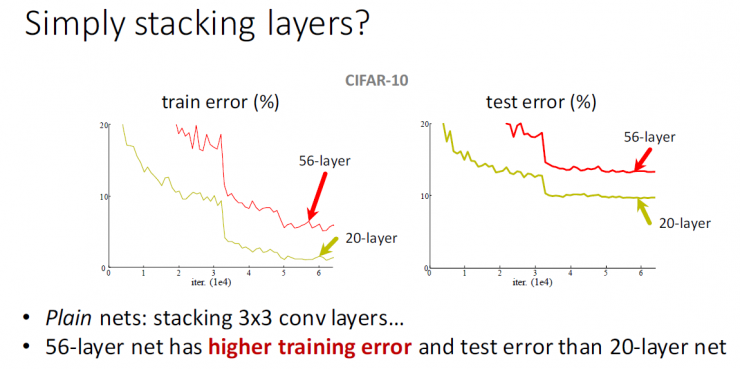
仅是简单的层数堆叠吗?
“平原”网络:堆叠3x3卷积网络……
与第20层网络相比,第56层网络存在更高的训练误差与测试误差。
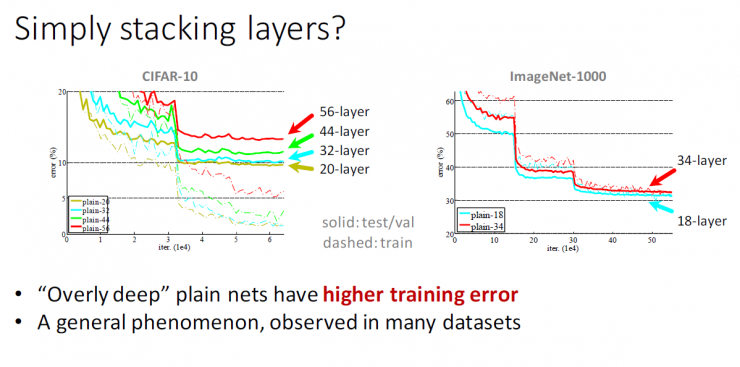
层数过深的平原网络具有更高的训练误差
这是一个在许多数据集中都能够观察到的普遍现象
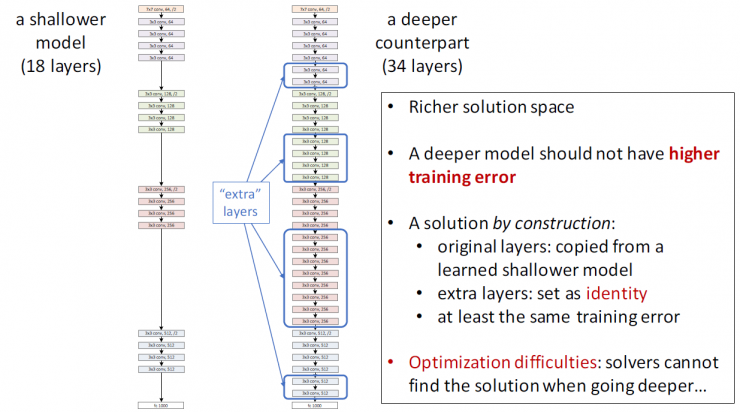
网络层数较浅的模型(18层)
网络层数较深的模型(34层)
较高分辨率空间
一个较深的网络模型不应当具有较高的训练误差
通过构建形成的分辨率:
原始层:由一个已经学会的较浅模型复制得来
附加层:设置为“恒等”
至少具有相同的训练误差
优化难题:随着网络层数不断加深,求解器不能找到解决途径
较高分辨率空间
一个较深的网络模型不应当具有较高的训练误差
通过构建形成的分辨率:
原始层:由一个已经学会的较浅模型复制得来
附加层:设置为“恒等”
至少具有相同的训练误差
优化难题:随着网络层数不断加深,求解器不能找到解决途径
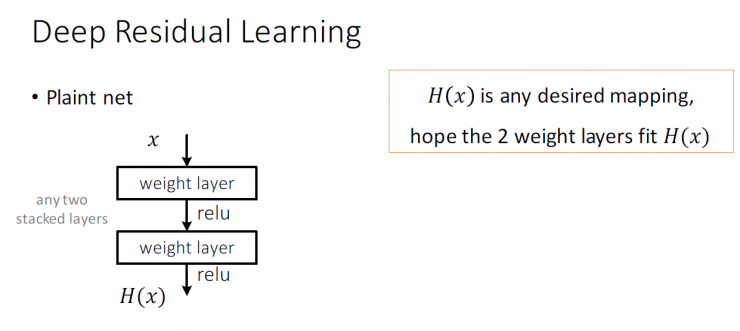
深度残差学习
平原网络
H(x)是任意一种理想的映射
希望第2类权重层能够与H(x)拟合
H(x)是任意一种理想的映射
希望第2类权重层能够与H(x)拟合
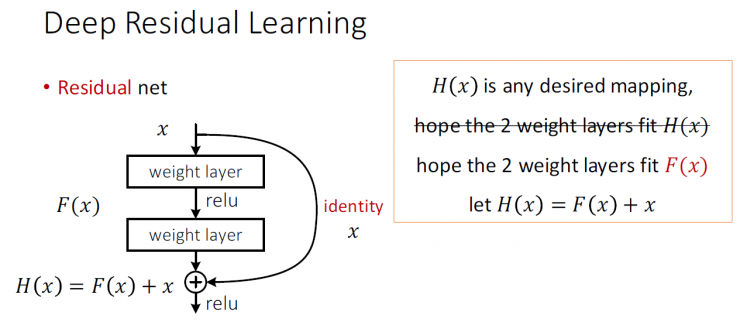
残差网络
H(x)是任意一种理想的映射
希望第2类权重层能够与F(x)拟合
使H(x) = F(x) + x
H(x)是任意一种理想的映射
希望第2类权重层能够与F(x)拟合
使H(x) = F(x) + x
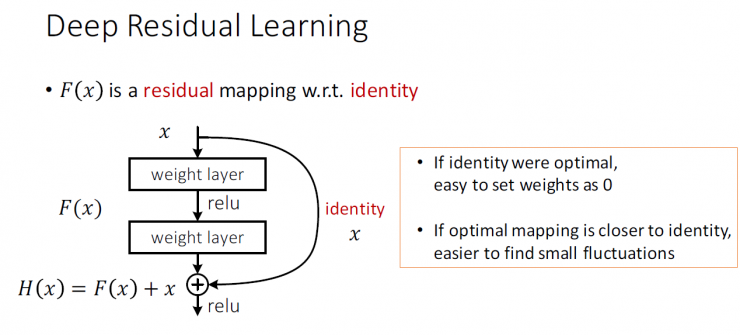
F(x)是一个残差映射w.r.t 恒等
如果说恒等是理想,很容易将权重值设定为0
如果理想化映射更接近于恒等映射,便更容易发现微小波动
如果说恒等是理想,很容易将权重值设定为0
如果理想化映射更接近于恒等映射,便更容易发现微小波动
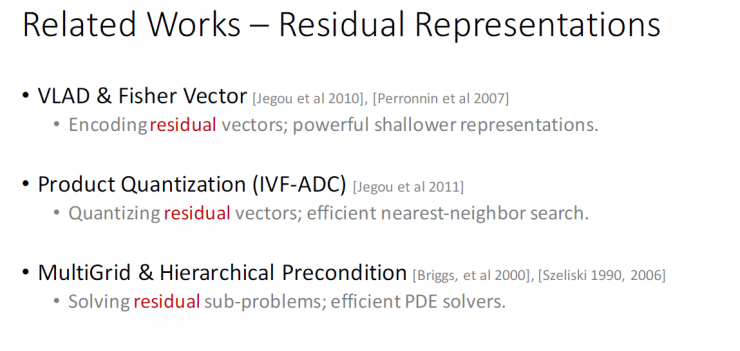
相关研究——残差表示法
VLAD & 费舍尔向量(Fisher Vector) [Jegou et al 2010], [Perronnin et al 2007]
编码残差向量;强大的较浅表示法。
编码残差向量;强大的较浅表示法。
产品量化(IVF-ADC) [Jegou et al 2011]
量化残差向量;高效最近邻搜索。
量化残差向量;高效最近邻搜索。
多栅 & 分层的先决前提 [Briggs, et al 2000], [Szeliski 1990, 2006]
解决残差次要问题;高效PDE求解器。
解决残差次要问题;高效PDE求解器。
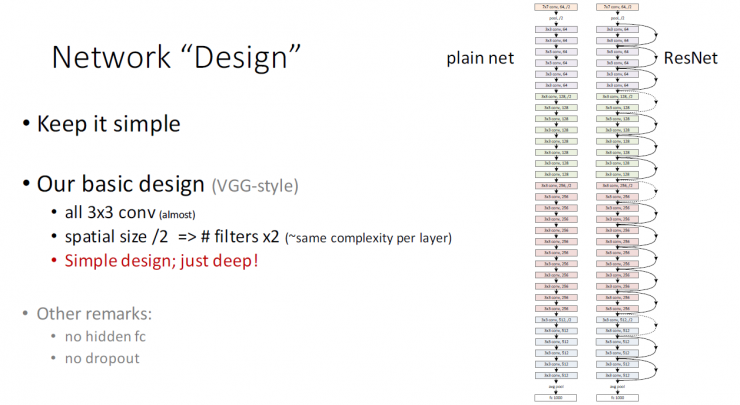
网络“设计”
保持网络的简约性
我们的基本设计方案(VGG-style)
所有的3x3卷积层(几乎所有)
空间规模/2=>#过滤器x2 (~每一层的复杂度相同)
简约的设计风格;保持设计风格的简约性
所有的3x3卷积层(几乎所有)
空间规模/2=>#过滤器x2 (~每一层的复杂度相同)
简约的设计风格;保持设计风格的简约性
其他评论:
无隐层fc
无信息流失
无隐层fc
无信息流失
训练
所有的平原/残差网络都是从头开始训练的。
所有的平原/残差网络都运用组归一化(Batch Normalization)
标准化的超参数&增强
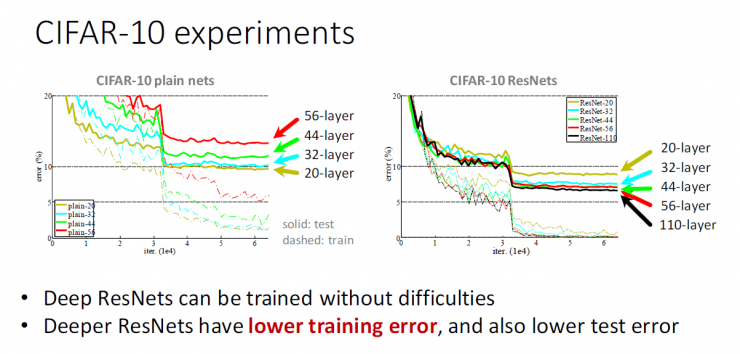
CIFAR-10 实验
深度残差网络(ResNets)能够在没有任何难题的情况下得到训练
深度残差网络(ResNets)具有较低的训练误差和测试误差
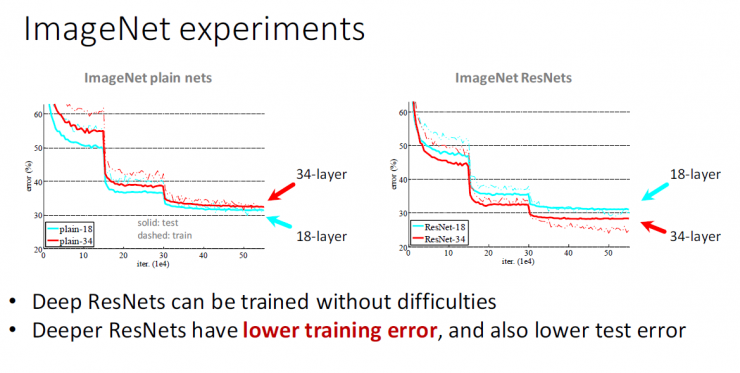
ImageNet (图像网络)实验
深度残差网络(ResNets)能够在没有任何难题的情况下得到训练。
深度残差网络(ResNets)具有较低的训练误差和测试误差。
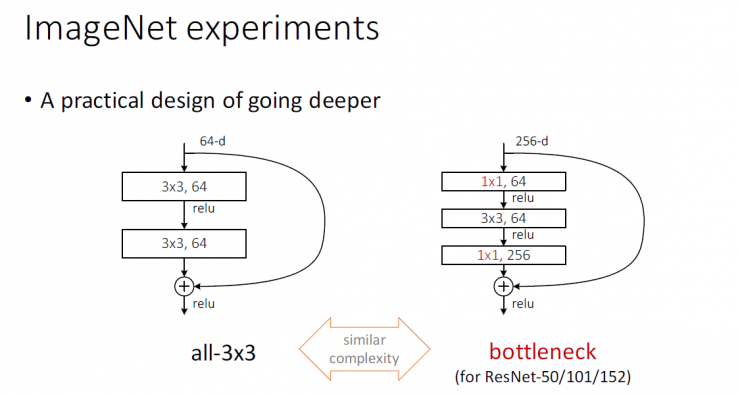
一个逐层深入的实际可行的设计方案
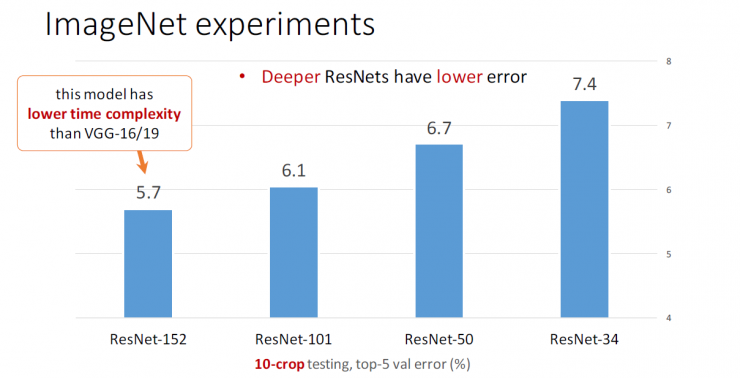
较深的ResNets具有较低的误差
与VGG-16/19相比,该模型具有较低的时间复杂度。
与VGG-16/19相比,该模型具有较低的时间复杂度。
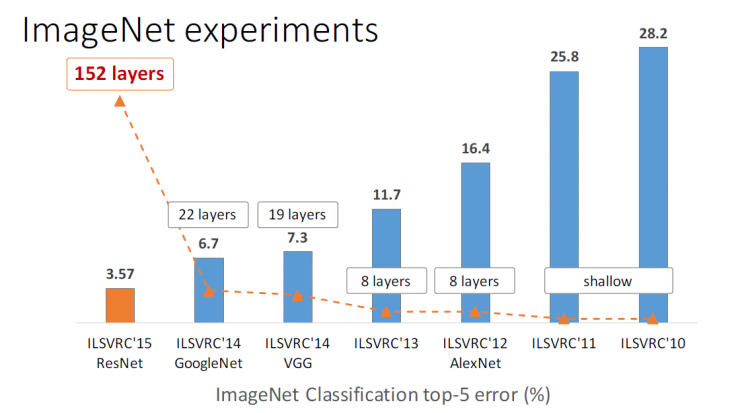
图像网络分类误差排行前5的网络模型
讨论
表征,优化,归纳
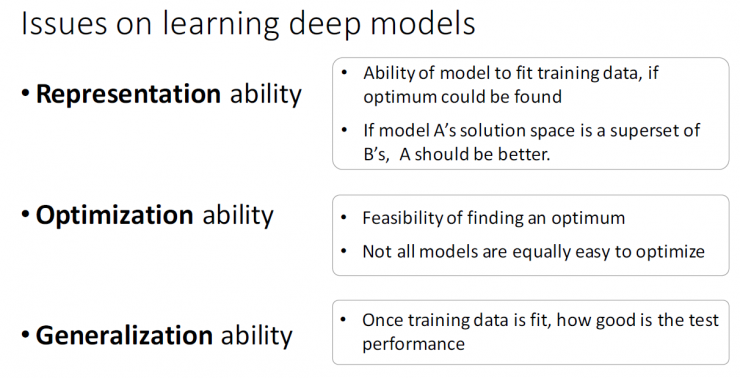
学习深度模型存在的一些问题
表征能力
如果能够找到最佳表征方法,将具备构建模型的能力,以拟合训练数据。
如果模型A的分辨率空间是B的父集,模型A的分辨率更高。
如果能够找到最佳表征方法,将具备构建模型的能力,以拟合训练数据。
如果模型A的分辨率空间是B的父集,模型A的分辨率更高。
优化能力
找到最佳表征方法的可行性
并不是所有的模型都能非常容易地得到优化
找到最佳表征方法的可行性
并不是所有的模型都能非常容易地得到优化
归纳能力
倘若训练数据是拟合的,测试的性能如何?
倘若训练数据是拟合的,测试的性能如何?
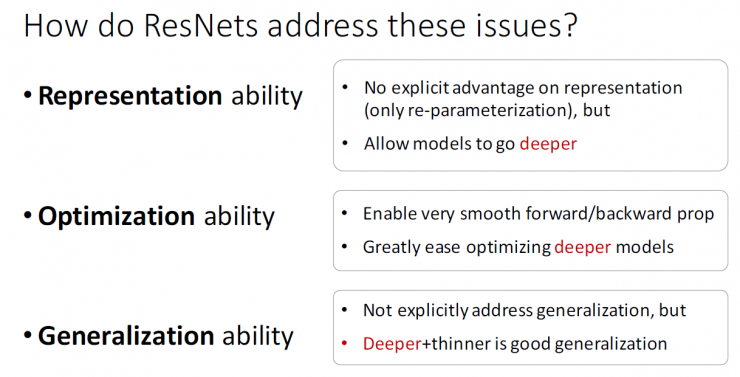
残差网络(ResNets)将如何解决这些问题?
表征能力
残差网络在模型表征方面不存在直接的优势(只是实现重复参数化)
但是,残差网络允许逐层深入地表征所有的模型
残差网络在模型表征方面不存在直接的优势(只是实现重复参数化)
但是,残差网络允许逐层深入地表征所有的模型
优化能力
残差网络使得前馈式/反向传播算法非常顺利进行
在极大程度上,残差网络使得优化较深层模型更为简单
残差网络使得前馈式/反向传播算法非常顺利进行
在极大程度上,残差网络使得优化较深层模型更为简单
归纳能力
残差网络未直接处理学习深度模型过程中存在的归纳问题
但是,更深+更薄是一种好的归纳手段
残差网络未直接处理学习深度模型过程中存在的归纳问题
但是,更深+更薄是一种好的归纳手段
另外,对于残差网络的详细介绍可见何凯明博士在2016年CVPR中的最佳论文——图像识别的图像识别中的深度残差学习(Deep Residual Learning for Image Recognition):
在论文中介绍了一个深层次的残差学习框架来解决精准度下降问题。我们明确地让这些层适合残差映射,而不是寄希望于每一个堆叠层直接适合一个所需的底层映射。形式上,把H(x)作为所需的基本映射,让堆叠的非线性层适合另一个映射F(x):=H(x)-x。那么原映射便转化成:F(x)+x。我们假设优化剩余的映射,比优化原来未引用的映射更容易。如果身份映射是最佳的,那么将剩余的映射推为零,就比用一堆非线性层来适应身份映射更容易。
公式F(x)+x可以通过“快捷连接”前馈神经网络实现。快捷连接是那些跳过中的一层或更多层。在我们的情景中,快捷连接简单的执行身份映射,并将它们的输出添加到叠加层的输出。身份快捷连接添加既不产生额外的参数,也会增加不计算的复杂度。通过反向传播的SGD,整个网络仍然可以被训练成终端到端的形式,并且可以在没有修改器的情况下很容易的使用公共资料库(例如Caffe)。
我们在ImageNet上进行了综合性实验展示精准度下降问题,并对我们的方法做出评估。我们发现:
(1)特别深的残差网络很容易优化,但当深度增加时对应的“平面”网(即简单的堆栈层)表现出更高的训练误差。
(2)深度残差网络能够在大大增加深度的同时获得高精准度, 产生的结果本质上优于以前的网络。
(1)特别深的残差网络很容易优化,但当深度增加时对应的“平面”网(即简单的堆栈层)表现出更高的训练误差。
(2)深度残差网络能够在大大增加深度的同时获得高精准度, 产生的结果本质上优于以前的网络。
相似的现象同样出现在了CIFAR-10集中,这表明了优化的难度,以及我们方法影响的不仅仅是类似于一个特定的数据集。我们在这个超过100层数据集中提出了成功的训练模型,并探讨了超过1000层的模型。
在ImageNet分层数据集中,通过极深的残差网络,我们得到了非常好的结果。152层的残差网络在ImageNet中是最深层的网络,同时相比于VGG网络仍然具有较低的复杂性。我们的集成在ImageNet测试集中有3.57%排前5的误差,并且在2015ILSVRC分类竞争中取得第一名。这种极深的陈述在其它识别任务方面也有出色的泛化性能,并带领我们进一步赢得了第一的位置:在ILSVRC和COCO2015竞赛中的,mageNet检测,ImageNet定位,COCO检测,和COCO分割方面。这有力的证据表明,剩余的学习的原则是通用的,我们期望它适用于其它的视觉和非视觉问题。
PS : 本文由雷锋网独家编译,未经许可拒绝转载!
via Kaiming He
雷峰网原创文章,未经授权禁止转载。详情见转载须知。
[
](https://vip.yanxishe.com/?from=leiphonearticle)
原文链接: https://www.leiphone.com/category/ai/vhqwt5eWmUsLBcnv.html
