


来源:老博侃AI
原文链接:https://mp\.weixin\.qq\.com/s/i4d15fR2A3OlGDTHz\-p3Lw
给你一张普通照片,人一眼就能看出哪个东西近、哪个东西远。但对机器来说,一张平的 2D 图片里其实没有「距离」这个信息,得靠算法猜。这件事叫「单目深度估计」——就一只眼睛(一个摄像头),估出整张图每个像素离你多远。它有啥用?扫地机器人躲障碍、手机拍照虚化背景、汽车看路、AR 把虚拟物体摆到真实桌面上,背后都得先知道深度。
这两年这活儿被一批「大模型」给彻底刷新了。像 Depth Anything、Marigold,你随便丢一张它从没见过的图进去——雪山、厨房、水下都行——它都能吐出一张相当漂亮的深度图。这种「不挑场景、拿来就用」的本事,行话叫「零样本」。
听着很爽,但有个大问题:这些模型太胖了。Depth Anything 的大号版本三亿多参数,Marigold 快九亿,跑一次得在 RTX 3090 那种专业显卡上烧掉五十多焦耳的电。你想把它塞进一部手机、一个行车记录仪、一台巴掌大的嵌入式盒子里实时跑?门都没有,卡直接卡死给你看。
那就用小模型呗?行业里确实有一批轻量选手,参数小到一两百万,手机上跑得飞快。可它们几乎都是在单个数据集上练出来的,换个场景立马抓瞎,压根谈不上「零样本」。
于是就卡在一个特别拧巴的地方:要么准得没法用(太胖),要么能用但一换场景就废(太蠢)。
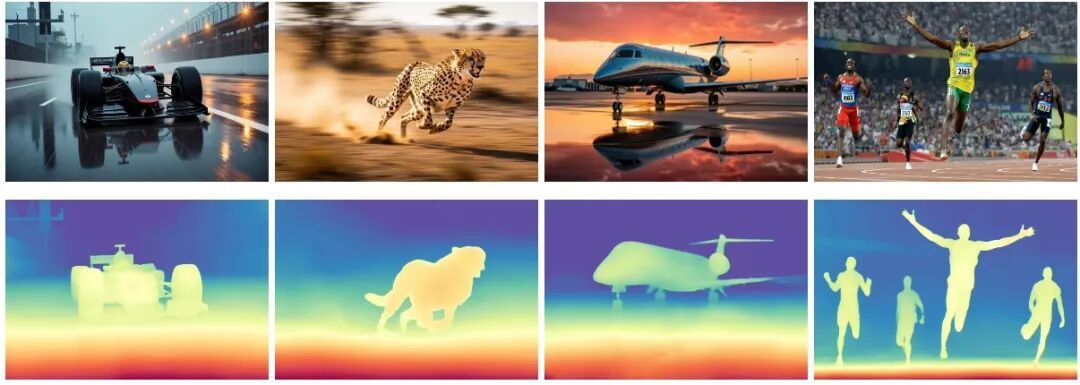
图1:ZipDepth 在赛车、奔跑的猎豹、停机坪的飞机、田径场这些差异极大、又完全没在训练里见过的场景上的表现。上排是原图,下排是它估出来的深度,层次照样分明。
来自博洛尼亚大学的一个团队(这篇论文已经被 ECCV 2026 收了,代码也开源了)就是冲着这个拧巴点去的:能不能造一个小到能塞进手机、又保留了大模型「换啥场景都能用」本事的网络?他们的答案就是 ZipDepth——推理时只有 610 万参数的一个纯卷积小网络。
核心一招:让大模型当老师,把本事「灌」给小学生
你可能会问:既要小又要泛化,那直接拿海量数据从头练个小网络不就完了?作者试过,不行。大模型之所以强,一部分是它在天量数据里悟出了一套「世界大概长啥样」的直觉,这套东西小网络靠自己在有限数据上悟不出来。
所以 ZipDepth 走的是「蒸馏」这条路,说白了就是请家教:
拿一个三亿多参数的大模型(Depth Anything v2 的大号版)当老师,让它对一千四百多万张、横跨十几个领域的图,每张都先估一遍深度,当成「标准答案」。然后让那个小网络照着老师的答案去学。这么一来,小学生不需要人工标注,也不局限在某个场景——老师见过多大的世界,学生就能继承多大的世界。这就是它能同时做到「轻」和「泛化」的根子。
那个「小学生」到底有多能扛,看这张图最直观:
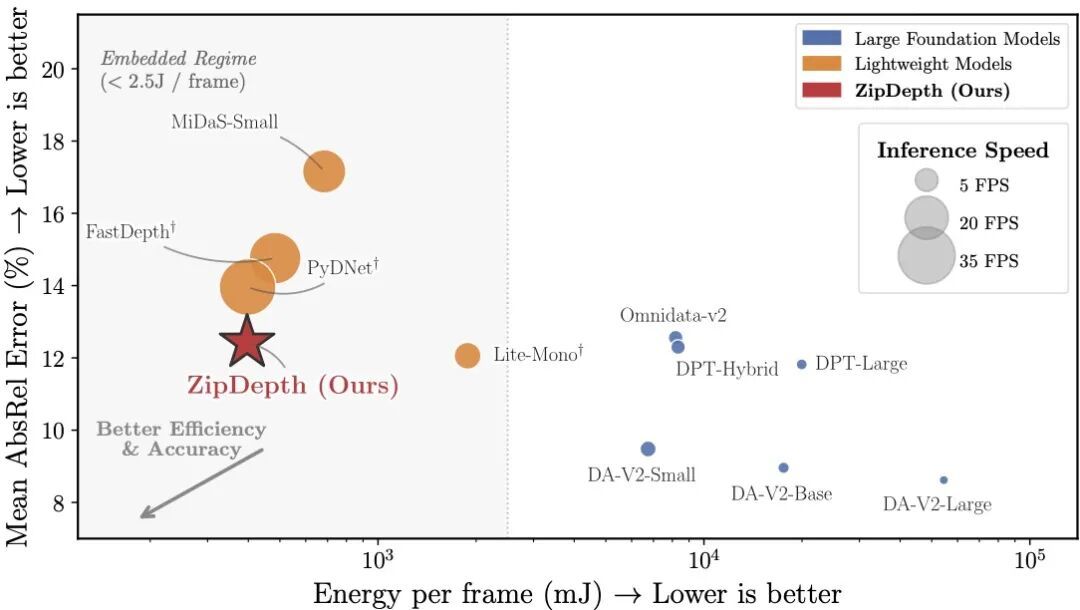
图2:越靠左越省电,越靠下越准,点越大跑得越快。左上灰色区是「嵌入式能用」的地盘。蓝点是那些又准又胖的大模型,全挤在右边费电区进不来;橙点是省电的轻量小模型,但普遍偏上(不够准)。只有红星 ZipDepth,又待在省电区、又把误差压到了小模型里最低。
网络怎么搭:每一块都在问「手机认不认这个算子」
ZipDepth 的架构没啥惊天秘密,真正贯穿始终的是一条铁律:只用手机、嵌入式芯片这些部署框架原生认识、还能在推理时「合并掉」的零件,坚决不用那些需要特殊照顾的花活。这就是它能从服务器一路跑到手机的原因。举两个我觉得最有意思的设计:
一个是「训练和推理长两副面孔」。训练的时候,网络的每个基本块是多条路并联的——就像修路时同时开好几条车道,车(梯度)跑得顺,学得也好。但到了真正上线推理时,作者用数学把这几条路等价合并成了一条,多余的车道直接消失,只剩一条最精简的卷积。训练时占「学得好」的便宜,推理时占「跑得快」的便宜,两头好处全拿了。
另一个是最后那步「放大」——怎么把一张缩小的深度图恢复到原尺寸。最省事的做法是直接拉伸插值,但那样物体边缘会糊成一团。作者借了个光流领域的巧招,让网络自己学着怎么放大,放大时能感知到物体边界,恢复出来的图边缘干净利落。效果差别看这张就懂:
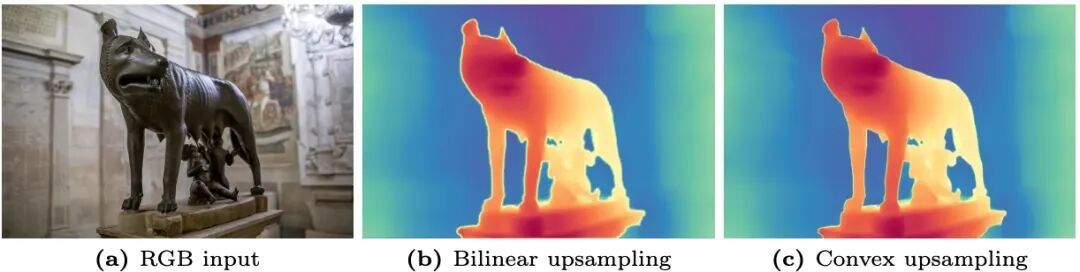
图3:同一尊青铜狼雕像。中间(b)是普通拉伸放大,边缘发虚还渗色;右边(c)是 ZipDepth 学出来的放大方式,轮廓干净,物体和背景的深度断层保持得很清楚。
而这里作者又露了一手「被现实坑过」的功力:这套聪明放大在电脑显卡上跑得很爽,可它用的某些零件在很多手机芯片上支持得并不好。于是 ZipDepth 干脆备了两条放大路线,按硬件自动切换——显卡上走精细那条,手机上自动换成一条只用手机铁定支持的算子拼出来的路线,边缘照样够锐。同一套模型权重,插到电脑走一条、插到手机走另一条,这才是它敢号称「on any device(啥设备都能跑)」的关键工程细节。
全部合并优化之后,整个模型上线时就 613 万参数,非常克制。
效果:轻量组里精度第一,能耗只是零头
作者在五个它没练过的基准场景上做了评测,还特意保证公平——所有轻量对手都用跟 ZipDepth 一模一样的数据从头重训,排除了「你数据好所以你赢」这种嫌疑。
结果一句话概括:在轻量这一档里,ZipDepth 基本每个场景都排第一或第二。个别场景被另一个小模型反超了,但那家伙要多花四倍多的算力、还慢四倍多,这买卖不划算,作者也如实说了。
跟自己老师(那个三亿参数的大模型)比呢?当然追不上,蒸馏本来就有损耗。但代价换来的是:参数少了 55 倍、算力少了 200 多倍。落到能耗上更夸张——在一台 15 瓦的嵌入式盒子上,ZipDepth 能跑到每秒 34 帧(实时了),每帧耗电只有老师的一百三十几分之一。对那些「电就这么点、多一焦耳都不行」的场景,大模型直接出局,而 ZipDepth 还能实时跑。
最能唬人的是设备清单:同一个 610 万的模型,作者从 350 瓦的服务器显卡一路测到 5 瓦的红米手机。一台 6 瓦的 iPhone 12,走苹果的神经引擎那条优化路线能跑到每秒 375 帧;连一颗 5 瓦红米 Poco 的手机 GPU 都有每秒 16 帧。背后靠的正是前面那两条自动切换的放大路线。
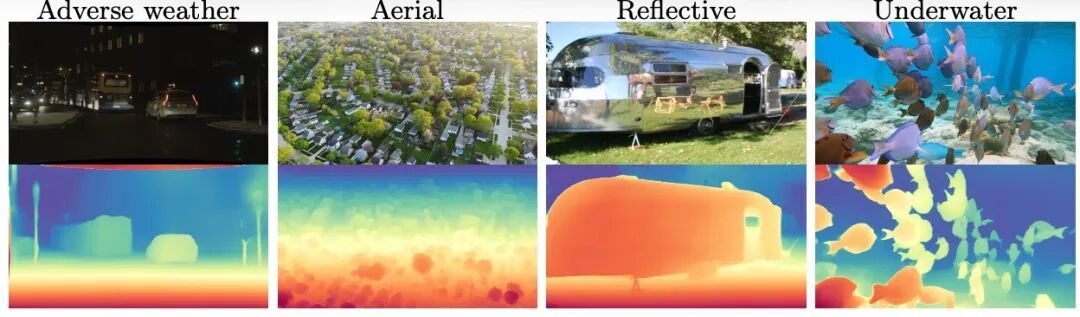
图4:完全没见过的野外场景——夜里恶劣天气的街道、高空航拍的居民区、镜面反光的房车、水里游的鱼群。这些远超它的训练范围,ZipDepth 照样给出了合理的深度结构,说明蒸馏是真把老师那套泛化本事搬进来了。
我的一点看法
我挺喜欢这篇工作的务实劲儿。它没去追「刷爆某个榜」,而是老老实实盯着一个真实痛点:深度大模型很强,但落不了地。它用的招也都不新——请家教(蒸馏)是老手段、多路合并是现成思路、聪明放大是从光流那儿借的,单看每一块都算不上原创。可作者拿「手机芯片认不认这个零件」当筛子,把这些旧零件重新筛了一遍、拼了一遍,硬是拼出一个能从服务器跑到手机的完整方案。那条按硬件自动切换的双放大路线,尤其是那种「真把模型部署到一堆破设备上、被坑麻了」才做得出来的设计。
局限作者也讲得很坦白:精度追不上大几十倍参数的大模型,这是蒸馏的天花板;而且它是单帧模型,用在视频上会有帧间闪烁。下一步他们也指清了——更好的蒸馏缩小差距、加个轻量时序模块治闪烁。对想在端侧真正用上深度估计的人来说,这版已经很能打,代码还开源了,是个很值得上手试的起点。
原文链接: https://www.leiphone.com/category/private/CFAVcVznAx50fm1n.html
