


来源:公众号“时序大模型”
原文链接:https://mp.weixin.qq.com/s/xUjYEZhimavKwed1hNWh7g
本篇论文来自ICML2026,最新前沿时序技术,针对时序异常检测,提出了IMPACT框架,首次将影响函数理论系统性融入开放集时间序列异常检测流程。
文章信息
论文名称:IMPACT: Influence Modeling for Open-Set Time Series Anomaly Detection
论文作者:Xiaohui Zhou, Yijie Wang, Hongzuo Xu, Weixuan Liang, Xiaoli Li, Guansong Pang
研究背景
时间序列异常检测(TSAD)旨在识别时序数据中偏离正常模式的异常样本,广泛应用于金融反欺诈、医疗心电 / 脑电监测、工业设备运维等核心场景。
传统无监督范式:假设训练数据全为正常样本,通过重构误差、分布拟合等方式检测异常,但无法利用场景中已有的少量标注异常先验,普遍误报率高。
开放集异常检测(OSAD)新范式:利用少量已标注的已知异常类训练模型,目标是同时检测训练中见过的异常,以及训练中完全未出现的未知异常类,更贴合真实工业场景。
而现有OSAD方法直接迁移到时间序列场景时存在两个致命瓶颈:
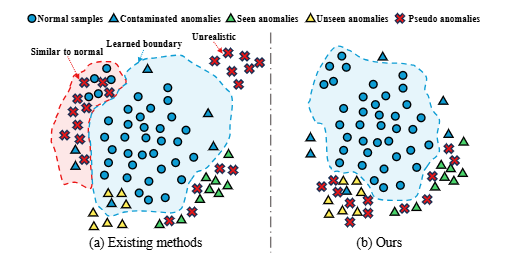
训练数据异常污染问题:现有方法默认未标注训练样本全为正常,但真实场景中未标注数据不可避免混有未知异常(污染率通常 2%~10%),这些污染样本会误导模型学习到有偏的决策边界,大幅降低检测精度。
伪异常生成质量低下:现有方法通过数据增强生成伪异常来模拟未知异常,但主流增强操作多面向图像设计(旋转、裁剪等),直接迁移到时间序列会破坏时序语义,生成的伪异常要么与正常模式难以区分,要么完全脱离真实异常分布,无法有效提升模型对未知异常的泛化能力。
为解决上述难题,文章提出了IMPACT框架。
问题正式定义
设时间序列训练集为 ,其中:
:带异常污染的正常样本集,共 个样本,标签默认 ;其中混入了少量未标注的真实异常(即污染样本)。
:少量标注的已知异常样本集,共 个样本,标签 ,满足 。
每个样本 ,表示 个变量、长度为 的时间序列窗口。
开放集场景定义:
全部异常类集合为 ,训练集中的标注异常仅来自已知异常子集;
剩余未知异常子集 在训练中无任何标注样本;
模型目标:学习异常评分函数 ,使所有异常(已知类 + 未知类)的评分显著高于正常样本。
模型框架
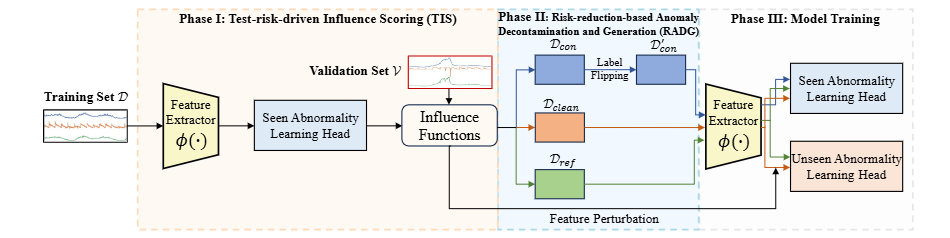
IMPACT框架由三个核心阶段串行组成,形成闭环优化:
测试风险驱动的影响评分(TIS):训练初始模型,基于影响函数量化每个训练样本对模型测试风险的影响,划分出污染样本、干净样本、正常参考样本。
风险降低的异常去污染与生成(RADG):对污染样本执行标签翻转实现去污染,对边界正常样本执行影响引导的特征扰动生成高质量伪未知异常。
双头模型训练与推理:用增强后的数据训练「可见异常学习头」和「不可见异常学习头」,融合多维度分数输出最终异常判定结果。
测试风险驱动的影响评分模块(TIS)
多通道偏差损失与初始模型训练
初始模型由特征提取器 和检测头 组成,总参数 ,输出 维的多通道异常分数 。
首先定义多通道偏差分数,衡量样本异常分数与高斯先验分布的偏离程度:
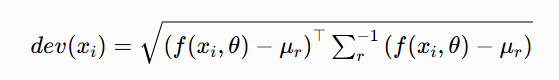
其中 和 是各向同性高斯先验分布的均值与协方差矩阵(默认 )。
基于偏差分数设计多通道偏差损失,用于初始模型训练:
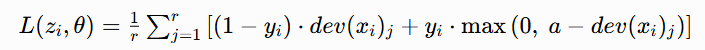
对于正常样本():最小化偏差分数,推动正常样本的特征向高斯先验均值聚拢。
对于异常样本():通过 hinge 损失强制偏差分数至少大于边际 ,推动异常样本远离正常分布。
多通道的核心意义:从多个视角评估样本异常性,正常样本在所有视角下都贴近先验,异常样本至少在一个视角下显著偏离。
定理 1:偏差损失与熵最小化的等价性
文章从理论上证明了多通道偏差损失的优化目标与隐分布熵最小化等价,为方法提供了统计学习层面的理论支撑。
定理 1:若多通道异常分数 服从隐高斯分布 ,则最小化样本与高斯先验的几何偏差,等价于最小化隐分布的熵。
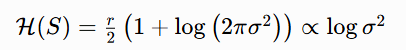
证明核心思路:
根据 KL 散度的非负性,,因此 ,当且仅当 为高斯分布时取等。
最小化偏差损失本质是推动样本分布向各向同性高斯先验靠拢,对应隐分布的方差 减小,熵 降低。
该性质鼓励模型学习到紧凑的正常样本表示,同时最大化异常样本的偏离程度。
影响函数建模与样本影响量化
基于经典影响函数理论,量化每个训练样本对模型测试风险的影响,核心是计算「扰动单个训练样本的权重」对「模型参数与测试损失」的影响。
首先,初始模型最优参数为经验风险最小化结果。
给单个训练样本 的损失添加权重扰动 ,得到扰动后的最优参数。
定义参数影响函数(样本权重扰动对模型参数的影响程度):
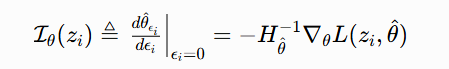
其中 是模型在最优参数处的海森矩阵。
进一步通过链式法则,推导单个训练样本 对单个测试样本 损失的影响。
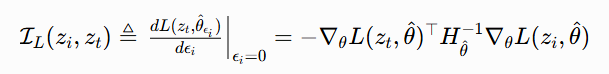
最终,样本 对整个验证集 测试风险的总影响为。
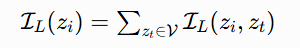
基于影响分数的样本划分
根据影响分数的正负与大小,将训练集划分为三类:
污染样本集:。影响为正表示「移除该样本会降低测试风险」,说明该样本对模型有害,是混入正常集的异常样本。
正常参考样本集:从影响为负的正常样本中选取 top-k 影响最小的样本。这类样本对模型收益最大,最能代表正常模式的核心分布。
干净样本集:,即剩余的正常样本与标注异常样本。
风险降低的异常去污染与生成模块(RADG)
异常去污染:影响引导的标签翻转
对识别出的污染样本 执行标签翻转,将其标签从正常(0)翻转为异常(1),得到新增的监督异常集 。该操作不仅消除了污染的负面影响,还将噪声转化为有效的异常监督信号。
标签翻转的形式化定义:将样本 扰动为 ,其中 表示标签从 0 翻转为 1。将 权重从原样本转移到翻转后的样本,得到扰动后的最优参数。
定理 2:标签翻转可严格降低测试风险
定理 2:对污染样本集 中的所有样本执行标签翻转,可严格降低模型在验证集上的测试风险。
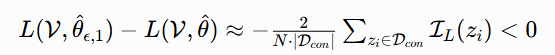
证明核心思路:
简化为单通道、各向同性高斯的场景,损失退化为 。
对于标签从 0 翻转为 1 的污染样本,梯度满足:。
代入影响函数表达式,得到标签翻转对测试损失的影响为 。
由于污染样本的 ,因此总风险变化量为负,即测试风险严格降低。
未知异常生成:影响引导的特征扰动
传统数据增强在时序场景质量低下,论文提出在特征空间执行扰动,通过影响函数精准找到「最大化测试风险」的扰动方向,生成语义合理、分布贴近真实未知异常的伪样本。
样本选择:从干净正常样本中选取对风险降低贡献最小的 top-k 样本(即影响分数最接近 0 的边界样本),构成待扰动集 。这类样本位于正常分布的边缘,微小扰动即可使其脱离正常模式,生成的伪异常更具挑战性。
扰动方向推导: 设样本 的特征为 ,给特征添加扰动 得到 。
定义特征扰动对测试风险的影响系数。
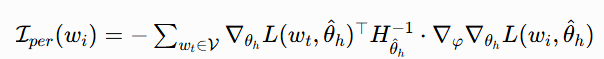
为了让扰动后的样本最大程度偏离正常模式、最大化测试风险提升,扰动方向取影响系数的梯度方向。
其中 为扰动强度超参数。最终将扰动后的特征标记为异常,构成伪未知异常集 。
定理 3:扰动特征与正常分布的差异下界
定理 3:经影响引导扰动后的特征分布,与原始正常特征分布存在可证明的分布差异,且差异有严格下界。形式化地,分布的 KL 散度满足:
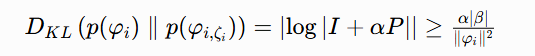
其中 是秩 1 矩阵,满足 , 为与影响值相关的负常数。
证明核心思路:
通过变量替换定理,扰动后分布的概率密度与原密度满足 。
代入 KL 散度定义,化简得到 KL 散度等于雅可比行列式对数的绝对值。
利用 的秩 1 性质和影响为负的条件,结合不等式 ,推导出分布差异的下界。
定理 4:伪异常可进一步降低测试风险
定理 4:将影响引导生成的伪未知异常加入训练,可进一步降低模型的测试风险。
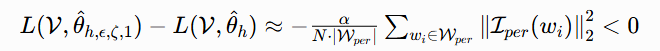
证明核心思路:结合特征扰动的影响与标签翻转的影响,将扰动后的样本标记为异常加入训练。由于平方范数恒正,因此总风险变化量为负,即测试风险严格降低。该定理从理论上保证了生成的伪异常能够有效提升模型的泛化能力。
双头训练架构与推理策略
联合损失函数
采用双头架构分别学习已知异常与未知异常的模式:
可见异常学习头:用所有标注异常(原始标注 + 翻转的污染样本)和正常样本训练,学习已知异常的判别模式。 训练集 ,损失为:
不可见异常学习头:用高置信度正常样本和生成的伪未知异常训练,泛化对未知异常的检测能力。 正常子集 为最具代表性的正常样本,损失为:
总训练损失通过超参数 平衡两部分:
多源融合的异常评分推理
推理阶段融合两类异常分数,兼顾判别精度与细粒度检测能力:
多通道最大异常分数:融合两个检测头的输出,取所有通道中的最大值,确保任意视角检测到异常都能被捕获。
特征偏差分数:计算测试样本特征与正常参考集特征均值的欧氏距离平方,补充捕捉细微的模式偏离。
最终异常分数:分数越高,样本为异常的概率越大。
实验设计
实验覆盖 8 个主流时序异常检测数据集,包含单异常类与多异常类场景:
所有训练集统一注入 2% 的异常污染,验证方法的鲁棒性;所有实验重复 5 次,取平均 AUC 作为结果。
对比基线与评价指标
无监督基线:TCN-AE、THOC、TranAD、DCdetector、GPT4TS、COUTA、DADA
开放集 / 弱监督基线:DevNet、DSAD、NCAD、DRA、MOSAD、InvAD、WSAD-DT
核心评价指标:ROC 曲线下面积(AUC,区间级);点级检测补充 Affiliation-F1、VUS-ROC
实验环境与配置
特征提取器采用时序卷积网络(TCN),隐藏层维度 64,特征空间维度 64。
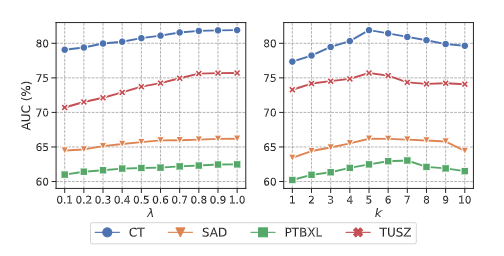
默认超参数:扰动样本数 ,扰动强度 ,损失平衡系数 。
硬件环境:Intel i9-10980XE CPU,单张 NVIDIA RTX 3090 GPU。
重点实验结果
通用开放集场景
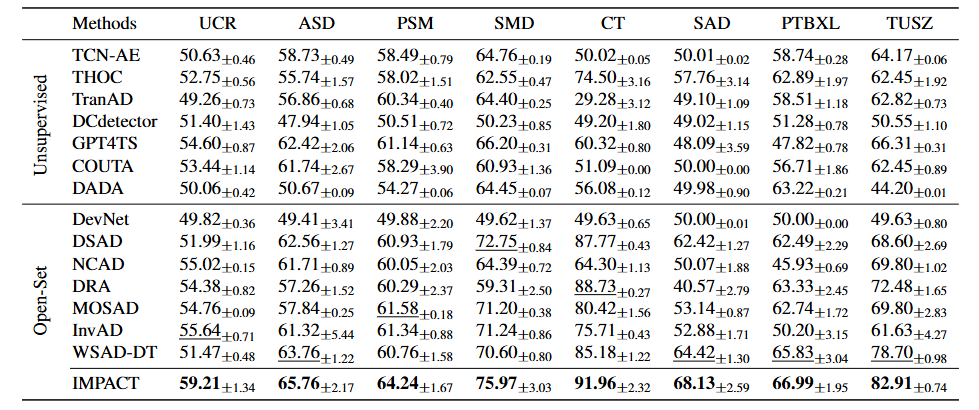
随机选取部分异常类作为已知标注,IMPACT 在全部 8 个数据集上均显著超越所有基线,平均 AUC 提升幅度为 6.37%~44.52%。典型数据集结果如下(单位:%):
| IMPACT | 59.21±1.34 | 65.76±2.17 | 64.24±1.67 | 75.97±3.03 | 91.96±2.32 | 66.99±1.95 | 82.91±0.74 |
困难开放集场景
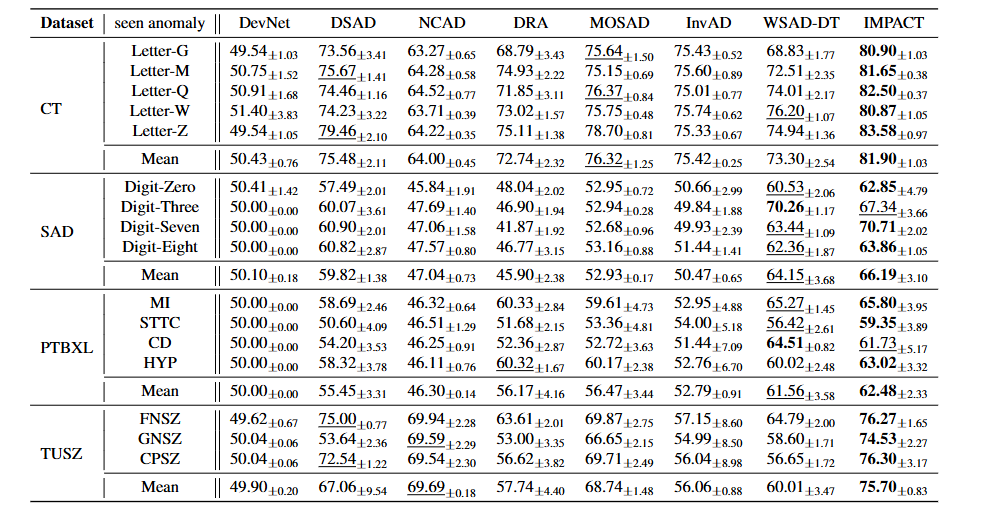
仅选取 1 个异常类作为已知标注,其余全部为未知类,评估模型的极端泛化能力。IMPACT 平均 AUC 相对基线提升 10.52%~42.83%,在所有数据集的所有已知类设置下均取得最优结果。
以 CT 数据集为例,5 个不同已知类的平均 AUC:IMPACT 81.90%,次优基线 MOSAD 76.32%。
以 TUSZ 数据集为例,3 个不同已知类的平均 AUC:IMPACT 75.70%,次优基线 WSAD-DT 60.01%。
消融实验
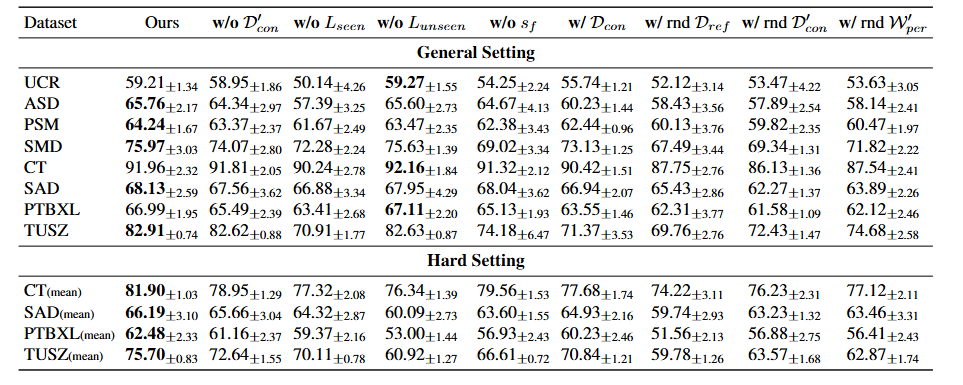
通过移除核心组件验证各模块的必要性:
标签翻转的作用:移除翻转的污染样本后,所有数据集 AUC 均出现下降,在污染率高的场景下降更明显,证明去污染模块有效抵消了训练噪声的负面影响。
双头架构的作用:移除可见异常头后性能下降最显著,证明已知异常先验是检测精度的核心基础;移除不可见异常头后,困难场景下性能大幅下降,通用场景影响较小,验证了伪异常生成对未知类泛化的关键作用。
特征偏差分数的作用:移除后 AUC 普遍下降,证明特征空间的分布偏差补充了分类头的检测盲区,提升了细粒度异常的捕获能力。
为验证影响建模的不可替代性,将影响引导的操作替换为随机选择 / 随机扰动,结果显示:
随机选择参考集、随机翻转标签、随机特征扰动均会导致性能显著下滑,证明 IMPACT 的性能提升并非来自数据增广的红利,而是源于影响函数的精准引导。
关键机制深度分析
异常污染鲁棒性分析
在 2%~10% 的污染率区间内测试性能变化:
所有基线方法的 AUC 随污染率升高持续单调下降,污染率越高,性能衰减越严重。
IMPACT 的性能保持高度稳定,甚至在部分数据集上随污染率升高略有提升 —— 因为更多污染样本经翻转后转化为有效的异常监督数据,反而增强了模型的异常判别能力。
伪异常生成质量量化
通过 KL 散度衡量生成的伪异常与真实未知异常的特征分布差异:
传统增强方法(COE、WMix、CutAddPaste 等)的 KL 散度普遍在 0.15~1.53 之间,生成的伪异常聚集在已知异常附近,无法覆盖未知异常的分布。
IMPACT 生成的伪异常 KL 散度始终最低(0.03~0.32),平均降低 64.13% 的分布差异,与真实未知异常的分布高度贴合。
t-SNE 可视化进一步验证:IMPACT 生成的伪异常均匀分布在正常分布外围,且与真实未知异常的区域高度重合;传统方法生成的样本则集中在已知异常周边。
少样本标注效率分析
随着标注异常数量从 1 增加到 20:
简单数据集(如 UCR、ASD):性能先升后降,标注过多会导致模型过拟合已知异常,削弱对未知类的泛化能力。
复杂数据集(如 PTBXL、TUSZ):性能随标注数量增加持续提升,说明复杂场景下更多的异常先验能够持续帮助模型学习通用的异常模式。
IMPACT 在所有标注量级下均显著优于基线,证明方法对少样本场景的适配性更强。
多通道策略的作用验证
单通道配置下性能最差,随着通道数增加,检测精度先升后降。
3~5 个通道时达到最优平衡:通道数过少无法提供多视角的判别信息,通道数过多会放大噪声,增加模型优化难度。
定性可视化显示:不同通道会捕捉不同类型的异常,部分异常仅在特定通道下显现,验证了多通道设计的互补性。
点级异常检测性能
采用滑动窗口将区间级分数转换为点级分数,评估细粒度检测能力:
IMPACT 在 Affiliation-F1 和 VUS-ROC 两项指标上均全面超越所有基线。
以 UCR 数据集为例,VUS-ROC 从次优的 61.09% 提升至 64.53%,证明方法不仅能识别异常窗口,还能精准定位异常发生的时间点。
计算复杂度与效率
理论时间复杂度为 ,其中 为正常集样本数, 为模型参数量,主要开销来自海森矩阵逆的计算。
实测效率:在所有深度学习基线中,IMPACT 的推理速度处于第一梯队;随着数据维度、样本量增长,执行时间近似线性增长,具备良好的可扩展性。
小小总结
文章提出了一个名为IMPACT的开放集时间序列异常检测框架,首次将影响函数理论系统性引入该领域:通过测试风险驱动的影响评分模块量化每个训练样本对模型测试风险的作用,识别出污染样本与正常边界样本;再借助风险降低的异常去污染与生成模块,对污染样本执行标签翻转以消除训练噪声并补充异常监督信息,同时对边界正常样本进行影响引导的特征扰动,生成贴合真实未知异常分布的高质量伪异常;最终搭配双头检测架构完成训练与多源融合的异常评分推理。
该方法在8个主流时序异常检测数据集上全面超越现有最优方案,在训练数据污染鲁棒性、未知异常泛化能力和细粒度点级检测精度上均表现出显著优势。
