


来源:JOJO极智算法
原文链接:https://mp\.weixin\.qq\.com/s/t1k6qrZ6\-NoU7i5yi7zEEQ
具身智能(Embodied AI)正在加速从简单的指令执行,迈向充满不确定性的真实物理世界。然而,当智能体真正落地时,往往会面临三大终极拷问:在恶劣天气下,机器人如何不变成“瞎子”?在复杂的物理接触中,如何让机器人拥有人类般的“手感”与应变能力?在数据极度匮乏的情况下,如何构建逼真的物理世界来训练机器人大脑?
本文精选了2026年来自机器人与图形学顶会(RSS、SIGGRAPH)的三篇重磅论文(CoRAL、Dr-BA、ActCam),集中展示了前沿AI技术 “复杂接触式操控”、“全天候雷达感知”以及 “3D物理世界模拟”三个维度的突破。这三项工作从感知、交互到仿真,共同拼凑出了具身智能走向开放世界的核心技术版图。
rol for Robotic Manipulation (RSS 2026)
【亮点速览】
拒绝黑盒,大模型变身“策略师”:针对现有端到端VLA(视觉-语言-动作)模型在复杂接触式任务(如倚墙翻转物体)中容易崩溃、且需要海量数据的痛点,CoRAL提出了一种神经符号框架。它不让LLM直接输出动作,而是让LLM作为“成本设计师(Cost Designer)”,为底层运动规划器(MPPI)生成目标函数。
零样本物理操控:无需任何专家演示数据,仅凭大模型的常识推理,即可在零样本(Zero-shot)状态下完成动态、力控要求极高的机器人操作任务。
【创新点】
神经符号自适应循环(Neuro-symbolic Adaptation Loop):将感知与推理彻底解耦。VLM先对物体的质量、摩擦力等物理参数给出“语义预估”;一旦机器人在操作中失败,外层循环的LLM会根据物理反馈(如:推了没推动)进行在线系统辨识,实时修正对物理参数的认知,并动态修改控制策略。
检索式记忆单元(Memory Retrieval):赋予了机器人“举一反三”的能力。将成功的物理参数和接触策略存储在记忆库中,遇到类似任务时直接调用,跨越了复杂任务的冷启动障碍。
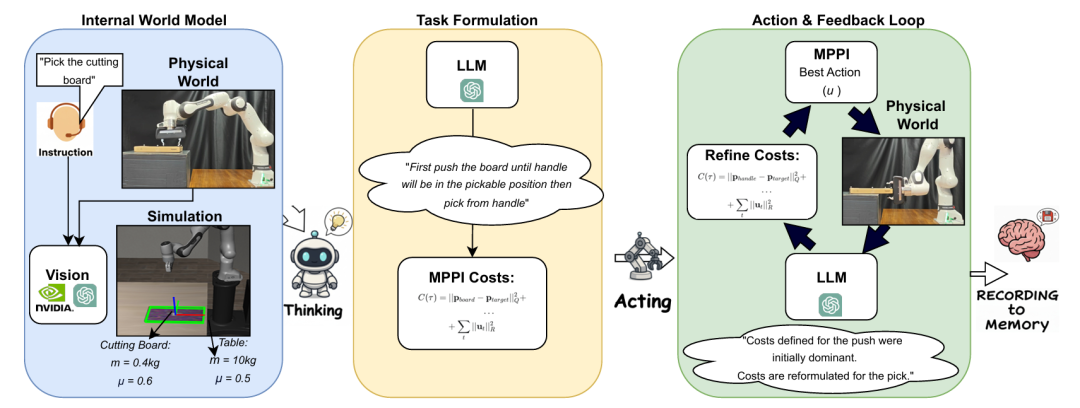
左侧视觉模块负责预估环境的物理参数(质量、摩擦力),右侧大语言模型(LLM)则化身“军师”,为底层的MPPI控制器动态生成并优化代价函数(Cost Function)。当操作偏离预期时,LLM还能通过外层循环(Outer Loop)实现在线系统辨识与物理参数纠错。
【成果】
成功率飙升:在未见过的复杂接触式任务(如推拉、翻转、定力控制)中,相比OpenVLA等当前SOTA模型,CoRAL的任务成功率平均提升了**50%**以上。
极强的虚实迁移能力:得益于自适应物理参数调整机制,该框架直接在真实的Franka Panda机械臂上实现了零样本部署,完美克服了仿真与现实之间的物理鸿沟(Sim-to-Real Gap)。
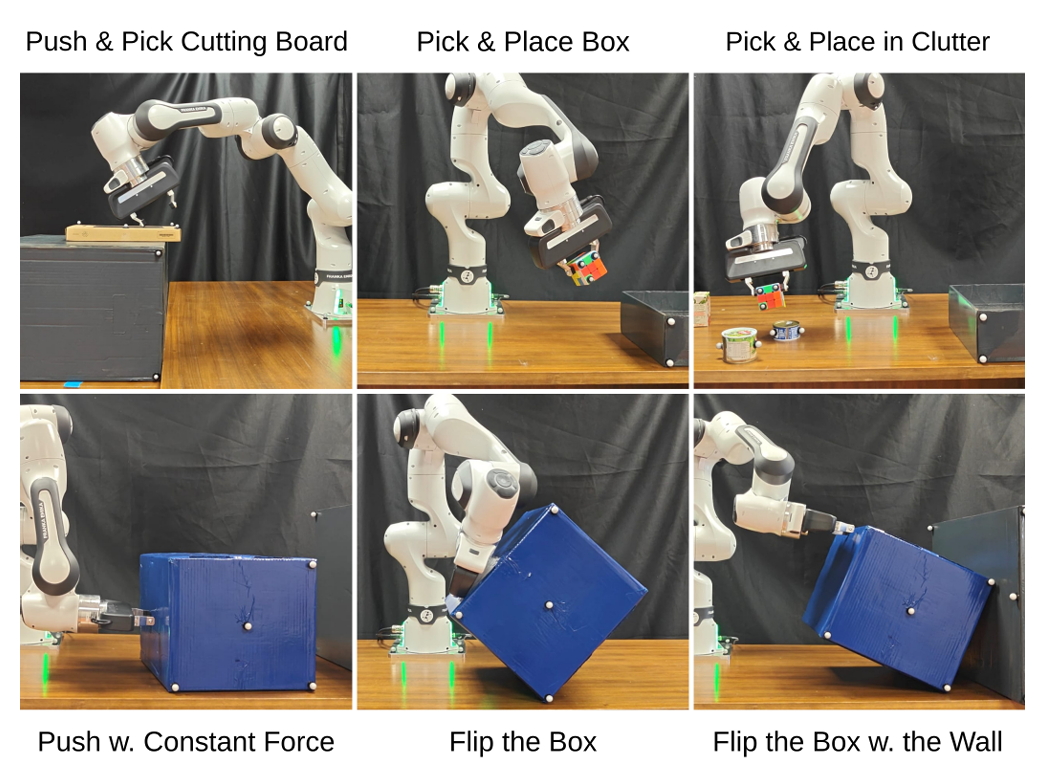
在面对诸如“推拉切菜板(需克服摩擦力)”、“倚墙翻转盒子(需利用外部环境作为支点)”等需要精细力控与复杂物理接触的任务时,未经任何专家数据微调的CoRAL框架,依然在真实机械臂上展现出了极高的执行成功率。
Dr-BA: Separable Optimization for Direct Radar Bundle Adjustment & Localization (RSS 2026)
【亮点速览】
无惧风雪的感知底座:视觉和激光雷达在雨雪天气极易失效,而毫米波雷达不受天气影响。Dr-BA是业界首个直接作用于2D旋转雷达强度图像的光束法平差(Bundle Adjustment, BA)框架。
告别稀疏特征:传统的雷达里程计依赖提取稀疏点云,难以理解环境。Dr-BA直接利用全量雷达回波,联合优化传感器位姿与高密度地图。
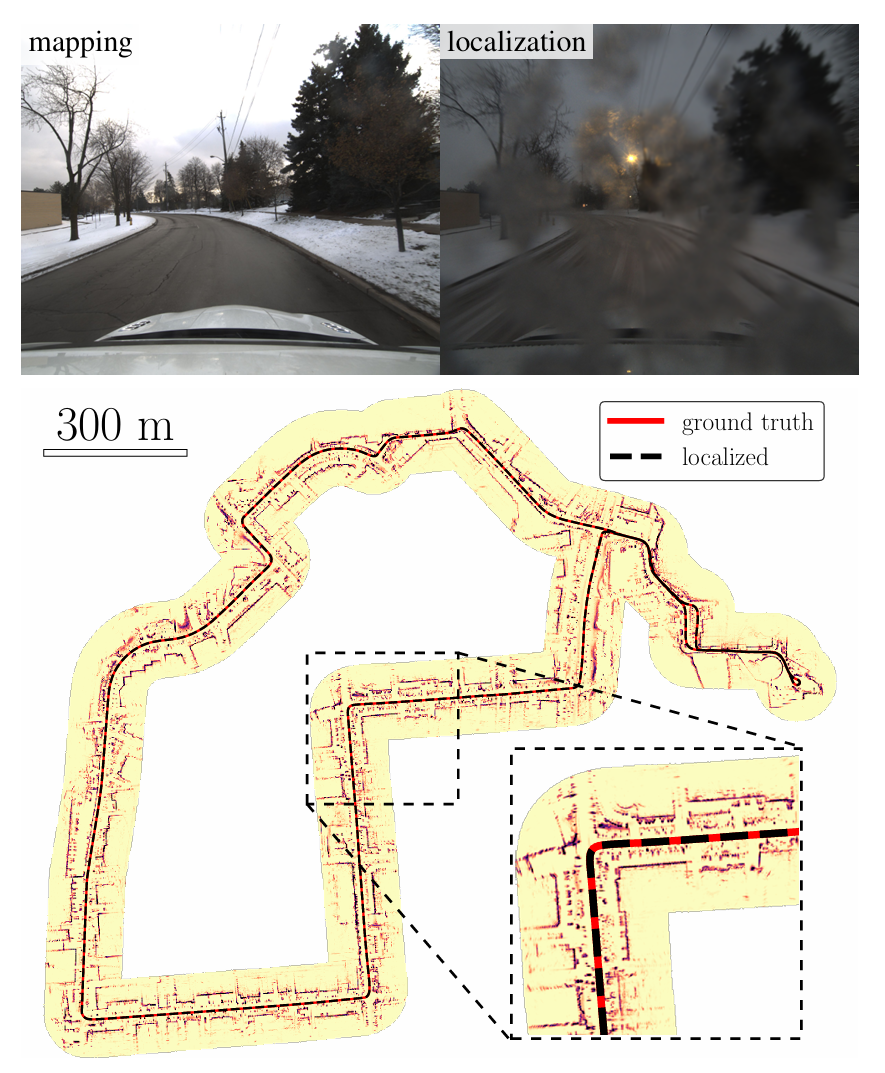
有别于视觉或激光雷达提取的稀疏点云,Dr-BA直接利用全量雷达回波构建了极其稠密且局部一致的高精度地图。图中展示了其强大的跨视界能力:机器人在极具挑战的暴风雪天气下,依然能利用晴天构建的Dr-BA地图实现厘米级的精准定位(红色定位轨迹与黑色真值高度重合)。
【创新点】
可分离优化技术(Separable Optimization / VarPro):巧妙地将巨大的BA优化问题解耦。通过变量投影技术,将“轨迹估计”与“地图构建”分离开来,使得算法的计算复杂度与地图大小呈线性关系,极大提升了运算效率。
动态模糊与累积图像处理:针对雷达数据中常见的稀疏死角和多径反射噪声,引入了自适应高斯模糊与光线累积算法,强行在特征匮乏的场景(如空旷的高架桥)中“榨取”出可用的优化梯度。
【成果】
全天候的SOTA表现:在涵盖城郊、工业区、森林等超过200公里的自动驾驶数据集中,Dr-BA取得了最先进的轨迹精度(ATE)和跨时段定位表现。
高一致性建图:即使在暴风雪天气下,利用Dr-BA生成的高密度雷达地图依然能实现厘米级的高精度定位,证明了其构建全局与局部一致性地图的卓越能力。
ActCam: Zero-Shot Joint Camera and 3D Motion Control for Video Generation (SIGGRAPH 2026)
【亮点速览】
给世界模型装上“斯坦尼康”:在AI视频生成中,同时控制人物动作和复杂的运镜一直是个灾难。ActCam提出了一种零样本(Zero-Shot)方法,允许用户给一张参考图,就能同时施加精确的3D人物运动控制和逐帧的摄像机轨迹控制。
无需微调的即插即用:不需要像Uni3C那样进行昂贵的特定任务微调,ActCam可以直接建立在任何支持深度和姿态控制的预训练图像到视频扩散模型之上。
【创新点】
相机对齐的联合条件构建:为了防止摄像机运动和人物运动“打架”,算法创造性地采用了“抠图与几何重置”策略。将参考图中的静态人物抠除,提取纯背景3D深度,再将动态的3D人物按照目标摄像机视角重新对齐并渲染,彻底消除了静态/动态干扰。
双阶段条件注入(Two-phase Conditioning):提出了一种“先搭骨架后画皮”的调度策略。在早期去噪阶段同时注入深度和姿态(锁定场景结构与运镜),随后丢弃深度信息,仅用姿态引导。这有效避免了深度图粗糙导致的背景僵化,极大保留了高频动态细节。
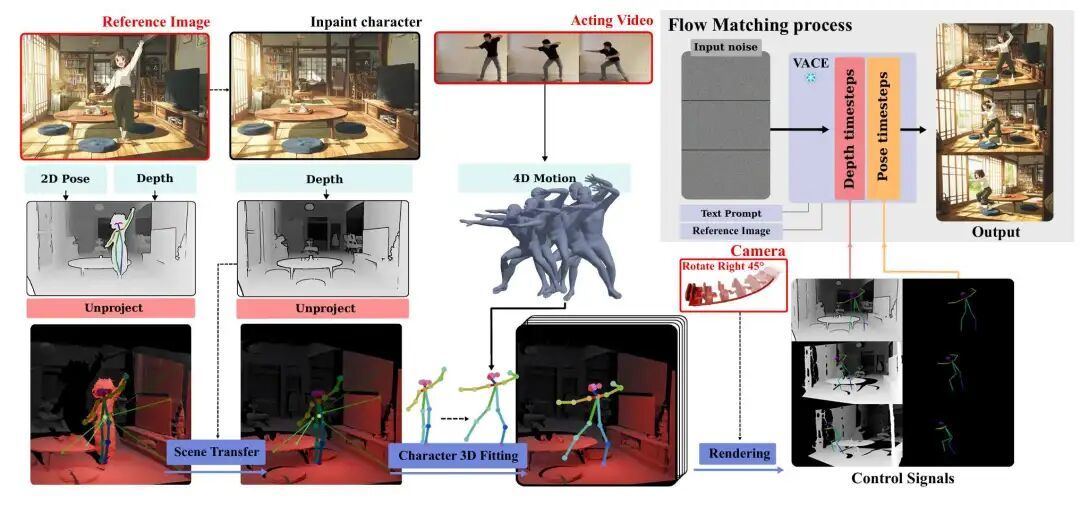
为了防止人物动作与相机运镜相互干扰,系统首先利用“图像修复(Inpaint)”将参考图中的人物抠除以提取纯净的3D背景深度,随后将动态3D人物按照目标相机轨迹进行空间对齐与重组,为扩散模型生成了毫无歧义的几何引导条件。
【成果】
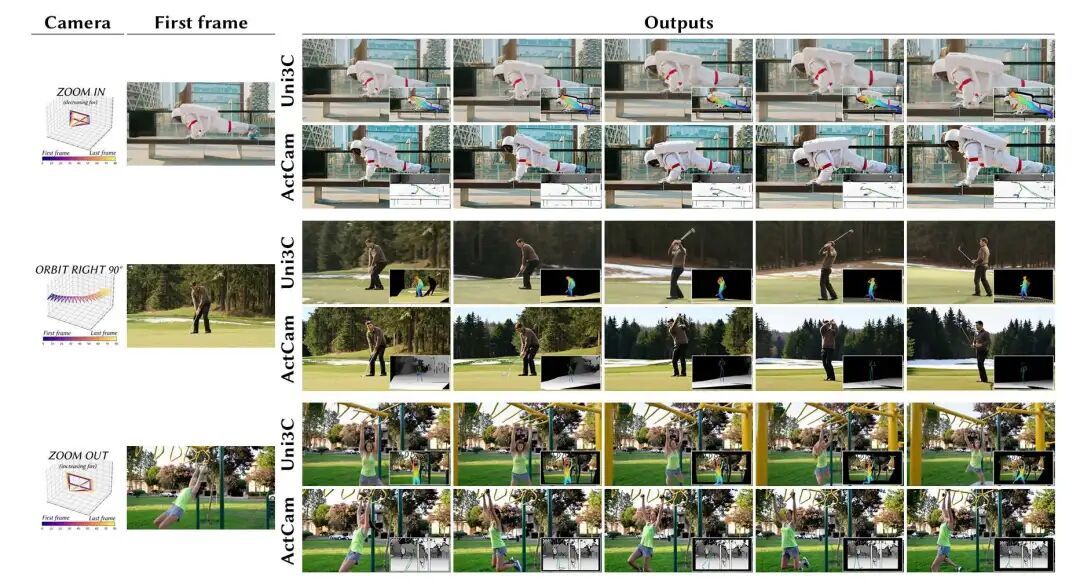
在剧烈的相机视角旋转和拉远/拉近镜头下,现有的SOTA模型Uni3C(图中第一、三排)出现了背景结构崩溃和人物动作扭曲的现象;而采用了双阶段条件注入的ActCam(图中第二、四排)则完美保持了人物肢体的一致性以及极高保真度的运镜质感。
从“认知”到“干预”:构建完整的空间智能闭环
从这三篇顶会论文中我们可以清晰地看到一条技术主线:Dr-BA解决了机器人在恶劣环境下的 “三维空间认知与定位”,提供了坚实的感知底座;CoRAL解决了机器人在复杂物理法则下的“精细干预与自我纠错”,赋予了智能体灵巧的双手;而ActCam代表的3D可控视频生成技术,则为机器人提供了无限逼近真实的“平行世界仿真器”。
这三个维度的交汇,标志着AI正在从“只能在屏幕上作诗画画”,向“能够真实感知、理解并重塑物理世界”的具身智能终极目标大步迈进。
原文链接: https://www.leiphone.com/category/private/LerWcWbkiXxH5L3m.html
