


来源:公众号|多模态信息融合
ICML 2026 图像/红外/融合
这次我们把Image fusion、Infrared、Fusion三组检索结果进行并集运算之后,去掉 ReID、红外检测、病理预测等不属于图像融合主线的内容。将每一篇论文放到它应该回答的问题里:一般性特征、语义导航、空间-光谱建模、移动端部署、视频时序一致性。
NO.0
导读
GUIDE
如果要快速抓住要点的话,可以记住下面这句话:ICML 2026 融合论文不只追求“更清晰的一张图”,还要问一问“融合模型怎样去适应现实世界”。
在现实世界中,传感器是不固定的,光谱带也是不固定的,场景语义也是不固定的,而且输入可能会出现错位的情况,视频还会有跨帧漂移的问题。所以这些工作一起把融合从“像素级增强”推进到表征接口、潜空间算子、文本/语义先验、部署效率以及时序稳定性。
NO.1
趣味问答 QA
快速问答
不再只是比较 EN、MI 和 SSIM 哪个大了,而要回答下面五个更基础的问题:怎样去设计共享表征、如何把语义先验带入到融合中来、空间和光谱怎么一起求解、模型怎样在边缘端进行实时部署、如何防止视频融合长时间漂移。
按照兴趣来划分阅读内容:做一般性表征看1D-Fusion;做差异决策看IDEAL;进行语义或者文本融合看TEDFusion;做移动端部署看MobileFusion;做视频融合看DRFusion;做遥感高光谱/配准融合看SSA、SA-RFM 和 LSO。
Infrared 和 Fusion 会有很多“相关但不在这篇文章主要部分”的论文,比如可见光-红外 ReID、红外小目标检测、红外检测攻击、病理生存预测、workshop 早期融合等等。它们与关键词有关,但是不在本文所讨论的像素级、图像级和视频级融合,因此放在文末的边界清单上。
NO.2
先按主题看一遍
主题地图
把融合的共享载体由原来的二维特征网格推进到一维 token 或者显式差异决策上,主要就是使模型能够知道哪些东西要共享、哪些东西要保留差异。
围绕语义导航、潜空间鲁棒性以及移动端部署等方面继续推进 IVIF,把目标由原来的视觉质量扩展到场景适应和工程化落地。
由原来的固定传感器适配发展到任意光谱带、任意尺度、配准融合一体化和更加普遍的潜空间 / 算子建模。
由逐帧图像融合转为历史条件、运动先验以及抗漂移建模,用来解决闪烁、鬼影以及跨帧误差累积的问题。
NO.3
9 篇论文索引
论文目录
NO.4
论文逐篇速览
题目:Hyperspectral Image Fusion with Spectral-Band and Fusion-Scale Agnosticism
光谱带与融合尺度都不固定:面向未见传感器的高光谱融合
作者:Yu-Jie Liang · Zihan Cao · Liang-Jian Deng · Yang Yang · Malu Zhang*
单位:电子科技大学计算机科学与工程学院(网络空间安全学院)/ 电子科技大学数学科学学院 / 电子科技大学四川省多灾害早期预警重点实验室
链接:https://arxiv\.org/abs/2602\.01681
代码:暂无
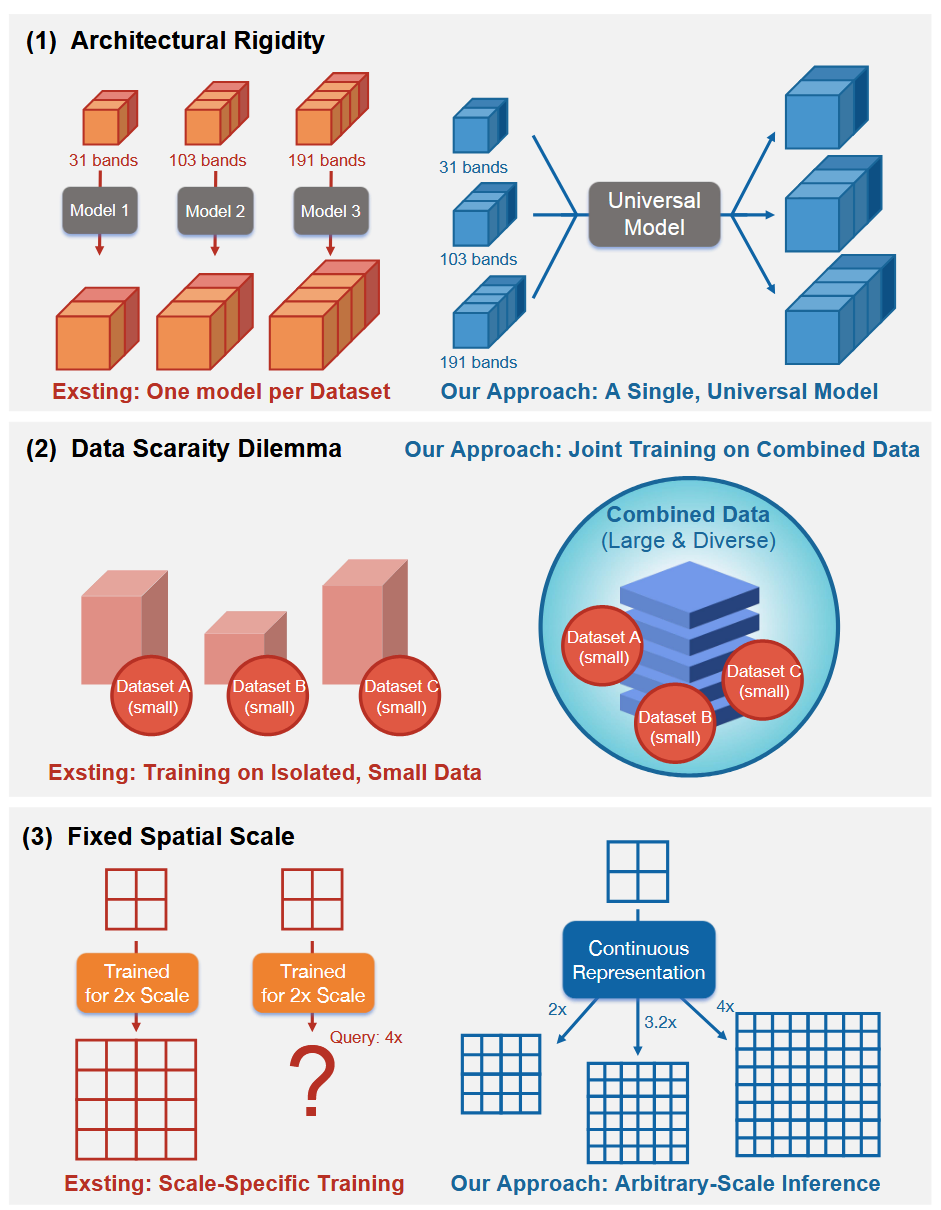
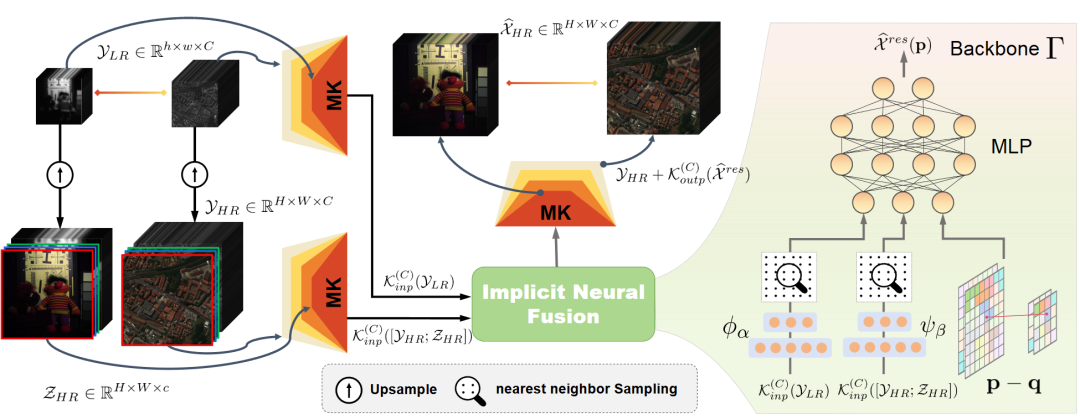
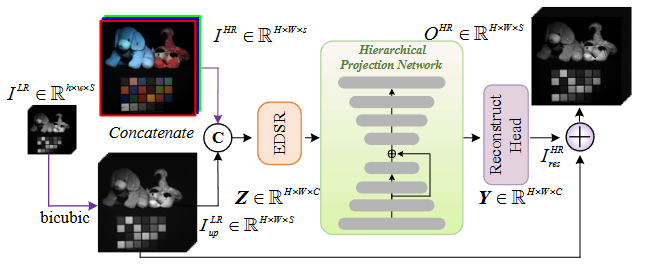
摘要精读:本文所要解决的是高光谱融合中一个很实际的问题:很多模型默认光谱通道数和融合尺度都是固定的,更换一个传感器或者改变分辨率就会失效。SSA 有两个主要部分:第一是Matryoshka Kernel,使一个模型可以适应不同的光谱通道数;第二是隐式神经表示 INR,把高光谱信号当作一个连续函数来处理,从而实现任意空间分辨率重建。
读者视角:对遥感 / 高光谱方向的读者来说,它最值得看的是一个模型是否可以跨传感器、跨尺度地被复用这个问题。
题目:From 2D Grids to 1D Tokens: Reforming Shared Representations for Multimodal Image Fusion
从 2D 网格到 1D Token:重新定义多模态图像融合的共享表征
作者:Yuchen Xian · Yunqiu Xu · Yang He · Yi Yang*
单位:浙江大学 / 新加坡国立大学 / A*STAR
链接:https://arxiv\.org/abs/2606\.12303
项目页:https://zju\-xyc\.github\.io/1D\-Fusion\-Project\-Page/
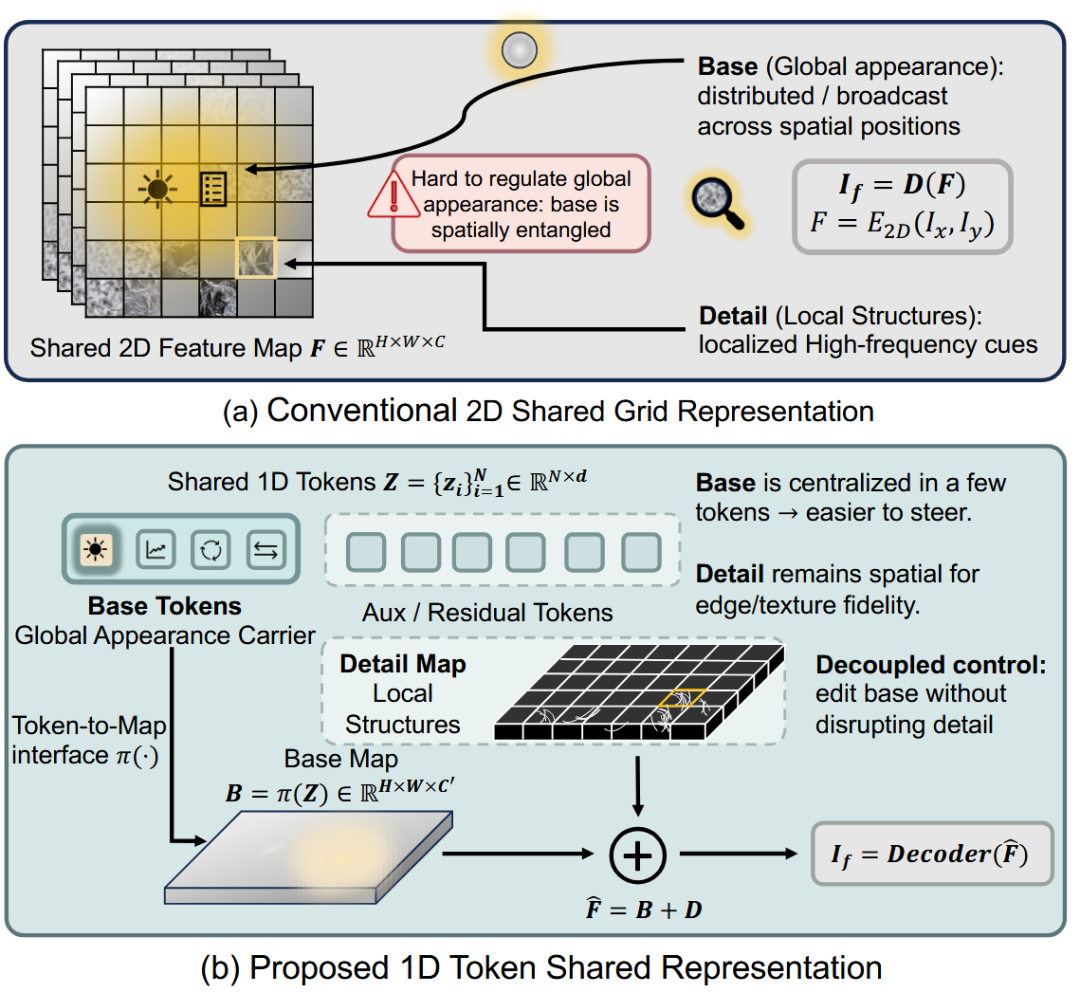
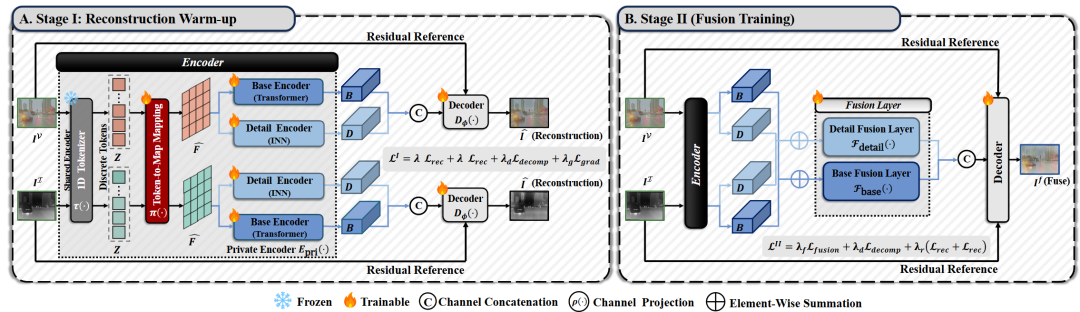
摘要精读:传统的融合网络一般将共享信息放在二维特征网格中:它很擅长处理纹理、边缘和局部结构,但是对于亮度、整体感觉以及全局基调等图像级别的 appearance 因素并不友好。1D-Fusion 使用冻结的预训练图像 tokenizer,并且用 1D token 作为全局外观载体,同时保留 2D 空间路径来负责局部结构。它只对少数重要 token 进行稀疏修改,并没有重新生成整个图像,只是对融合结果的整体一致性做轻量调整。
读者视角:如果对“融合的结果为什么局部清晰但是整体不自然”这个问题感兴趣,这篇文章从接口角度给出了一个很好的答案:2D 管结构,1D 管外观。
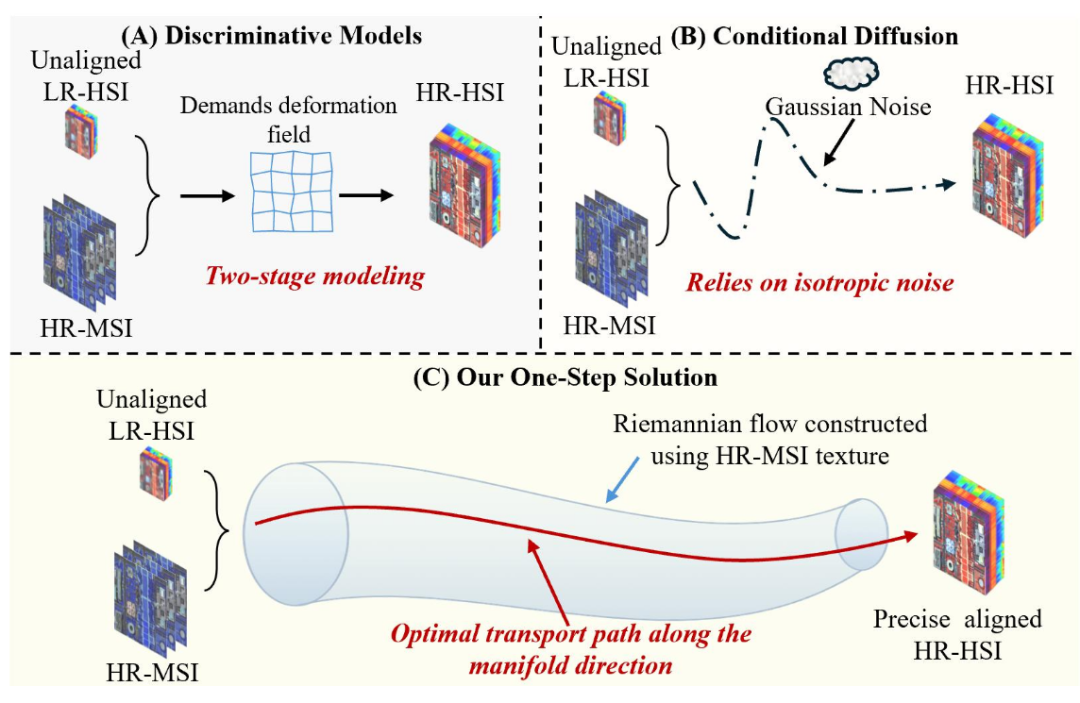
题目:Structure-Aware Riemannian Flow Matching for Registration and Fusion of Hyperspectral and Multispectral Images
结构感知 Riemannian Flow Matching:把配准与高/多光谱融合放到同一几何框架里
作者:Quan Zhang · Jun Li* · Weilong Zhu · Mingyang Li · Qinmu Shen · Yuanxi Peng
单位:国防科技大学计算机科学与技术学院 / 国防科技大学电子科学与技术学院
链接:https://openreview\.net/attachment?id=s7PdLEWyyW&name=pdf
代码:https://github\.com/ZhangQuan\-hub/SA\-RFM
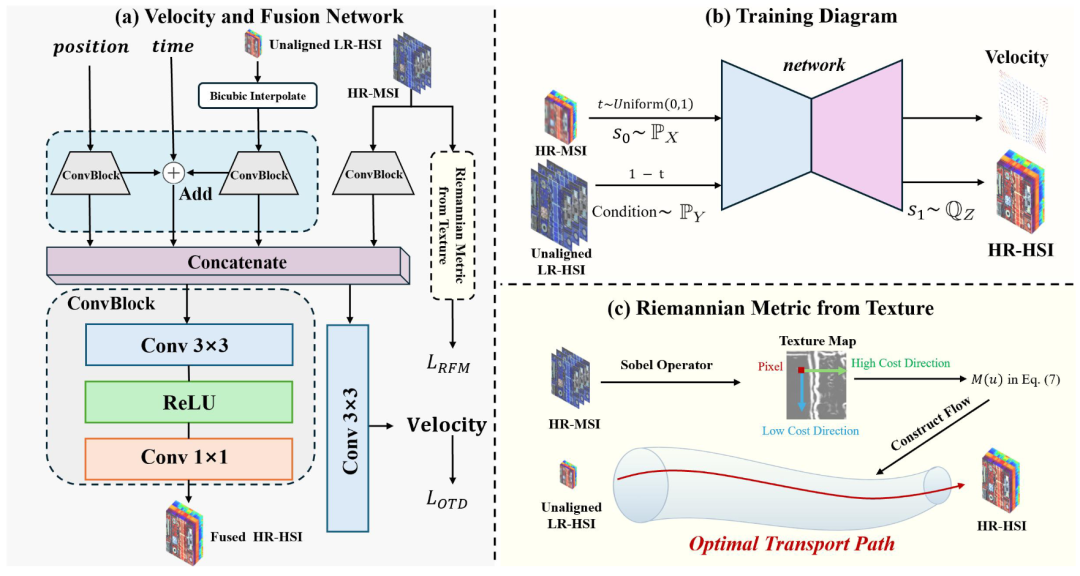
摘要精读:这已经不是只做标题级别的判断了。PDF 把问题定义为未配准 HSI/MSI 的联合配准与融合:精确对齐是高 / 多光谱融合的前提,但是现实中的平台振动、传感器视差、湍流等等都会造成非刚性的错位。SA-RFM 把配准看作是一个结构感知下的动态最优传输问题,在 MSI 结构线索引导下的 Riemannian 流形上学习形变路径,并不是用普通的欧氏距离来把所有方向上的偏差都看作同一种错误。从方法上看,它把几何约束加入到 flow matching 中去的方式有两个:第一是Riemannian Flow Matching loss,在高代价结构方向上对速度误差进行更加严格的处罚;第二是Optimal Transport Direction regularization,把预测速度场导向 Riemannian 度量下低代价传输的方向。这样做的价值在于:配准并不是只求像素位移相近,而是要尽可能避开道路、建筑物等结构区域,减少光谱混杂以及边界模糊。
读者视角:主要看三方面:一是它怎样把配准和融合的过程由串联改为统一建模;第二,Riemannian metric 中结构张量是如何由 MSI 构建出来的;第三,在 Elastic、Homography、Turbulence 等扰动之下,它是否能够同时提高空间对齐度与光谱保真度。对遥感融合读者来说,本文的启示是:错位并不是预处理的小问题,而是在融合模型中必须要建模的核心变量。
题目:Difference-Aware Decision Learning for Multimodal Image Fusion
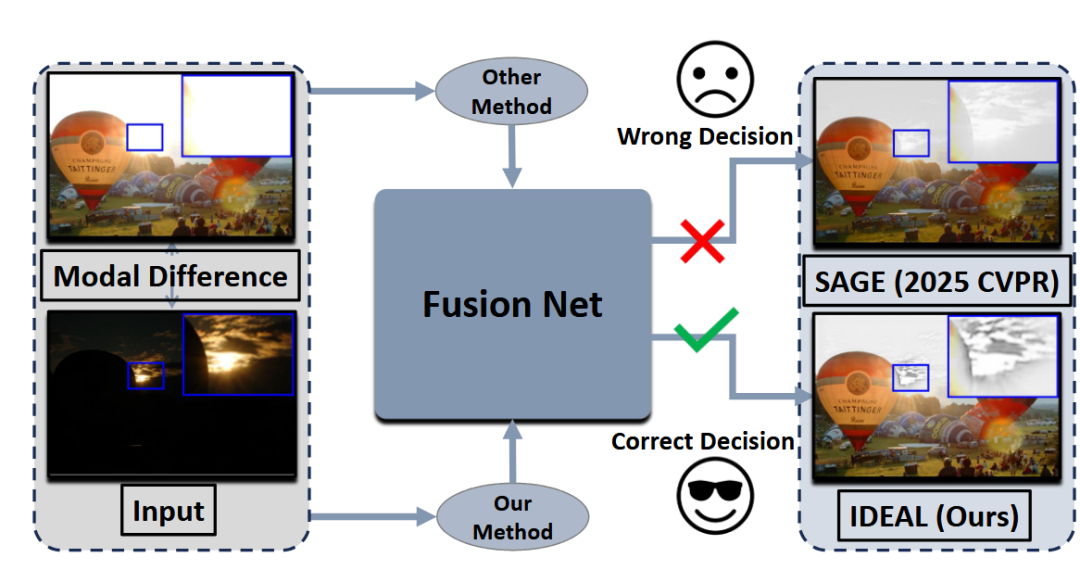
IDEAL:把模态差异转化为可以被解释的融合决策,而不是只用隐式加权
作者:Hao Pan · Jian Dai · Yuan Sun · Zhenwen Ren* · Xingfeng Li*
单位:西南科技大学 / 西南自动化研究所 / 四川大学
链接:https://openreview\.net/attachment?id=j4E6NstJR4&name=pdf
代码:https://github\.com/Pon915/IDEAL\-main
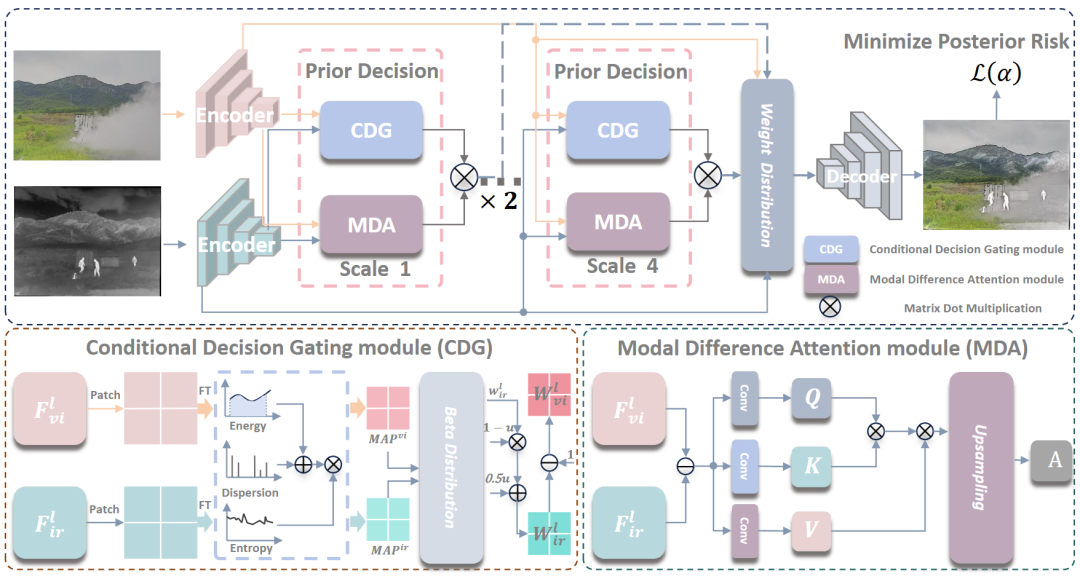
摘要精读:该文的方法名应该写为IDEAL,而不能继续使用原来的占位符。它将多模态图像融合再表述为一个在观测条件下进行的概率决策学习问题:局部区域应该偏向哪个模态,不能只用隐式的注意力或者特征激活来决定,而要将“模态贡献”作为显式的决策变量。IDEAL 的关键是把跨模态差异作为决策触发器来使用。它用Modal Difference Attention(MDA)对需要进行局部贡献判断的区域进行定位,然后用Conditional Decision Gating(CDG)从功率谱能量、互补频谱和谱熵可靠性中形成决策依据。然后把上面提到的证据映射到一个对称 Beta 先验中:当证据充分的时候模型做出明确分配,而当证据不足的时候就自动收缩为保守混合,防止被过曝、强响应或者局部噪声影响。
读者视角:可以和各种“显式模态贡献 / 动态门控 / Mask 决策”等方法一起阅读。它最有价值的地方并不是又设计了一个模块,而是在融合中把一个老问题讲明白了:强响应并不等同于可靠的信息,差异不一定就是互补的信息。后面的阅读中可以重点关注 MDA/CDG 是否能够提高跨任务稳定性,以及 Beta prior 的不确定性收缩能否降低伪影传播。
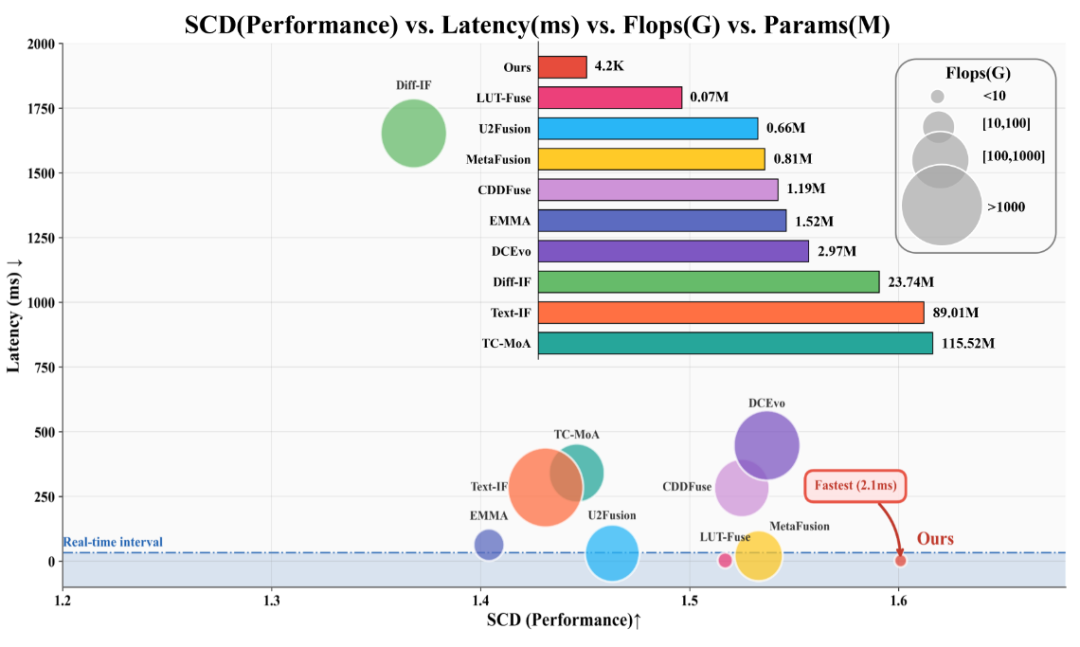
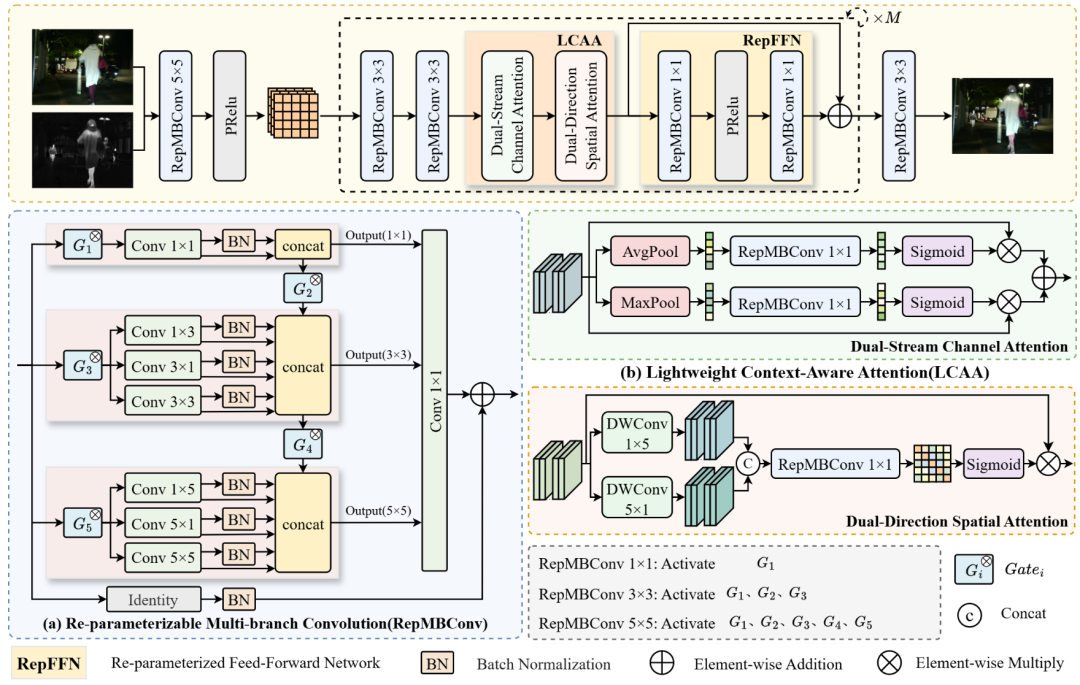
题目:MobileFusion: Mobile-Friendly Infrared and Visible Image Fusion via Structural Re-parameterization
MobileFusion:通过结构重参数化实现移动端友好的红外-可见光融合
作者:Yufa Duan · Jialing Huang · Yingying Wang · Weimin Cai · Xinghao Ding · Xiaotong Tu*
单位:厦门大学
链接:https://openreview\.net/attachment?id=Mv6r6u3Yf9&name=pdf
代码:https://github\.com/sucessfullys/MobileFusion
摘要精读:很多 IVIF 方法在论文指标上很优秀,但是需要复杂的注意力机制、扩散迭代或者大的网络结构,在实际部署的时候会遇到算力、显存以及延迟的问题。MobileFusion 的主要目标是:使用结构重参数化将训练中多分支的能力折叠到推理中的单路径高效卷积中。公开新闻中提到,它用多尺度、多方向异构卷积分支来加强红外热辐射和可见光纹理之间的相互作用,在推理的时候进行数学上的等效变换,以此来降低延迟以及内存访问成本。
读者视角:它提醒我们,融合算法不能只问清不清楚,还要问能不能在边缘设备上进行实时运行。
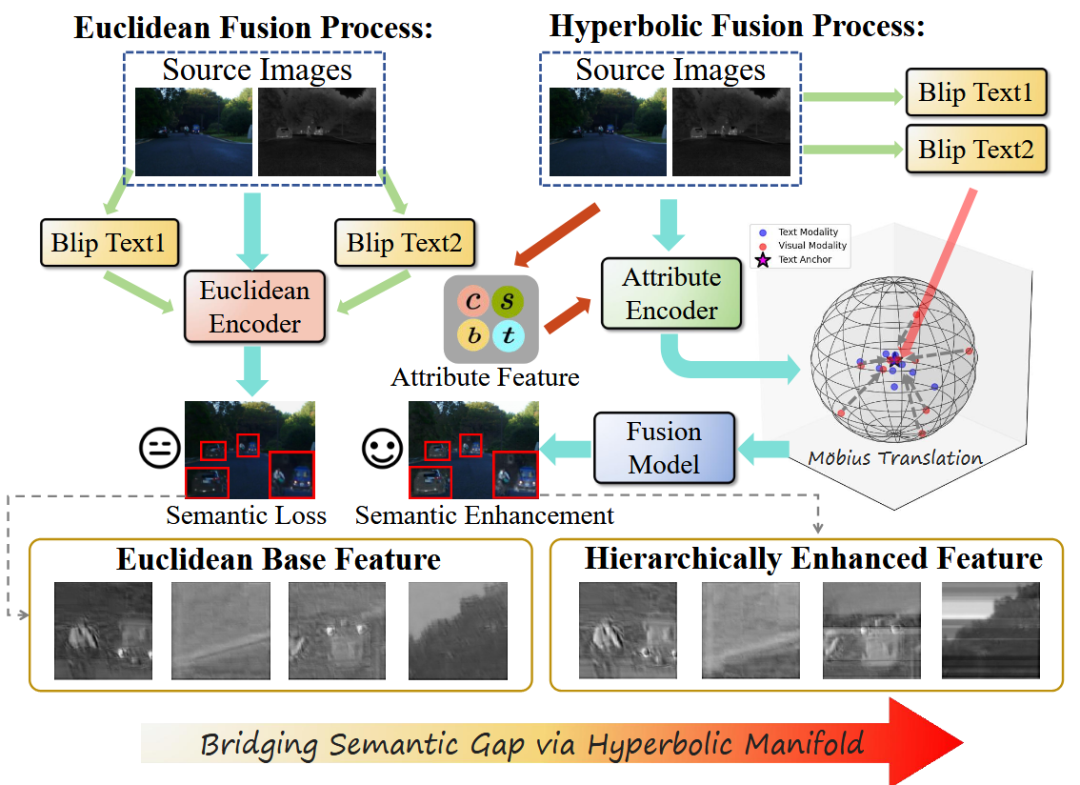
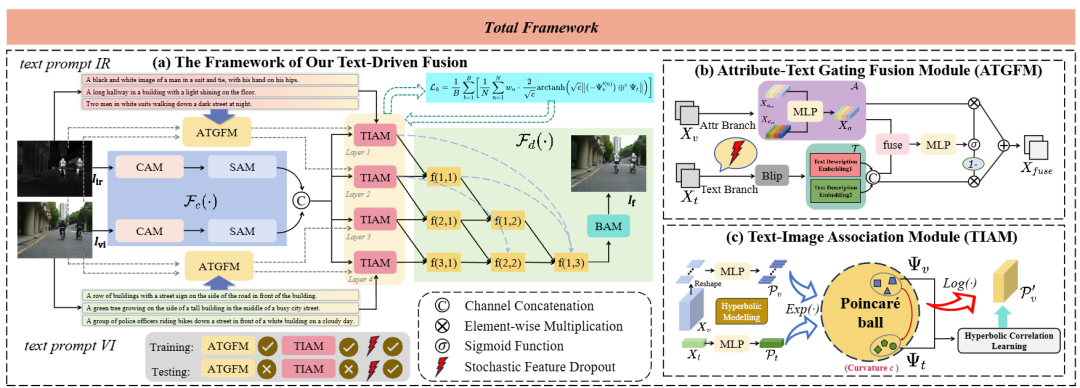
题目:Text-Driven Fusion for Infrared and Visible Images: Achieving Image Scene Adaptation on Hyperbolic Space
文本驱动红外-可见光融合:在双曲空间实现图像场景自适应
作者:Huan Kang · Hui Li · Tianyang Xu · Tao Zhou · Xiao-Jun Wu* · Josef Kittler
单位:江南大学 / University of Surrey
链接:https://arxiv\.org/abs/2606\.15104
代码:https://github\.com/Shaoyun2023/TEDFusion
摘要精读:TEDFusion 的关键不是“推理的时候让使用者输入一句话”,而是在训练阶段使用 BLIP 来提取文本提示,并把文本当作双曲空间中的拓扑锚点,使视觉属性和层级语义对齐。论文指出,Poincaré ball 的负曲率能够更好地容纳从粗到细的语义层次;在推理过程中,模型利用所学得的文本-属性先验来自适应地处理输入内容,不需要再有额外的文字输入。
读者视角:融合开始从“像素互补”走向场景语义导航。
题目:LaRA-Fusion: Latent-Robust Adaptation via Dual-Loop Constraints for Infrared and Visible Image Fusion
LaRA-Fusion:用双环流形约束提升红外-可见光融合的潜空间鲁棒性
作者:Yaru Su · Chaowei Huang · Huangbiao Xu · Xiao Ke*
单位:福州大学计算机与数据科学学院 / 福建省网络计算与智能信息处理重点实验室 / 教育部大数据智能工程研究中心
链接:https://openreview\.net/attachment?id=u6UnapBLWr&name=pdf
代码:暂无
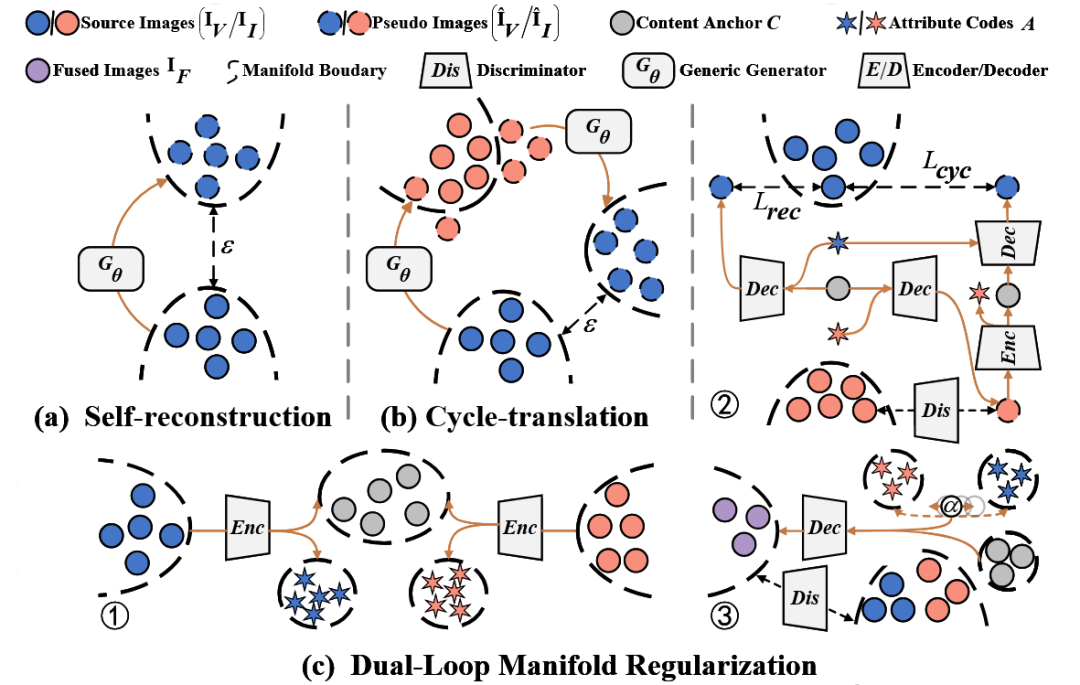
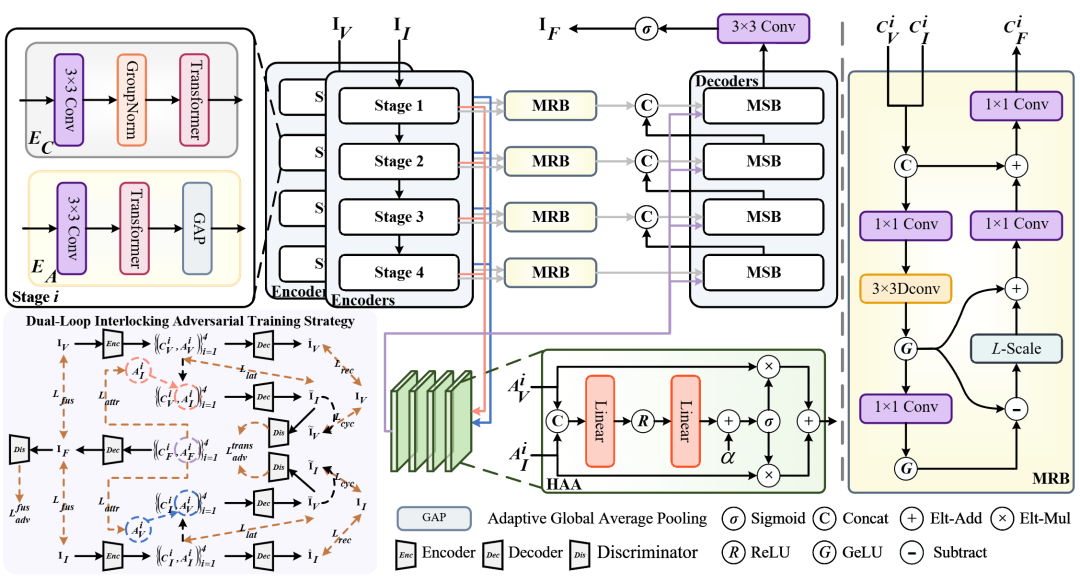
摘要精读:LaRA-Fusion 还可以由“标题级”提升到“摘要级”。它所关心的是 IVIF 中一个容易被忽视的问题:当没有真正融合标签的时候,模型可能会通过数值捷径来满足重建损失,比如把源图的细节编码成不可见的高频噪声,表面看重建误差很小,但是潜空间拓扑已经发生了漂移,跨场景鲁棒性就会下降。为了解决这个问题,LaRA-Fusion 构造了Dual-Loop Manifold Constraints:内环注重几何可逆性,使表示不容易丢失结构;外环利用对抗对齐将中间翻译状态拉回到目标的数据分布中去,从而减小 off-manifold 漂移。同时,模型将输入分成共享内容锚点 C 和模态属性 A,并且用MRB、MSB 和 HAA对潜空间校正、属性调制重建以及层级属性仲裁进行分别处理。
读者视角:最好是从“潜空间是否可信”的角度来读。很多融合模型看上去指标很好,但是换了光照、烟雾、夜晚等场景之后就会偏向于某一个模态。LaRA-Fusion 的启示是:融合的时候不能只保留像素信息,还要保证潜空间的拓扑一致性。后面如果要做跨场景鲁棒融合、无监督融合稳定训练,这篇文章要重点看。
题目:DRFusion: Drift-Resilient Temporally Consistent Infrared-Visible Video Fusion
DRFusion:面向红外-可见光视频融合的抗漂移时序一致性方法
作者:Xingyuan Li · Haoyuan Xu · Shulin Li · Xiang Chen · Zhiying Jiang · Jinyuan Liu*
单位:浙江大学计算机科学与技术学院 / 大连理工大学软件学院与 DUT-RU 国际信息与软件工程学院 / 大连海事大学信息科学技术学院
链接:https://openreview\.net/attachment?id=H98n6clgHv&name=pdf
代码:https://github\.com/xhhaoyan/DRFusion
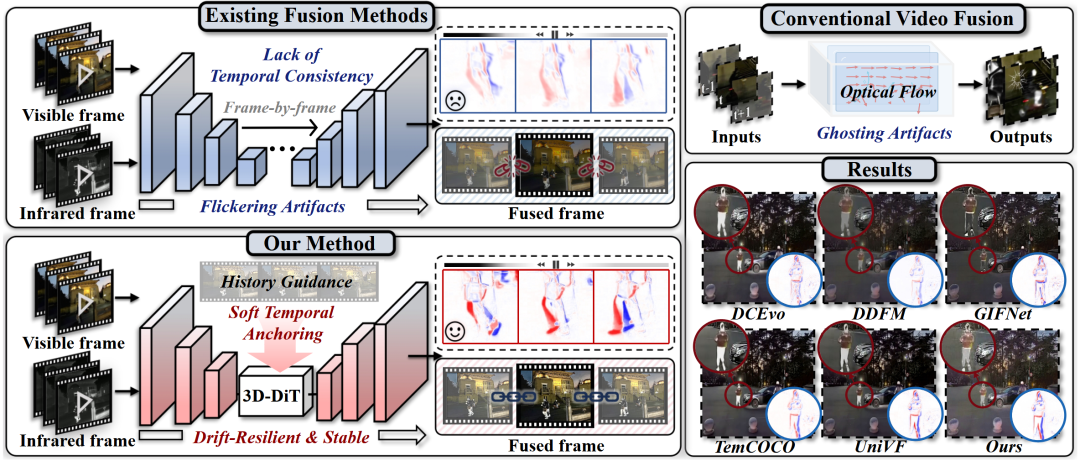
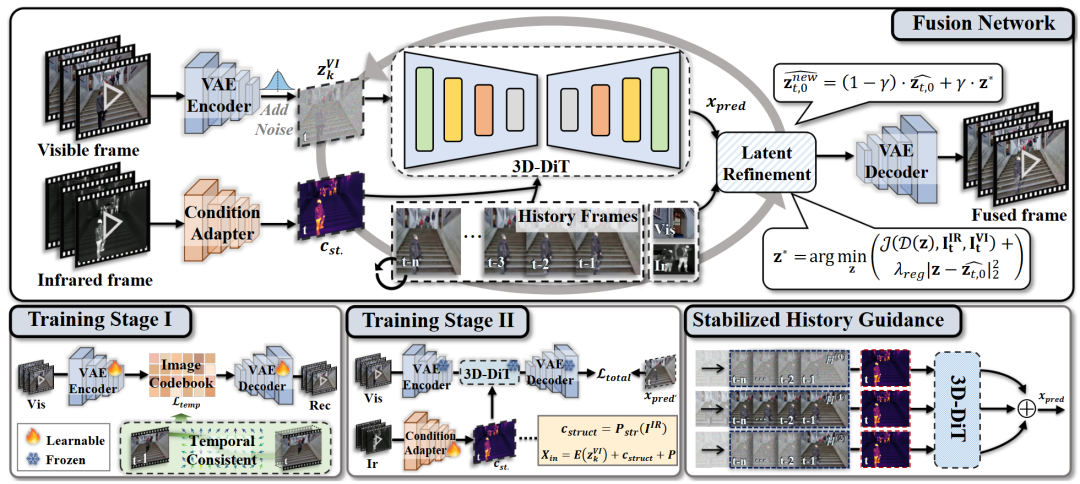
摘要精读:视频融合比图像融合更困难,除了“一帧清楚不清晰”的问题之外,还有跨帧是否出现闪烁、鬼影、随时间漂移等问题。DRFusion 把红外-可见光视频融合改写为历史条件下的运动生成:使用 Stabilized History Guidance 和 Soft Temporal Anchoring 来把时序一致性看作一个频谱滤波的问题,并且把稳定下来的低频运动趋势和不断累积起来的高频误差分开。
读者视角:如果你做过逐帧融合视频,就会明白这篇文章的重要性:单帧的质量好,并不代表整个视频是稳定的。
题目:Solving Spatial-Spectral Fusion with Latent Spectral Operators
用潜谱算子求解空间-光谱融合:从像素域映射转向潜空间建模
作者:Wei Li · Jieyuan Pei · Junnan Xu · Xuanfeng Ding · Junwei Zhu · Wanjun Chen · Jianwei Zheng
单位:浙江工业大学
代码:https://weili419\.github\.io/latent\-spectral\-operators/
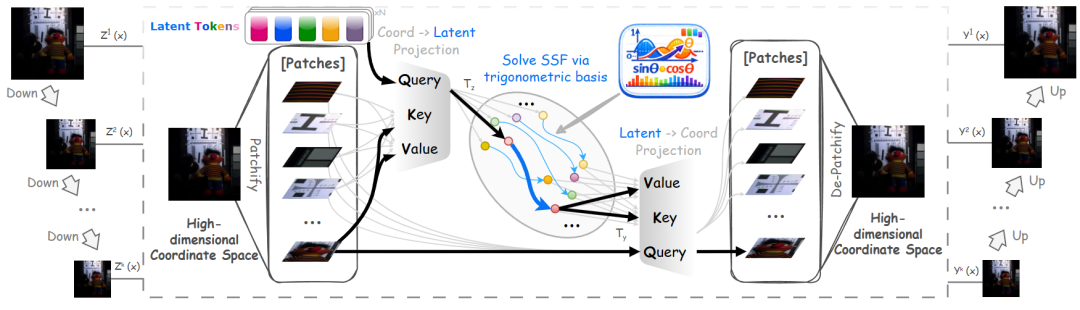
摘要精读:LSO 加入之后,这份主榜就更加全面了。它所关心的是空间-光谱融合:一个传感器具有较高的空间分辨率,而另一个传感器则提供了更多的通道或者物理响应。公开新闻中提到,LSO 使用交叉注意力投影网络以及可学习的 latent tokens,把高维图像观测压缩成紧凑潜在表示,并且降低模型对于具体分辨率和像素坐标的要求。
读者视角:可以和 SSA 放在一起看:SSA 偏任意波段、任意尺度的通用模型,LSO 偏潜空间 + 谱算子建模,二者一起表明遥感融合正在逐渐从更加一般的函数或者算子角度来考虑。
NO.5
边界项单列
下面这些论文在红外线或Fusion检索中会出现,但是本文不会把这些放在主要榜单上:
Cross-Modal Semantic Decoupling、Hyperbolic Hierarchical Alignment 等属于行人重识别/跨模态检索,不输出融合图,因此不进入图像融合主榜。
Diffuse to Detect、Temporal-Emerged Prompting、CodeMamba、Fourier Shapes 等更偏向于红外小目标检测、序列异常检测或者检测攻击的研究对象,并不是图像融合。
DPsurv、HistoTx 等虽然包含 Fusion,但更偏 whole-slide image survival prediction 或 workshop early fusion,不属于本文的像素级/图像级融合主线。
NO.6
总结
将这 9 篇放到一张发展图上来看的话,可以发现 ICML 2026 的融合方向出现了三条明显的路线:
第一,由网络结构到表征接口。1D-Fusion 和 IDEAL 告诉我们,融合的效果不仅和 backbone 有关,还和信息被放入怎样的共享空间中有关。
第二,由单一场景模型到真实世界的适应。TEDFusion、LaRA-Fusion、MobileFusion 从语义、潜空间鲁棒性以及移动端部署的角度出发来说明,“能不能用”已经和“好不好看”一样重要了。
第三,由静态图片到函数 / 算子和视频序列。SSA、Riemannian Flow、LSO 将遥感融合推向了更加普遍的光谱 / 尺度 / 空间建模;而 DRFusion 则把视频融合的核心问题由单帧的质量推进到了长时间序列上的稳定性。
NO.7
数据来源和验证说明
本文根据 ICML 2026 Downloads 官方总表、ICML、OpenReview、arXiv、作者 / 机构主页、高校新闻页面等多方面进行交叉验证。
官方总表:https://icml\.cc/Downloads/2026
OpenReview 会议的信息:https://openreview\.net/group?id=ICML\.cc/2026/Conference
原文链接: https://www.leiphone.com/category/private/cqx3vOuuVoQWd5kb.html
