


作者丨张 璐
编辑丨齐铖湧
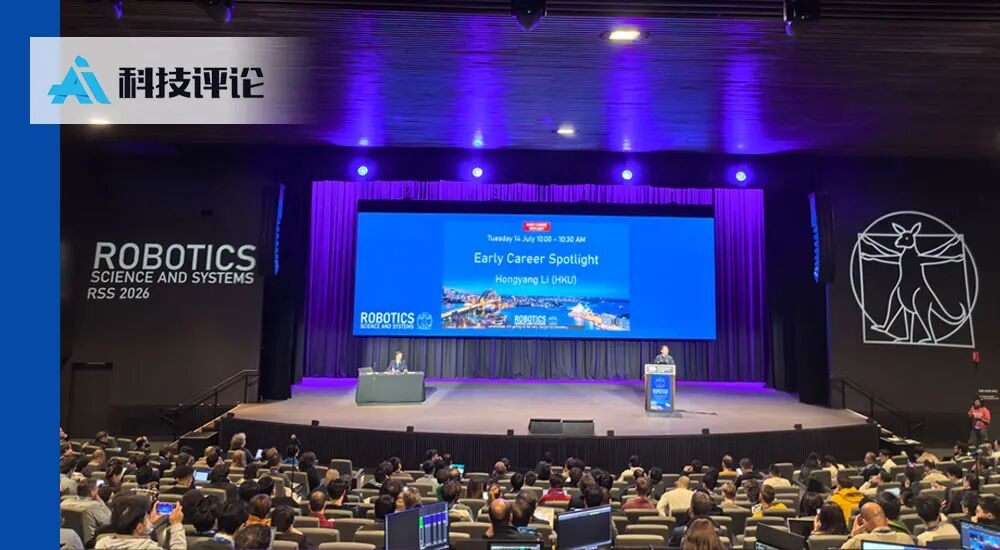
2026年7月14日上午10点,机器人领域国际顶级学术会议 RSS(Robotics: Science and Systems)现场掌声雷动。
香港大学助理教授、源策未来创始人李弘扬,荣获 RSS 2026 年度“青年成就奖”(Early Career Spotlight),值得一提的是,他也是该奖项设立20年以来唯一的国人获奖者。
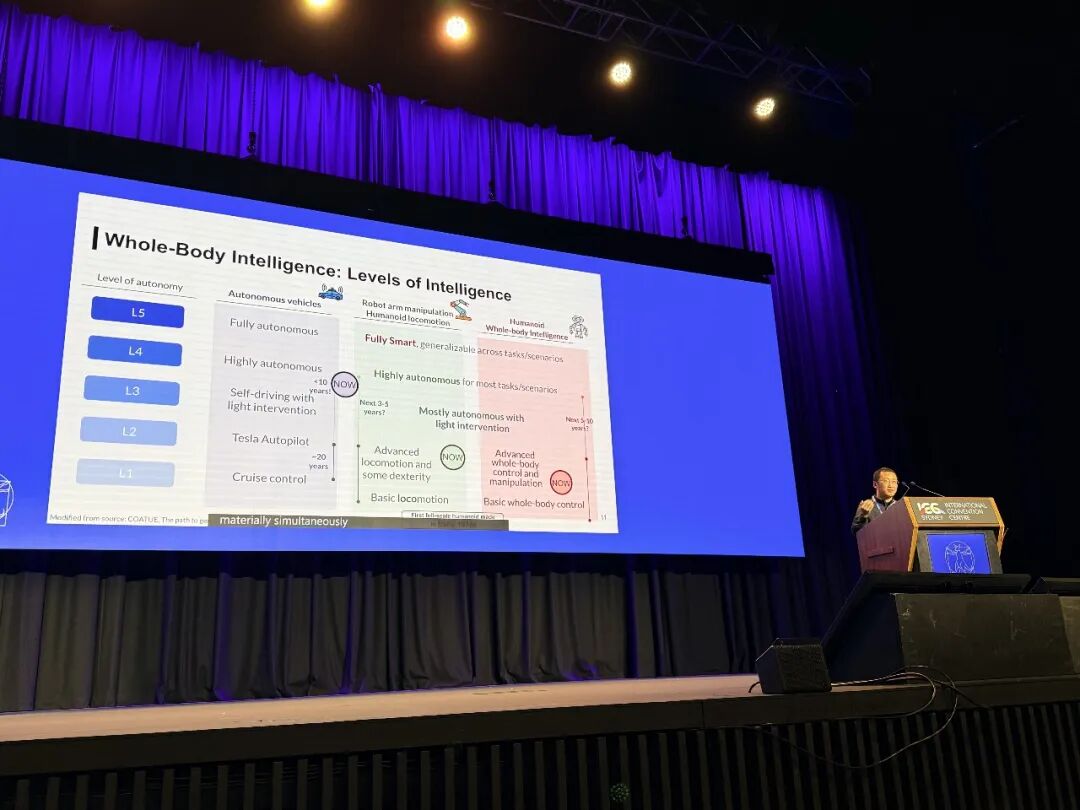
在随后的重磅演讲中,李弘扬全面阐述了从“全身控制(WBC)”向“全身智能(WBI)”演进的范式转移,并将其定义为具身智能的下一座“高山”。
01
谢谢主持人的热情介绍。其实我准备了一页背景介绍的 PPT,结果被你把词儿全念完了(笑)。
大家好,我是来自香港大学的李弘扬。我们团队的核心目标,就是通过扩大具身系统的规模,来实现具备通用性和智能化的机器人能力。
今天我的演讲主要分为三个部分:第一,为什么我们要从局部操控或单纯的全身控制,走向“全身智能(WBI)”;第二,我们在算法、数据、基准测试和硬件上面临的挑战与解决方案;第三,对未来的总结。
▎以前我们让机器人“能走、会拿”,现在我们想让它“全身一起动起来”
过去,我们看到了许多优秀的专业化能力。比如在环境里导航,或者利用具备高自由度双手的上肢进行灵巧操作,亦或是让人形机器人稳定地行走。
也有人尝试把这些任务组合起来,比如“移动+操控”的串行任务,机器人先导航走到位置,再去伸手拿东西。
但我们想做的是全身协同操控——上肢和下肢在具身智能的驱动下,同时为了一个目标去协作。
在全身智能之前,是传统的 WBC(系统 0 / 0.5),它的核心是让参考运动变得可行,关注的是物理稳定性、接触力以及实时执行。这更偏向底层的控制工程。
而我们倡导的 WBI(全身智能),它的核心是让机器人学会“行为”。它关注的是全身行为的任务理解、多机器人与多任务之间的协同、在未知环境中的泛化与恢复能力,以及持续学习的能力。
为什么要这种转变?我举几个我们在 Unitree G1 机器人上做实验的实际例子:
当 G1 去搬一辆非常重的自行车时,它不能只靠手臂,必须调动全身的力量往后拉;当它和人类并排走过一条非常狭窄的通道时,它需要侧过身子横着走;当它想拿沙发下左侧的东西时,它的右臂必须自然地撑在沙发上以防摔倒;当它要去够一个很远的目标时,它的另一只手臂必须抬起来以保持全身的质心平衡。
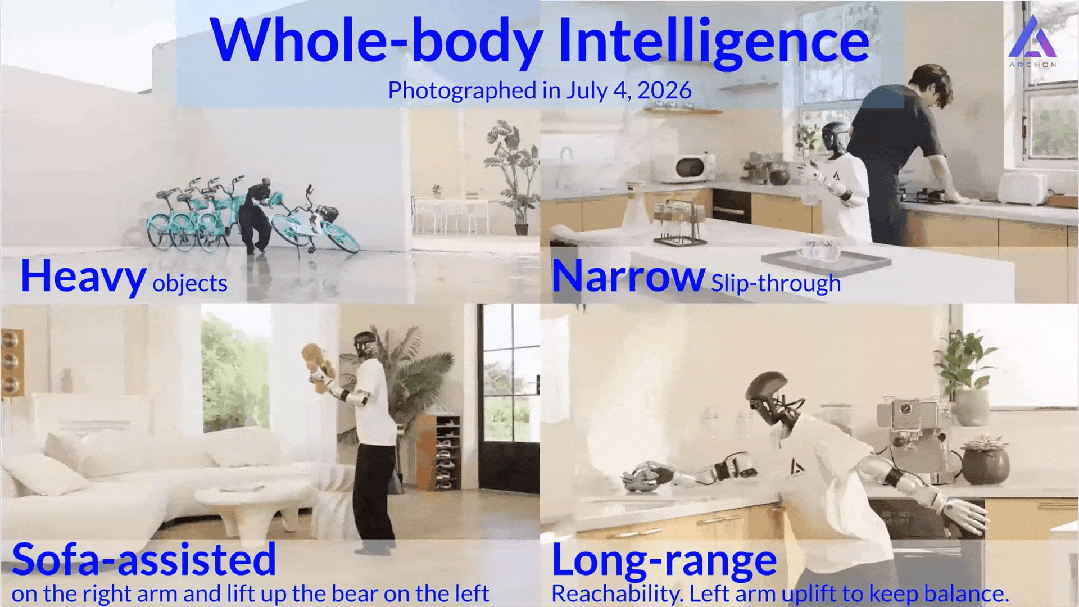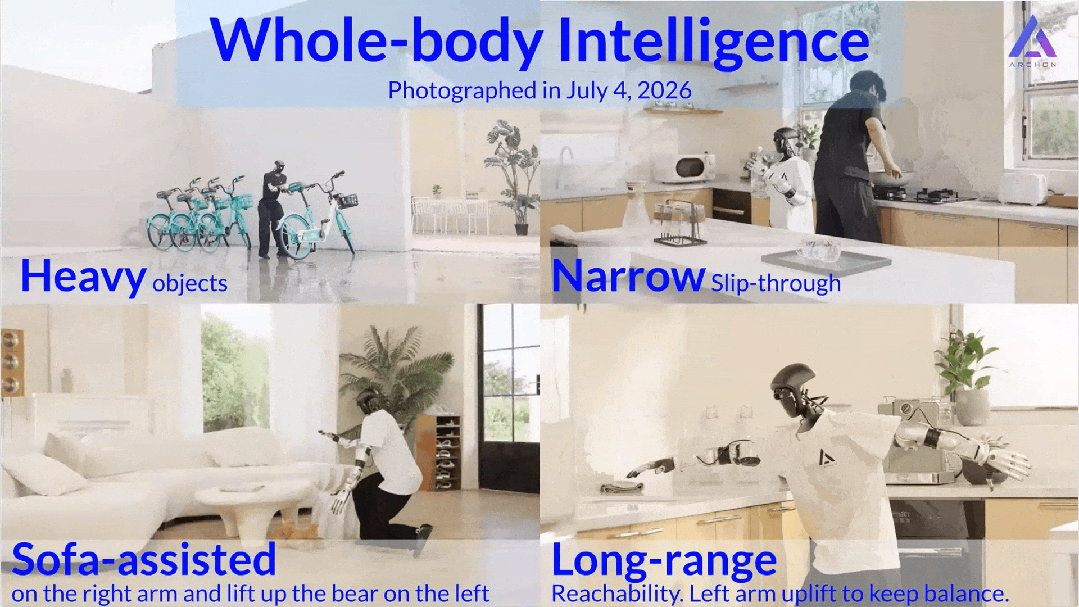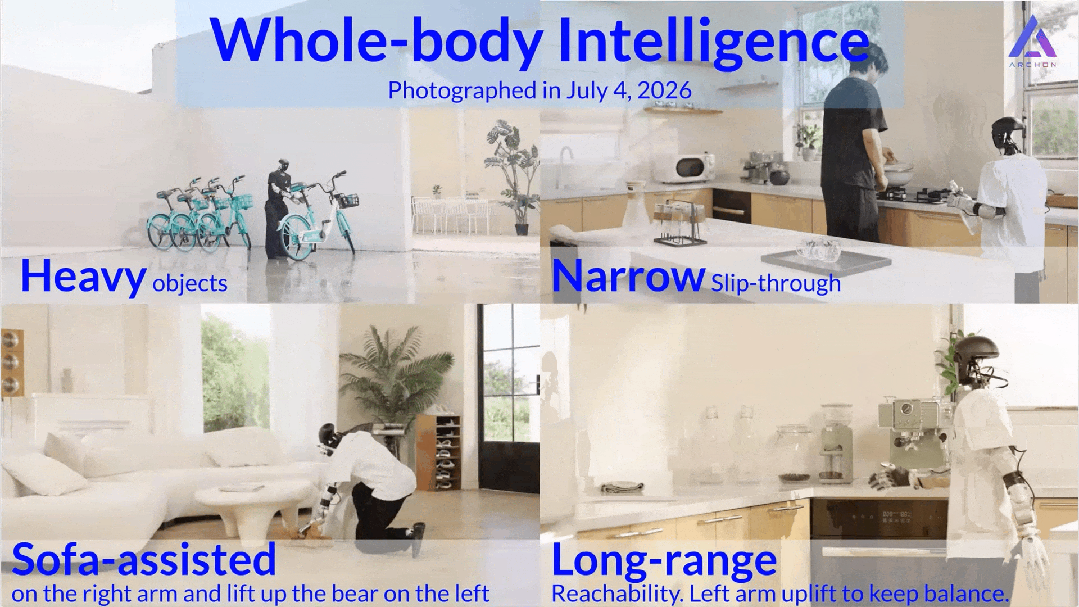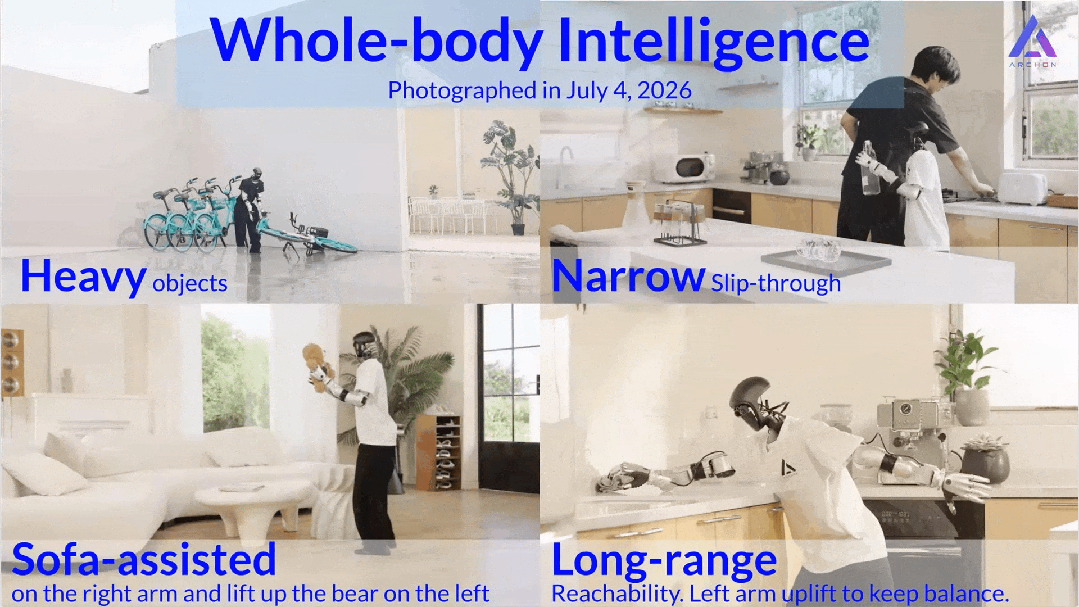
这绝对不是简单的“手臂操控 + 腿部行走(A + B)”,而是全身作为一个整体的协同。我认为,WBI 就是机器人领域下一座必须攻克的“最高山峰”。
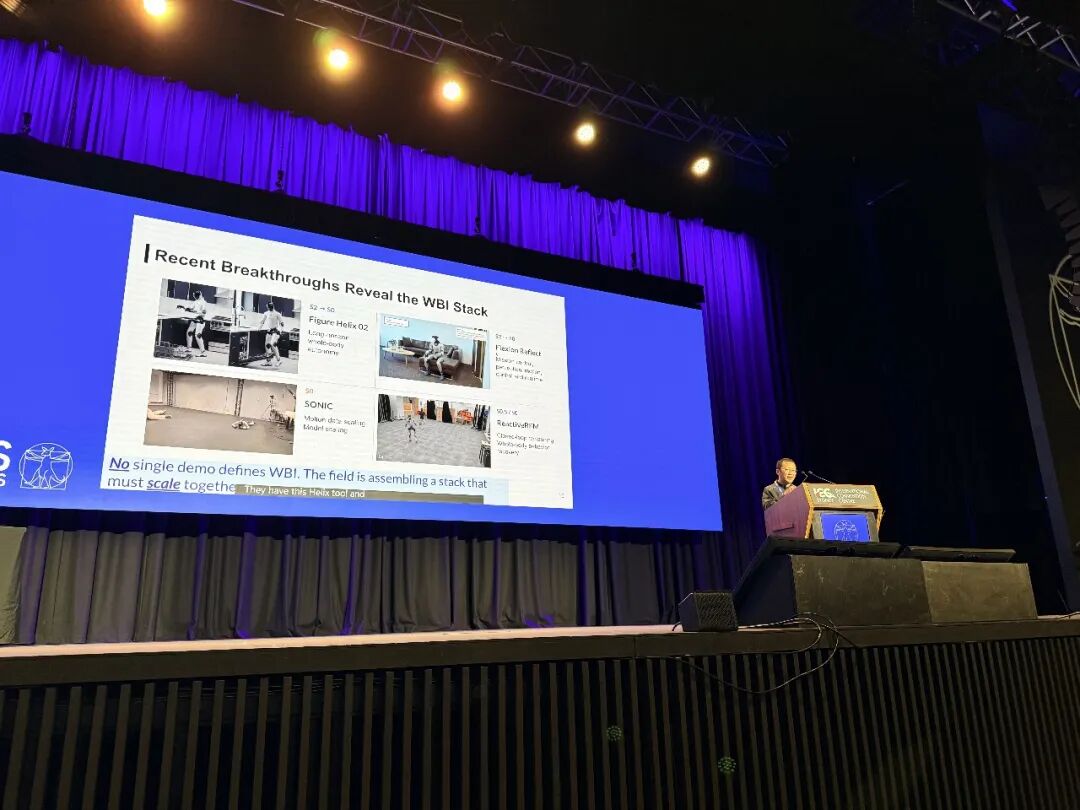
RSS 2026 演讲现场,李弘扬拆解 WBI 核心技术栈的演进路径,涵盖了从长周期全身自主到闭环反应式行为恢复等多层级突破,强调全身智能是一项系统级的宏大工程。
▎我觉得,要想实现全身智能,得给机器人装一个“超级大脑”,再配上“强壮”的身体。
为了实现这一目标,我们设计了一个预训练中心架构:
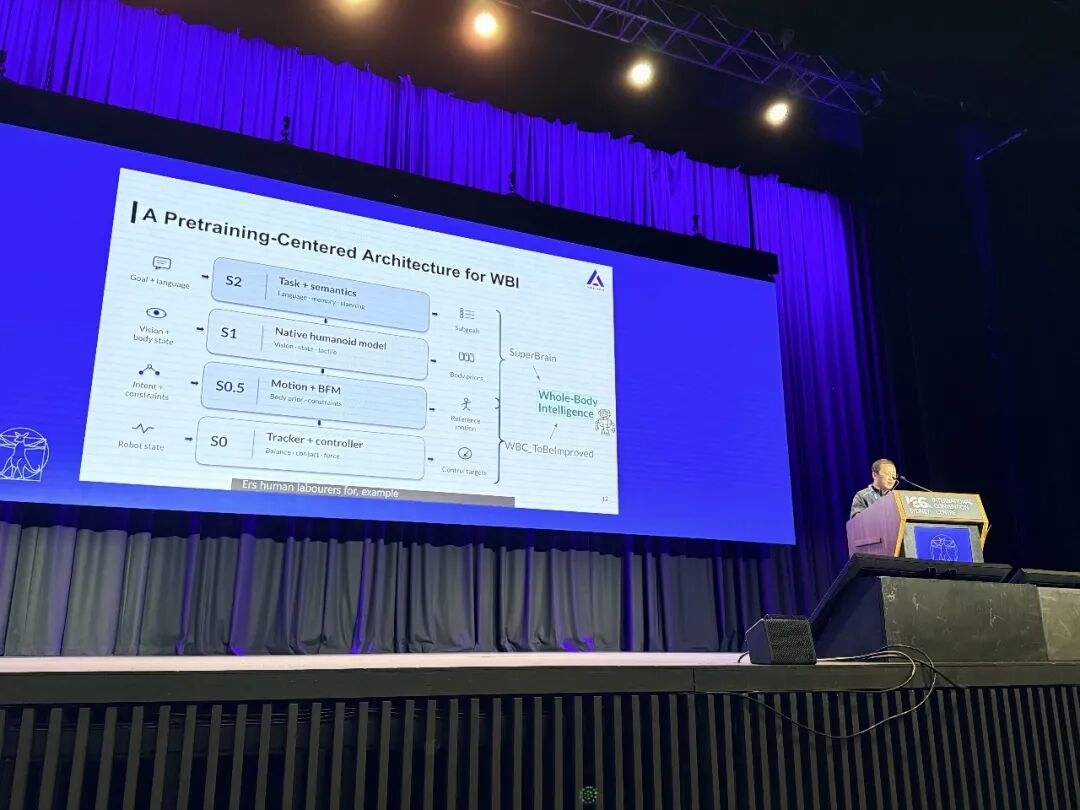
李弘扬现场讲解“以预训练为中心”的全身智能(WBI)核心架构。该架构将具身智能系统清晰划分为系统2(大模型层)、系统1(人形基础模型)、系统0.5(行为先验与约束)及系统0(底层全身控制系统)。
最顶层是“系统 2”(大模型层),负责最高层的语义、记忆和长期规划。输入的是高层语言指令,输出的是拆解后的子目标。
往下是“系统 1”(人形基础模型),这是直接从头训练的原生人形大模型,它输入视觉和身体状态,直接输出身体各部位的动作姿态。
再往下是“系统 0.5”(行为基础模型),负责提供身体先验和约束,生成参考运动。
最底层是“系统 0”(底层控制器),也就是传统的通用追踪器,确保动作的物理可行性和最终执行。
▎聊聊我们团队最近折腾出来的几件大事
围绕这个架构,我们团队在算法、数据和硬件上做了一系列努力:
首先是大规模人类机器人协同预训练。我们利用了超过 10 万小时的数据、3000 多个环境和 700 多个角色进行了大规模预训练。
我们得到的最大启发是:人类数据绝对不是具身智能的“配菜”,它就是泛化能力的核心引擎!
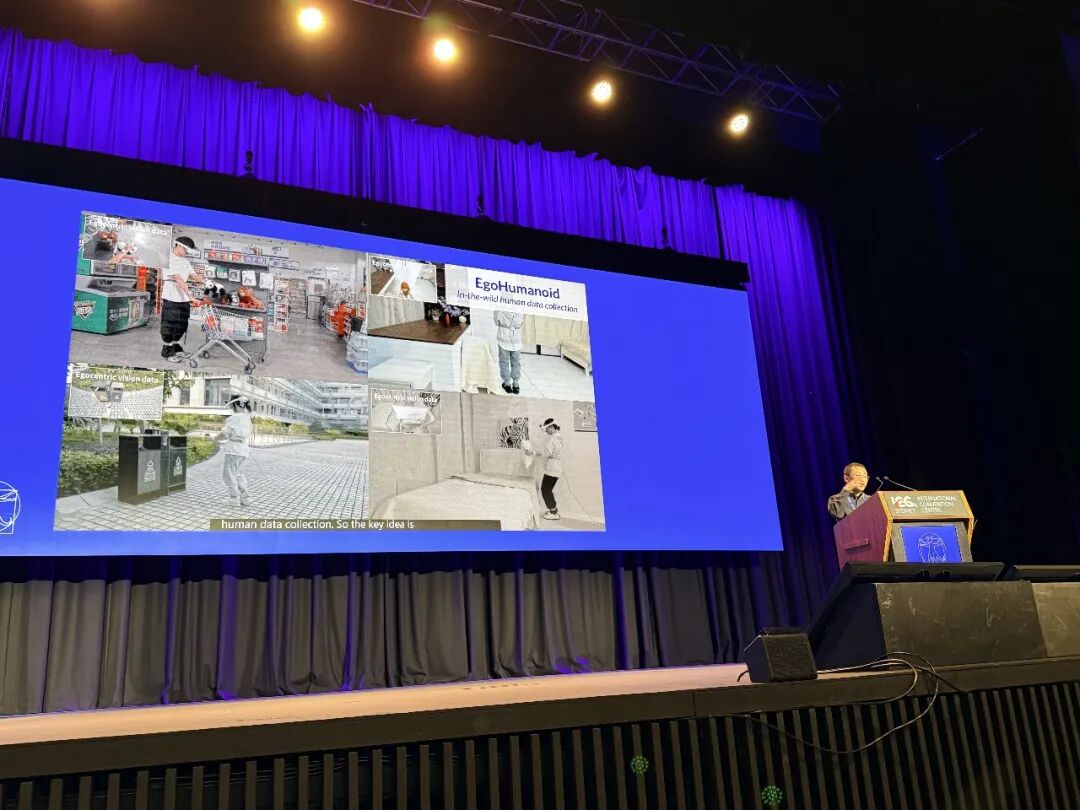
李弘扬介绍的团队的野外真实场景数据采集项目“EgoHumanoid”。该项目通过让采集人员在超市购物、户外散步、整理内务等日常场景中穿戴设备,获取了海量高质量的第一人称视角交互数据
其次是基于世界模型的强化学习后训练(RISE)。传统的物理世界强化学习太慢了,容易伤硬件,还要频繁人工重置。我们把“世界模型”引入到了后训练阶段,通过并行的大规模 Rollout(模拟产出),极大地提升了策略更新的效率和准确度。
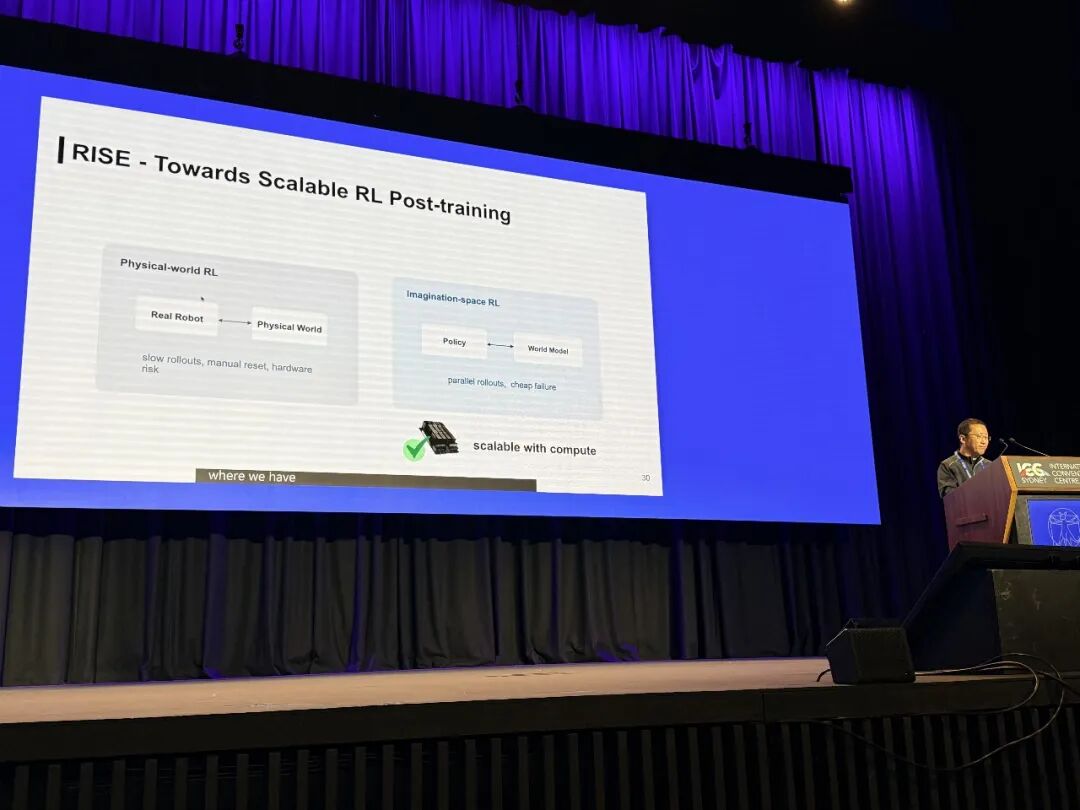
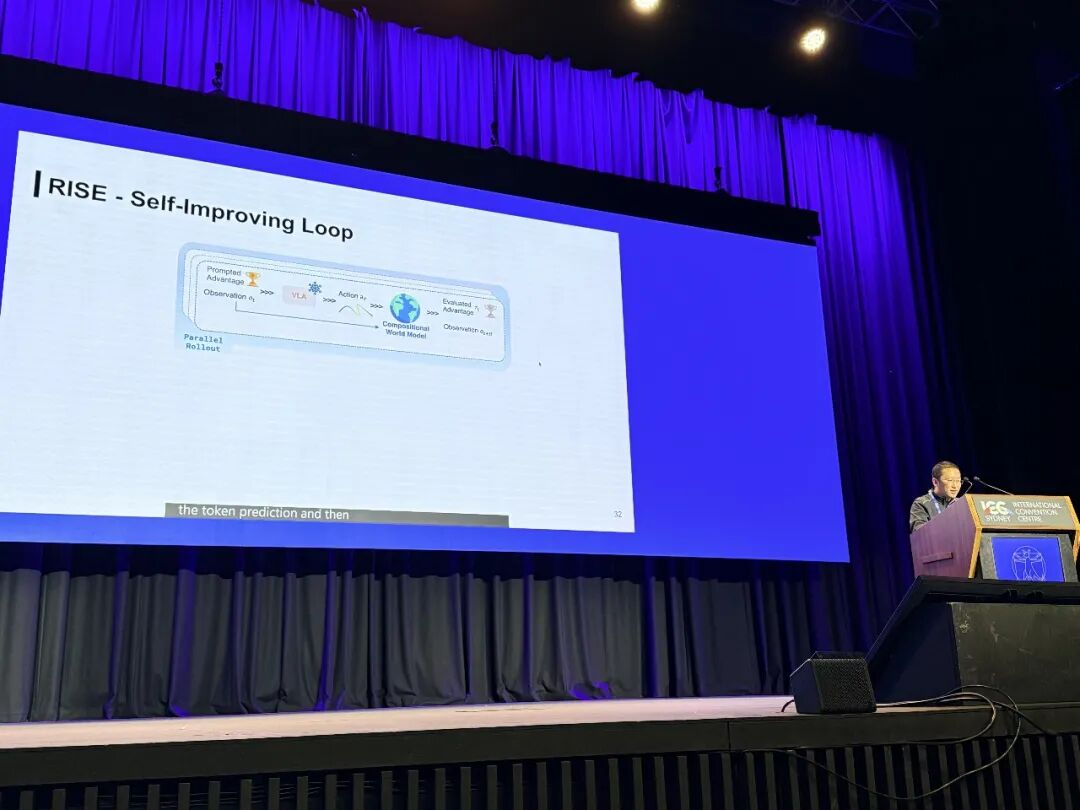
通过组合式世界模型在虚拟想象空间中进行并行大规模的 Rollout,完成了“动作生成-优势评估-策略更新”的闭环迭代
▎硬件离完美还有距离,数据的未来也有公式可循
当然,这条路还很长。即使是目前世界上部署量最大的优秀硬件,在实际测试中依然会遇到各种让人头疼的“翻车”现场:无线通信导致的丢包、关节过流保护突然瘫倒、高负荷运载时的电机过热等等。硬件离完美还有距离。
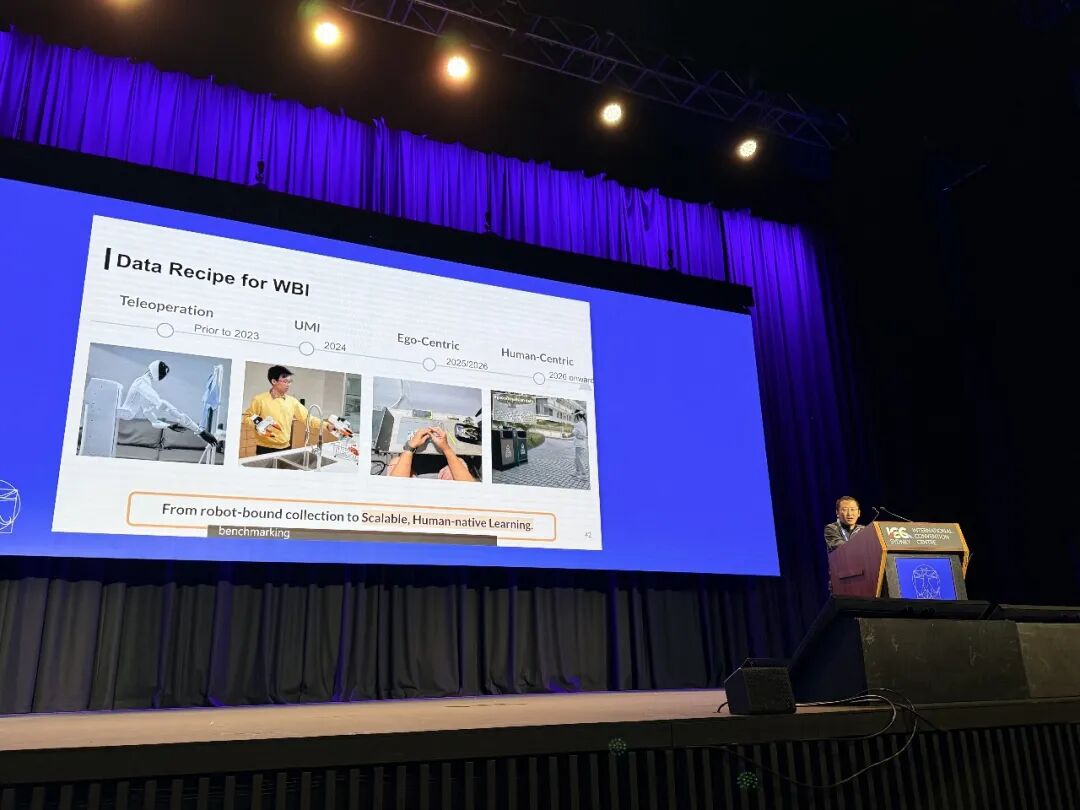
在数据配比上,我的观点是:未来人类中心的数据(Human-centric data)应该占到 80% 到 90% 的绝大多数,而机器人自身的原子技能数据占 10% 到 20%,最后再通过机器人策略进行后训练。
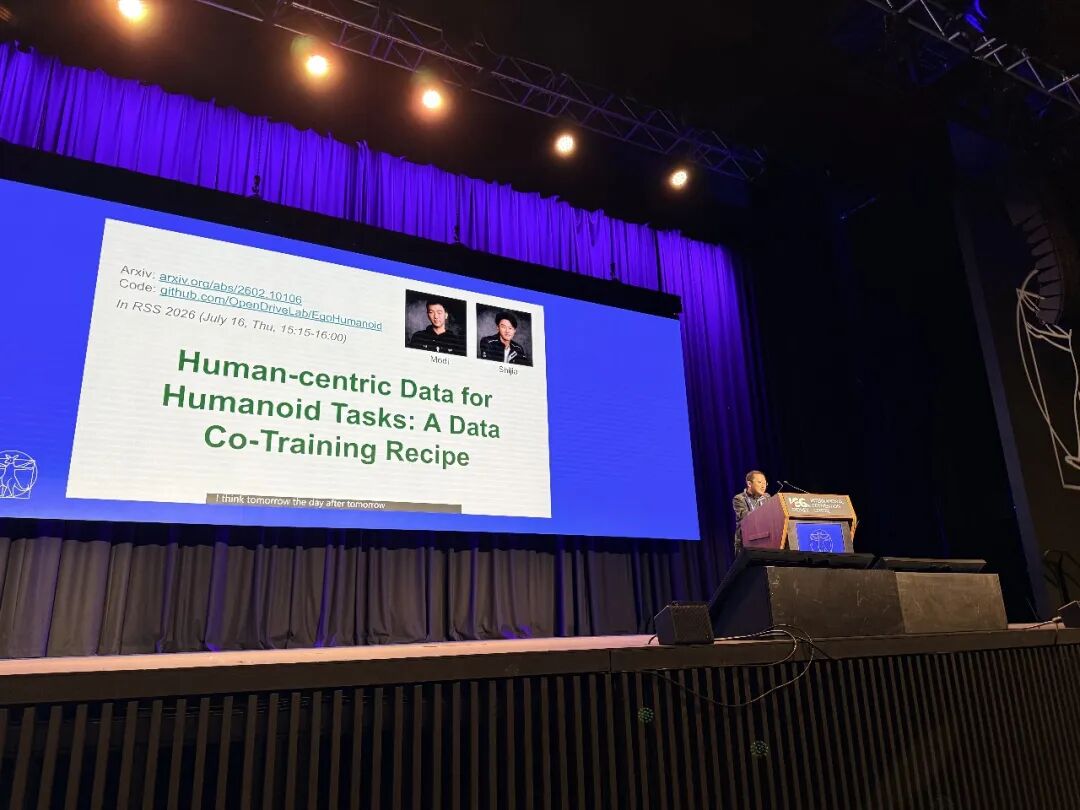
李弘扬现场发布团队关于人类原生学习的最新具体成果。该项目提出了一个创新的协同训练配方,旨在利用大规模人类中心数据直接驱动人形机器人完成复杂任务。
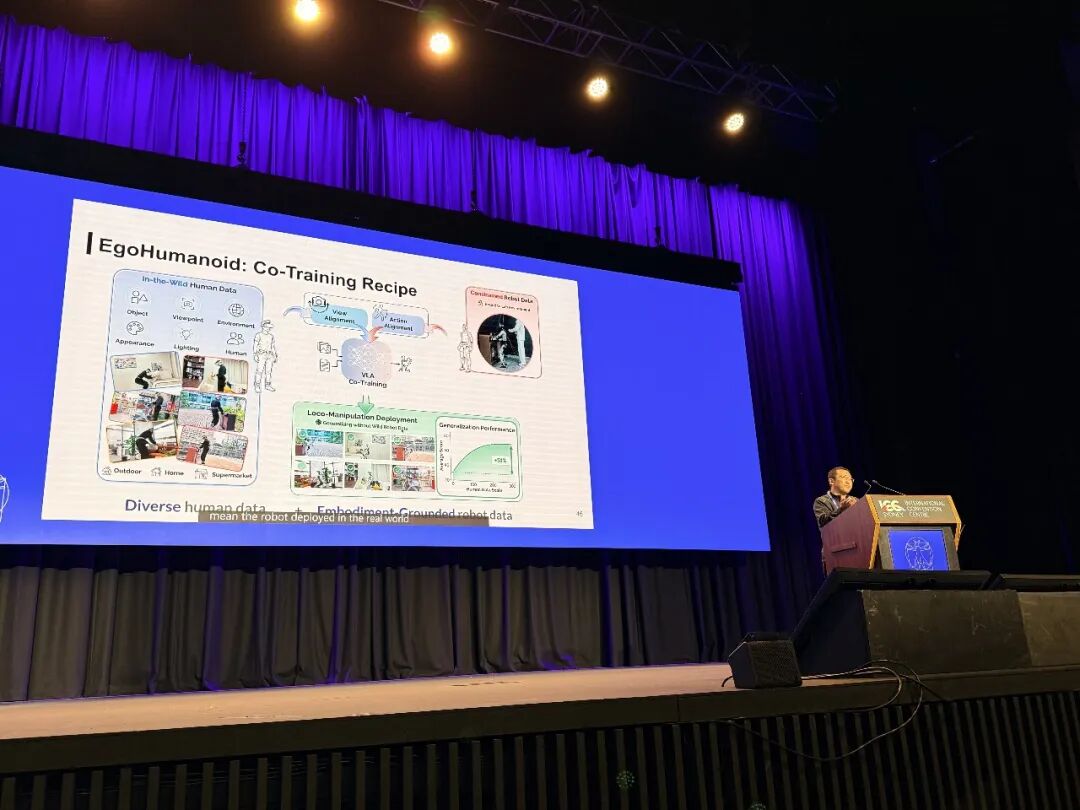
“EgoHumanoid: Co-Training Recipe”全景流程。
想要真正实现 WBI 的全面爆发,我们不妨大胆预测一下公式:大概需要一个 100 亿参数(10B)的模型,超过 10 万小时(100K hours)的高质量人类数据,以及至少 500 到 1000 张 H200 级别的 GPU。
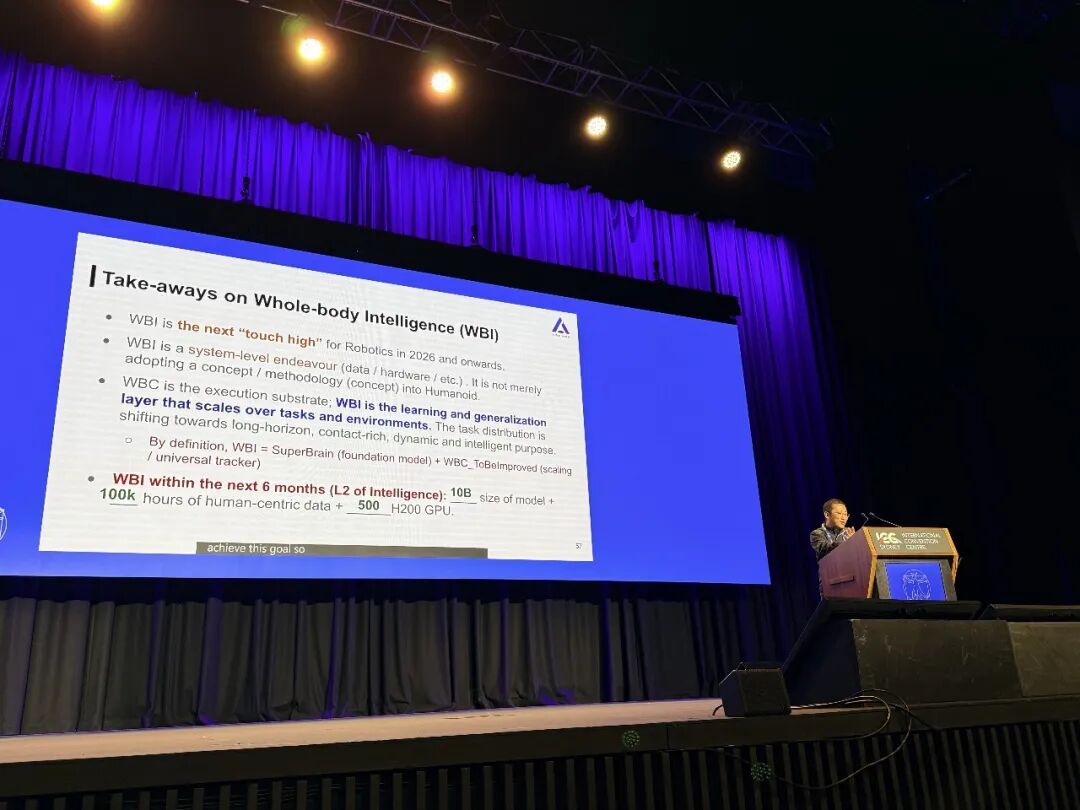
这是一个系统级别的宏大工程,但我相信这一天很快就会到来。
谢谢大家!
02
▎Q1(现场观众): 你提到持续改进(Continuous Improvement)是全身智能(WBI)的四大核心之一。你能详细讲讲持续学习(Continuous Learning)或者终身学习在你的架构里扮演什么角色吗?
李弘扬:谢谢。我们这里强调的持续学习,更侧重于物理世界中的“闭环反馈”。比如当机器人被部署到一个全新的环境,或者面对某些失败任务时,它会从环境获得负反馈或负面奖励(Negative Reward)。通过不断收集这些新环境下的交互数据并反哺模型,让模型产生自我迭代。这跟纯机器学习领域定义的持续学习会稍微有一点点概念上的不同,它更强调具身交互的闭环。
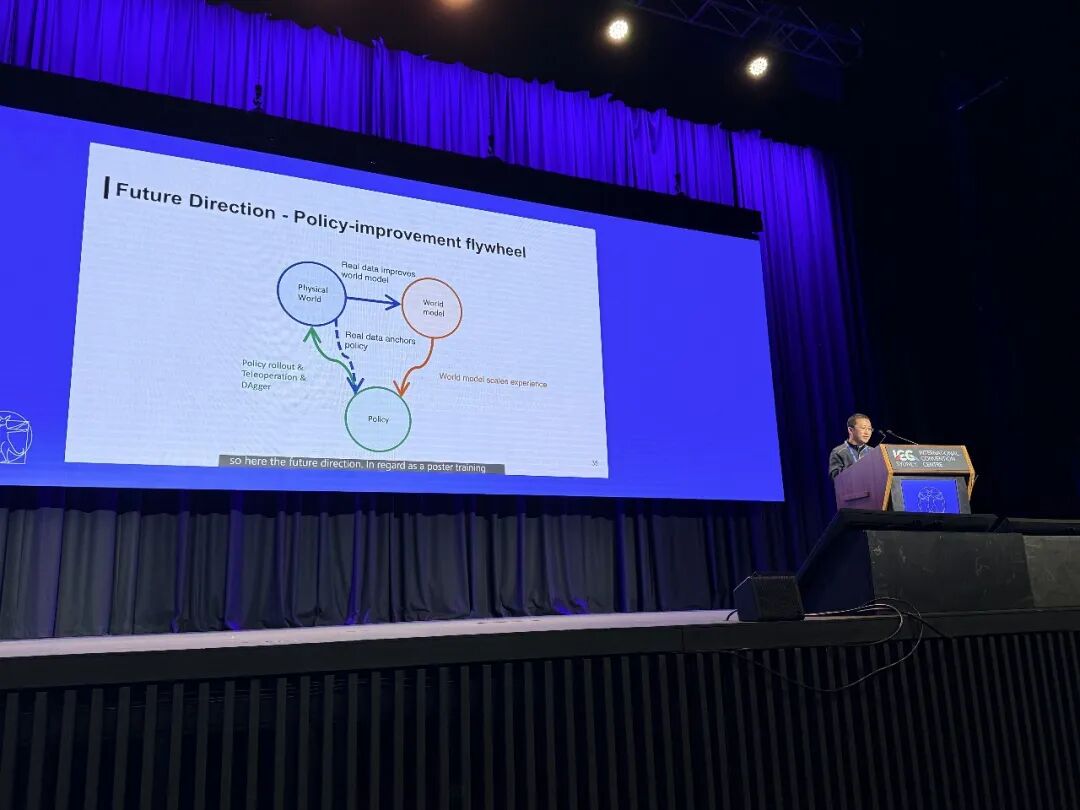
▎Q2(现场观众): 大家都知道数据非常关键。那你认为我们是应该花大力气去采集足够多的真实世界数据,还是去开发一个极度逼真的超写实仿真环境,直接在里面做廉价的强化学习?
李弘扬:这问得很直接。我认为目前获取有效数据最快的方式,是基于现有的开源数据和社区协作(比如 Hugging Face 上的优质数据集)。至于仿真环境(Simulation),我认为它在训练底层的运动控制器(下肢行走、平衡等)时非常有效且成本低廉。但是,如果你想去 scale up(扩大)机器人的高级大脑(系统 1 和系统 2),去理解复杂的语义和千变万化的任务场景,仿真环境现在能提供的价值还非常有限,我们必须依赖真实世界的数据。
▎Q3(现场观众): 如果我们直接把现有的视觉大模型或者多模态大模型,接入到一个更大的动作空间里,是否能直接驱动全身智能?我们有必要去采集专门的全身数据吗?
李弘扬:正如我前面提到的,全身智能绝不是“手臂数据 + 腿部数据”的简单拼接(A + B)。当机器人要完成很多全身协同的任务时,它需要两条腿作为支撑,同时手臂去发力,这需要全身的动力学在一瞬间进行完美的交织。现有的局部数据或者单纯的视觉大模型没有这种全身协同的先验。因此,搭建一套能够采集整个人体/机器人全身传感器(包括机载相机、IMU 等)的数据流水线,是实现真正全身智能的基础,这也是视觉大模型替代不了的。
一个人读论文太孤单,一群人刷顶会才好玩。
RSS 2026召开在即,我们正在召集一波含金量极高的 AI 研究者。群内主打实时论文跟踪与硬核技术探讨,拒绝灌水。
? 进群传送门:扫码进群或添加微信Luyoyo_2026,备注:论文群 + 关注的 AI 方向。
搞科研/搞技术,信息差很重要。
来,一起快人一步!
上车,带你看遍全球 AI 顶会精华
可独家畅览:
专家演讲PPT
大会报告全文
热门论文解读
学术新星访谈
扫描上方二维码
或点击「阅读原文」关注专区。
