


来源:公众号|复杂网络课题组
近日,课题组唐伟老师以第一作者身份在机器学习顶会ICML 2026上发表研究论文《Artemis: Structured Visual Reasoning for Perception Policy Learning》。
近年来,多模态大语言模型(MLLMs)在视觉问答、图像描述和跨模态理解等任务中取得了显著进展。然而,现有模型大多依赖自然语言形式的思维链进行推理,其推理过程主要发生在语言空间而非视觉空间。在目标定位、目标检测、视觉计数以及数学图形理解等需要精确视觉感知的任务中,模型虽然能够生成看似合理的解释,却经常出现目标定位偏差、对象遗漏以及数量统计错误等问题。这表明当前多模态模型缺乏与视觉事实紧密对齐的中间推理过程,限制了其视觉感知能力与跨任务泛化能力的进一步提升。
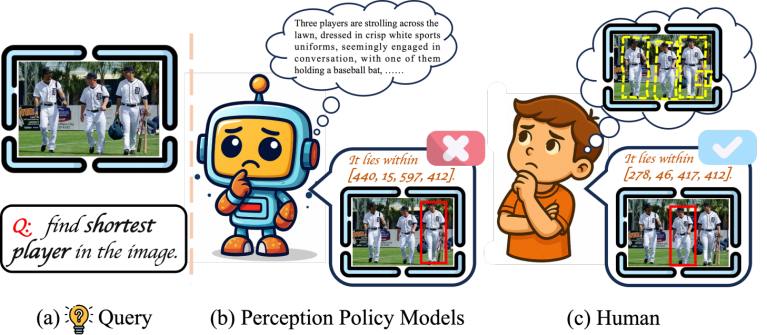
已有研究尝试利用强化学习提升多模态模型的推理能力,并取得了一定成效。然而,现有方法大多沿用语言推理链作为中间思考过程,难以对推理步骤进行有效监督和验证。同时,自然语言推理与视觉感知任务之间存在固有差异,语言描述往往难以准确表达目标的空间位置和视觉关系,容易导致推理过程与真实视觉信息脱节。受到人类视觉认知机制的启发,研究团队认为视觉感知任务中的推理应当直接发生在视觉空间中,而非依赖语言空间的间接表达。因此,如何构建一种可验证、可监督且与视觉事实紧密关联的推理机制,成为提升多模态模型视觉感知能力的关键问题。
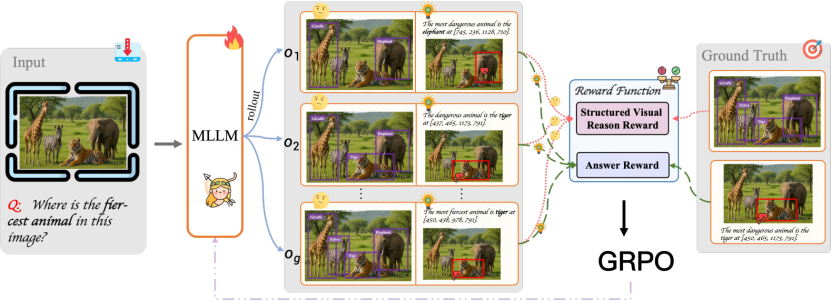
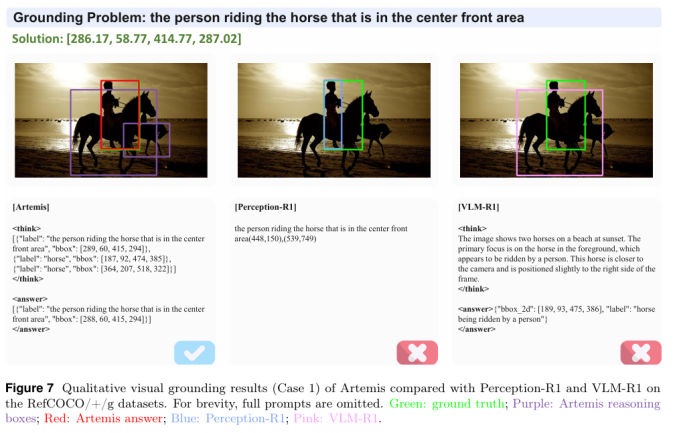
针对上述问题,研究团队提出了Artemis框架,通过结构化视觉推理实现视觉感知策略学习。在该框架中,模型在推理阶段不再生成自然语言形式的思维链,而是输出由目标类别和边界框坐标组成的结构化视觉证据序列。通过这种方式,模型需要在回答问题之前显式关注与任务相关的目标及其空间位置,使中间推理过程能够直接与真实标注进行匹配和验证。
在训练过程中,Artemis基于GRPO强化学习算法构建统一优化框架,并设计了由格式奖励、答案奖励和结构化视觉推理奖励组成的奖励机制。其中,结构化视觉推理奖励通过评估中间视觉证据与真实标注之间的一致性,引导模型学习更加准确的视觉感知策略;格式奖励用于约束输出结构;答案奖励则负责监督最终任务结果。通过联合优化推理过程和最终答案,模型逐步形成面向视觉空间的感知与决策能力。
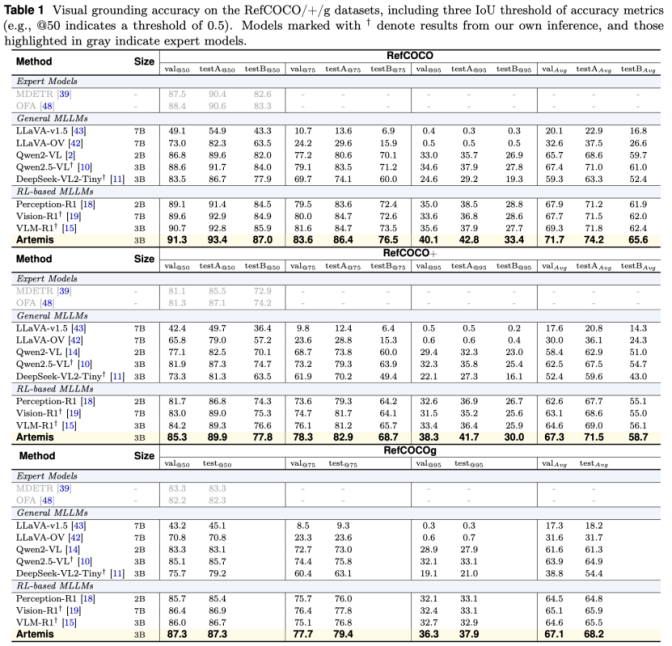
研究结果在7个域内和域外数据集以及10个MLLM通用能力评估数据集上都显示出了强大的性能和泛化能力。
在COCO 2017目标检测任务中,Artemis取得31.0 mAP的检测性能,成为首个在3B参数规模下突破30 mAP的统一强化学习视觉感知模型。相比仅针对目标检测任务进行优化的方法,Artemis在保持检测性能的同时展现出更强的任务通用性。
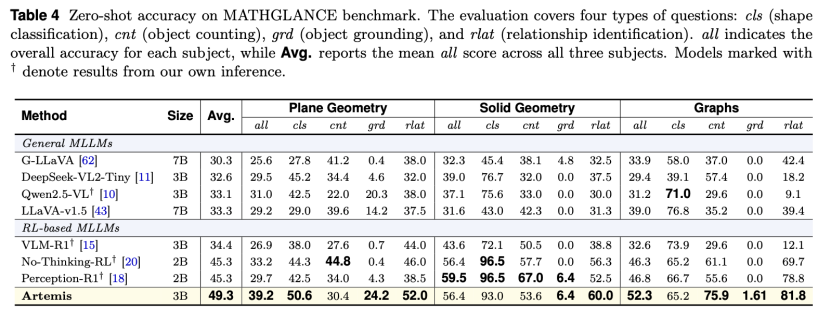
此外,在未参与训练的视觉计数和数学图形理解任务上,Artemis同样展现出优异的零样本泛化能力。在MATHGLANCE基准测试中,Artemis取得49.3%的准确率,显著优于多个主流多模态模型和强化学习模型。实验进一步证明,结构化视觉推理不仅能够提升模型的视觉感知能力,还能够促进模型学习更加通用的视觉表征,从而实现跨任务、跨领域的有效迁移。
该研究提出了一种基于结构化视觉推理的统一感知策略学习框架Artemis,通过将推理过程从语言空间转移到视觉空间,实现了对视觉感知过程的显式建模与强化学习优化。实验结果表明,结构化视觉推理能够有效提升多模态模型在目标定位、目标检测、视觉计数和数学图形理解等任务上的性能,同时增强模型的跨域泛化能力。该研究为多模态大模型视觉感知能力提升提供了新的研究思路,也为未来构建更加可信、可解释的视觉推理系统奠定了基础。
据悉,ICML会议由国际机器学习学会主办,是机器学习理论、算法与统计方法领域的国际核心学术会议,在中国计算机学会(CCF)推荐目录中列为A类。从近年的投稿数据来看,该会议竞争态势持续加剧:近三年有效投稿量普遍在5000至7500篇之间,录用率在22%至25%间,对论文的理论深度与实验复现性提出了极高要求。
原文链接: https://www.leiphone.com/category/private/N1EYaJpX9TCaI8vN.html
