


来源:CVer
原文链接:https://mp\.weixin\.qq\.com/s/rjzsndtcb6XkAnE5oGJHQA
European Conference on Computer Vision(简称 ECCV,欧洲计算机视觉国际会议),两年一次,是计算机视觉三大顶会之一。ECCV 2026 将于 2026 年 9 月 8 日至 12 日在瑞典马尔默举办。
Colab在本次会议中共入选三篇论文。
- 1 -
**
**
Beyond 2D Matching: A Unified Single-Stage Framework for Geometry-Aware Cross-View Object Geo-Localization
**
**
作者:Liyao Wang, Ruipu Wu, Haojun Xu, Lei Shi, Linjiang Huang, Si Liu
论文简介:
随着无人机导航、灾害监测和空间智能等应用的发展,跨视角目标地理定位逐渐成为视觉定位领域的重要任务,其目标是在地面或无人机视角中指定目标,并在卫星视角中完成精确定位与分割。然而,现有方法大多依赖二维外观匹配,难以应对极端视角差异、尺度变化、遮挡以及重复纹理等问题;同时,已有数据集普遍存在规模有限、提示形式单一、缺少相机位姿与几何监督等不足,限制了模型的空间理解与泛化能力。
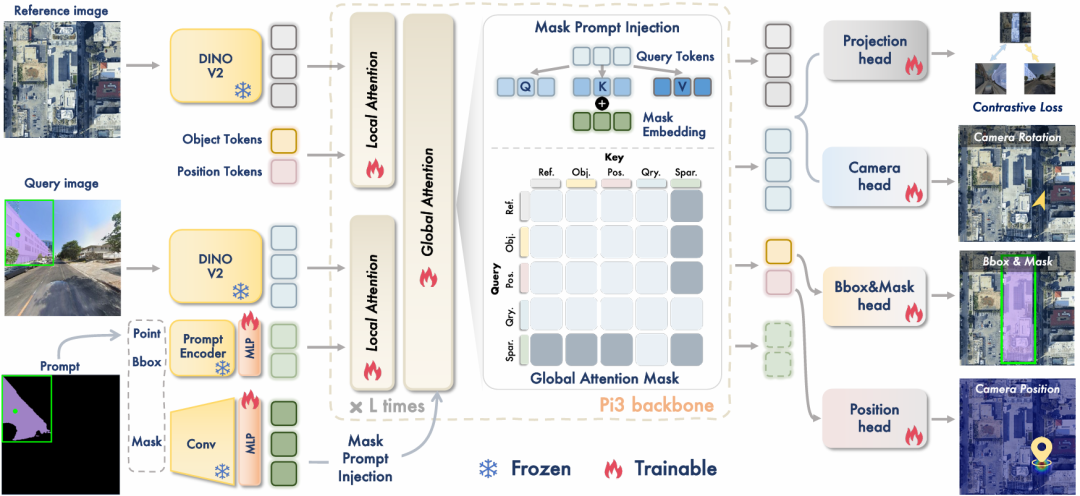
为此,本文构建了大规模跨视角建筑定位数据集 CMA-Loc,提供地面—卫星、无人机—卫星等多种视角组合,并包含点、框、掩码等多模态提示以及相机位姿信息,为几何感知的跨视角目标定位提供数据支撑。进一步地,本文提出 GAGeo,一种统一的单阶段几何感知跨视角地理定位框架,通过引入三维基础模型的几何先验,将视觉特征、目标提示和任务 token 融合到同一 Transformer 结构中,实现目标检测、实例分割和相机位姿估计的联合预测。实验表明,GAGeo 在无人机到卫星、地面到卫星以及地面到无人机等设置下均显著优于现有方法,验证了几何先验与单阶段多任务建模在跨视角目标地理定位中的有效性。
** - 2 - **
**
**
Generative Lane Topology Reasoning via Autoregressive Model with Geometry Prior
作者:Jiahui Fu, Zehao Huang, Han Li, Naiyan Wang, Si Liu
**
**
论文简介:
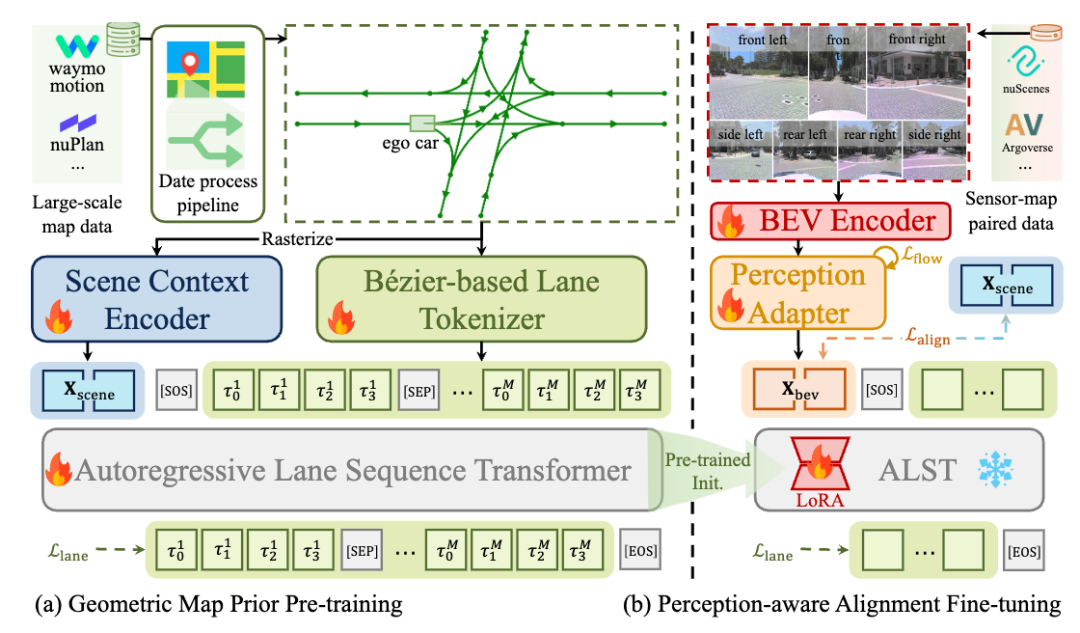
车道拓扑推理旨在根据车载传感器观测构建完整且几何一致的车道图。现有方法大多对车道实例进行独立建模,因而容易导致相连车道端点的几何不一致,并在视觉遮挡场景下产生结构不完整的车道图。为此,我们提出 TopoGPT,一种基于生成式建模的车道拓扑推理框架,通过自回归序列建模学习典型车道图的几何结构先验。具体而言,我们构建大规模地图数据集,并设计车道 Tokenizer 将车道图序列化为离散 Token,同时利用场景上下文编码器提取全局场景条件,对自回归车道序列 Transformer 进行场景条件预训练,使模型具备车道图几何结构建模能力。在此基础上,进一步设计感知适配器,将多视角图像提取的鸟瞰图特征与预训练场景条件对齐,实现几何先验向基于传感器的车道图预测任务迁移。实验结果表明TopoGPT能够生成几何一致、结构完整的车道拓扑图。
- 3 -
**
**
SVCBench: A Streaming Video Counting Benchmark for Spatial-Temporal State Maintenance
作者:Pengyiang Liu, Zhongyue Shi, Zitian Wang, Linjiang Huang, Si Liu
**
**
论文简介:
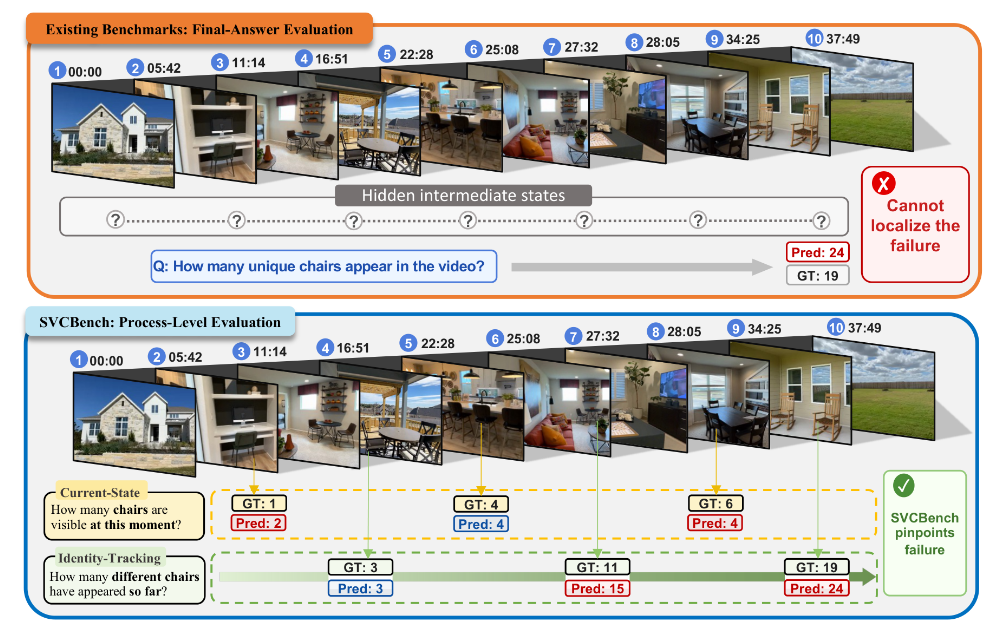
视频理解要求模型在播放过程中持续追踪并更新世界状态,例如当前可见目标的数量、迄今出现过的不同个体数,以及某类事件发生的次数。然而现有视频理解基准大多只评判视频结束后的最终答案,难以观测模型如何随时间维护这些状态,也无法定位失败发生的具体时刻与原因。
本文提出 SVCBench,首个将计数重新定位为状态维护最小探针、面向流式长视频的评测基准。计数具有客观可验证的标准答案,且难以依靠语义识别或语言先验蒙混,因而适合作为诊断入口。该工作沿物体计数与事件计数两个维度,将状态维护系统拆解为 8 个细粒度子类(涵盖当前可见数量、跨时累计身份、瞬时动作与完整动作周期等),并采用流式多点提问的方式观测模型的完整预测轨迹,配套 GPA(数值精度)、MoC(轨迹单调一致性)与 UDA(更新时机)三项互补指标。基准共包含 406 个视频、逐帧标注的 10071 个事件与状态变化、1000 道计数问题与 4576 个查询点。
在主流视频理解模型上的系统评测显示,当前模型在时空状态维护上仍存在显著短板:人类整体得分约 96,最强模型仅约 37;在完整动作周期计数任务上人类达到 93.2,模型却几乎全部低于 4 分。对照实验进一步表明,仅在画面角落叠加显式计数提示,即可将该子类成绩从 3.9 提升至 81.8(约 21 倍),说明模型已具备数值累加的推理能力,真正的瓶颈在于从视觉输入中识别周期边界的视觉-时间对齐。SVCBench 为衡量与改进视频模型的状态维护能力提供了可量化、可定位的诊断框架。
本文系学术转载,如有侵权,请联系CVer小助手删文
原文链接: https://www.leiphone.com/category/private/TSsmPEViCkU2Zril.html
