来源:公众号“AI上分搭子
原文链接:https://mp.weixin.qq.com/s/6VviwXMsnFYLQHkVKMUZ3w
LILA 盯的是一个很基础、但常常被绕开的点:
视觉 foundation model 很强,但很多输出仍然是 patch-level feature。
做分类、检索,patch feature 很够用。
但做 video object segmentation、surface normal、semantic segmentation,就会卡在更细的地方:
边界、几何、跨帧一致性。
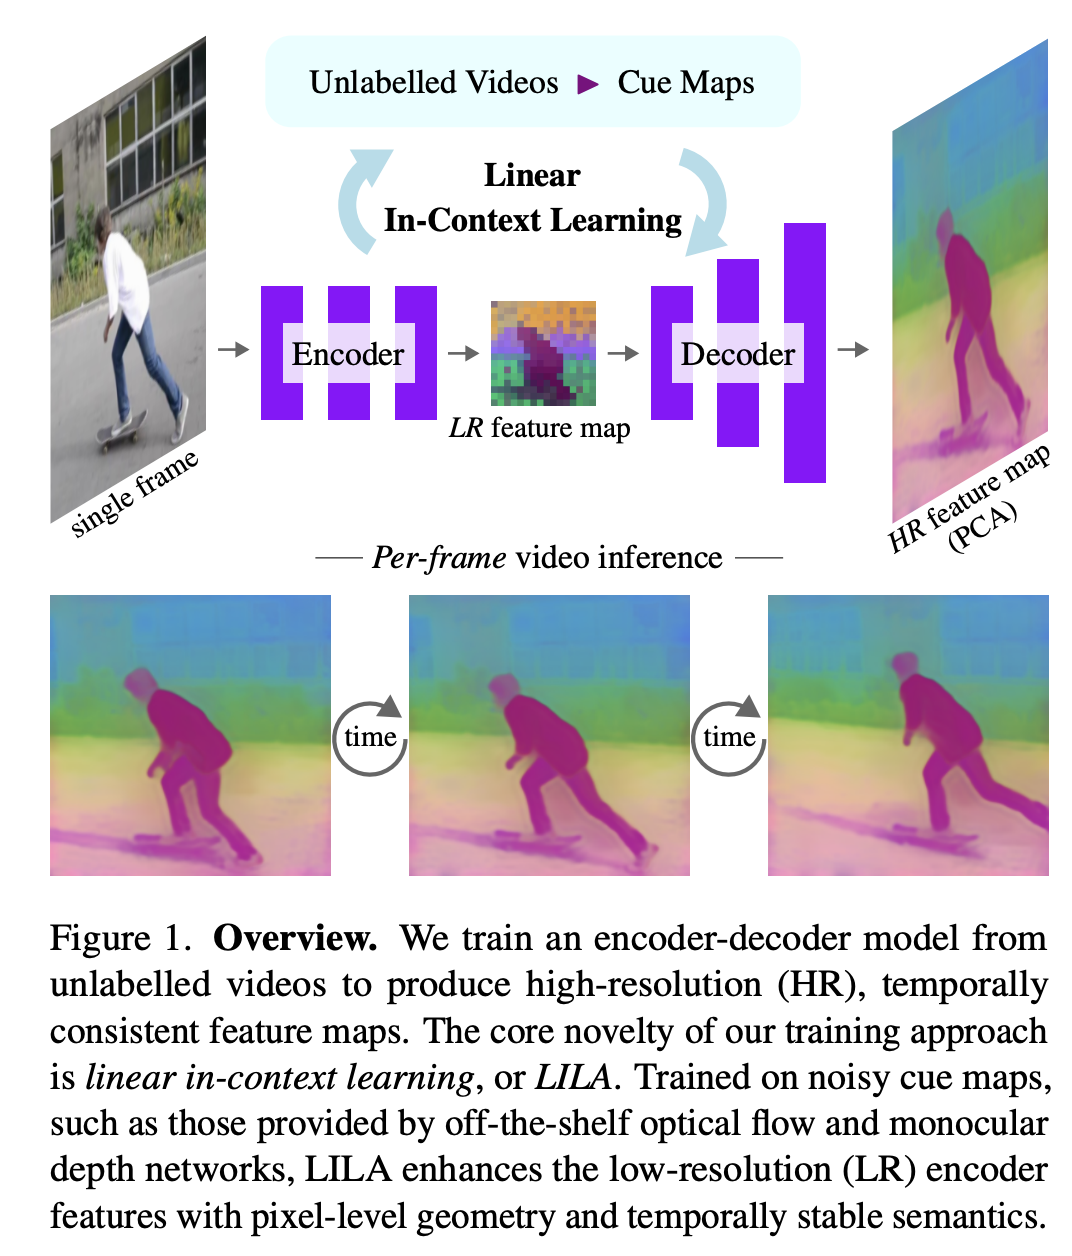
LILA 的办法是从未标注视频里学 pixel-level feature。
它不需要人工 mask。
也不要求推理时输入视频。
训练时,它借用 off-the-shelf 模型给出的 depth、optical flow,再加上 self-distillation cue。
核心机制叫linear in-context learning。
简单说:
在一帧上学到的“从特征读出 cue 的线性规则”,换到相邻帧也应该成立。
先看几组数字:
DINOv2、DINOv3 这类视觉 foundation model 已经很强。
它们的特征里有语义,也有不少几何信息。
问题在于,很多 encoder 的输出仍然是 patch grid。
一个 patch 里有很多像素。
当任务需要细边界、局部几何、跨帧对应时,patch-level feature 就有点粗。
当然,也可以把输入图像放大,或者用后处理方法上采样 feature。
但这会带来两个麻烦:
LILA 的目标更直接:
让模型天然输出每个像素一个 feature。
而且这个 feature 不只是“看起来更细”。
它还要带有三类信息:
视频在这里就派上用场了。
视频天然有运动,也隐含 3D 几何。
如果能把这些线索转成训练信号,就有机会补上 image-only pretraining 缺少的部分。
LILA 用了 depth 和 optical flow。
但它并不是简单训练模型去预测 depth 和 flow。
这点要先说清楚。
因为这些 cue 本身有噪声。
off-the-shelf depth / flow 模型在很多视频上能用,但不可能每个像素都准。
如果直接把 noisy cue 当答案蒸馏,模型很容易连噪声一起学进去。
LILA 换了一个问法:
如果一帧里的 feature 真的学到了稳定结构,那么从这帧 feature 到 cue map 的线性映射,换到相邻帧也应该还能用。
这就是linear in-context learning。
它学的不是 depth 或 flow 本身。
它学的是一种 pixel feature:
同一个线性读出器,在相邻帧里也能解释它。
约束很轻,但视频里的时间一致性被用进来了。
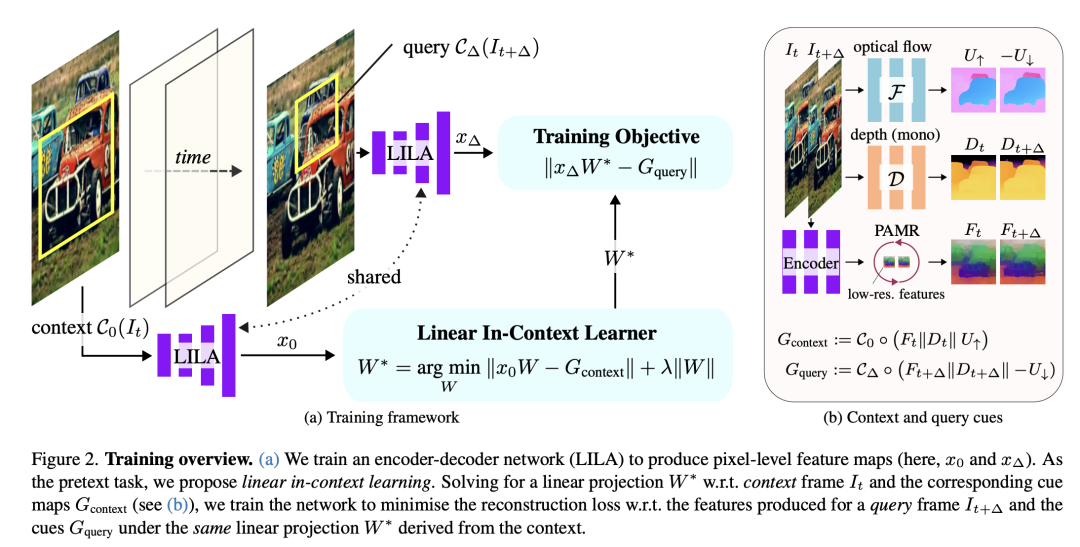
LILA 从一个预训练 ViT 出发,比如 DINOv2。
encoder 冻住。
只训练一个 DPT decoder。
这个 decoder 通过 skip connections,把 patch-level token 上采样成 pixel-level feature map。
训练时,每次取一对相邻帧:
模型分别输出:
监督信号来自三类 cue:
cue map 的构造可以写成:
这里的和是对应 crop。
是 refine 后的 encoder feature,是 depth,是 optical flow。
接着,在 context frame 上求一个线性映射:
然后要求同一个也能解释 query frame:
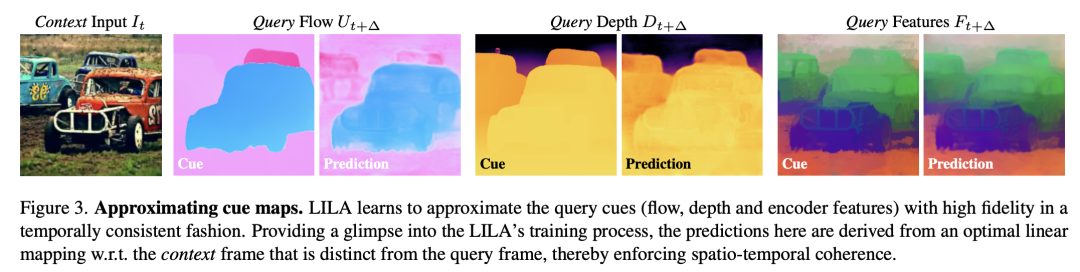
换个更直观的说法:
context frame 先给出一个“小考题”:
这个 feature 里能不能线性读出 depth、motion 和 encoder cue?
query frame 接着验证:
同一套读出规则,换一帧还成立吗?
如果成立,说明 feature 里学到的不是单帧噪声,而是更稳定的时空结构。
主结果覆盖三个方向:
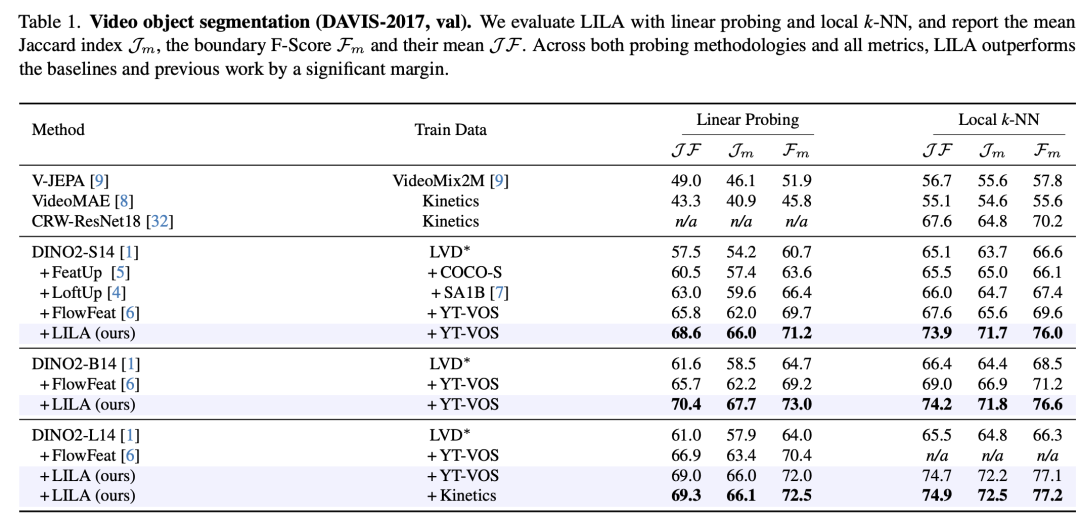
在 DINOv2-S14 上:
LILA 的优势不只是 linear probe。
local k-NN 也明显提高。
这说明它不只是让类别更容易线性读出来,也让跨帧像素匹配更稳。
DINOv2-B14 上,LILA 也超过 FlowFeat:
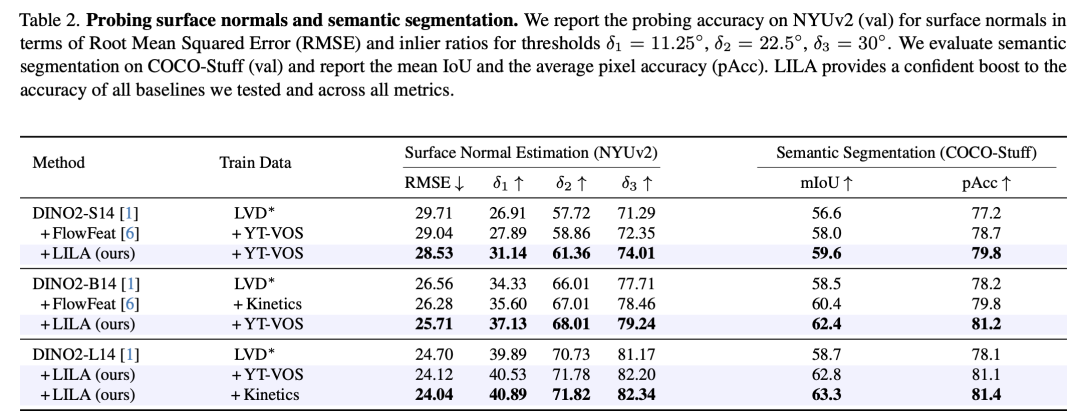
Table 2 说明,LILA 并不是只为 VOS 调出来的。
在 surface normal estimation 上,RMSE 越低越好:
COCO-Stuff 上,mIoU 越高越好:
DINOv2-L14 + Kinetics 这一行也值得看。
LILA 的 COCO-Stuff mIoU 到63.3。
这说明扩大视频数据后,语义表征还能继续涨。
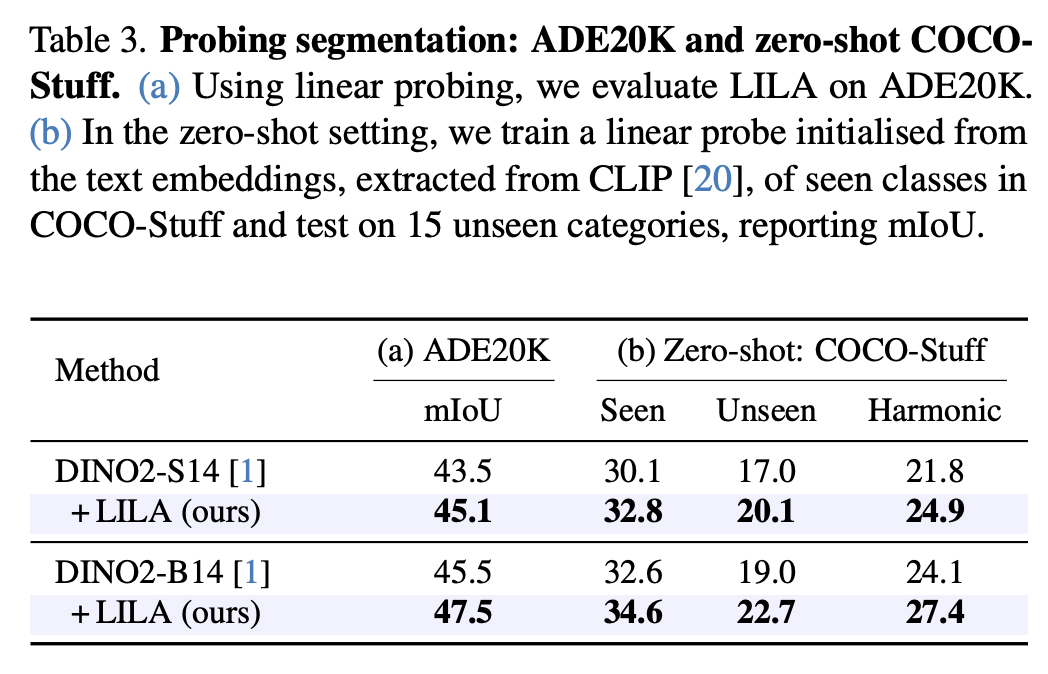
Table 3 补了两个测试。
ADE20K 上:
zero-shot COCO-Stuff 上,DINOv2-B14 的 harmonic mIoU:
这说明 LILA 学到的 dense feature,对 unseen classes 也有帮助。
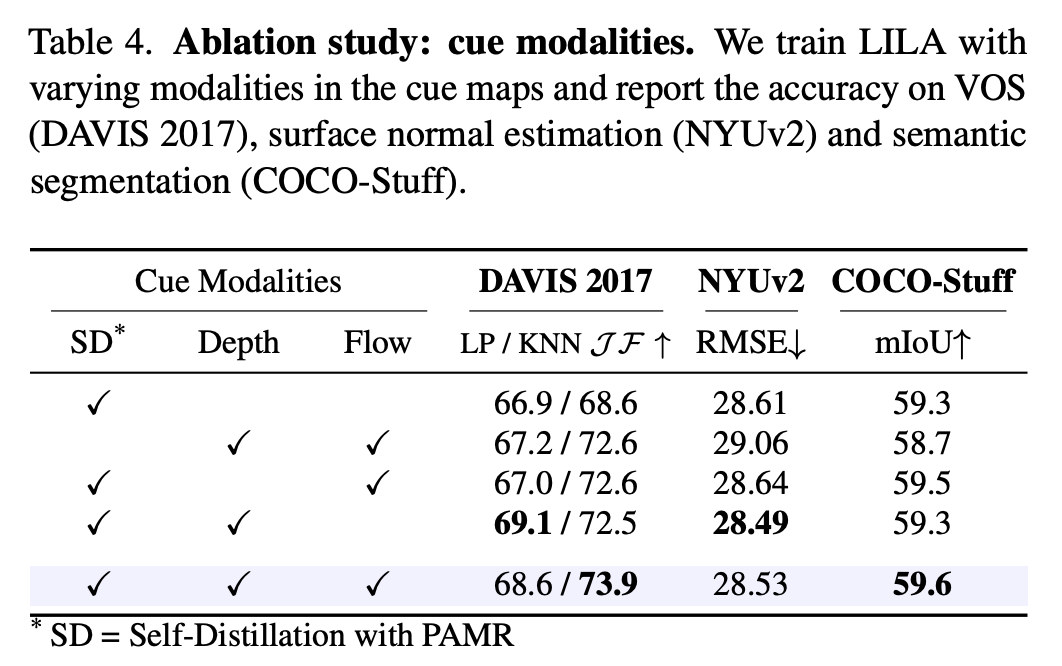
Table 4 看 cue modality。
只用 self-distillation 时,VOS local k-NN J&F 是68.6。
加入 depth 或 flow 后都会涨。
三种 cue 一起用,local k-NN J&F 到73.9。
这说明 depth、motion、encoder feature 是互补的。
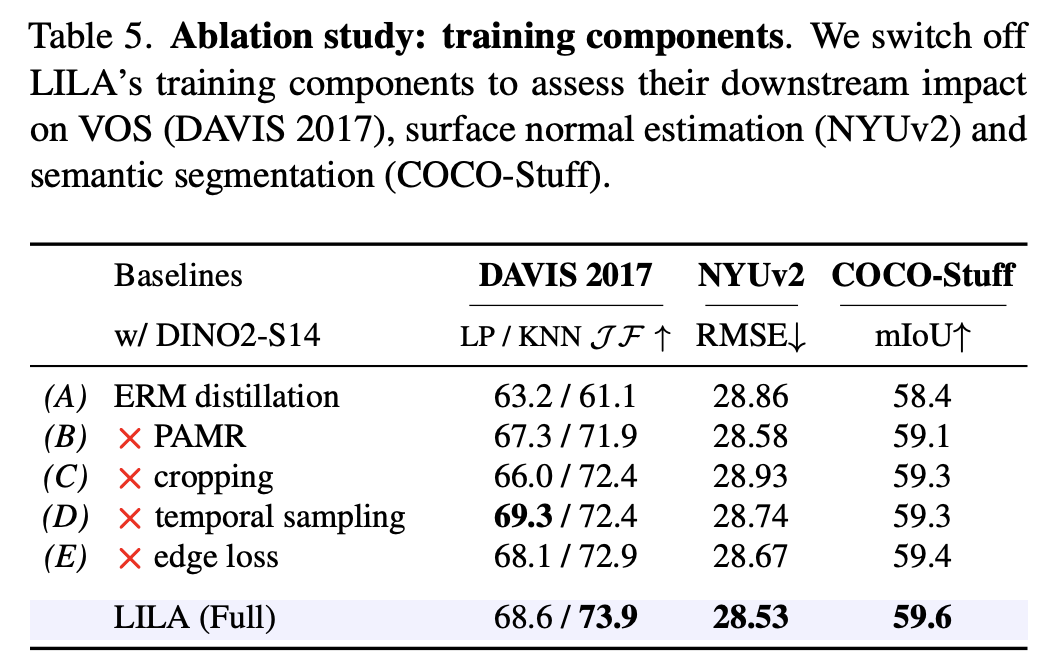
Table 5 更关键。
它比较了 LILA 和直接预测外部 cue 的 ERM distillation。
两者用的是类似 cue。
差别在于:ERM 直接学 noisy cue,LILA 用跨帧线性一致性过滤噪声。
这个差距说明,linear in-context learning 本身不是装饰。它确实在起作用。
其他组件也有贡献:
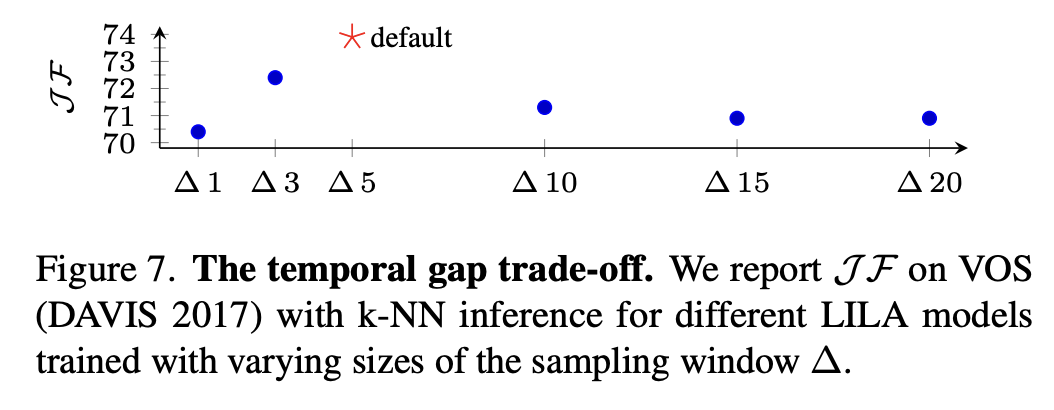
Figure 7 看 temporal gap。
太小,任务太容易,学到的表征反而弱。
变大后,cue predictability 更难,但精度是平滑下降。
这说明 LILA 确实在利用视频里的时间间隔,而不是只做单帧蒸馏。
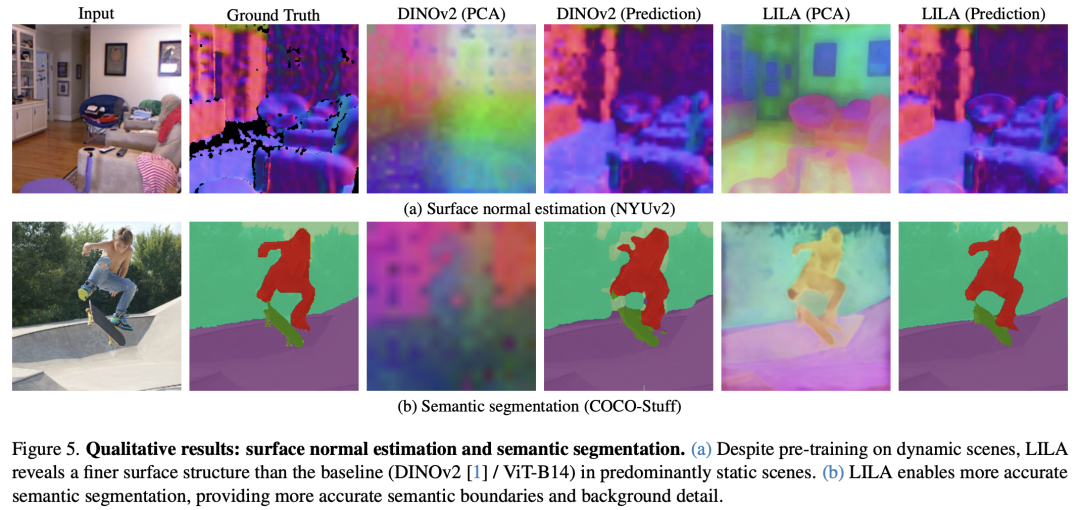
Figure 5 适合讲两个点:
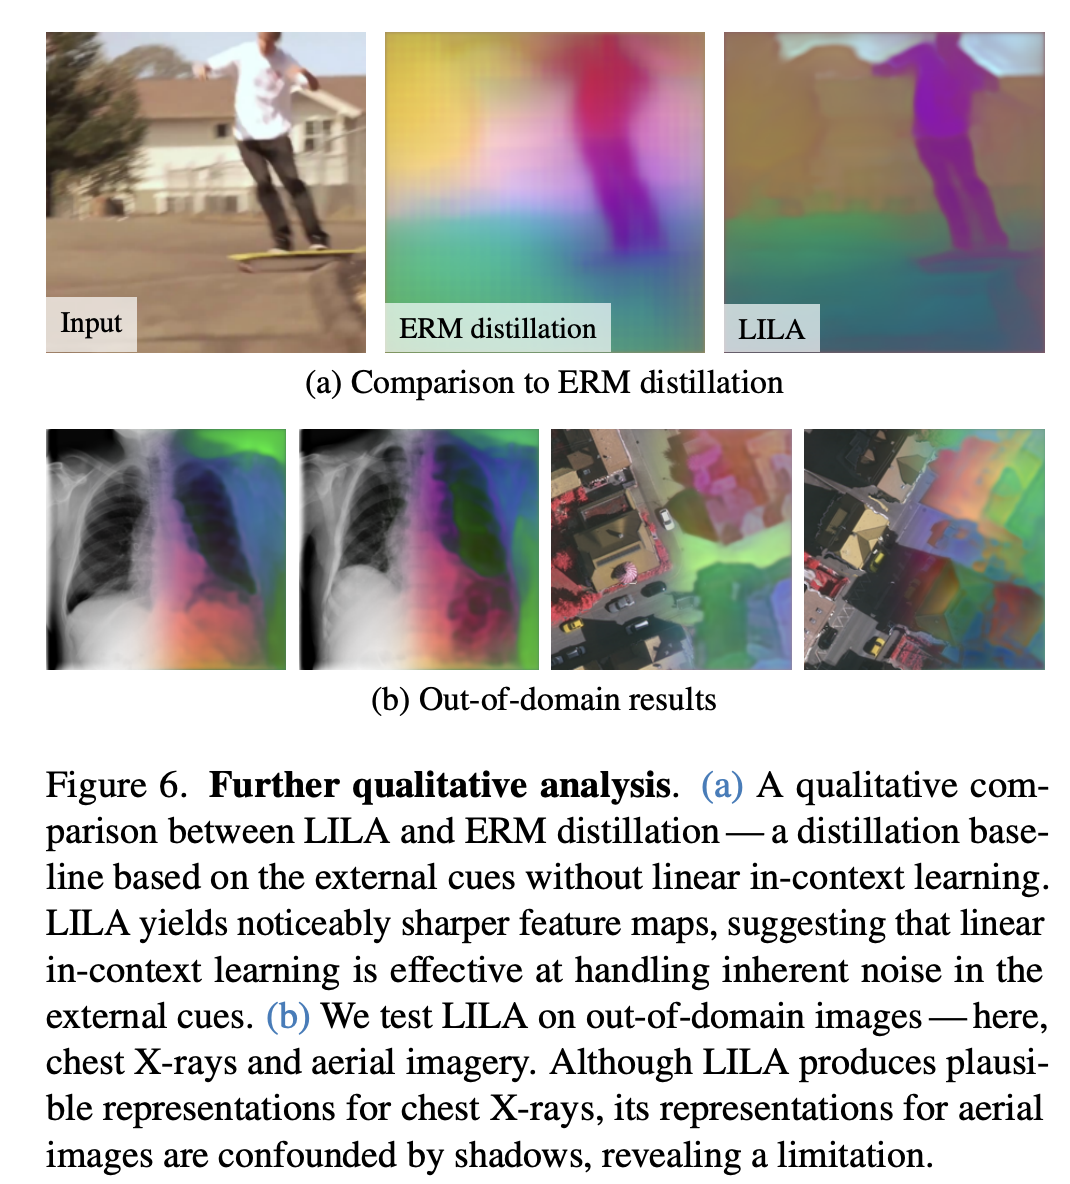
Figure 6 值得放在“注意点”附近。
它有两个信息:
这张图也能提醒读者:别把方法理解成“哪里都无脑好”。
LILA 强,但它确实依赖 depth / flow cue 的适用范围。
LILA 的信息可以压成一句话:
未标注视频里的 depth 和 motion,不只是训练目标,也可以变成 pixel-level representation learning 的桥。
它没有推翻 DINOv2 这类大 encoder。
更像是给它们补了一个 dense decoder。
encoder 负责强语义。
decoder 负责把语义、几何和时间一致性落到每个像素。
这条路线的好处是很实用:
训练时用视频。
推理时只要单张图。
不需要人工 mask。
结果也不是只在一个 benchmark 上变好,而是在 VOS、surface normal、semantic segmentation 上一起提升。
代码 / 项目页:
项目页和 GitHub 已放出代码与 pretrained checkpoints。
我觉得这篇最值得看的地方,是它很清楚地补了 foundation model 的一个短板。
大 encoder 已经有强语义。
但 dense tasks 需要的是每个像素都可靠。
LILA 没有强行重训整个 foundation model,而是冻结 encoder、训练 decoder,用视频里的 depth / flow cue 把 pixel detail 补上。
这个选择很克制,也很工程。
LILA 依赖 off-the-shelf depth 和 optical flow。
如果这些 cue 在域外场景里不可靠,feature 也可能受影响。
Figure 6 里的 aerial image 就是一个提醒。
另外,很多结果是 probing 设置。
它证明了 representation 更好,但真正接到复杂下游系统时,还要看 task head、训练数据和部署场景。
第一个方向,是接更多 backbone。
附录 Table 6 已经显示,MAE-B16、DINOv2-Reg、DINOv3 上都能有提升,只是幅度不同。
第二个方向,是引入更多 cue。
比如更强的 3D cue、object permanence、interaction signal,甚至来自机器人交互的视频反馈。
第三个方向,是把 LILA 这种 dense decoder 变成视觉 foundation model 的标准配件。