


来源:AI TIME 论道
文章链接:https://mp.weixin.qq.com/s/BmqJdhzVDwQ2HO0f64NRJg
解读、编辑|张意梅
审核 | 蒲诗瑶
ACM MM 2026
论文题目:OASIS: Occlusion-aware Single-image Hand Avatar Reconstruction via 3D Gaussian Splatting
作者:Zhisheng Han, Shiyao Wu, Jiayan Qiu, Yakun Ju, Lu Liu, Le Zhang, Pengfei Feng, Huiyu Zhou, Zheheng Jiang
论文链接:https://arxiv.org/abs/2607.29633
3D 虚拟化身重建听起来很酷:给一张照片,还你一个可以转动、可以驱动、可以编辑的 3D 模型。其中,手部化身的重建尤为关键——因为手,恰恰是人类与世界交互、传递表情最频繁的媒介。
可这件事真正做起来,远比想象中难。手是人体里"最难伺候"的部分:它有高度复杂的铰接结构(多关节、高自由度的复杂铰接结构),而且几乎每个姿态都伴随着严重的自我遮挡——握拳时掌心消失,侧握时拇指挡住食指,你永远只能看到它的一面。
这就引出了一个核心矛盾:重建一只完整的 3D 手,需要的信息远不止"看得到的那一面"。 而单张照片,恰恰只给了你一面。
针对这个矛盾,来自莱斯特大学、埃克塞特大学、伯明翰大学和中国地质大学的研究团队提出了 OASIS——一个专为单图像手部化身重建量身定制的 3D 高斯溅射(3DGS)框架。它不仅把重建质量做到了新的高度,还在 NVIDIA A100 GPU 上,OASIS 达到约390 FPS;相比论文中约0.16 FPS的 HandAvatar 和 OHTA,单帧渲染耗时缩短约2500倍。目前该论文已被多媒体领域顶级会议 ACM Multimedia 2026 接收。
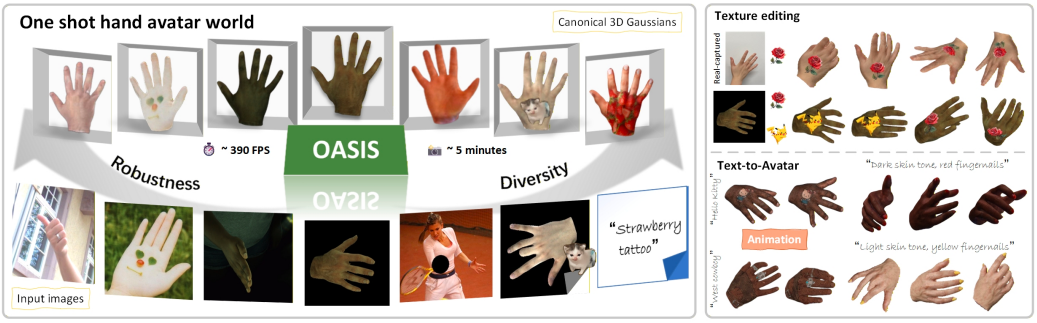
图1 | 成果总览 Teaser——左侧为单图重建的多样化手部画廊,中部标注 ~390 FPS 渲染与 ~5 分钟定制,右侧为纹理编辑、文生化身等下游应用
为什么手部重建这么难
要理解 OASIS 在解决什么问题,得先看清手部化身重建的两道坎。
第一道坎:被遮挡的部分,看不到
单图像重建本质上是一个高度病态(ill-posed)的问题。你可以这样理解:照片是一个 2D 的投影,而手是一个 3D 的、会形变的复杂结构。从 2D 反推 3D,本身就有无数种可能;再叠加手指相互遮挡,能直接观测到的外观信息就更少了。
更棘手的是,当你试图把图像特征"贴"到 3D 手的表面时,那些被遮挡的 3D 点会错误地匹配到可见的前景区域——比如,手背上的一个点,可能误把掌心的纹理当成自己的外观。证据一旦错位,重建出来的手自然就"破"了。
第二道坎:手在动,几何在变
手不是刚体。每一次抓握、每一次弯曲,皮肤表面都在发生拉伸和剪切。如果用顶点(vertex)来描述这种形变,往往会顾此失彼。仅依赖顶点级特征时,模型可能无法充分捕捉网格面的局部拉伸和剪切,进而在姿态变化中出现覆盖不足和局部孔洞。
现有的主流方法大多依赖 NeRF(神经辐射场) 这类隐式表示。它们原理上可行,但代价沉重:需要密集的光线采样和反复评估,渲染慢得难以部署。而近期被广泛用于人体化身重建的 3D 高斯溅射(3DGS) 虽然又快又好,却迟迟没能在手部大显身手——因为通用 3DGS 方法并没有为"严重自遮挡"和"复杂非刚性形变"这两个手部特有的难题设计专门的机制。
OASIS 要做的,正是补上这一块。
本文的主要贡献
OASIS 的核心思路是:与其回避遮挡,不如让模型学会区分"看得见的证据"和"看不见的地方",并分别处理。 围绕这一思路,论文提出了三个关键设计:
提出几何对齐的视觉证据令牌(VETs),把 2D 图像特征与 3D 手部几何显式对齐,建立可靠的"2D-3D 对应关系"。
设计遮挡感知的注意力机制(VPIA),对可见点和被遮挡点采用不同的特征传递策略,避免错误匹配。
-
引入网格特征表示(Feature-on-Mesh, FoM),将特征提升到网格面层级,让高斯属性与表面形变严格耦合,提升非刚性运动中的表面连续性,减少局部孔洞。
此外,OASIS 还采用了一种 one-shot 适应策略:先从多身份数据中学到共享的手部先验,再用一张目标图像快速微调,只需约 5 分钟即可注入目标身份特定的颜色与精细纹理。
三大模块:如何破解"看不见"与"在变形"
OASIS 的整体框架可以理解为一个"证据采集—证据筛选—形变驱动"的流水线。下面分别拆解三个核心模块。
几何对齐的视觉证据令牌(VETs)
第一个模块要回答的问题是:如何从一张图里,可靠地提取出属于每个 3D 点的外观证据?
传统做法是直接把图像特征"灌"给模型,但手部高度遮挡下,这种直接传递会产生歧义。OASIS 的做法更精细:它先用 DINOv2 提取图像特征,再把参数化手部模型(MANO-HD)的 3D 点投影到图像平面上,通过 5×5 的局部邻域网格采样,并用距离加权来聚合特征——这样就建立起了明确的 2D-3D 对应关系。随后,一个可学习的令牌化模块通过交叉注意力,将这些冗余特征压缩成紧凑的令牌表示。
一句话:先对齐,再压缩,确保每条视觉证据都"知道"自己来自几何上的哪个位置。
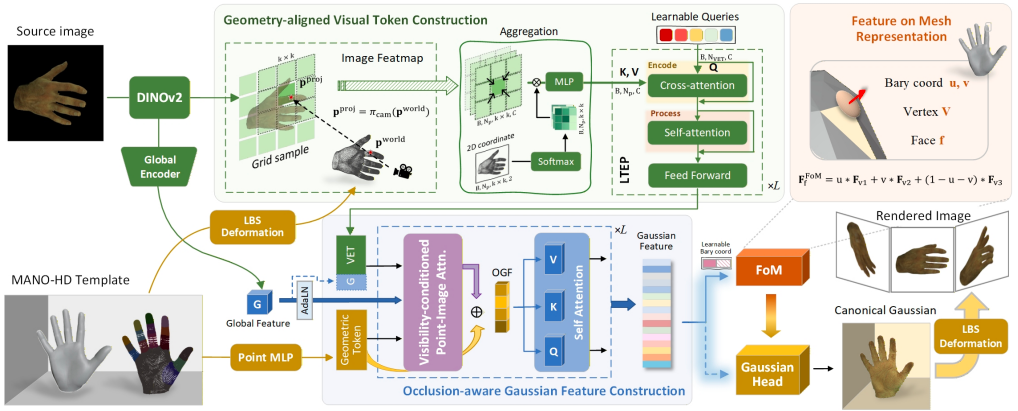
图2 | OASIS 整体框架图——从单张输入图像出发,依次经过 VETs 构建、遮挡感知高斯特征构建、FoM 表示,最终 LBS 变形渲染
遮挡感知的注意力机制(VPIA)
即便建立了对应关系,遮挡依然是绕不开的难题。被遮挡的 3D 点在投影时会落到可见前景上,从而"认领"到错误的外观。
OASIS 引入了 visibility-conditioned point-image attention(VPIA)。它通过 z-buffer 测试,为每个点计算一个连续的软可见性分数:
Δz = z-buffer 深度 − 该点自身深度,再经 sigmoid 归一化到 [0,1]。
然后分流处理:
对于可见点,注意力偏置偏向局部、具体的视觉证据(因为这部分信息是可信的);
-
对于遮挡点,注意力偏置则把权重引导向全局上下文特征(既然看不到细节,就借助整体语义来"推断")。
之后,再通过自注意力进一步精炼这些高斯特征。这种"区别对待"的设计,正是 OASIS 名字中 Occlusion-aware(遮挡感知)的由来。
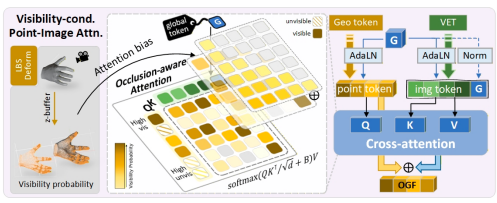
图3 | VPIA 架构——通过 z-buffer 计算软可见性分数,对可见点偏向局部证据、对遮挡点偏向全局上下文,实现分流处理
网格特征表示(Feature-on-Mesh, FoM)
前两个模块解决的是"证据从哪来",第三个模块要解决的是"形变怎么跟"。
手部的非刚性运动,让基于顶点的特征解码力不从心——它无法充分反映网格面在关节运动中的局部拉伸和剪切。OASIS 的解法是把特征从顶点层提升到面(face)层:在网格三角面上嵌入可学习的重心坐标,通过重心插值得到面级特征。这样,解码出的高斯属性(位置、缩放、旋转、不透明度、颜色)会与网格面的局部变形严格耦合,使高斯更一致地跟随网格面形变,从而在实验中保持更连续的表面,并显著减少局部孔洞”。
One-shot 适应:5 分钟定制一只手
在训练阶段,OASIS 先在多身份数据(InterHand2.6M 的 21 个受试者)上学习一个共享的手部先验。到了应用阶段,面对一张全新的目标图像,它通过三步完成定制:
颜色校准:利用掩码区域的颜色均值和标准差,对目标图像与预训练先验之间的全局外观差异进行校准;
LoRA 微调:用低秩适配注入特定身份的精细纹理,并用参考视角正则化防止过拟合;
-
整个过程只需约 5 分钟(100 步颜色校准 + 400 步纹理学习)。
训练在 2 张 NVIDIA A100(40GB)上完成,使用 Adam 优化器,学习率 4×10⁻⁴。
实验结果:又快又好,还通用
OASIS 在 InterHand2.6M、HanCo 等数据集上,与现有单图像及多视频基线方法进行了全面对比。结果可以用一句话概括:在单图像方法中全面领先,多项指标接近多帧视频方法。
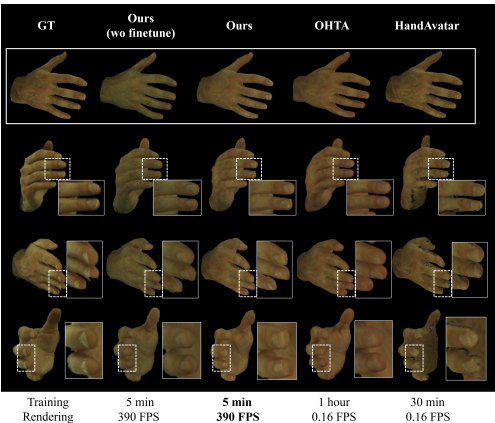
图4 | InterHand2.6M 定性对比——从左到右依次为 GT / Ours(wo FT) / Ours / OHTA / HandAvatar,底部附有各方法的渲染帧率与训练耗时
质量:单图设置全面领先
在 InterHand2.6M 测试集上,各方法的对比如下:
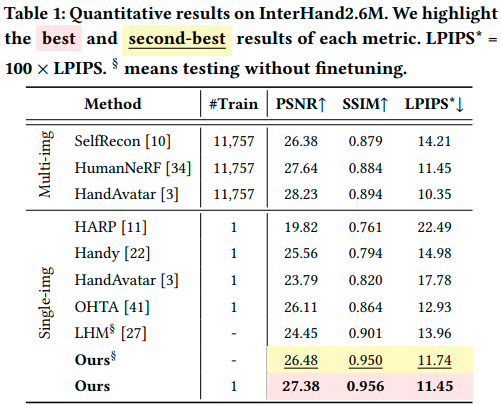
表1 | InterHand2.6M 定量主结果——多图 vs 单图方法全面对比,OASIS(One-shot)以 PSNR 27.38、SSIM 0.956 全指标领先单图方法。(LPIPS* = 100 × LPIPS,数值越低越好)
值得注意的有两点:
即便是未经任何微调的 OASIS(PSNR 26.48),也已经超过了当前单图 SOTA 方法 OHTA——这说明共享手部先验本身就很强。
-
经过仅 5 分钟的 one-shot 微调后,OASIS 进一步把 PSNR 推到 27.38,而且只用了一张图,就逼近了需要上万张图训练的多帧/单目视频方法(HandAvatar 的 28.23)。
在 HanCo 数据集上,OASIS 同样全面领先:
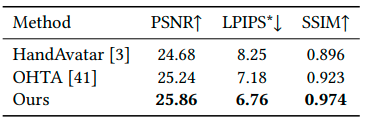
表2 | HanCo 数据集定量结果——OASIS 以 PSNR 25.86、SSIM 0.974、LPIPS 6.76 全面超越 HandAvatar 与 OHTA
效率:快了约 2500 倍
更惊人的是速度。OHTA 收敛需要约 1 小时、渲染仅约 0.16 FPS;而 OASIS 的渲染速度达到约 390 FPS——单张图像的渲染耗时差距约为 2500 倍。这意味着,OASIS 已经具备了走向实时交互的条件。
消融实验:每个模块都在起作用
论文还做了详尽的消融实验,消融结果表明,VET、VPIA和FoM均对最终性能有所贡献,其中纹理先验对one-shot重建的影响最为显著;FoM的价值则更多体现在姿态变化时的表面连续性上。
下游应用:不止于重建
OASIS 还展示了它在两个下游任务上的潜力(效果见开篇图 1 右侧):
文本到化身生成:结合文生图模型,先根据手部掩码和文本提示生成参考手部图像,再由 OASIS 将其重建为可驱动的3D手部化身;
手部化身编辑:先在参考图像上绘制或修改外观内容,再利用 OASIS 重建相应的可驱动化身。
诚实面对的局限
论文也坦诚地指出了两类局限,这是优秀工作应有的态度:
依赖第三方姿态估计:OASIS 高度依赖预训练估计器(如 WiLoR)来预测姿态、相机参数和掩码。在极端视角或复杂姿态下,估计不准会导致几何初始化错误,进而影响纹理建模。
阴影/反照率模糊:由于单图像逆渲染的固有歧义(材质、几何、光照纠缠),模型未做显式本征分解,强烈投射阴影可能被直接"烘焙"进纹理。
总结与展望
OASIS 的意义,不仅在于它把单图像手部化身重建的"质量-速度"权衡推向了一个新台阶,更在于它给出了一个清晰的解题范式:面对严重遮挡,不要假装看不见,而是让模型学会区分、分流、分别处理。
从更宏观的视角看,这项工作所处的位置正好处在几个趋势的交汇处:3D高斯溅射正成为与NeRF并行发展的重要显式3D表征路线;数字人与虚拟化身的需求随着 AR/VR、远程呈现、内容创作而爆发;而手部——作为人机交互最精细的"接口"——其重建质量直接决定了虚拟人的可信度。
展望未来,仍有几个值得继续探索的方向:如何摆脱对第三方姿态估计器的依赖,实现真正的端到端单图重建;如何引入显式的本征分解,把光照、材质、几何解耦开来,避免"阴影烘焙"问题;以及如何把这种遮挡感知的思路,从手部推广到更通用的铰接物体(乃至全身化身)的重建中。
当我们能让一张静态照片"长出"一只可以自由驱动的 3D 手时,距离让虚拟人真正"活"起来,或许又近了一步。
