


ICML 2026现场 | 天气数据压缩566倍、表格推理仅用万张图,八篇Spotlight速读
**
**
过去几年,AI的进步往往伴随着暴力的“大锅炖”——把海量数据一股脑塞进模型,指望它自己顿悟。但这招在应对复杂真实世界时,正变得越来越低效。
在正在进行的 ICML 2026 上,我们从数百篇 Spotlight 论文中敏锐地捕捉到了一个新风向:AI 正在告别“混沌”,学会像人类一样进行结构化思考与“解耦”。
当 AI 学会“骨肉分离”,它只需 1 万张图就能看懂复杂表格的版式与内容;当它学会像人类一样区分“我看到的”和“我推断的”,长程多模态推理便不再轻易断片;当它像工程师一样在脑海中建立 3D 正交视角,空间智能的鸿沟被瞬间跨越;而当气象数据被抽丝剥茧迁入隐空间,原本需要数百 TB 算力的天气预测被惊人地压缩了 566 倍。
雷峰网(公众号:雷峰网) & AI科技评论记者在首尔现场,为您速递这 8 篇极具启发性的 Spotlight 代表作。它们证明了一件事:在算力见顶的今天,更优雅的底层解构,才是通向更强智能的真正钥匙。
1、World-Model Inspired Emotion-aware Token Refinement:无需训练的多模态情感识别
World-Model Inspired Emotion-aware Token RefinementICML for Training-Free Multimodal Emotion Recognition
多模态大语言模型在情感识别(MER)方面展现出潜力,但往往不够可靠——稀疏的情感线索容易被冗余上下文淹没。虽然微调有效但成本高昂,而链式思维推理等无训练方法虽提供了实用替代方案,却大多依赖启发式提示来影响模型行为,并未在内部明确关注与情感相关的Token,导致决策相关的情感Token被环境噪声稀释,产生不稳定的预测。
为在不训练的前提下解决这一限制,研究者从世界模型的视角重新思考MER,将情感视为从嘈杂和冗余的多模态观测中推断出的潜在状态。在参数冻结的情况下,模型的鲁棒性取决于对Token如何以及为何参与推理进行约束。基于这一洞察,该方法通过情感感知的Token精炼机制,在推理过程中动态调整Token的参与方式,使与情感决策相关的Token获得更高的权重。
实验表明,该方法在多个多模态情感识别基准上取得了显著提升,且无需任何训练即可生效。这一工作为"无训练增强多模态情感识别"开辟了新路径,证明了从世界模型视角重新审视情感推理的巨大价值。
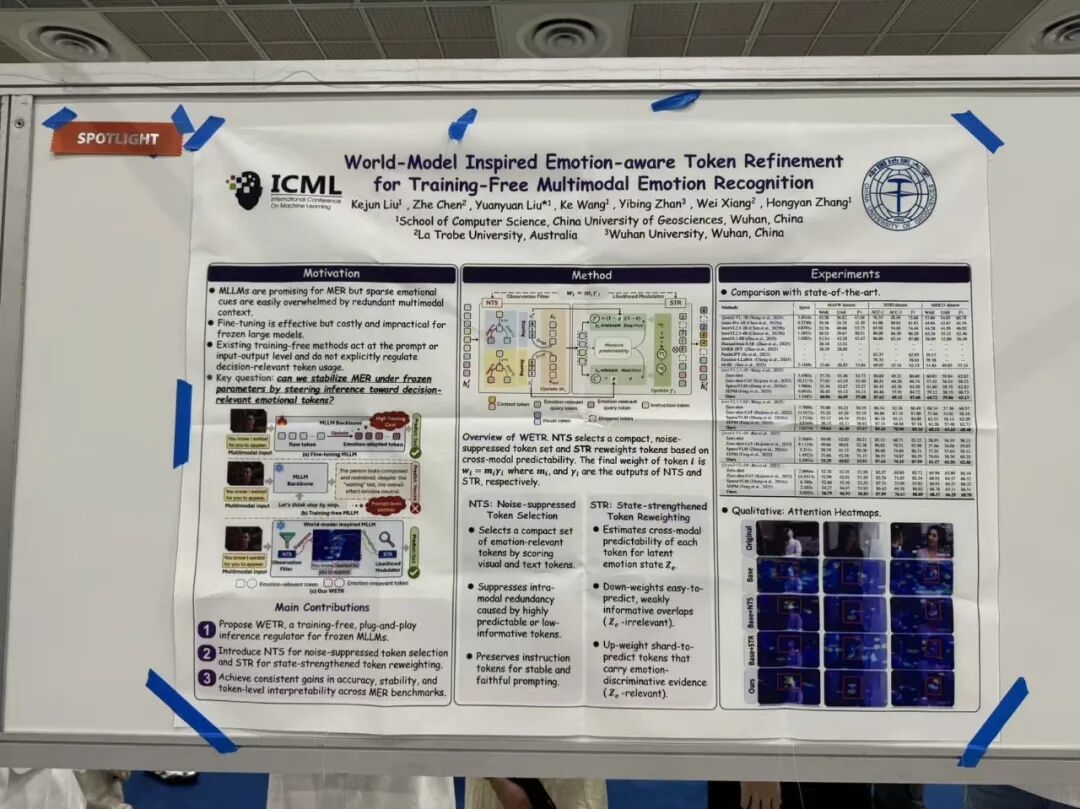
论文链接:https://openreview\.net/forum?id=ViQO8FlRFR
2、Decoupling Skeleton and Flesh:高效多模态表格推理
Decoupling Skeleton and Flesh: Efficient Multimodal Table Reasoning with Disentangled Alignment and Structure-aware Guidance
大型视觉语言模型(LVLM)在表格图像推理上面临严峻挑战,根因在于表格的复杂布局以及结构与内容信息的紧密耦合。现有解决方案要么依赖大量标注的监督微调或强化学习(成本高、易遗忘),要么需要外部工具(增加延迟和系统复杂度)。更关键的是,这些方法将结构标记和内容标记混在同一个序列中,迫使模型学习纠缠信号,导致跨布局泛化能力差、样本效率低。
该研究提出了"骨肉分离"的核心思想——将表格的结构(行列布局、层级关系)与内容(单元格语义)解耦学习。训练阶段,DiSCo框架通过单元格匿名化技术,让模型仅从视觉线索中学习表格结构,同时通过全局摘要和局部坐标查询学习内容语义,仅需1万张表格图像即可完成对齐。推理阶段,Table-GLS框架采用"全局结构探索→子表提取→证据驱动推理"三步链,无需专门的推理训练或外部工具。
在21个表格理解与推理基准上的实验表明,该框架仅用1万张对齐数据即显著超越依赖8.2万至9.7万标注的SFT/RL基线方法,尤其在未见表格结构上展现出强大的泛化能力。这一工作为LVLM表格推理提供了"低标注、无工具"的新范式。
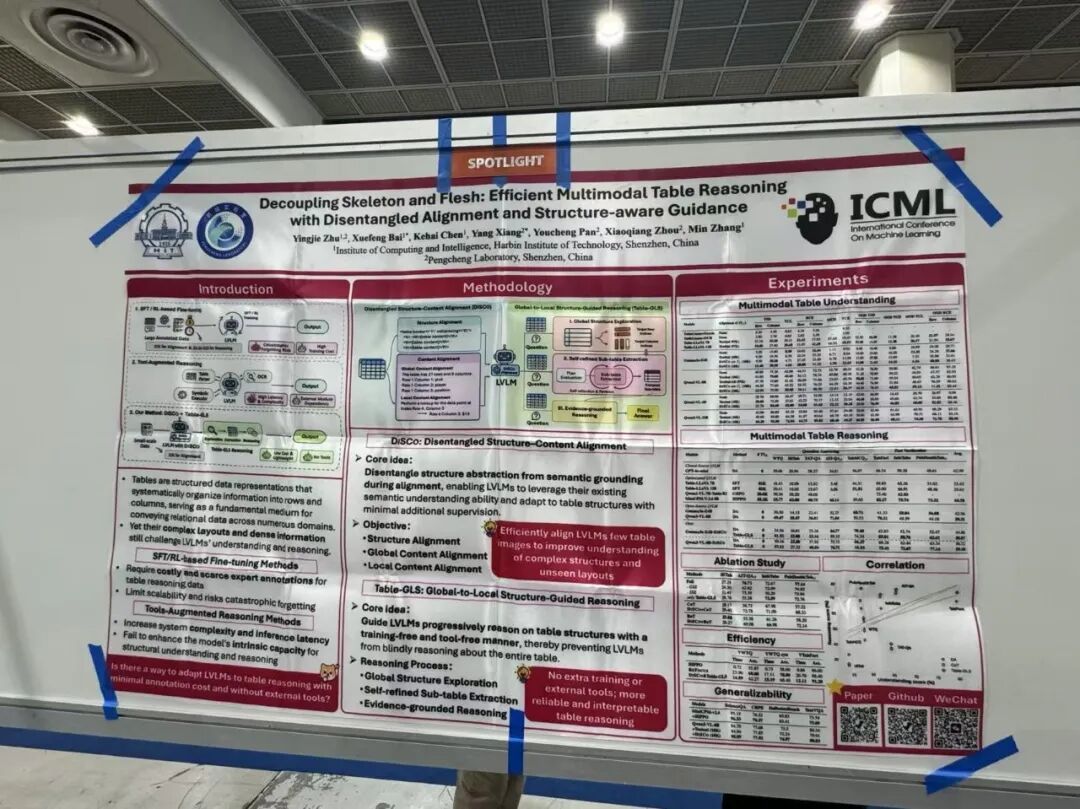
论文链接:https://arxiv\.org/abs/2602\.03491
3、DLMR:面向视觉语言推理的双潜记忆路由
Dual-Latent Memory Routing for Vision-Language Reasoning
多模态大语言模型(MLLM)在视觉语言推理上取得了长足进步,但随着生成长度增加,性能往往出现退化。一个关键因素是:在单一增长的上下文中,模型常常丢失早期视觉证据和中间约束。这类似于人类在处理复杂任务时,如果无法有效区分"看到的"和"推断出的"信息,就容易出现推理链条断裂。
受人类分别回忆"所见"和"所推"的启发,DLMR为MLLM配备了双潜记忆机制:视觉记忆压缩图像证据,推理记忆追踪中间结论和约束。一个路由器在推理过程中动态决定复用哪种记忆以及复用多少,在保持视觉锚定的同时维持连贯的长程推理。DLMR通过三阶段训练(潜记忆构建→选择性路由学习),仅引入少量可训练参数,基座MLLM保持冻结。
实验表明,DLMR在通用基准和推理基准上均取得显著提升。进一步分析揭示了可解释的、状态依赖的路由模式:视觉记忆和推理记忆各司其职,该设计有效减少了冗余解码,提升了长程生成的Token效率。这一工作为"让MLLM记住该记住的"提供了优雅的解决方案。
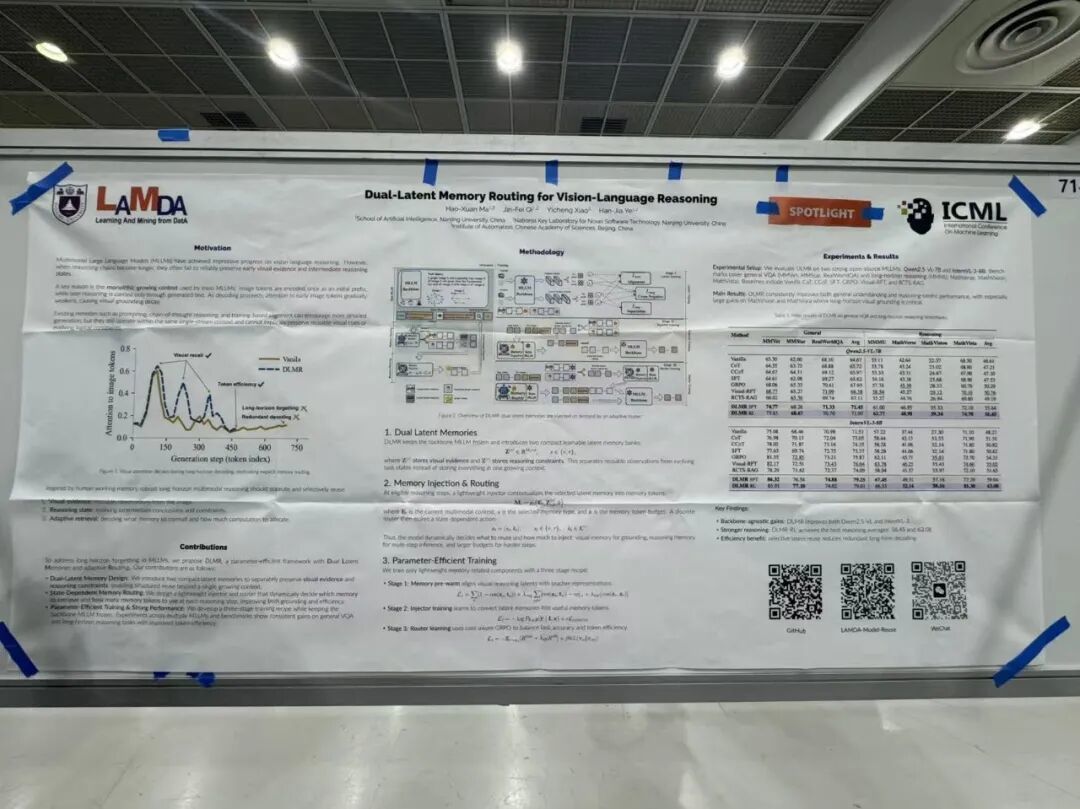
论文链接:https://openreview\.net/forum?id=SFWWUr9V7c
4、FeatJND:深度视觉特征的恰可分辨差异建模
Just Noticeable Difference Modeling for Deep Visual Features
深度视觉特征正日益成为视觉系统中的通用接口——在端云部署中,特征在设备端提取后传输用于下游推理;在基础模型和多任务流水线中,模块通过深度特征进行组合复用。然而,当需要压缩、量化或降采样中间特征以满足带宽和延迟约束时,简单的均方误差等度量无法反映任务级别的真实影响——同样大小的失真在不同位置可能导致截然不同的下游性能下降。
受图像处理领域"恰可分辨差异"(JND)概念的启发,该研究提出FeatJND——一种与任务对齐的深度特征JND公式,能够预测在保持下游任务性能的前提下,每个特征的最大可容忍扰动图。研究者设计了标准化分割点上的FeatJND估计器,并在图像分类、目标检测和实例分割三个任务上进行了验证。
实验表明,在匹配的失真强度下,基于FeatJND的失真始终比无结构高斯扰动保持更高的任务性能,归因可视化显示FeatJND能有效抑制非关键特征区域。作为应用展示,该方法被进一步应用于逐Token动态量化,在相同噪声预算下,FeatJND指导的步长分配显著优于随机排列和全局均匀步长。这一工作为"特征质量控制"提供了首个实用且理论有据的框架。
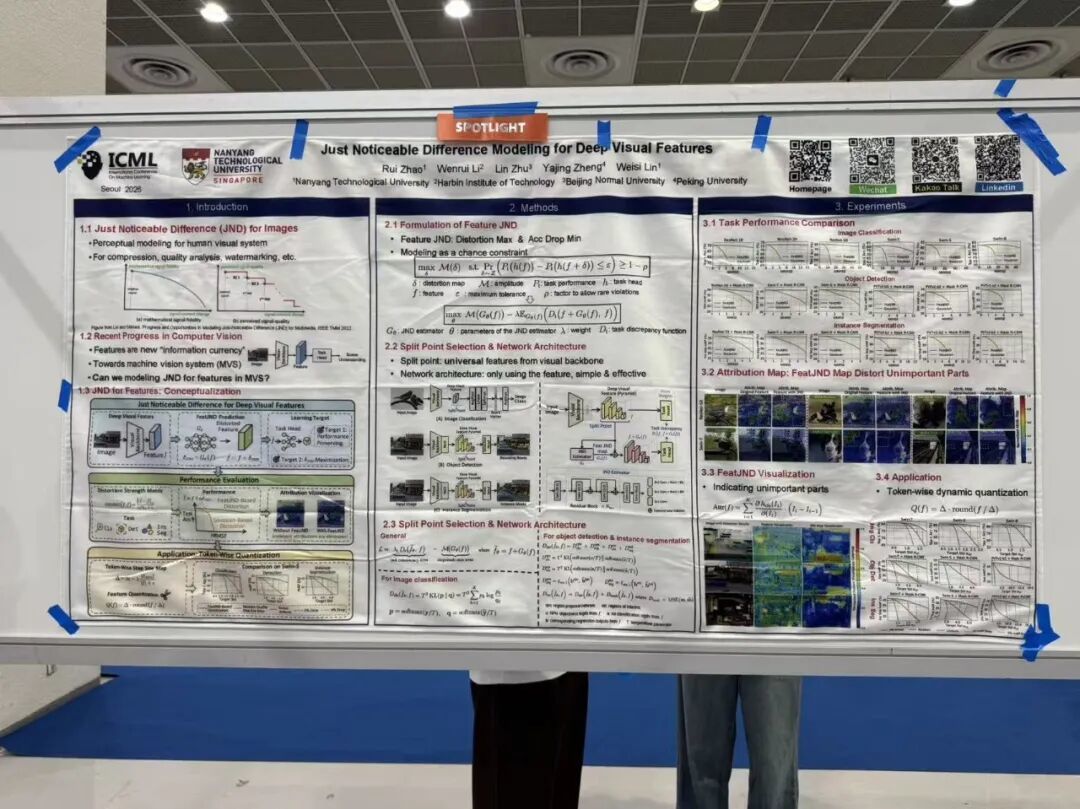
论文链接:https://arxiv\.org/abs/2601\.21933
5、3ViewSense:基于正交视角的VLM空间与心理视角推理
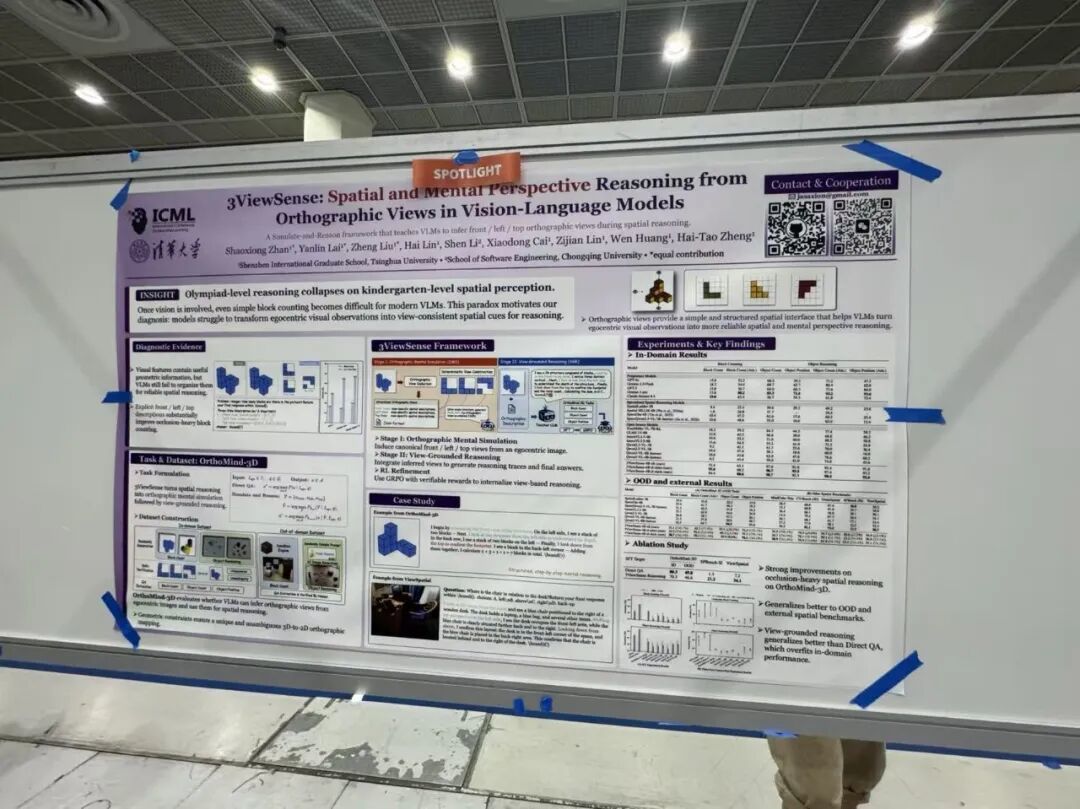
3ViewSense: Spatial and Mental Perspective Reasoning from Orthographic Views in Vision-Language Models
当前大语言模型已达到奥林匹克级别的逻辑推理能力,然而视觉语言模型却在积木计数等基础空间任务上频繁出现反常的失败。这种能力不匹配揭示了一个关键的"空间智能鸿沟"——模型无法从2D观察中构建连贯的3D心理表征。通过诊断分析,研究者发现瓶颈不在于视觉特征不足或推理能力薄弱,而在于缺乏一个视角一致的空间接口。
3ViewSense框架将空间推理建立在正交视角之上,借鉴工程认知领域的做法,提出"模拟与推理"机制:将复杂场景分解为规范的正交投影以解决几何歧义问题。通过将自我中心感知与非自我中心参考进行对齐,该方法实现了显式的心理旋转与3D重建,使模型能够像工程师一样从多视角理解空间结构。
实验结果表明,3ViewSense在空间推理基准测试中显著优于现有基线方法,在遮挡密集的计数任务和视角一致的空间推理上均取得持续提升。这一工作不仅精准定位了VLM空间推理的瓶颈,更为多模态系统中更强的空间智能提供了一条可扩展的路径。
论文链接:https://arxiv\.org/abs/2603\.07751
6、C2R:让蒸馏数据集真正鲁棒起来
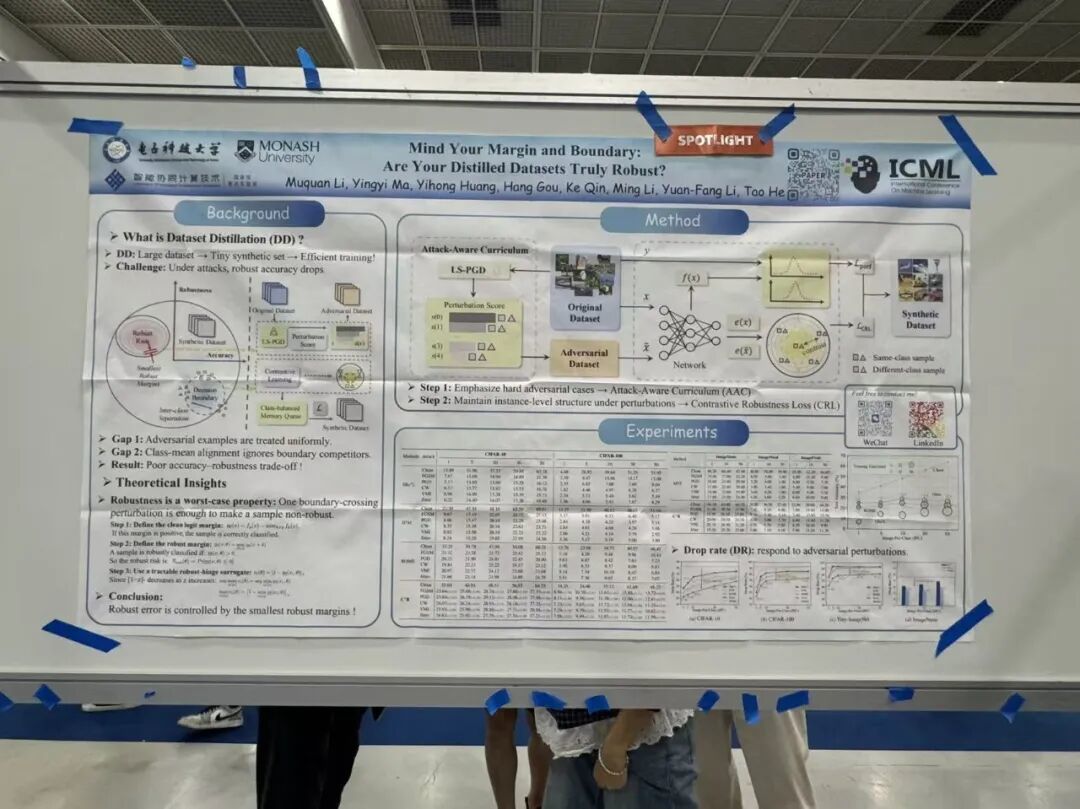
Mind Your Margin and Boundary: Are Your Distilled Datasets Truly Robust?
数据集蒸馏旨在将大规模训练数据压缩为少量高效合成样本,但现有方法大多只优化干净准确率,对鲁棒性缺乏控制。已有的鲁棒蒸馏方法虽然提升了对抗鲁棒性,但往往在准确率与鲁棒性之间存在权衡:要么干净准确率下降过多,要么在强攻击下仍然崩溃。研究者发现两个结构性缺陷:一是将所有对抗样本一视同仁,忽略了真正决定鲁棒风险的"小间隔"困难样本;二是未显式增加决策边界附近攻击集中区域的类间分离度。
C2R框架从"鲁棒间隔"和"决策边界"两个关键角度重新审视蒸馏数据的安全性。首先,从鲁棒铰链损失出发推导出扰动得分,近似每个样本的鲁棒间隔,据此设计攻击感知课程学习,优先优化间隔最小、最易被攻击的对抗样本。同时,类平衡的对比鲁棒性损失在保证对抗不变性的同时,显式拓宽决策边界处的类间分离。为控制计算成本,该方法还引入了基于线性搜索的PGD攻击生成策略。
在CIFAR-10/100、Tiny-ImageNet和多个ImageNet-1K子集上、面对六种攻击的实验表明,C2R取得了最佳鲁棒准确率,平均比此前最优鲁棒蒸馏方法高出2.8%。这一工作为安全敏感场景下的数据集蒸馏提供了更可靠的技术基础。
论文链接:https://arxiv\.org/abs/2605\.20606
7、WLA:将气象数据从像素空间迁移到隐空间
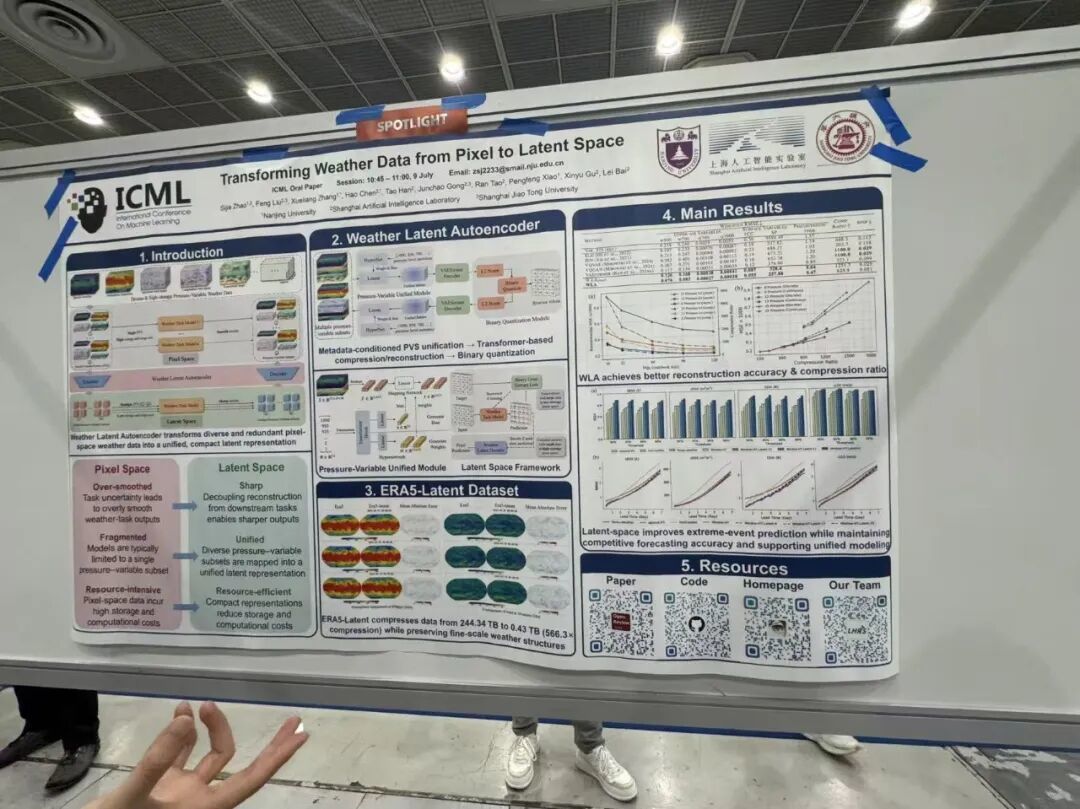
Transforming Weather Data from Pixel to Latent Space
深度学习在天气预报、降尺度、降水预测等任务中取得显著进展,但大多数方法直接在像素空间中对天气数据建模,面临三大挑战:模型输出容易过平滑,不利于极端天气事件的刻画;模型通常只能适用于单一气压-变量子集(PVS),缺乏跨场景适应能力;像素级天气数据动辄数百TB甚至PB级,存储和计算成本极为高昂。
该研究提出Weather Latent Autoencoder(WLA),将天气数据从高维像素空间转换到统一隐空间。核心创新包括:通过Pressure-Variable Unified Module将不同气压-变量组合映射到统一表示,实现跨场景适应;将天气重建与下游任务解耦,使任务模型在低成本隐空间中直接训练和预测,避免像素空间中重建与预测的互相干扰。基于此,研究团队构建了ERA5-Latent数据集。
实验结果令人瞩目:WLA将原始ERA5数据从约244.34 TB压缩至约0.43 TB,压缩比达566倍,同时下游任务模型在隐空间中以更低的数据成本取得了优于像素空间模型的性能。这一工作为大规模气象数据的高效建模开辟了全新范式,具有深远的科学和工程价值。
论文链接:https://arxiv\.org/abs/2503\.06623
8、DistIRL:分布式逆强化学习
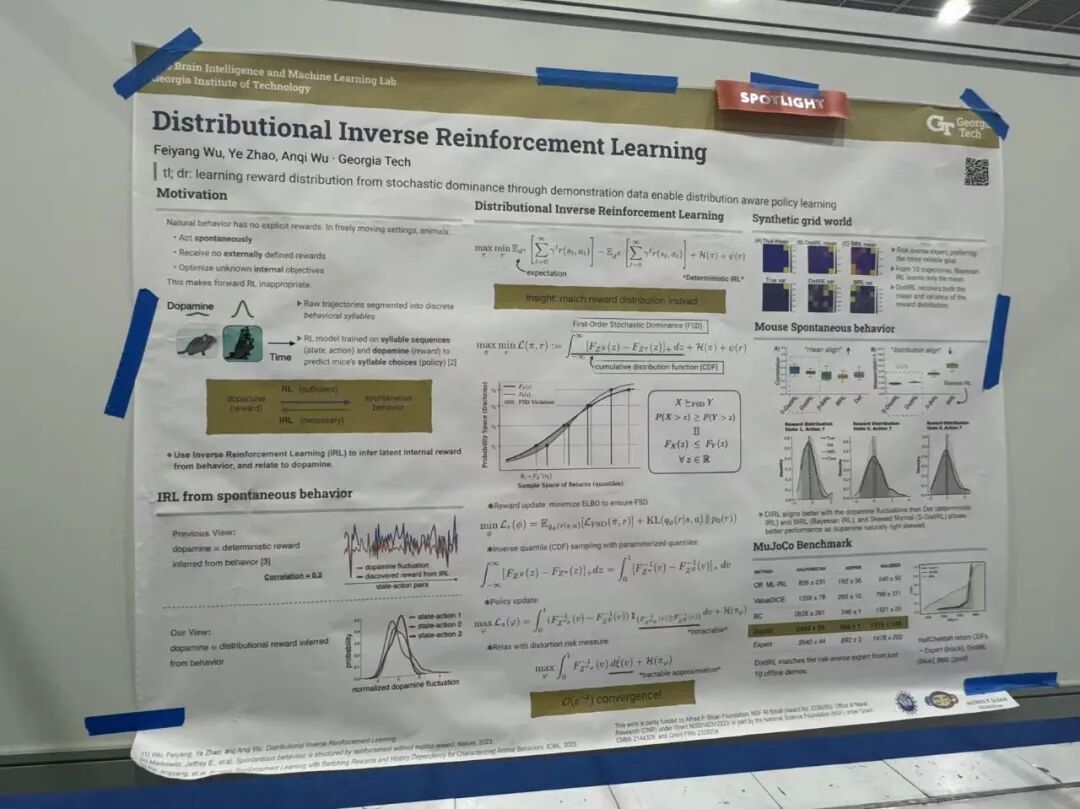
Distributional Inverse Reinforcement Learning
传统逆强化学习(IRL)通常恢复确定性奖励估计或仅匹配期望回报,忽略了专家行为中更丰富的结构信息。然而在许多真实场景中,奖励本质上是随机变量——在机器人接触丰富的任务中,相同状态-动作对的回报表现出高方差;在神经科学中,多巴胺信号在相同行为下也呈现显著的跨试次偏度。仅匹配期望会将均值相同但方差、偏度、尾部截然不同的两个奖励分布视为等价,使高阶结构对IRL目标"不可见"。
DistIRL提出了一种分布式框架,同时建模奖励函数的不确定性和回报的完整分布。核心创新在于用一阶随机优势(FSD)替代期望差异来约束"专家优于学习者"的关系——FSD不仅蕴含期望优势,还适用于任何单调效用函数。对于策略侧,不可观测的FSD指示函数被松弛为可计算的失真风险度量(DRM),形成风险敏感的策略目标。该方法通过基于能量的模型和变分推断学习奖励分布。
理论分析证明了算法的O(ε-2)迭代复杂度收敛性。在合成基准、真实神经行为数据和MuJoCo控制任务上的实验表明,DistIRL恢复了更具表达力的奖励表示,并取得了最先进的模仿学习性能。这是首个从离线演示中同时学习完整奖励分布和分布感知策略的系统性框架。
论文链接:https://arxiv\.org/abs/2510\.03013
结语
从多模态情感识别到表格推理,从空间智能到天气建模,从数据集蒸馏到逆强化学习,这八篇Spotlight论文展现了ICML 2026的多元创新面貌。它们或揭示能力鸿沟,或打破数据瓶颈,或将经典理论推广到全新维度,共同指向一个趋势:AI研究正在向更深层的认知建模、更高效的资源利用和更鲁棒的系统设计迈进。雷峰网 & AI科技评论将持续为您带来ICML 2026的现场报道,敬请关注。
一个人读论文太孤单,一群人刷顶会才好玩。
ICML 2026 召开在即,我们正在召集一波含金量极高的 AI 研究者。群内主打实时论文跟踪与硬核技术探讨,拒绝灌水。
? 进群传送门: 扫码进群或添加微信Vin_Vivid,备注:论文群 + 关注的 AI 方向。
搞科研/搞技术,信息差很重要。
来,一起快人一步!
上车,带你看遍全球 AI 顶会精华
可独家畅览:
专家演讲PPT
大会报告全文
热门论文解读
学术新星访谈
扫描上方二维码
或点击「阅读原文」关注专区。
雷峰网原创文章,未经授权禁止转载。详情见转载须知。
原文链接: https://www.leiphone.com/category/private/ygYlfC0UBQgppoVU.html
