


来源:公众号“AI光点”
原文链接:https://mp.weixin.qq.com/s/WYaG9RVRvpC2uVb0pyhsTg?scene=1&click_id=6
超市货架最里面立着一盒饼干。机械臂已经看见它,夹爪也张得开,可正面被其他商品挡住,侧面只剩一条窄缝。传统系统会继续找一条不碰任何东西的轨迹;实在找不到,就宣布这次抓取不可行。
人不会这么做。我们会先把纸盒拨转一点,让包装袋替它挡一下,或借旁边更重的罐子做支点,把原本夹不到的侧面露出来。整个过程没有更灵巧的手指,灵巧来自对环境的利用。
机器人研究把这种能力叫作Extrinsic Dexterity,外在灵巧性。难点在于,货架上的障碍会跟着接触继续运动。手臂碰到一个物体,运动会传给第二个、第三个;同样的几何位置,装满饮料的罐子可以借力,空纸盒却会被一起推走。
这正是DAPL想补上的判断。论文由银河通用(Galbot)、北京大学、智源研究院、中科院自动化所和上海交大共同完成,王鹤与张智铮担任通讯作者,并入围RSS 2026 Best Paper Finalist。
它把杂乱操作的核心问题,从“哪里能走”推进到了“碰上以后会发生什么”。
抓取优先的操作系统有一套清楚的秩序:先找到物体,再生成抓取姿态,最后规划一条无碰撞轨迹。这套流程在桌面空旷、目标暴露时很有效,一旦物体挤在一起,安全边界会迅速吞掉可行空间。
非抓取操作提供了另一条路。机器人可以推、滑、拨、翻,把目标送到更容易抓取的位置。过去的外在灵巧工作已经证明,简单夹爪也能借桌面、墙面和重力完成复杂动作,但不少方案依赖预先设计的接触模式、特定动作primitive,或只在少量物体的简化场景里学习。
近年的点云表征方法更擅长看清物体形状与接触位置,却仍容易把场景当成静态几何。密集环境里,要命的差别恰恰不在轮廓:塑料杯和金属罐可以占据相同位置,但机械臂推过去以后,一个会滑走,另一个可能成为稳定支点。
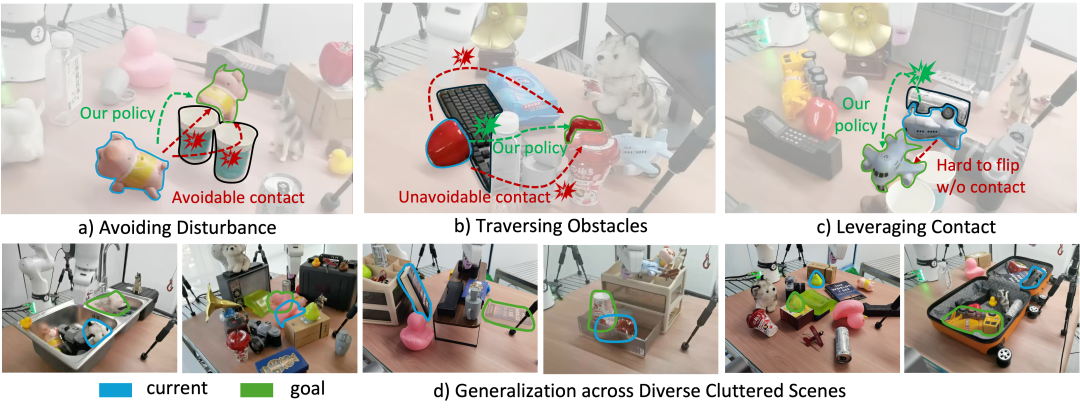
图1:DAPL学到的三类接触选择。自由空间足够时避免无谓碰撞;接触不可避免时穿过障碍;目标难以翻转时主动借周围物体施力。下排展示真实世界测试场景。来源:官方项目页teaser。
因此,论文没有继续给静态点云堆更大的编码器,而是先问一个更物理的问题:如果此刻执行某个动作,场景中的点下一刻会在哪里、以什么速度移动?
DAPL分成两个阶段。第一阶段训练一个物理世界模型,输入目标物体、周围场景和机械臂末端的局部点云。每个点除了三维位置,还带有质量与速度;机器人动作作为条件,一起送入Transformer。模型要预测下一时刻逐点的位置和速度。
这里的逐点预测很关键。只预测每个物体的六维位姿,容易把局部碰撞和接触链压得过粗;只重建静态形状,又学不到运动如何在物体之间传递。作者还给速度场加入方差约束,避免模型面对大量静止点时,退化成“所有速度都接近零”的轻松答案。
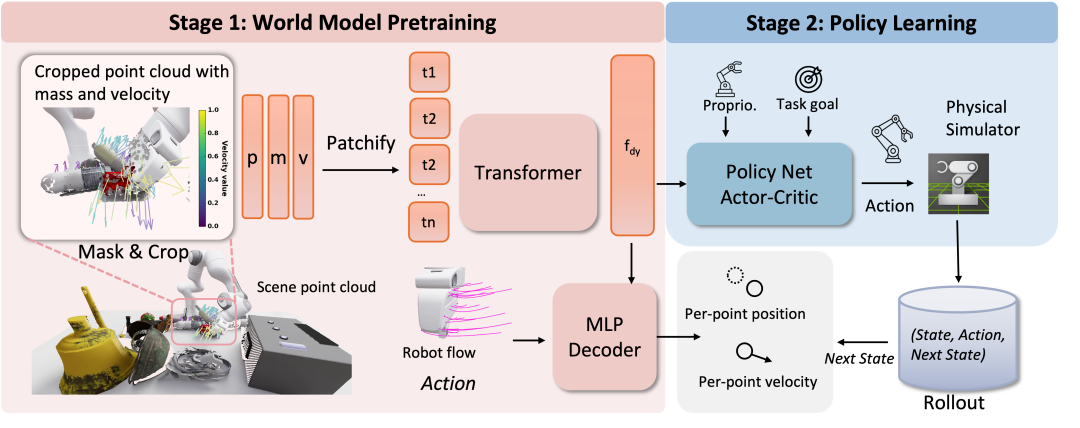
图2:DAPL两阶段框架。左侧世界模型从带有质量、速度的局部点云中提取动力学表征,并预测动作后的逐点运动;右侧强化学习策略把这份表征与机器人本体状态、任务目标一起用于控制。来源:官方项目页方法图。
第二阶段才轮到强化学习策略。世界模型的隐表示会作为物理先验,与关节状态和目标位姿一起进入actor-critic。策略输出连续关节控制,由阻抗控制器执行。奖励仍包含接触、朝向目标运动和成功项,但不需要为“先撞哪个物体、再借哪个支点”逐条手写行为脚本。
世界模型与策略会交替更新。早期策略产生的大量笨拙碰撞,反而暴露了更多接触结果;作者用这些轨迹继续更新世界模型,再让更准确的动力学表征指导下一轮策略。三轮迭代中,成功率从61.3%上升到71.8%。
我们认为,这个循环比“世界模型”四个字本身更值得记。模型专门学习当前策略最容易撞上的真实难题;策略变强以后,又会把数据分布推向更有任务价值的接触。
为了让这件事可测,团队构建了Clutter6D。它关注完整六维物体重排,而非平面上的二维推箱子;场景由约一万件处理后的Objaverse资产组成,包含尺寸、质量、材质与空间关系。
基准按密度分成三档:Sparse放4个物体,Moderate放8个,Dense放12个。每一档都有128个留出场景;任务不仅检查目标是否到达指定位置和朝向,也计算非目标物体被扰动了多少。机器人不能靠把桌面全部扫开来换成功率。
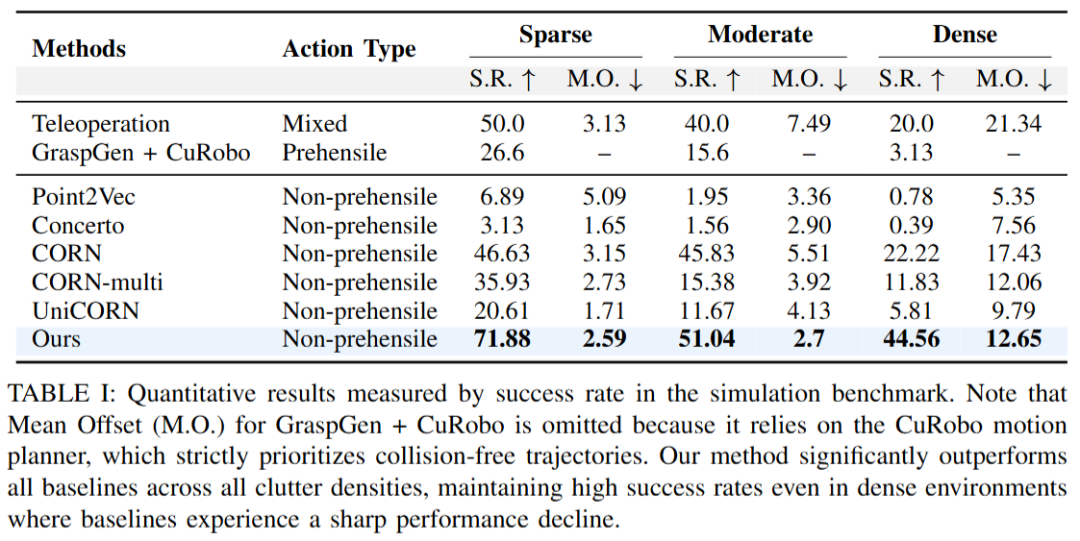
图3:Clutter6D主要结果。S.R.为成功率,M.O.为非目标物体平均偏移。场景越密,静态几何方法下降越明显;DAPL在Dense场景达到44.56%。来源:论文Table I、官方项目页。
最有区分度的是Dense。静态接触表征CORN的成功率从稀疏场景的46.63%降到22.22%,DAPL在12个物体的密集场景仍达到44.56%,正好翻了一倍;人工遥操作在同一档为20%。与此同时,DAPL对周围物体造成的平均偏移为12.65厘米,低于CORN的17.43厘米。
这说明更高成功率并非来自更用力地横扫障碍。策略需要在接触不可避免时穿过去,也要在自由空间足够时收手,还要挑出真正能提供支撑的邻居。
只看最终分数仍有一个漏洞:DAPL会不会只是记住了常见几何布局,所谓动力学表征只是多出来的一组特征?论文用两类实验回答了这个问题。
先看消融。在Sparse场景中,完整模型达到71.88%;拿掉速度和物理属性,只留下逐点世界模型后,成功率降到42%。换成静态重建任务,即使保留速度与物理输入,也只有29.63%。收益来自预测交互后的运动,而非单纯增加模型容量。
更直观的是质量交换实验。作者保持物体位置、目标和外观不变,只交换一块派与薯片罐的质量。派更重时,策略主动把它当作稳定支点,用接触产生翻转所需的力矩;派变轻后,机器人转而避开它,改借另一件重物完成动作。
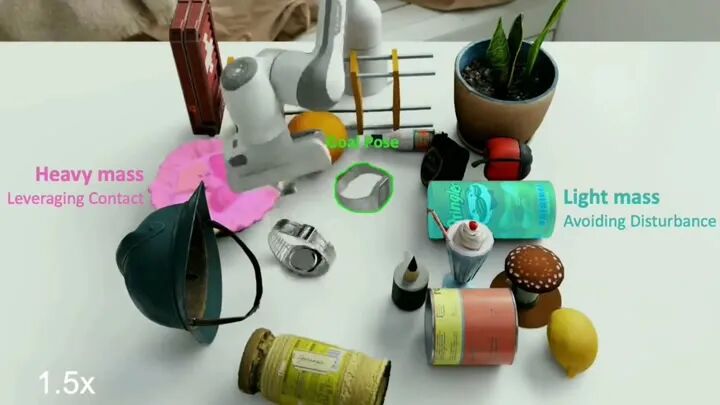
图4:相同场景、不同质量分配下的自适应行为。策略会在“借重物发力”和“避开轻物体”之间切换。来源:官方项目页Adaptive Behavior视频帧。
同一张几何地图给出了两条不同路线,变化只来自物理属性。这是论文最接近“策略确实在使用动力学”的证据,也把外在灵巧性说得更准确:并非接触越多越好,而是知道哪一次接触会帮助任务。
仿真策略随后零样本部署到Franka Research 3。系统用三台RealSense获取点云,SAM2与XMem负责分割和跟踪,FoundationPose估计位姿;质量由视觉语言模型给出粗略先验,速度通过时间差分与滤波获得。作者没有假设真机能拿到模拟器里的完美物理状态。
在10个真实杂乱场景中,DAPL平均成功率为48%,人工遥操作为52%。它没有在成功率上超过人,但平均执行时间是42.6秒,快于人工的55.9秒。这组结果支持一个克制得多的结论:粗糙的质量和速度估计,已经足以让策略在真机上做出有用的接触选择;它距离普遍超越人的操作能力还很远。
团队又把这项能力接到银河通用Galbot G1的货架任务里。VLM规划器先把“拿出饼干盒”转换成目标位姿;DAPL负责抓取前最麻烦的一段,把夹不到的商品滑出、转正,送到下游抓取模块能够接手的位置。策略在数字孪生中训练,没有使用真实货架交互数据。
这个组合暴露了DAPL的产业位置。它位于语言规划与最终抓取之间,是一项pre-grasping skill:当商品排列让常规抓取失效时,先用环境接触制造一个可抓状态。对于真实零售货架,这往往比再换一套抓取姿态更接近问题本身。
DAPL把世界模型从视觉预测推进到一个更具体的位置:它不负责想象整段未来,而是为当前控制策略提供局部、逐点、带物理属性的接触后果表征。对机器人学习而言,这条路线的价值在于重新定义了场景。周围物体不再只有“障碍”和“目标”两种身份,它们还可能是支点、缓冲、通道,或一碰就会破坏任务的轻质干扰物。
先别把它扩展成通用物理智能。真机评测只有10个场景,每个场景5次试验;任务集中在刚性物体的桌面重排,成功阈值与90秒预算也写得很明确。质量和速度仍需要外部模块估计,论文没有处理关节物体、柔性包装、丰富触觉或长程多阶段操作。货架演示还依赖独立的VLM规划与抓取模块,代码和基准目前也仍在准备中。
但它已经跨过了一个值得RSS Best Paper Finalist关注的门槛。过去,机器人看到杂乱场景,首先想到的是避开;DAPL让策略有机会先估计碰撞之后的运动,再决定避开、穿过,还是借力。
银河通用王鹤团队这项工作最值得留下的,不是把“推”做成了新的万能动作,而是让接触第一次以可学习、可迁移的动力学表征进入策略。货架越拥挤,这个区别越重要。
