


来源:具身智能导航
原文链接:https://mp\.weixin\.qq\.com/s/jQxNrurkc90Z5eE\_PsVwcA
❝ - 论文标题:3DGSNav: Enhancing Vision-Language Model Reasoning for Object Navigation via Active 3D Gaussian Splatting
- 作者:Wancai Zheng, Hao Chen, Xianlong Lu, Linlin Ou, Xinyi Yu
- 单位:浙江工业大学,浙江大学
- 论文链接:https://arxiv\.org/abs/2602\.12159
- 项目主页:https://aczheng\-cai\.github\.io/3dgsnav\.github\.io/
一段话总结
本文提出了3DGSNav,一种新颖的零样本目标导航框架,其核心创新在于将3D高斯泼溅(3DGS)作为视觉语言模型(VLM)的持久记忆表示。该系统通过主动感知增量构建环境的3DGS表示,并利用轨迹引导的自由视点优化策略渲染信息丰富的第一人称视图。结合结构化视觉提示和链式思维(CoT)推理,3DGSNav使VLM能够直接从视觉观测中进行空间推理和长程规划,无需依赖传统的语义地图或文本场景抽象。在HM3Dv1、HM3Dv2和MP3D等基准测试上,该方法相比现有最优方法平均提升了13.5%的成功率和32.08%的路径效率,并在四足机器人平台上实现了69.44%的真实世界导航成功率。
研究背景:具身智能的"找东西"难题
1. 目标导航任务的挑战
目标导航(Object Navigation)是具身智能的基础能力之一,要求智能体在完全未知的环境中,仅凭自然语言指令(如"找到一把椅子")自主探索并定位目标物体。这一任务的核心挑战在于:智能体需要同时理解复杂场景的空间结构与语义信息,并基于持续观测进行长程规划。
近年来,视觉语言模型(VLM)凭借其强大的上下文理解和推理能力,为零样本目标导航(ZSON)带来了新的可能。然而,现有方法普遍存在一个关键瓶颈:它们通常将环境抽象为文本描述或语义价值图,这种"场景抽象"策略虽然简化了规划过程,却不可避免地丢失了物体之间的连续空间结构和精细几何关系。更重要的是,这迫使VLM的高层决策严重依赖低层感知模块的准确性,无法充分发挥其固有的视觉空间推理潜力。
2. 本文的动机与意义
本文的核心观察是:VLM已展现出生成旅行指南、总结长文档、编辑图像等令人印象深刻的能力,这表明它们具备强大的规划、文本推理和视觉推理能力。因此,一个关键问题是:如何最大化VLM在零样本导航规划中的潜力,同时避免低层感知的瓶颈约束?
为解决这一问题,作者提出用3D高斯泼溅(3DGS)构建环境表示作为VLM的"持久记忆",使VLM能够直接从高质量渲染的视觉观测中进行分析和决策,而非依赖中间的场景抽象表示。
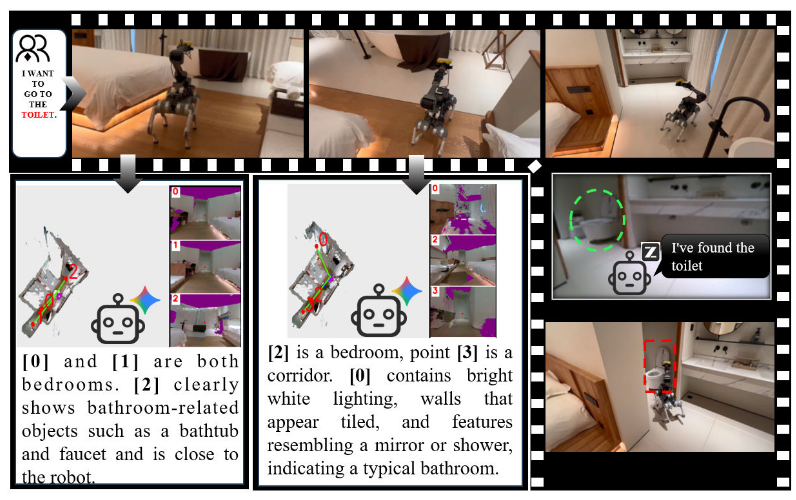
主要贡献
方法详解
1. 任务定义与系统概览
在零样本目标导航任务中,给定自然语言指令(如"找一把椅子"),智能体需要在未知环境中自主探索,导航至距离目标物体一定范围内并停留,且需在最大步数限制内完成。每个时间步,智能体接收RGB图像、深度图和位姿信息,导航策略输出相应动作。
3DGSNav系统由三个核心模块组成:感知模块负责通过主动感知构建3DGS环境表示和导航地图;规划模块通过自由视点优化渲染信息丰富的FPV,结合结构化视觉提示和CoT推理选择最优探索目标;重验证模块利用实时检测器识别潜在目标,并通过VLM驱动的主动视点切换进行目标确认。
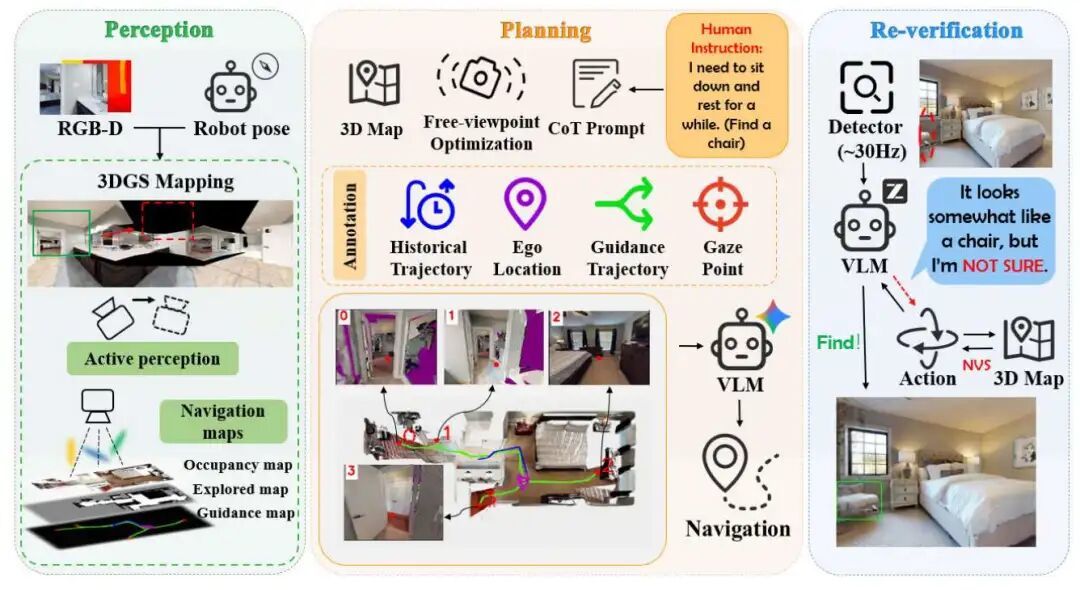
2. 感知模块:构建3DGS记忆
3DGS用一组各向异性高斯基元表示3D场景,每个基元由位置μ、不透明度o、颜色c和协方差矩阵Σ定义。通过可微分渲染,可以从任意视点高效合成RGB图像、深度图和不透明度图。3D地图在后端通过光度损失和深度损失进行优化,实现高质量的新视角合成。
传统方法通常依赖被动的旋转扫描来获取环境信息,效率较低。本文提出了基于不透明度驱动的主动感知方法:利用虚拟相机的灵活性,渲染全景不透明度场来估计观测完整度;然后应用DBSCAN聚类算法识别低不透明度区域,从连续视点空间中提取离散的目标视点。
具体而言,系统从最大低不透明度区域计算目标视点的俯仰角θ和偏航角φ,引导真实相机主动覆盖视觉缺失区域。这种策略不仅避免了机械旋转带来的定位误差和冗余观测,还显著提升了长程导航中的探索效率和鲁棒性。
在3DGS空间中,系统通过整合俯视角度的不透明度渲染和智能体高度信息来构建探索地图。前沿点定义为已探索区域与未探索区域的边界,从探索地图中提取并基于切比雪夫距离进行位置优化。
一个关键观察是:从离散前沿点渲染FPV往往只能获得不完整或局部的观测,而同一区域内的多个前沿点共同捕获更丰富的环境上下文。因此,作者提出了空间结构自适应的前沿点聚类方法:基于探索地图的几何信息构建距离场,检测局部距离极大值作为核心骨架点,然后利用分水岭分割算法将前沿点聚类,选取每个分割区域的质心作为代表性前沿点。这种聚类策略既提升了渲染质量,又减少了分析孤立前沿点的计算开销。
引导轨迹为自由视点优化提供原则性参考,并帮助VLM建立空间意识。系统设计了基于距离变换的代价函数来引导Dijkstra算法搜索到达每个前沿点的最短路径,同时防止轨迹过于贴近障碍物边界。
代价函数包含父节点代价、步长项和指数惩罚项。当到最近障碍物的距离低于安全阈值时,惩罚项被激活,通过构建具有非线性梯度的虚拟人工势场,使代价随障碍物距离减小而指数增长,有效引导轨迹远离高风险区域。
3. 规划模块:VLM驱动的智能决策
由于引导轨迹代表最短路径,沿轨迹最靠近前沿点的转弯处通常能提供更好的前沿区域可见性。作者设计了基于曲率κ和距离d的加权评分策略来确定初始虚拟视点位置:
系统在有效候选集(受最小安全距离和最大回溯距离约束)中选择评分最高的点作为初始位置,结合朝向前沿点的方向确定初始位姿。这确保初始位置既不会太近影响优化效率,也不会太远导致解空间不稳定。
初始位姿无法应对所有场景,某些视点可能被遮挡导致VLM无法推理前沿信息。为此,系统将相机位姿估计建模为多约束优化问题,通过迭代优化相机的旋转四元数q和平移t来最小化复合损失函数。
复合损失函数包含四个组成部分:
其中,引导轨迹损失引入了自适应权重机制,根据不透明度损失自动调整,鼓励相机在优化过程中向前沿点靠近。
为增强VLM对空间结构和时间演化的理解,系统对FPV和BEV应用在线视觉标注:
系统将FPV和BEV整合为单一复合图像,结合链式思维提示送入VLM(Gemini3-Pro)来确定下一个前沿点。然后使用快速行进方法(FMM)导航智能体从当前位置到达长程目标。
4. 重验证模块:精确目标确认
检测准确性至关重要,因为它为智能体提供任务完成的终止信号。现有方法通常通过驱动智能体改变位姿来获取新观测以应对检测不确定性,但这往往带来额外探索成本并降低整体导航效率。
本文采用支持开放词汇检测的实时检测器(YOLOE)在导航过程中感知潜在目标。当检测到潜在目标时,包含检测结果的图像被送入动作决策VLM(GLM-4.5v),该VLM基于环境结构和物体遮挡推理决定是否需要进一步动作。
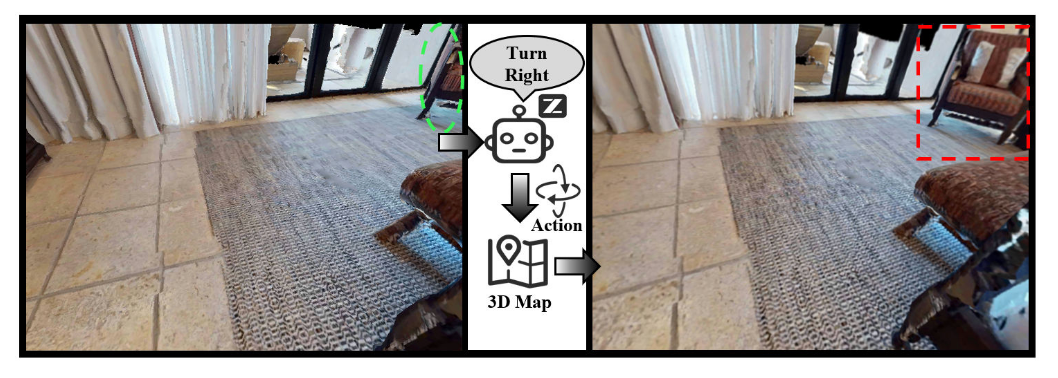
关键创新在于:选定的动作不是驱动机器人物理移动,而是投影到3DGS空间中渲染新视角,实现基于主动视点的目标重验证。这种方法既能获得更具判别性的观测以确认目标,又避免了实际移动带来的时间和能量开销。
实验设置与结果
1. 实验设置
数据集:实验在Habitat仿真器中的三个数据集上进行:
评估指标:
实现细节:VLM规划器使用Gemini3-Pro,实时目标检测使用YOLOE,动作决策VLM使用GLM-4.5v。所有仿真实验在NVIDIA RTX 4060 Ti 16GB GPU上进行。
2. 基准对比结果
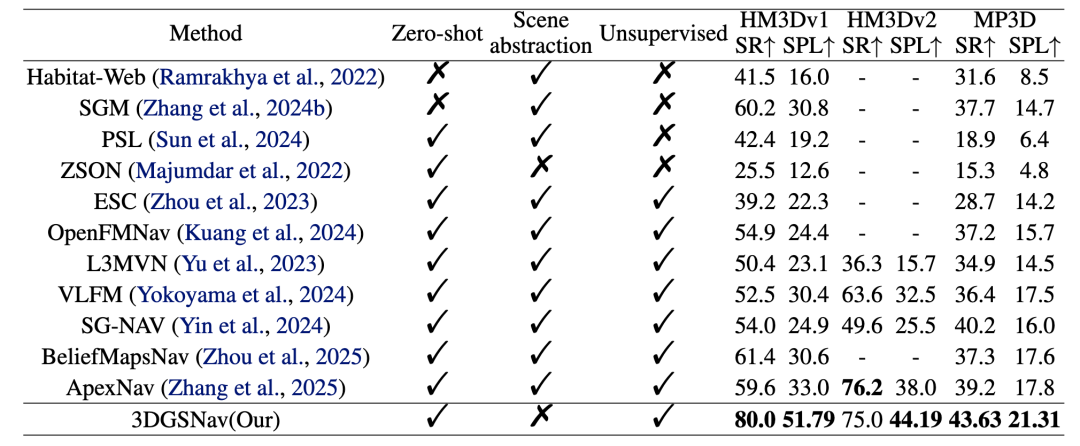
与现有最优方法相比,3DGSNav在成功率上平均提升13.5%,在SPL上平均提升32.08%。具体而言:
3. 不同VLM的对比分析
实验对比了不同VLM的表现:随机选择前沿点、Qwen3-VL-32b-Thinking、Qwen3-VL-235b-Thinking和Gemini3-Pro。结果显示:
通过自解释分析发现,Gemini3展现出更强的图像理解和空间理解能力,能够通过BEV推断不同前沿点之间的空间关系,而非进行孤立分析或做出不准确推断。
4. 消融实验
5. 失败案例分析
失败原因统计显示:
6. 真实机器人实验
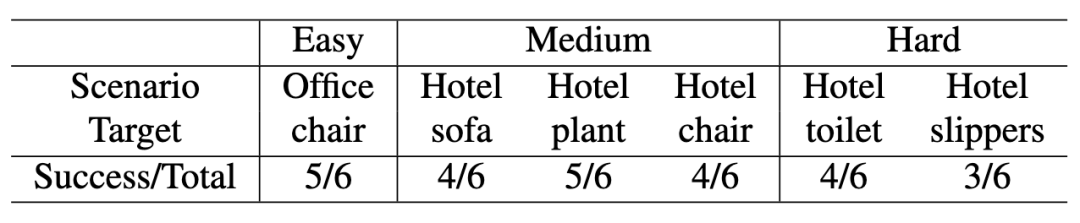
在Go2四足机器人上进行了真实世界实验,机器人配备Intel RealSense D455 RGB-D相机和6自由度机械臂。在办公室和酒店环境中的六组实验(难度递增)中,方法达到了69.44%的总体成功率,验证了在真实场景中的鲁棒性和有效性。
总结
本文提出了3DGSNav,一种新颖的零样本目标导航框架,核心创新在于将3D高斯泼溅作为VLM的持久记忆表示。通过结合主动感知、轨迹引导的自由视点渲染和结构化视觉提示与链式思维推理,该方法实现了高效的空间推理和规划能力。实验结果表明,3DGSNav在仿真基准和真实机器人平台上都取得了强劲的性能表现。
局限性:当前方法基于二维导航策略,无法进行跨楼层导航;RGB-D相机在玻璃表面、强镜面反射和高度中空结构环境中容易出现感知失败;四足机器人携带机械臂时的负载不平衡会影响行走轨迹稳定性。
未来方向:作者表示将致力于提升方法的通用性以支持更广泛的任务类型;将机械臂主动感知与四足行走策略紧密集成,实现感知与运动的统一协调控制。
原文链接: https://www.leiphone.com/category/private/WIunDZQAAZ1wOFRv.html
