


来源:未来清研TSINGTEC
原文链接:https://mp.weixin.qq.com/s/gpqDRbZoxXahlnh2awlAwA
导语
机器人学会“举一反三”有多难?一个老问题——模型换个场景就“失忆”——最近被一篇论文用两个精巧的设计给破了。更炸裂的是,它只用了 0.3B 参数,就干翻了 7B 的大模型,平均成功率飙到 95.3%。今天这篇,咱们就把它的核心思路拆开揉碎,看看这背后的“层混合”与“元技能”到底是个什么神仙操作。
你是不是也遇到过这种情况?一个视觉-语言-动作(VLA)模型,在训练场景里抓苹果放篮子,成功率高达 85% 以上,可一旦指令换成“准备水果放在托盘上”,成功率瞬间跌到 50% 以下。更离谱的是,你再问它“苹果在图像中的位置”,它直接输出一堆乱码——视觉问答能力彻底崩了。这,就是当前主流 VLA 模型最大的痛:灾难性遗忘。
但为什么 99% 的优化尝试都失败了?关键就在架构设计上。大多数方法选择在机器人数据集上微调整个 VLM 骨干网络,这就像让一个通晓百科全书的博士去学开挖掘机,结果挖掘机没开好,连微积分都忘了。而这篇论文的作者提出了一个反常识的观点:一个通用的 VLM,根本不需要动它的“大脑”,通过精巧的“外挂”就能成为机器人操作的顶级专家。
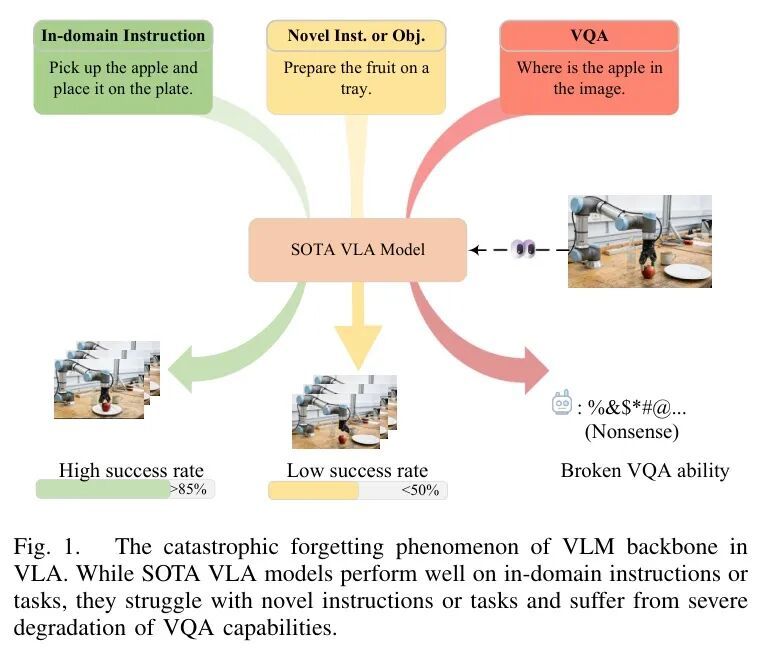
图:VLA模型在不同任务下的表现差异,绿色(域内指令)成功率>85%,黄色(新指令)<50%,红色(VQA任务)能力严重退化,揭示了灾难性遗忘问题的严重性
这个“外挂”方案就是 M²-VLA,它的核心架构你一眼就能看懂。左边是输入,包括机器人看到的画面和人类说的指令,通过 SigLIP 和 DINOv2 两个视觉编码器提取特征,再加上一组可学习的查询 Token(V, L, S),一起喂给中间的多层 Transformer。但重点来了——右边的两个创新模块:MoL(Mixture of Layers)和 MSM(Meta Skill Module)。MoL 负责从 VLM 的每一层中智能筛选出对当前任务最有用的信息,MSM 则像一个经验丰富的老师傅,从历史成功案例中检索最相关的“元技能”来指导当前的动作生成。而且,整个 VLM 骨干网络全程冻结,这就保住了它原有的泛化能力。
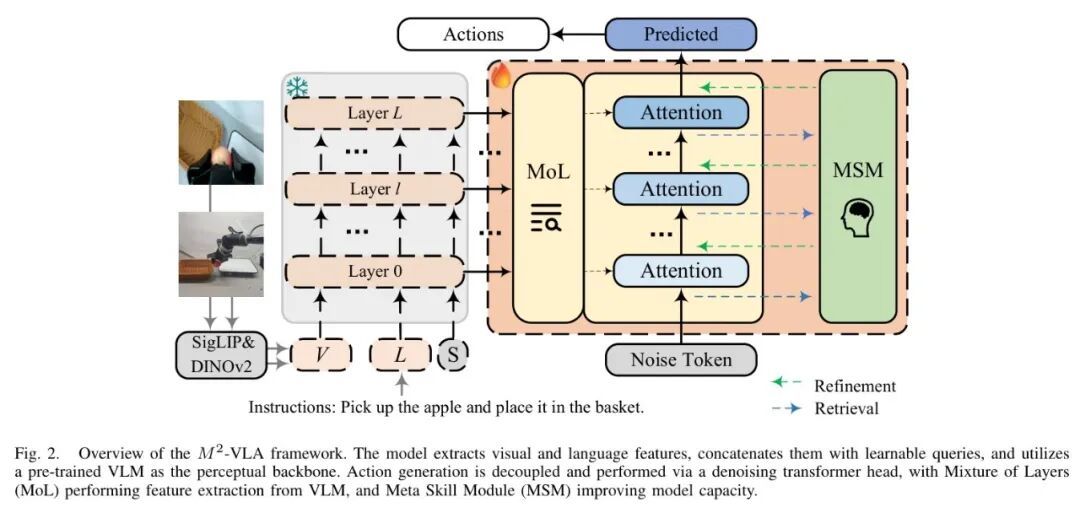
图:M²-VLA 整体架构,左侧为视觉和语言输入,中间为冻结的 VLM 骨干网络,右侧为 MoL 和 MSM 两个核心模块,绿色虚线为精炼流,蓝色虚线为检索流
咱们先拆第一个核心:MoL。为什么需要它?想象一下,VLM 的每一层都像是一个不同领域的专家。浅层关注边缘、纹理,中层理解物体形状,深层掌握语义概念。但机器人操作需要的是精细的空间信息,比如“夹爪应该往哪个方向移动 3 厘米”。直接拿所有层的信息去用,就像让一个团队里所有人都同时发言,信息过载且互相干扰。MoL 的做法是:让动作头自己决定“我现在需要听谁的”。
具体来说,MoL 在动作头的每一层都设计了三个并行的注意力分支。第一个分支关注语义特征 S,通过一个动态的门控因子 α_S 来决定当前应该从语义信息中提取多少。这个因子不是固定的,而是根据当前输入的语义特征自适应计算的:。然后,这个因子会调节注意力分数的计算:。第二个分支关注视觉特征 V,但考虑到视觉特征维度太高,动态计算开销太大,所以采用一个可学习的静态因子 α_v 来调节:。第三个分支则是对动作潜在表示自己做自注意力,抑制噪声。最后,三个分支的输出取平均,得到这一层的最终表示。
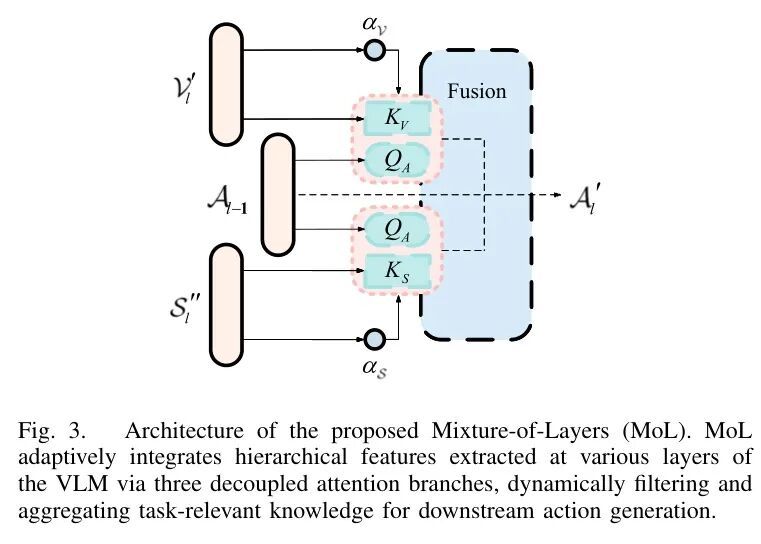
这个设计太巧妙了!它解决了两个关键问题:一是避免了不同模态特征在 softmax 操作中的尺度不一致问题(因为分开了),二是通过动态门控实现了“按需取用”,让模型自己学会在什么场景下更依赖语义理解,什么场景下更依赖视觉细节。
但光有 MoL 还不够。动作头的参数是轻量级的,它的“容量”有限,就像一个小本子,记不了太多复杂的轨迹模式。怎么在有限参数下学更多东西?答案就是 MSM——元技能模块。
MSM 的思路非常直观:别从头开始学每个新动作,去查查以前是怎么做的。它维护了一个外部队列 M,里面存着键值对。键是感知上下文,由 VLM 的浅层、中层、深层特征拼接而成:。值是对应成功完成任务的未来动作序列。这个队列,就是机器人的“元技能仓库”。
当机器人要执行一个新任务时,它用当前观测的多层次特征作为查询,从仓库里用 L1 距离检索出最相似的 R 个技能(比如4个)。然后,通过交叉注意力机制,把这些检索到的技能作为参考,融合到当前的动作生成流中:。最终的动作通过残差学习得到:。
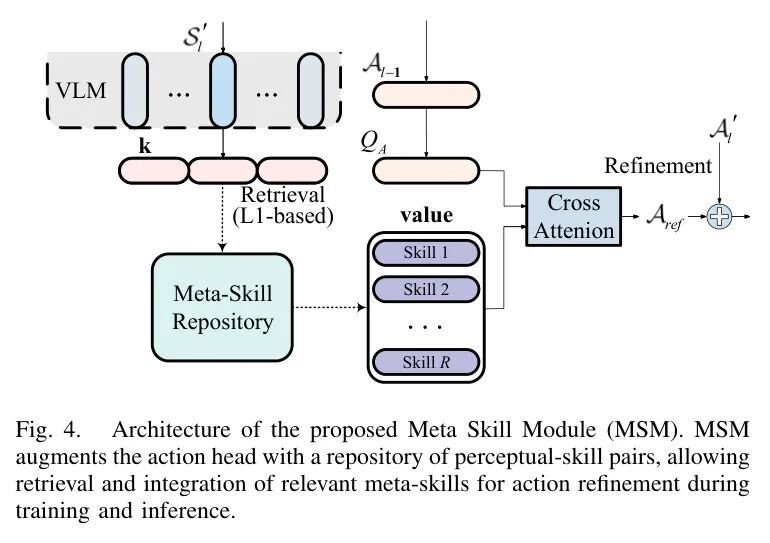
图:MSM 模块内部架构,通过 L1 距离从 Meta-Skill Repository 中检索相关技能,并利用 Cross Attention 机制融合到当前动作生成中,实现动作精炼
这个设计在真实世界中效果如何?咱们来看实验数据。在模拟基准 LIBERO 上,M²-VLA 以 0.3B 的参数量,在四个任务套件上平均成功率高达 95.3%,而参数量 7B 的 OpenVLA 只有 78.6%,同样 0.3B 的 SmolVLA 是 73.5%。更关键的是,M²-VLA 不需要微调 VLM 骨干网络,而其他方法大多需要。
| M²-VLA | 0.3B | 96.8 | 94.2 | 95.5 | 94.7 | 95.3 |
表:模拟基准测试结果对比,M²-VLA 以 0.3B 参数量在所有任务上取得最佳性能,且无需微调 VLM 骨干网络
在真实世界中,M²-VLA 同样表现惊艳。在“拿起苹果放入篮子”和“向碗中倒水”两个基础任务上,成功率分别达到 95% 和 90%,远超其他方法。在更具挑战性的泛化任务中,比如指令跟随(“在木制容器中准备水果”)和抓取新物体(水瓶或玩具鸭),M²-VLA 的成功率依然保持在 80% 以上,而其他方法普遍跌到 50% 以下。
| M²-VLA | 95 | 90 | 85 | 80 |
表:真实世界任务成功率对比,M²-VLA 在所有任务上均取得最高成功率,尤其在泛化任务中表现突出
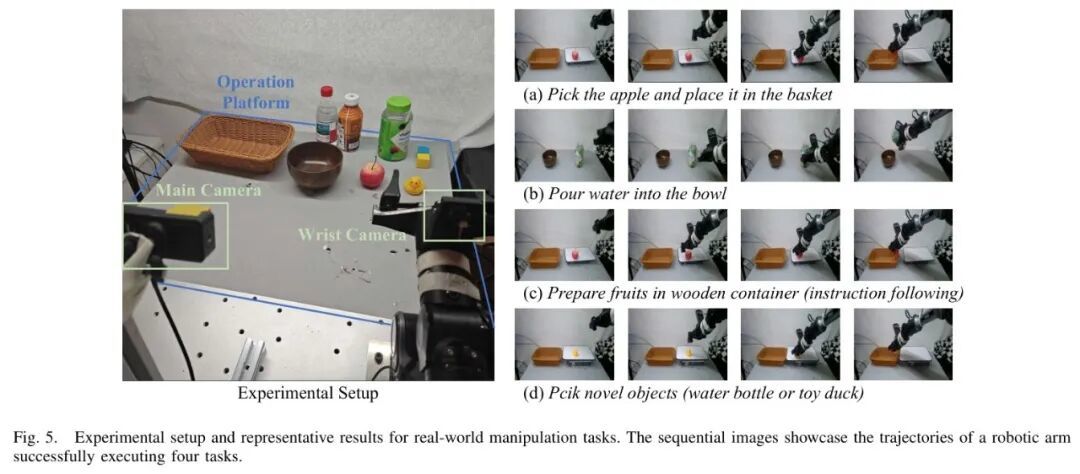
图:真实世界机器人操作任务序列图像,展示了 M²-VLA 在(a)苹果入篮、(b)倒水入碗、(c)指令跟随、(d)抓取新物体等任务中的成功执行轨迹
为了验证每个组件的贡献,作者还做了消融实验。去掉 MoL 和 MSM 后,模型性能从 75.0% 暴跌到 55.2%。单独去掉 MSM,性能降到 62.8%;单独去掉 MoL,性能降到 68.5%。这说明两个模块缺一不可,且 MoL 的贡献略大于 MSM。
| w/ MoL & w/ MSM | 75.0 |
表:消融实验结果,同时引入 MoL 和 MSM 能显著提升模型性能,单独移除任一模块均导致性能下降
更深入的可视化分析揭示了模型内部的运作机制。通过观察 MoL 中不同层的门控因子 α_S,作者发现模型对中间层(第 19 层左右)给予了更多关注。同时,中间层的注意力热力图显示,模型将注意力聚焦在机械臂夹爪和目标物体上,这说明 MoL 成功地从 VLM 的海量信息中识别出了与操作相关的空间信息。
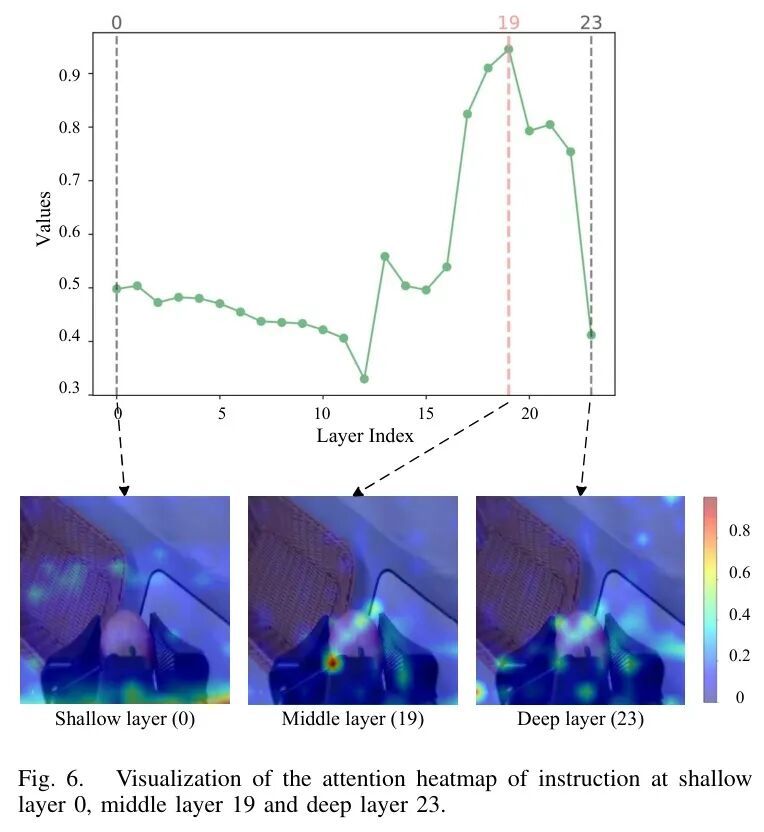
图:指令注意力热力图可视化,上方折线图显示注意力峰值出现在第 19 层,下方热力图显示模型在中间层聚焦于机械臂夹爪和目标物体
此外,MSM 中 Keys 与 Values 的相关性分析显示,两者之间存在显著的正相关性(L1 距离相关系数 0.624,余弦距离相关系数 0.618),验证了键构建策略的有效性——相似的感知上下文确实能检索到有用的元技能。
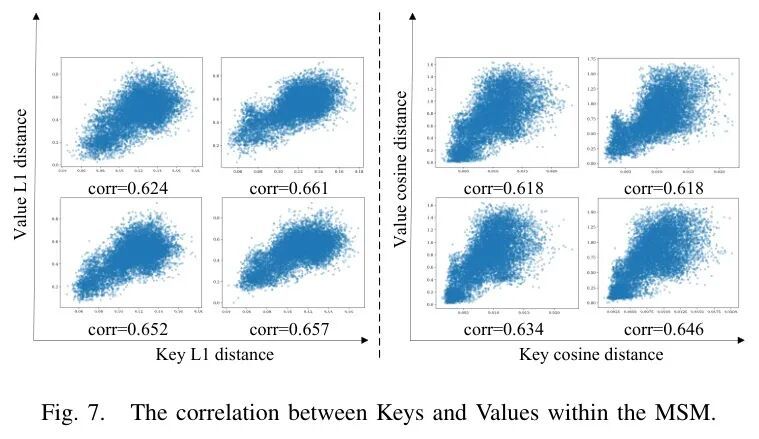
图:MSM 中 Keys 与 Values 的相关性分析,L1 距离和余弦距离均显示出显著的正相关性,验证了记忆单元的语义一致性与结构稳定性
诚实地说,这个方案也有局限性。目前它只适用于单一机器人平台,未来需要为不同任务和机器人形态定制多个动作头。另外,MSM 的检索效率在超大技能库下可能会成为瓶颈。但瑕不掩瑜,M²-VLA 的思路——冻结通用 VLM,通过轻量级外挂模块实现高效适配——为机器人操作领域提供了一个极具潜力的新范式。
走向AGI终局
打造未来清研双矩阵战略飞轮
信息来源:M²-VLA: Boosting Vision-Language Models for Generalizable Manipulation via Layer Mixture and Meta-Skills
