


来源:公众号南方科技大学统计与数据科学系
2026年上半年统计与数据科学系师生作为第一作者/通讯作者在机器学习领域顶会(ICML、ICLR)、计算机视觉领域顶会(CVPR)、自然语言处理领域顶会(ACL)以及人工智能综合顶会(AAAI)共发表论文34篇,成果覆盖可信人工智能、人工智能的安全隐私、大模型路由、大语言模型、图像生成等。
01
面向对抗性干扰的匹配市场多臂老虎机学习
Bandit Learning in Matching Markets Robust to Adversarial Corruptions
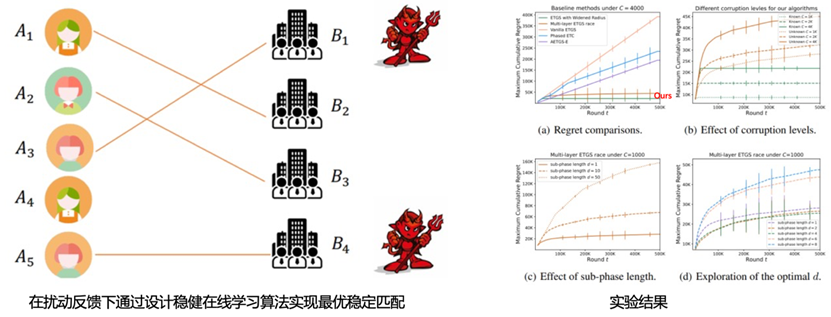
Bandit学习框架已广泛应用于未知偏好匹配市场中的在线学习问题。然而,现有算法通常假设用户反馈真实可靠,而现实场景中,外部噪声或恶意干扰往往会污染反馈信号。例如,服务器资源分配中的性能伪装、广告投放中的点击欺诈等,都会显著影响学习与匹配效果。已有算法在面对扰动反馈时表现极为脆弱:即使只有少量反馈被干扰,也可能导致玩家长期匹配到次优臂。针对这一问题,本文系统研究了存在对抗性扰动的去中心化匹配市场Bandit学习问题。围绕扰动水平已知与未知两类场景,本文分别设计了稳健学习算法,从理论上证明所提算法能够收敛至最优稳定匹配,同时刻画了学习效率与扰动水平之间的依赖关系。仿真实验进一步验证了算法的有效性:与现有基线方法相比,本文所提算法在受污染反馈环境中表现出更强的稳健性。
论文作者:
伍哲舜,左金航,徐增林,孔芳*
会议:
国际表征学习大会2026(International Conference on Learning Representations,ICLR2026)
02
面向多维数据恢复的重参数化张量环函数分解
Reparameterized Tensor Ring Functional Decomposition for Multi-Dimensional Data Recovery
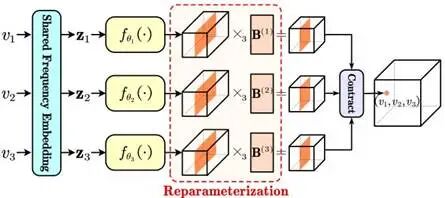
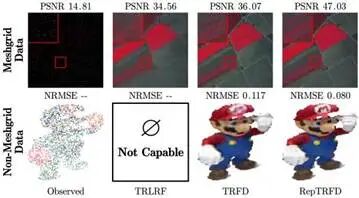
张量环分解是高阶数据建模的重要工具,但传统张量环分解受限于固定网格上的离散表示。为将离散张量分解推广至连续表示,本文提出一种适用于网格与非网格数据的张量环函数分解框架,通过隐式神经表示对张量环因子进行参数化。然而,该连续框架在优化过程中难以有效捕捉精细尺度信息。针对这一问题,本文从频域角度揭示其内在原因,并提出重参数化张量环函数分解方法,将每个张量环因子表示为可学习潜张量与固定基矩阵的结构化组合。理论分析表明,该机制能够改善因子学习的训练动力学,并提供严格的Lipschitz连续性保证。在多种网格与非网格数据恢复任务上的实验表明,所提方法持续优于现有基准方法。
论文作者:
徐阳洋,柯钧博,文有为,王超*
会议:
国际计算机视觉与模式识别会议2026 (IEEE/CVF Conference on Computer Vision and Pattern Recognition,CVPR 2026)
03
基于引导式微调与迁移的指令微调语言模型增强方法
GIFT: Guided Fine-Tuning and Transfer for Enhancing Instruction-Tuned Language Models
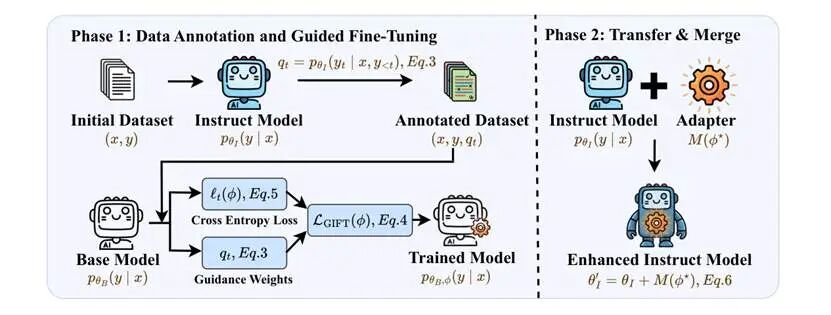
经过指令微调的大语言模型已具备较强的通用能力,但在新任务上继续微调时,往往容易破坏原有的指令遵循和知识能力。现有迁移式微调方法通常先在基础模型上学习任务更新,再合并回指令模型,但没有利用指令模型指导训练过程。本文提出 GIFT,将指令模型从“合并目标”变为“训练指导者”:通过指令模型的 token 级置信度重加权于基础模型的 adapter 训练,使模型聚焦更可靠的学习信号,再将 adapter 合并回指令模型。实验表明,GIFT 在数学推理、医学问答等任务上稳定提升性能,同时保持通用能力与指令遵循能力。该工作已被 ACL 2026 Main Conference 接收。
论文作者:
阮志文,杜逸超,郑剑杰,王龙跃,陈云,李鹏,苏劲松,刘洋,陈冠华*
会议:
国际计算语言学协会2026(Annual Meeting of the Association for Computational Linguistics,ACL2026)
04
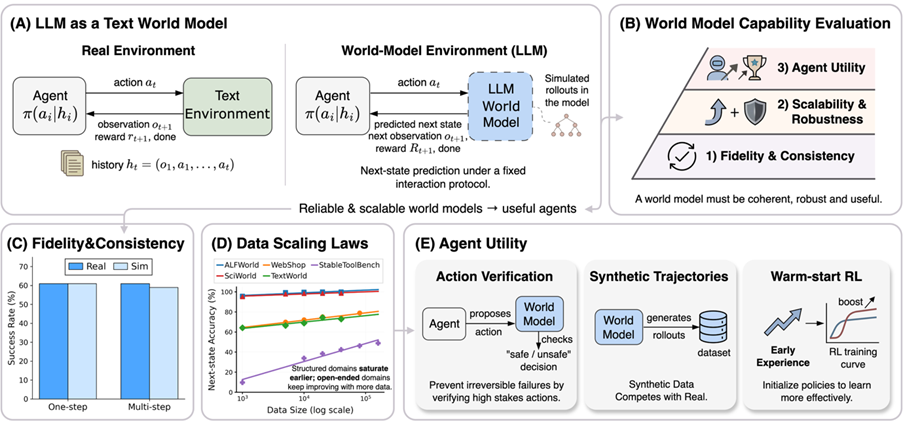
大模型作为文本世界模型的能力评测
From Word to World: Can Large Language Models be Implicit Text-based World Models?
智能体强化学习近年来快速发展,但制约其进一步扩展的瓶颈正从算力与数据转向经验——真实环境交互慢、贵且不可逆,使得世界建模成为关键路径。本文聚焦文本环境,系统探究大语言模型能否充当可靠的隐式世界模型,提出 Word2World 框架,将世界建模形式化为固定交互协议下的多轮 next-state 预测,并构建覆盖逼真度、可扩展性与智能体效用的三层评估体系。在 ALFWorld、SciWorld、TextWorld、WebShop 与 StableToolBench 五类环境上的大规模实验表明:训练对齐后的 7B/8B 模型在结构化环境上长程一致性超过 0.90;用作预执行验证器可为 GPT-4o 在 WebShop 上带来 +5.5% 提升,用作强化学习暖启动则在 SciWorld 上获得约 15% 增益,充分展示了 LLM 作为智能体可回放经验放大器的通用价值。
论文作者:
李乙侠,王鸿儒,裘嘉豪,尹榛菲,张冬冬,钱成,李泽平,马骁腾,陈冠华,季姮
会议:
国际计算语言学协会2026(Annual Meeting of the Association for Computational Linguistics,ACL2026)
05
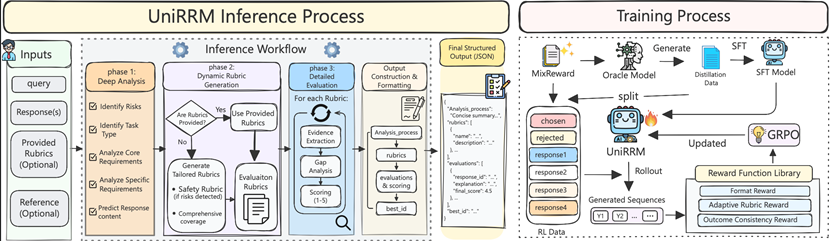
面向跨语言与多评测范式的统一推理奖励模型
UniRRM: Unified Reasoning Reward Models Across Languages and Evaluation Paradigms
强化学习在开放式生成任务中的核心瓶颈,在于奖励模型难以同时兼顾可靠性、泛化性与可扩展性。现有方法通常依赖昂贵的闭源模型进行评估,或受限于缺乏可解释性的黑盒标量奖励,难以统一多语言与多评估范式。为此,我们提出统一推理式奖励建模框架 UniRRM,并构建覆盖六大领域、103 种语言的多语言奖励数据集 MixReward,统一支持pairwise 与 listwise 评估。UniRRM通过精心设计的分阶段推理链动态生成任务相关评估标准,实现细粒度、输入自适应的奖励判断。实验表明,UniRRM 在多个基准上取得接近同规模最先进模型的性能,并对未见评估范式(pointwise)展现出泛化能力。同时,UniRRM 可支撑真实 RL 训练流程,有效提升复杂推理任务中的性能。
论文作者:
赖鹏,杜逸超,吴俊潮,高维博,岳立楠,王龙跃,骆卫华,Derek F. Wong,陈冠华*
会议:
国际机器学习大会2026(International Conference on Machine Learning,ICML2026)
06
贝叶斯采样如何增益成员推理攻击?
How does Bayesian Sampling help Membership Inference Attacks?
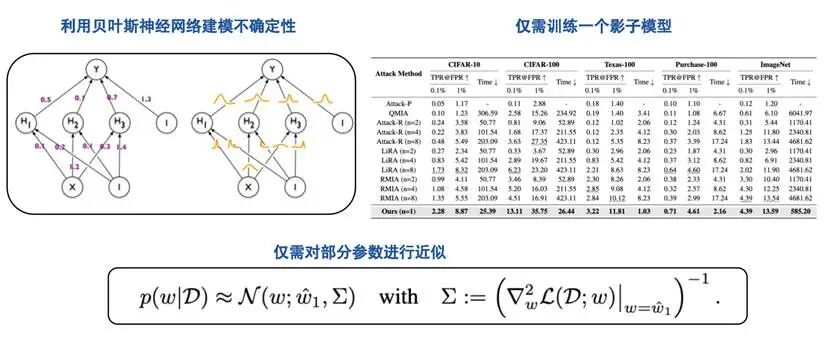
成员推理攻击是为了判断一条数据是否被制定模型训练过。本文从贝叶斯采样的视角切入,把以往主流的成员推理攻击放到"不确定性度量"这一统一框架下来解释。本文动机也很直接——成员身份的推断本质上是一个统计推断问题, 那么"度量不确定"与"减小不确定"实际上是同一件事。基于此,本文利用贝叶斯神经网络采样直接去刻画这种不确定性, 在成员推理攻击任务上的效率和效果上都得到了显著提升。
论文作者:
刘真龙,姜文玉,周峰,魏鸿鑫*
会议:
国际机器学习大会2026(International Conference on Machine Learning,ICML2026)
07
可证明的大语言模型训练数据识别
Provable Training Data Identification for Large Language Models
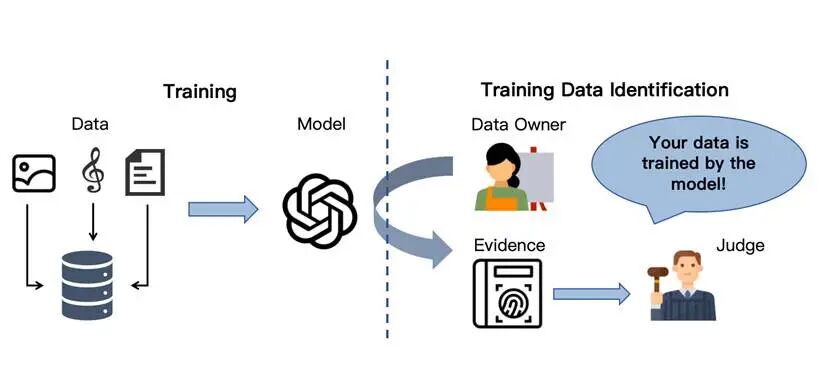
LLM数据版权的法律诉讼通常需要提供高信度的证据。之前社区里的观点普遍认为,成员推理攻击没法证明某条版权数据真的进了 LLM 的训练集。本文的处理方式是放弃逐条判定: 从候选集合里挑出一批疑似被训练过的样本,用 conformal inference 给这一选择过程加上统计保证。挑出来的这批样本里, 有严格理论保证其真正来自训练集的比例足够高,为未来大模型数据版权的司法实践提供统计学证据。
论文作者:
刘真龙,曾浩,黄维然,魏鸿鑫*
会议:
国际机器学习大会2026(International Conference on Machine Learning,ICML2026)
08
RACER:面向大语言模型的风险感知校准高效路由方法
RACER: Risk-Aware Calibrated Efficient Routing for Large Language Models
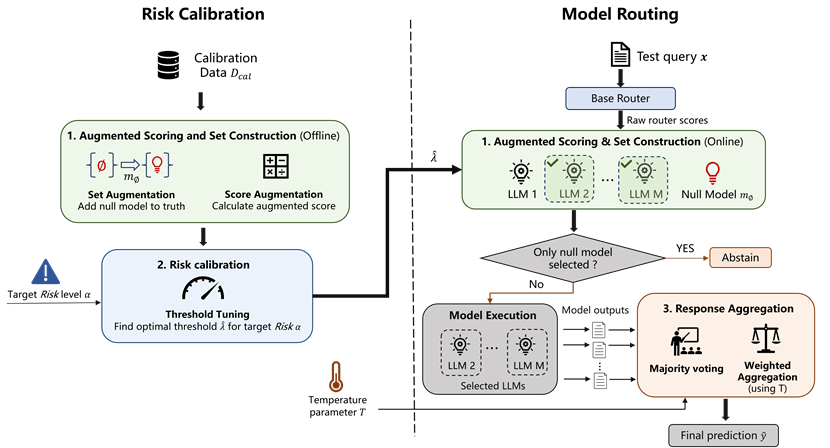
大语言模型在多模型系统中常具有不同能力,如何为每个问题选择合适模型,是提升效率与性能的关键。针对现有路由方法易误选单一模型、缺乏可靠风险控制的问题,本文提出风险感知校准高效路由方法 RACER,将模型路由转化为带风险约束的集合选择问题。该方法无需重新训练基础模型或路由器,可自适应选择候选模型集合,并通过结果聚合提升回答质量。实验表明,RACER 在多类任务上实现稳定风险控制,同时提升下游准确率并减少模型调用开销。
论文作者:
郝赛,曾浩,魏鸿鑫,荆炳义
会议:
国际机器学习大会2026(International Conference on Machine Learning,ICML2026)
09
基于流形投影的流匹配分类器自由引导
Improving classifier-free guidance of flow matching via manifold projection
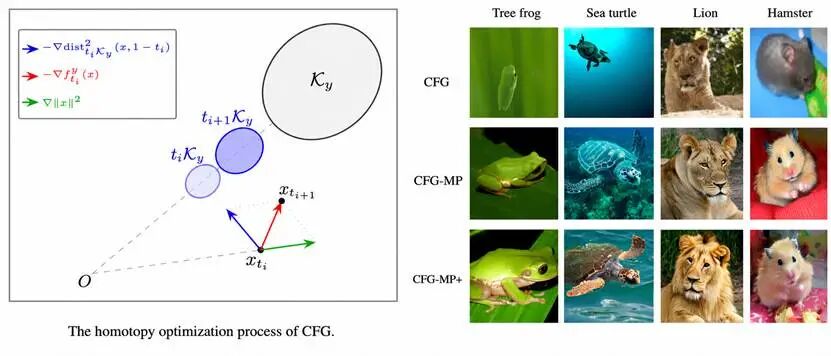
本文从优化视角重新解析了分类器自由引导(CFG)机制,指出传统CFG依赖线性外推导致的稳定性问题。研究揭示了流匹配模型速度场与平滑距离函数梯度的内在联系,并将CFG采样过程建模为带流形约束的同伦优化问题。据此,本文提出CFG-MP方法,通过增量梯度下降实现流形投影以增强引导稳定性,并进一步推出CFG-MP+,引入安德森加速显著提升计算效率与采样质量。该方案无需重训练或额外模型评估,并在多个大规模生成模型上验证。
论文作者:
蔡剑锋、刘海霞、苏政逸(南科大大三本科生)、王超*
会议:
国际机器学习大会2026(International Conference on Machine Learning,ICML2026)
