


来源:Lumina具身智能
文章链接:https://mp\.weixin\.qq\.com/s/jxViNfNSuDrcCmsXf\-MzLw
如果让人形机器人学会翻滚、跳跃和起身,最先遇到的往往不是动作难,而是训练太慢。每次策略更新都要让模拟器把机器人重新跑一遍,动作越多,等待越长。
如果让人形机器人学会翻滚、跳跃和起身,最先遇到的往往不是动作难,而是训练太慢。每次策略更新都要让模拟器把机器人重新跑一遍,动作越多,等待越长。
SuperMimic是伯克利团队在CoRL 2026提出的一套人形机器人全身控制方法。它的做法很直接:用模拟器数据训练一个可微世界模型,让策略先在这个模型里反复试错,再回到物理模拟器检查。
官方项目页给出的结果很有冲击力:一张 H100训练约3小时,超过 SONIC公开模型的归一化回报;SONIC的训练报告使用128张L40、持续7天。下面不只看这个数字,而是追问它怎样做到,以及这个结果真正说明了什么。
****01 SuperMimic先让机器人学什么
SuperMimic 面对的不是“让机器人走起来”这一种单一任务,而是目标条件下的全身动作模仿:给定一段由人体动作捕捉或动作库提供的参考轨迹,策略需要让 Unitree G1在保持动力学可行的同时跟上这段动作。论文系统面向一台29个主动自由度的 G1,控制频率为 50 Hz,也就是每 0.02 秒更新一次动作。
策略每次看到的不是一张图片,而是一组本体状态:关节位置和速度、机体姿态、基座速度、重力方向、上一时刻动作,以及未来一小段参考动作。系统还把最近 10 个观测堆叠起来,缓解单帧观测看不到速度和接触变化的问题;前瞻目标则覆盖未来约 10 帧,给策略留出约0.2秒的动作预期。
这个设定很重要,因为它决定了策略到底在学习什么。策略输出的是 29 维归一化动作,底层再把它映射成关节位置设定点,而不是直接把电机力矩交给策略。这样做把“学会怎样移动”与“如何安全驱动电机”分开:上层策略负责动作意图,底层控制器负责把意图变成可执行的关节运动。
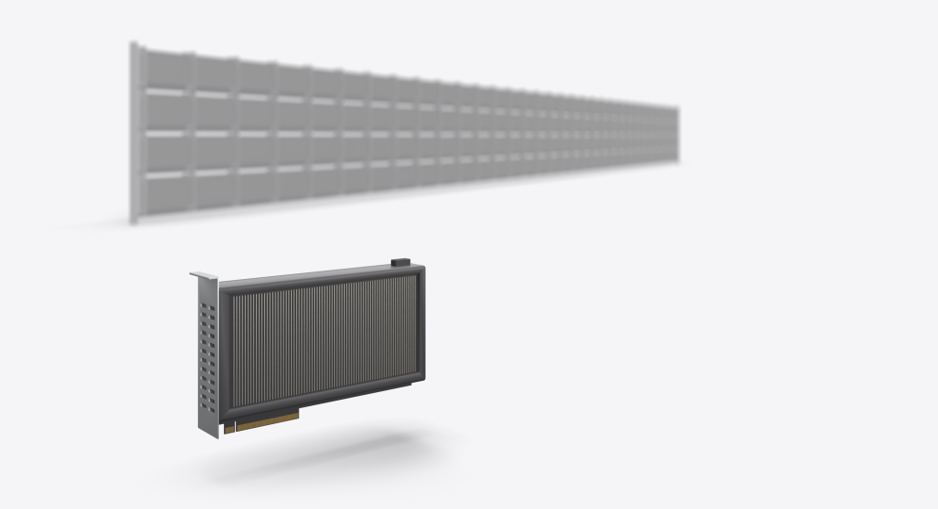
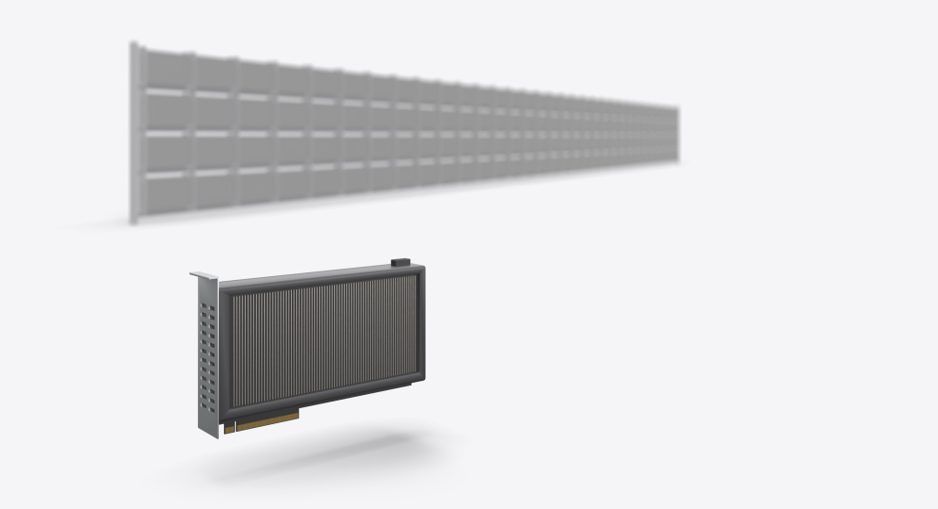
官方项目页:训练成本对比图,展示 SuperMimic 与 SONIC 在训练时间和 GPU 资源上的差异;两种方法的 GPU 型号、数据规模和训练设置并不完全相同
把任务写成目标条件的部分可观测决策过程,可以先看策略接收什么、输出什么。策略根据当前观测和目标生成归一化关节设定点:
aₜ = πθ(oₜ, gₜ)
训练时,模拟器执行的是带噪声的动作:
aₜᵉⁿᵛ = aₜ + εₜ
噪声用于拓宽世界模型看到的状态—动作范围;部署时,策略仍然接收带传感器噪声的观测。这样,训练和真机之间的差异被放进接口里处理。
这张图真正展示的是训练计算被重新分配:模拟器负责提供样本和校验结果,世界模型承担大部分快速试错,策略因此不必每次更新都等待完整的物理仿真。
*02 策略输出,怎样变成机器人的动作***
策略输出的动作向量会先映射到关节参考位置。
qˢᵖ = αaₜ + q⁰
其中 q⁰ 是机器人默认站立姿态,α 控制动作幅度。随后,低刚度 PD 控制器根据位置误差和速度误差生成力矩。低刚度不是简单地把控制做弱,而是给真实机器人保留被动顺应性,让策略在接触、落地和碰撞时不必用过大的力矩硬顶。
这套接口带来一个很实际的好处:同一策略输出可以在仿真和真机上使用相近的动作语义,底层控制器则吸收一部分电机、摩擦和接触差异。也正因为动作经过了低层控制,评测结果反映的是“策略能否生成可跟踪的全身运动”,不能直接理解成策略已经学会了每个电机的精确力矩控制。
SuperMimic 的核心加速发生在更上层。它不让梯度穿过 MuJoCo Warp 本身,因为碰撞和接触带来的状态变化并不平滑;系统先用模拟器记录状态转移,再训练一个可微的世界模型。策略在世界模型里获得更新方向,底层 PD 和原始模拟器仍然负责把动作约束在可执行范围内。
因此,世界模型的输入输出需要与这个控制接口一致:输入是当前本体状态、参考动作和策略动作,输出是下一时刻的状态变化、奖励相关量以及是否接近终止。它不是为了生成视觉上逼真的视频,而是为了在控制训练最关心的局部状态空间里,快速回答“这一步动作会把机器人带到哪里”。
论文没有让一个网络包办所有事情,而是把世界模型拆成四个输出。它先预测动力学状态:
ŝₜ₊₁ = fω(ŝₜ, aₜ, ξ)
再分别预测奖励、无噪观测和终止概率:
r̂ₜ₊₁ = rω(ŝₜ, aₜ, gₜ); ôₜ = gω(ŝₜ, ξ); d̂ₜ = dω(ŝₜ, gₜ)
ξ 包含摩擦、关节校准偏移和躯干质心偏移等仿真上下文。这样,模型既要预测身体怎么动,也要预测策略将看到什么、奖励会怎样变化,以及轨迹是否正在走向失败。
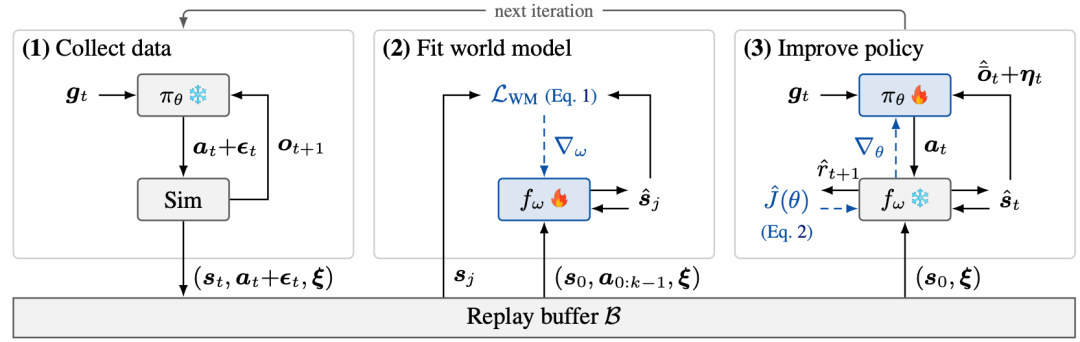
SuperMimic 训练流程
一旦把控制问题写成“动作—状态转移—奖励”的链路,策略就可以在一段预测轨迹上连续更新,而不必把每个候选动作都交给物理引擎完整执行。这是 SuperMimic 把训练瓶颈从模拟器交互转移到可批量矩阵计算的关键。
世界模型不是只用单步误差训练。论文从回放池取长度 k=8 的连续窗口,把前一步预测继续喂回网络,训练它在自回归状态下连续预测。对应的损失同时约束状态、奖励、无噪观测和终止概率:
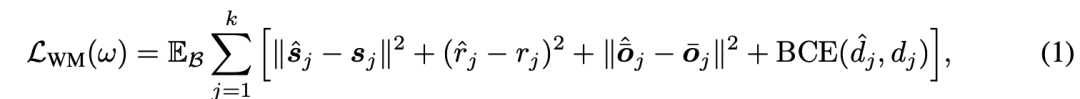
因此,模型学到的是一段状态如何演化,而不是把每一步当成互不相干的样本。
这里的“可微”只描述网络的计算路径,不代表碰撞过程变得连续,也不代表模型自动拥有真实物理常识。它的可靠性来自两部分:模拟器提供状态转移样本,策略不断把新的访问状态带回训练循环。世界模型负责提速,模拟器负责校验。
****03 机器人为什么不会只顾着追动作
全身动作模仿不能只看姿态像不像,还要看机器人能不能稳定地把动作做完。奖励通常同时关注参考动作跟踪、身体姿态和速度误差、关节限位、动作平滑、能量消耗以及与地面接触后的稳定性。这样设计是因为“看起来完成了动作”和“用可执行的身体状态完成动作”并不是一回事:如果只奖励末端姿态,策略可能学会抄近路,用不自然的关节运动换取短期分数。
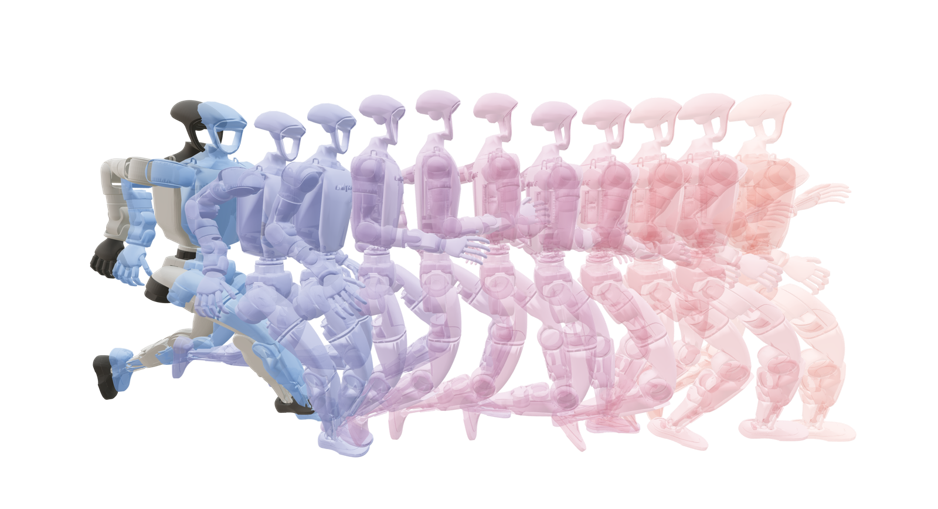
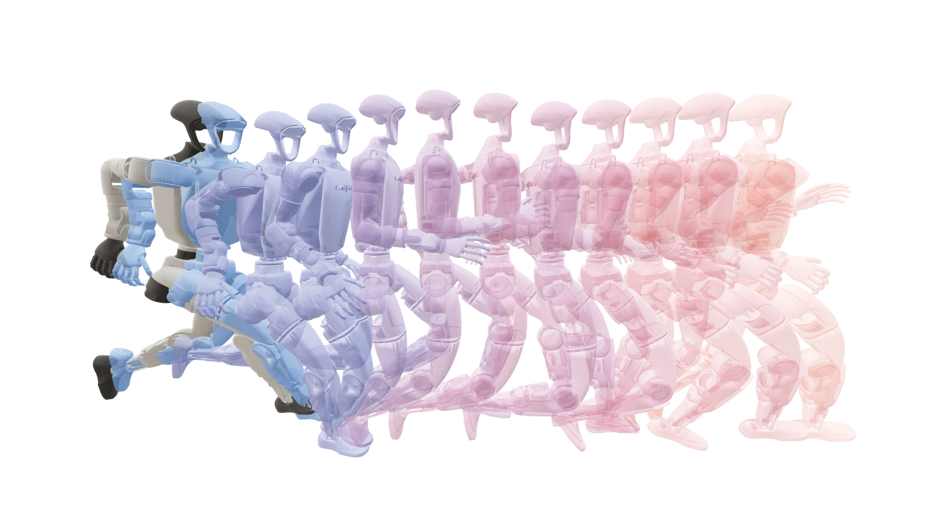
SuperMimic 论文官方 Teaser:人形机器人动作轨迹与全身控制场景,展示同一策略覆盖多种动作
终止条件也会改变训练结果。机器人摔倒、姿态偏离过大或关节进入危险范围时,模拟器可以直接结束这一回合;但硬终止会让回报在某个时刻突然归零,策略很难知道“哪一步开始变差”。SuperMimic 引入可微的软生存权重,把即将失败的状态逐步降权,让失败前的动作仍然能传回一些连续信号。
软生存权重把硬终止改成了可传播的训练信号。它先从 1 开始,再随着终止概率上升而衰减:
c₀ = 1; cₜ₊₁ = cₜ(1 − d̂ₜ₊₁)
策略优化的回报也会乘上这条生存权重:
Σₜ γᵗ cₜ r̂ₜ₊₁
接近失败的轨迹不会突然被截成零分,而是逐步失去权重;真实模拟器仍然使用硬终止,软权重只服务于想象训练。
奖励、终止和世界模型因此不能分开看。世界模型预测得再快,如果奖励只在成功或失败时给一个粗粒度结果,策略仍然缺少改进方向;奖励设计得再细,如果世界模型无法保持接触和重心变化的预测,策略又可能在想象轨迹里学会模拟器不存在的捷径。
训练时,系统先用模拟器收集真实状态转移,更新世界模型;再从当前状态出发,让策略输出动作,让世界模型滚动预测一小段未来;策略根据这段想象轨迹更新,critic 则估计短窗口之外的价值。策略更新后,新访问到的状态再次回到模拟器,形成持续回流。
世界模型不是训练一次后永久冻结的模块。策略越强,越可能进入训练早期没有覆盖过的状态,例如翻滚中途的姿态、落地前的重心偏移和恢复动作的临界点。让模型和策略交替更新,才能避免世界模型只会预测“已经见过的平稳状态”。
这也解释了为什么短 rollout 可以工作:世界模型不需要在每次更新里预测完整的一集,只要在一段有限窗口内提供稳定的局部梯度。长期影响交给 critic 估计,物理一致性则由模拟器在数据采集和最终评测时检查。
换句话说,SuperMimic 没有删掉物理,而是把物理引擎放到了更合适的位置:它负责生成和检查关键状态,世界模型负责承担大量重复的短期预测。
*04 真正的加速,发生在模拟器之外*
每次策略更新会冻结世界模型,在 H=32 步的想象轨迹上优化策略和 critic。策略目标可以写成:
Ĵ(θ) = E [ Σₜ₌₀ᴴ⁻¹ γᵗ ĉₜ r̂ₜ₊₁ + γᴴ ĉᴴ Vψ(ŝᴴ, gᴴ, ξ) ]
前半段是窗口内的预测回报,最后一项由 critic 补上窗口之外的价值。世界模型提供状态对动作的雅可比,BPTT 就能把回报对动作的梯度一路传回策略参数。
策略从一个真实状态出发,先输出动作,再由世界模型预测下一状态;预测状态继续输入策略,循环展开一小段轨迹。这个短 rollout 不需要每一步都等待完整的碰撞计算,因此可以在 GPU上批量并行。SuperMimic 还用 critic 估计窗口末端的价值,使 16 步左右的短想象也能获得一部分更长期的训练信号。
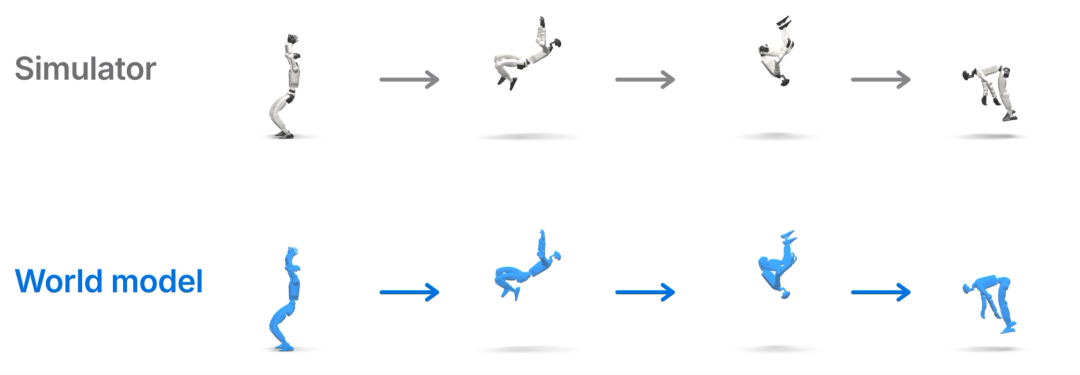
SuperMimic论文官方动作序列图:360°翻滚动作的连续状态,展示全身动作跟踪效果
它和PPO的区别不只是“一个更快、一个更慢”。PPO把模拟器当成黑箱,用多条采样轨迹估计动作好坏;SuperMimic直接对世界模型中的状态转移求导。短窗口内,后一种梯度可以利用“动作往哪个方向会让姿态更接近目标”的局部斜率,减少随机试错带来的方差。
这一套机制首先改善的是“动作库扩展效率”。官方页面报告,SuperMimic 在一张H100上训练约3小时后超过SONIC 公开模型的归一化回报;在 129,514 条训练动作上,SuperMimic 训练3小时后失败25条,使用2张GPU训练9.8小时后没有失败,而SONIC 公开模型失败179条。
论文还做了更能说明机制的LAFAN1对比:SuperMimic和PPO-Sim使用相同动作、观测、奖励、终止条件、随机化方式、网络规模和评测协议。SuperMimic 在单张GPU上约1.2小时达到0.82回报;PPO-Sim 在18小时内单GPU只有0.60,4张GPU为0.70,8张GPU也只有0.72。这个对比说明收益不只是来自世界模型 rollout 更快,BPTT提供的解析梯度本身也在发挥作用。
这组结果说明,世界模型和短 rollout确实给了策略更多低成本试错机会,尤其适合动作库不断扩大的训练场景。但129,514条动作来自训练动作集,所以它主要说明动作覆盖和训练效率,不能直接推成对陌生动作、不同摩擦或不同身体形态的泛化能力。
计算对比也有前提:SONIC 使用 128 张 L40 训练 7 天,SuperMimic 使用1张 H100,而且两边的数据规模并不完全相同。因此,文章真正应该强调的是训练范式的变化和资源差异的量级,而不是把某个倍数当成换一张GPU 就能稳定复现的固定承诺。
****05 一张GPU之后,训练机器人还剩下什么成本
SuperMimic 的冲击力来自几件事同时成立。第一,它把“动作越多、算力越多”的惯性改成了一个可以测量的研究问题:共享的人形动力学被一个世界模型复用,动作库扩展不再需要为每条轨迹重复支付完整的策略试错成本。第二,论文用LAFAN1 控制变量实验把rollout吞吐和梯度质量拆开,避免所有收益都被归因于硬件。第三,同一套策略还展示了 Unitree G1 真机迁移和下游速度接口,这让方法从仿真训练技巧变成了可继续接任务的控制底座。
****06 训练出来的策略,能不能上真机
SuperMimic 的真机部分回答的是“同一策略能否离开模拟器”。官方项目页展示 Unitree G1 执行翻滚、跳跃、起身等全身动作,并强调没有针对每个动作单独调参。动作输出经过同一套低层控制接口,说明策略学到的不只是某一个动作的专用控制器,而是一套可以覆盖多个参考动作的控制规律。
但真机演示要和泛化实验分开理解。视频可以说明策略已经在实体 G1上运行;它不能单独说明策略面对陌生动作、不同地面摩擦、传感器噪声和长时间运行时仍然稳定。下一步真正有价值的实验,是把这些条件作为变量逐项加入,并记录恢复动作、失败类型和重新训练成本。
因此,动作接口、奖励和世界模型必须放在一起看:低层 PD 决定动作能否安全落地,奖励决定策略愿意怎样完成动作,世界模型决定策略能否以足够低的成本探索这些选择。单独提高其中一项,未必能得到更好的真机控制。
****07 复现 SuperMimic,先从接口开始
SuperMimic 目前已公开项目主页(包含训练流程、计算资源对比、在线演示和 Unitree G1 真机视频)和论文。官方完整代码暂未开源。
复现前先对齐任务接口:确认 29 个主动自由度、50 Hz 控制频率、观测历史和未来参考动作的定义,以及策略输出到关节设定点的映射。低刚度 PD 控制也要一致,否则后续结果无法直接比较。
目前已经有几套第三方实现可以参考:
• CuboiLeo 的 SuperMimic-Reproduced:覆盖世界模型、短视野 BPTT actor-critic、BONES-SEED 数据处理和整段动作评测。
• Motphys 的 Uni-SuperMimic:更关注 UniLab 和 Unitree G1 的迁移。
• zita-ch 的 supermimic_vibed:适合快速了解训练循环。
复现顺序也不宜一开始就追求论文中的完整结果。先用少量动作检查状态维度、控制频率、奖励曲线和终止条件,再观察世界模型的单步预测和短 rollout 是否会随着步数增加迅速偏离。等这条链路稳定后,再扩展到 BONES-SEED,并按动作类别记录失败情况。这样才能看出问题究竟出在接口、模型预测,还是长时间控制上。
真正容易把复现带偏的,是评测口径。动作重定向后的关节顺序、坐标系、控制频率、奖励计算、终止条件和整段clip评测方式,只要有一项不同,最后的回报就不能直接和论文对齐。更稳妥的做法是先记录中间曲线,再比较最终结果:世界模型误差是否下降、想象吞吐是否提高、真实模拟器回报是否同步改善。
****结语:SuperMimic真正改变了什么
这项工作带来的启发是,世界模型不应该只在平均预测误差上变好。脚底打滑、重心偏移和动作中断等少量失败状态,可能比大量平稳行走样本更影响控制质量。下一轮训练如果能优先回收这些状态,再检查策略的恢复能力,世界模型才真正参与了全身控制。
SuperMimic 最值得关注的地方,不只是“1张GPU训练3小时”。它把训练成本拆成了三个可检查的来源:模拟器交互、世界模型预测和策略梯度估计。前两项决定一次更新能跑多快,第三项决定每次更新是不是朝着有效方向走。论文的LAFAN1对比说明,SuperMimic 同时改善了这三件事中的至少两件:想象 rollout 更快,BPTT也提供了比黑箱 PPO 更直接的局部梯度。
这也是这项工作最值得继续追踪的地方:研究者可以逐项改变想象窗口、世界模型容量、动作数据规模、失败状态采样和低层控制参数,再看哪一项真正影响动作覆盖、恢复能力和真机稳定性。计算资源下降只是结果,真正的研究价值在于它让这些变量第一次更容易被分开测量。
只看“一张 GPU 对128张 GPU ”,容易把 SuperMimic 理解成硬件对比。实际上,它改动的是训练过程中的时间分配:SONIC把更多时间花在真实模拟器里收集轨迹,SuperMimic 则先用模拟器建立可学习的状态转移,再让世界模型承担大规模短期试错。
****参考资料
SuperMimic项目主页(官方):
https://supermimic\.github\.io/
SuperMimic论文 arXiv 2610.28480:
https://arxiv\.org/abs/2610\.28480
SuperMimic Reproduced 独立复现:
https://github\.com/CuboiLeo/SuperMimic\-Reproduced
Uni SuperMimic 独立复现:
https://github\.com/Motphys/Uni\-SuperMimic
Supermimic vibed 独立重实现:
https://github\.com/zita\-ch/supermimic\_vibed
原文链接: https://www.leiphone.com/category/private/1WKDxQldvOpejeL8.html
