


来源:淘天集团智能算法产品
原文链接:https://mp\.weixin\.qq\.com/s/r0vxge6BPJTHpb4PpZhsGA
ECCV(European Conference on Computer Vision,欧洲计算机视觉大会)是计算机视觉领域最具影响力的国际学术会议之一,与CVPR、ICCV并称全球计算机视觉三大顶会,也是中国计算机学会(CCF)推荐的A类会议。作为计算机视觉领域的重要学术交流平台,ECCV持续推动视觉理解、视觉生成、多模态学习等前沿方向的发展与创新,在学术界与工业界均享有广泛影响力。
ECCV 2026将于9月8日至12日在瑞典马尔默举行。作为两年一度的国际盛会,ECCV持续汇聚全球顶尖高校、研究机构及科技企业的前沿研究成果,共同探索计算机视觉领域的新突破与新趋势。
本届ECCV中,淘天集团7篇论文脱颖而出,覆盖生成模型对齐、视觉基础模型、复杂图像/ 视频生成以及4D试衣等多个前沿方向。后续我们也将邀请论文作者详细解析研究思路与技术成果,欢迎持续关注。
痛点:现有方法在微调扩散模型时,往往只关注最终生成的图像,而忽略了模型逐步生成图像的自然演变过程。这种强制模型“走直线捷径”的优化方式,违背了图像生成的客观规律,容易导致生成过程偏离正常轨道,进而造成图像结构崩塌、细节失真以及整体优化效果受限。
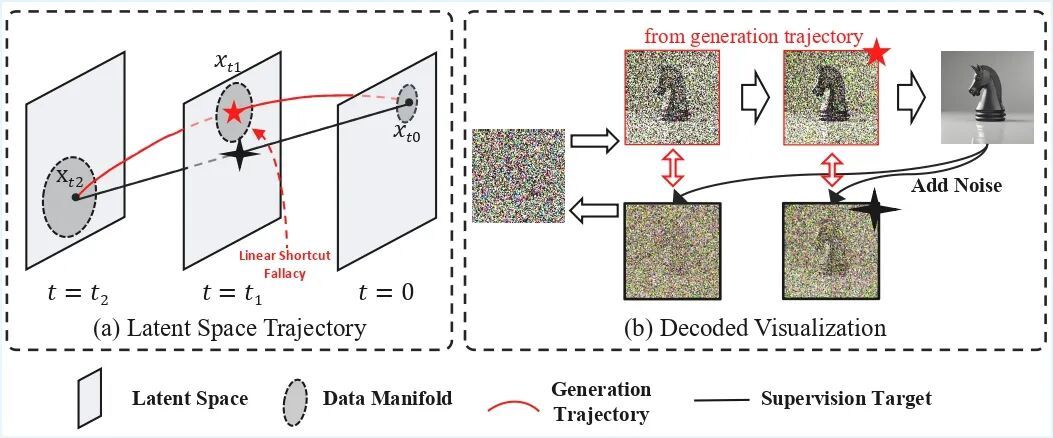
解决方案:提出轨迹一致性偏好优化(TCPO)框架,使模型在学习人类偏好的同时,严格遵循其固有的生成规律。该方法首先动态评估生成路径的演变特征,并选取合适的中间生成状态作为基准,确保优化过程始终贴合模型正常的生成轨迹;随后,将该中间状态与最终的偏好目标进行平滑融合,构建出一条既符合模型固有规律,又能准确反映人类意图的综合指导信号。
实验结果:在 HPD v2、Parti-Prompts 和 Pick-a-Pic v2 等多项标准测试中,采用 TCPO 微调的 SDXL 模型展现出了更卓越的视觉真实感和图文一致性。与原始模型相比,其在 HPD v2 上的 PickScore 提升了 0.61,HPS 提升了 0.88。此外,TCPO 显著降低了计算成本,其训练速度分别达到了传统 DPO 方法的 4.31 倍与 InPO 方法的 1.23 倍,成功实现了生成质量与训练效率的同步突破。
痛点:连续 VAE 是 latent diffusion 中的核心视觉 tokenizer,用于将图像压缩到低维 latent space。传统 CNN-VAE 擅长保留颜色、纹理等局部细节,但全局结构建模效率不足;ViT-VAE 具备全局建模能力,却在 tokenizer 场景中存在收敛慢、细节保真不足、单分辨率训练后高分辨率外推不稳定,以及模型放大后收益不一致等问题。因此,如何同时获得 CNN 的局部建模能力和 ViT 的可扩展全局表示,是构建下一代生成模型 tokenizer 的关键。
解决方案:TransVAE 的核心思路是让 CNN 与 ViT 分工协作:浅层 CNN stem/ResBlock 负责局部纹理和细粒度结构提取,深层 Transformer backbone 负责全局语义关系建模。方法上,作者仅采用 RoPE位置编码,避免了绝对位置编码在高分辨率外推时的插值伪影;设计多阶段 CNN-ViT 混合架构,提高早期重建训练效率;并在 Transformer block 中加入 ConvFFN,将局部空间混合能力注入 FFN 模块,进一步增强模型深层的局部建模能力。整体结构简洁,支持从 44M 到 2.3B 参数的稳定扩展。

实验结果:TransVAE 在学习效率、重建质量、分辨率外推和 scaling 上均表现突出。相比 VA-VAE,TransVAE 用更少训练轮数即可达到相近甚至更高 PSNR;仅在 256×256 训练,也能稳定推理到 512×512/1024×1024;模型规模从 44M 扩展到 2.3B 时,重建性能和语义对齐性能持续提升。在 ImageNet、COCO 重建和 LightningDiT 下游生成实验中,TransVAE 与 FLUX-VAE、VA-VAE 等强 tokenizer 保持竞争性能,并展现出更好的收敛速度和可扩展潜力。
痛点:现有 Normalizing Flow 具备精确密度估计和高效采样优势,但严格可逆性使其容易消耗容量去拟合低层像素细节和高频噪声,削弱对全局语义结构的建模能力。本文提出 MIMFlow,将 Masked Image Modeling 与 Normalizing Flow 统一到端到端图像生成框架中。

如图所示,MIMFlow 包含 Masked Encoder、Latent Normalizing Flow 和 Generative Decoder。Masked Encoder 从随机遮挡图像中提取紧凑语义潜变量;Flow 只负责建模低频、语义化的潜在流形;Decoder 则恢复完整图像并合成纹理细节。该设计实现了语义建模与像素合成的解耦,使 Flow 摆脱冗余局部噪声,更专注于稳定的全局结构。
实验表明,MIMFlow 在 ImageNet 256×256 上显著提升了NF类生成模型的表现。MIMFlow-L 仅使用 128 个 latent tokens,比常见设置减少 50%,仍取得 FID 2.50,相比相近规模的 SimFlow-L 提升 32.8%;其 latent space 线性探测准确率达 71.3%,验证了更强的语义表达能力。MIMFlow 为 Flow-based 图像生成提供了一条更高效、更语义化的路径。
Track:Research Track
痛点:现有I2V模型通常只依赖单张人物图像,面对转身、侧身等视角变化时,难以准确还原首帧不可见的服装背面、侧面纹理等细节,在电商展示等高保真场景中容易出现服饰外观不一致的问题。
解决方案:论文提出多视角图生视频任务和MVI2V框架,在现有MM-DiT架构的I2V模型中额外添加Reference Stream,专门处理人物或服装的多视角参考图,并与原有视频生成分支进行信息交互,使模型能够利用正面、背面等互补信息生成外观一致的视频。论文还设计了针对性的训练策略和数据构建流程,引导模型真正学习参考图中的服饰细节,而不是仅依赖首帧进行想象。

实验结果:评测表明,MVI2V能够显著提升生成视频与参考人物/服饰之间的外观一致性,同时保持视频主体稳定、背景一致和运动流畅。该方法在开源模型和自研视频生成模型上均取得稳定增益,说明其具备良好的通用性,并且不会破坏原有单图生视频能力。
痛点:Video VAE 是视频生成模型中的核心压缩模块,但现有方法大多将静态内容与动态运动耦合建模,主要依赖隐式方式学习帧间关系,难以充分利用视频中“静态冗余大、动态变化稀疏”的结构特性,因而在重建质量、训练稳定性和训练效率上仍有提升空间。
解决方案: 受传统视频编解码中“I-frame + motion residual”机制启发,我们提出 VC-VAE,首次将关键帧锚点与帧间动态残差的显式解耦思想系统引入 Video VAE。具体而言,VC-VAE 通过预训练 Image VAE 初始化,建立高质量的静态关键帧先验;进一步设计 Temporal Dynamic Difference Convolution(TDC),显式从帧间差分中学习稀疏运动残差,同时保留独立的静态内容路径,在不引入额外参数和计算开销的前提下增强时序建模能力。
实验结果: 在 WebVid-10M、UCF-101、TokBench-Video 等多个基准上,VC-VAE 在视频重建质量、高频细节恢复和动态建模方面取得了优异结果,并在下游视频生成任务中展现出更优 latent 表征能力。同时,模型总体训练开销较现有方法降低约 50%,验证了该 codec-inspired 设计在性能与效率上的综合优势。
痛点:现有视频虚拟试衣方法虽能生成逼真的动态换装效果,却始终被束缚在输入视频的原始相机轨迹上,用户无法自由查看侧身版型、背面细节或近距离质感,更谈不上360°环绕观察。一个直观的补救方案是串联“试衣模型”与“视角控制模型”,但这种两阶段方案容易产生误差累积:前一阶段中的服装纹理漂移、人体结构偏差和身份不一致,会在后一阶段的视角变换中被进一步放大,导致手臂扭曲、衣物变形、背景撕裂等问题,也带来更高的推理成本。
解决方案:将试衣从“像素预测”升级为“4D空间构建”。TryOnCrafter 不依赖端到端的像素生成,而是显式建模一个可渲染、可编辑、随时间演进的4D试衣代理(Renderable 4D Try-on Proxy)。该代理首先从源视频中解耦出背景点云、人体运动与相机参数,利用SMPL-X将动作统一对齐至三维空间;再以3D高斯泼溅(3DGS)为载体,将高质量2D试衣先验蒸馏为穿着目标服装、且能随动作自然变形的动态人体化身。自此,人物、服装、背景与目标相机轨迹被统一嵌入同一4D世界坐标系,新视角生成拥有了稳定的几何锚点,而非仅靠像素层“脑补”。在此基础上,团队进一步设计几何锚点引导的DiT与跨视角参考适配器(CRA),分别强化新视角下的结构稳健性,以及身份、纹理、背景的一致连贯性。

结果表明: TryOnCrafter不仅胜任常规视频虚拟试衣,更支持主体重定位、360°环绕展示、子弹时间等镜头级创意操控。在开源评测集ViViD-S与自建评测集CaM-VVTBench上,它全面超越DreamVVT等当前最优方法——VFID指标显著下降,VBench综合评分提升3.83%,在固定视角与自由视角两类场景中均达成最佳表现。
痛点:现有的统一多模态模型虽然具备通用的理解与生成能力,但在面对现实应用中常见的复杂组合指令时,其图像生成效果往往不尽如人意;同时,训练此类高级推理生成模型面临着多步对齐思维链数据难以获取且成本高昂的挑战。
解决方案:MANGO 从两个维度入手:首先,提出功能导向型 Transformer架构,通过将不同分支专用于特定功能(如生成或理解)来消除跨功能干扰,这种功能解耦的设计缓解了主流“模态导向型”架构中固有的跨功能干扰,进而释放了模型的图像生成潜力;其次,构建Paint-CoT 框架,让模型模仿人类的“规划 - 执行 - 反思 - 修正”艺术创作思维链以提升性能上限。此外,团队还开发了一种多任务联合训练范式,将完整的推理 - 生成流程分解为可管理的子任务。该策略最大化地利用了现有或易于构建的监督信号,使得无需完全对齐的多步标注即可实现基于 Paint-CoT 的有效图像生成。
实验结果:广泛的实验评估显示,MANGO 在多种多样的图像生成基准测试中均表现出一致性的优越性能,特别是在高难度的复杂图像生成场景中,实现了大幅度的效果提升。
原文链接: https://www.leiphone.com/category/private/WsSUSz8kMiZX4Cfn.html
