


来源:公众号“AI泡哥”
链接:https://mp.weixin.qq.com/s/TfCQH_PT8jItqCZDBSugPw
转眼 2026 年已经过了一半了,robotics 相关会议也陆续进入一个很适合阶段性回顾的时间点:AAAI 2026,ICLR 2026已经结束了,ICML 2026 和RSS 2026 的 accepted papers 也已经公布,ICRA 2026(2026 年 6 月 1–5 日)和CVPR 2026(2026年6月 3日 - 7日 ) 正在召开。虽然 CoRL(2026年11月 9-12日)、NeurIPS(2026年12月6-12日 )、IROS(2026年9月27日至10月1日) 等会议还未公布accepted paper。但对于2026年来说,已经值得先总结一下。为此,本文选择了10篇有代表性的paper(具有一定"范式意义",引用大,或获奖【入围】,或工作扎实等综合视角进行选择), 进行详细介绍:涵盖策略、VLA模型(Robot foundation Policy /VLA ), 世界模型(World model),生成式监督(Generative Supervision),Active / Temporal Perception和Diffusion Policy 理论化等议题。
作者:Physical Intelligence
Physical Intelligence的π₀是很“老”的文章(2024年11月就“占坑”了【2026年1月修正版】,但是RSS 2026录用,该文引用近2000);其后,陆续发布π₀.5(2025年4月) ,π*₀.6(2025年11月),π₀.7(2026年4月)【π 系列论文风格很像“顶级机器人学习实验室 + 大模型公司 + 真实机器人数据工厂”的混合体:有 Berkeley的 robot learning 脉络(尤其 Sergey Levine / Chelsea Finn),也有 Google RT-1/RT-2/Open X-Embodiment 那条大规模机器人数据路线(Karol Hausman等),还有明显的创业公司式工程和部署导向(面向家务这个场景)】,本着“一群羊也是赶”的精神,一起梳理一下π系列(如下图):
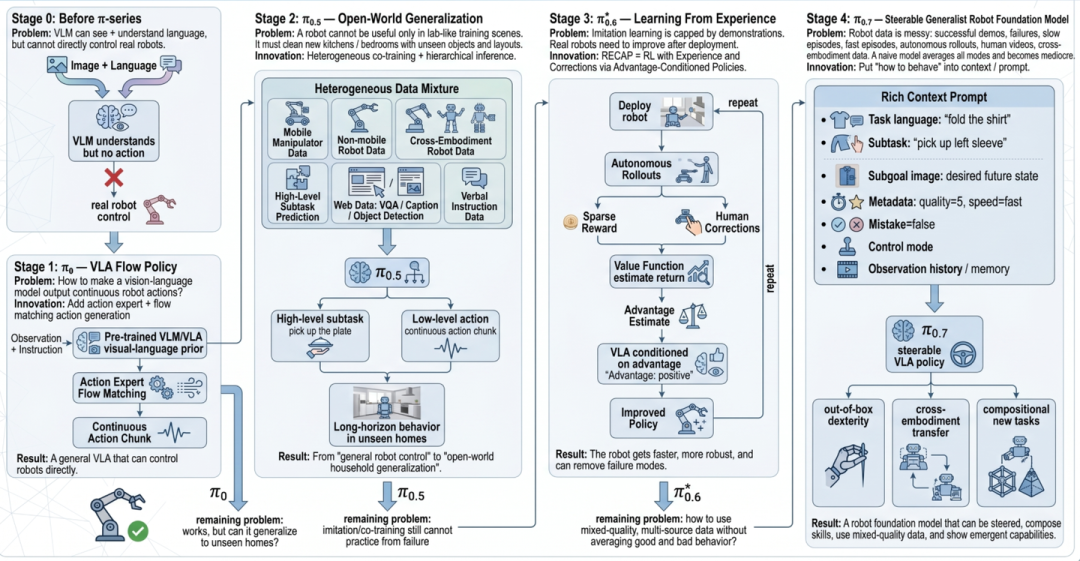
π₀(从 VLM 到 VLA,解决“语言视觉模型如何输出真实动作”):传统 VLM 能看图、理解语言,但不会控制机器人。机器人需要输出的是连续、高频、带物理约束的动作序列,而不是离散文本 token。π₀ 旨在解决能否把 VLM 改造成能直接控制机器人的 Vision-Language-Action Model ?
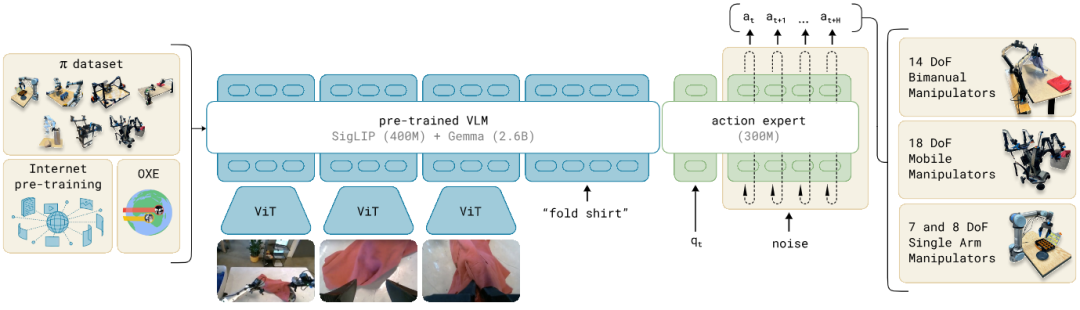
如上图,π₀ 的核心创新就是:把预训练 VLM 的语义理解能力,和一个 flow-matchingaction expert的连续动作生成能力接起来,让大模型真正从“会看会说”变成“会控制机器人”。白话文:以 VLM/VLA backbone 提取的视觉-语言-机器人状态特征作为 condition,再接收一个 noised action chunk 和 flow timestep,学习预测从噪声动作到真实动作的 flow / velocity field。推理时,模型从随机噪声动作 chunk 出发,经过若干 flow-matching 更新步骤,生成未来 H 步连续机器人动作,即 chunked action。更直白,就是VLM+diffusion model(flow matching)->chunked action。
π₀.5(从 general control 到 open-world generalization):π₀ 能控制机器人,但一个更难的问题是:机器人能不能离开实验室,到从未见过的新家里完成真实家务?π₀.5 核心问题是 在家务的场景下,如何实现open-world generalization。
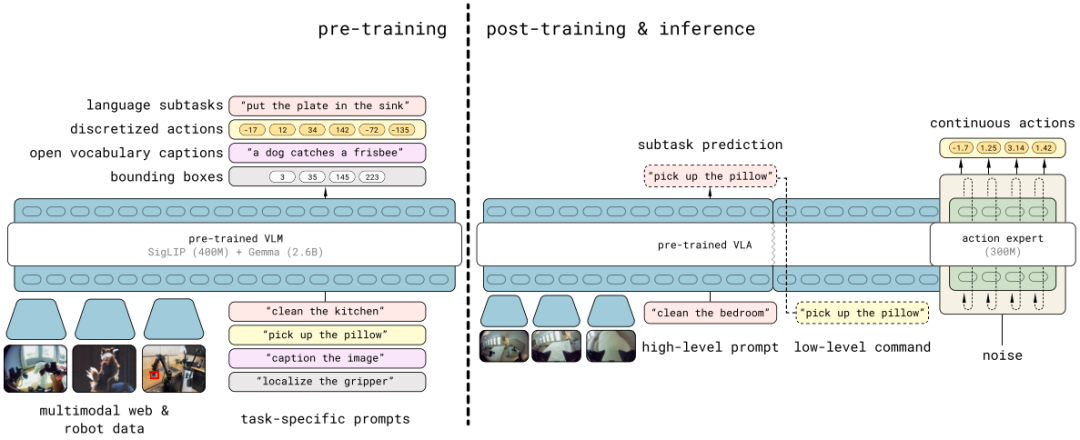
π₀.5 基于 π₀,通过 heterogeneous tasks 的 co-training,使机器人能在新家中完成厨房、卧室清理等 10–15 分钟的复杂多阶段任务。具体地,π₀.5 分成pre-training和post-training两阶段:pre-training 结合多源数据与离散 token;post-training 专门适配 mobile manipulation,并加入通过 flow matching 输出连续 action chunk 的 action expert。它使用的数据包括多机器人数据、高层语义预测、web data、verbal instructions 等。白话文:在 π₀的基础上,post-training 专门适配 mobile manipulation,以适应家务的应用场景。
π₀.6(从 imitation 到 experience,解决“机器人如何通过真实部署变强”):π₀ 和 π₀.5 主要还是 imitation learning / co-training 路线。它们能学demo数据,但真实机器人部署后一定会犯错。π₀.6 的问题变成:机器人能不能像人一样,通过反复尝试、失败、纠正、反馈,越练越强?
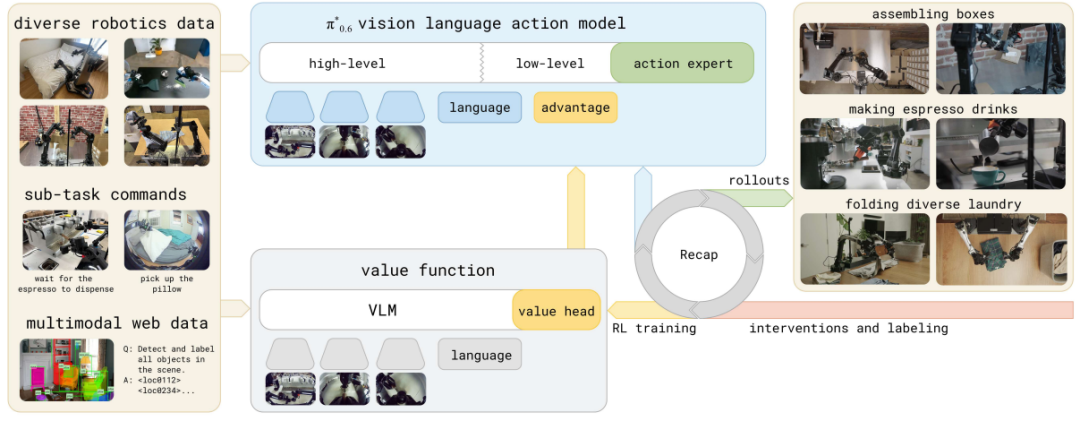
π₀.6 的核心创新是把 VLA 变成一个可以post-training / RL self-improvement的系统:Deploy VLA on robot ->collect autonomous rollouts->human corrections / sparse reward->train value function->estimate action advantage->advantage-conditioned VLA training->improved VLA->repeat; 这就是π₀.6 提出 RECAP:RL with Experience and Corrections via Advantage-conditioned Policies。它利用 demonstrations、on-policy collection、expert teleoperated interventions,把真实部署经验纳入训练。RECAP 可以让 π₀.6 在真实任务中折衣服、组装盒子、制作 espresso,并在一些困难任务上将 throughput 提升超过 2 倍、failure rate 大约减半。白话文:π₀ / π₀.5 类似 pretraining + SFT;π₀.6 开始robot RL post-training(虽然π₀.5有post-training ,其目的是为了适应家务场景;π₀.6 的post-training 是面向部署,它必然也有π₀.5的post-training,因此,π₀.6 更像是post-post-training)。
π₀.7(从 self-improvement 到 steerable generalist foundation model):π*₀.6 能通过经验提高某些任务性能,而进一步,π₀.7可能面对的问题: 数据质量不一致,有成功、有失败、有慢动作、有快动作; 不同机器人形态、不同任务策略混在一起,容易学成平均行为;用户不仅想让机器人“做什么”,还想控制它“怎么做”; 机器人需要组合旧技能完成新任务,而不只是复现训练任务。
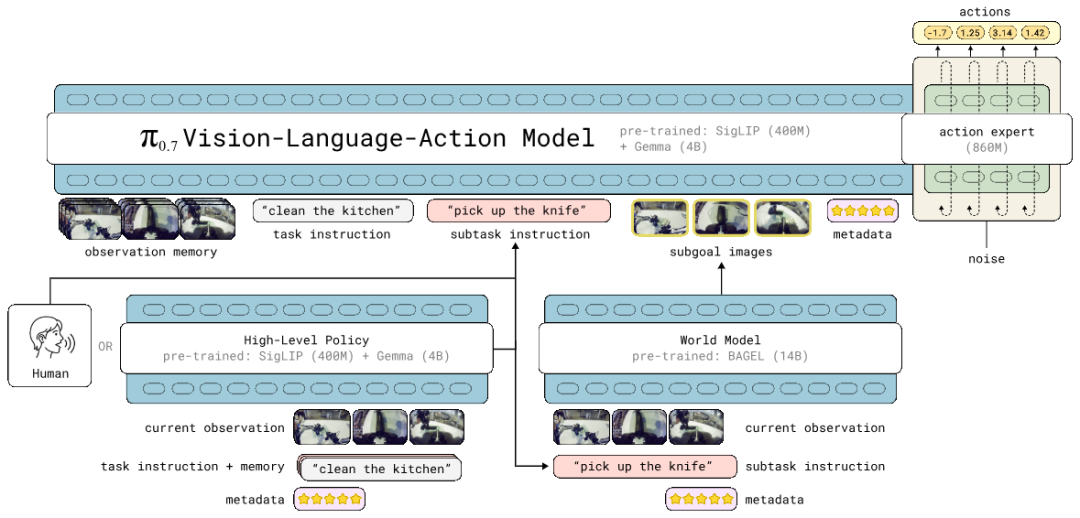
π₀.7 的核心创新点是把prompt / context变成机器人行为的控制面板:通过 diverse context conditioning,让模型可以在 prompt 中接收任务描述、策略信息、episode metadata、subgoal images 等,从而在未微调情况下完成复杂灵巧任务、跨 embodiment 泛化和组合式任务泛化。π₀.7 还引入 world model 生成 subgoal images,让机器人能看到一个“目标状态草图”。白话文:π₀.7 不是取消训练,而是改成 context-conditioned training,推理时再通过 prompt/context 选择不同的行为模式,从而减少每个新任务的fine-tune 的需求。
π-series 的创新逐步形成了一个机器人基础模型系统范式:Robot Foundation Model =VLA backbone + action expert + flow/diffusion continuous action generation + cross-embodiment data + web / human / robot heterogeneous co-training + high-level semantic subtask inference + real-world experience and correction loop + value / advantage conditioning + metadata / subgoal / memory based context steering;最终,这条路线从“根据语言做动作”到“能在真实世界中提示、纠正、训练、 steer,组合技能解决新任务”。
作者:Physical Intelligence
没看错,又是一篇Physical Intelligence的paper (引用也500+)!FAST 之所以必须推荐: 因为π₀ 系列说明机器人基础模型可以通过 VLA + flow matching 产生连续动作,而 FAST 说明:动作 tokenization 做对时,动作也可以进入类似 LLM 的 next-token prediction 训练范式。这是因为,LLM 有 text tokenizer,VLA 也必须有action tokenizer。问题是,机器人动作不是文字,而是连续、高频、多维的时间序列。而已有的 per-dimension、per-timestep binning 方法在 high-frequency dexterous skills 上表现很差。
传统做法是:每个时间步 × 每个动作维度 → 单独分桶;这会产生大量强相关 token。高频控制下,相邻动作变化很小,模型很容易学成“复制上一个 token”,训练信号变弱。FAST 的核心洞察是:robot action sequence 不是普通离散 token,而是连续时间序列,所以应该先压缩。为此,FAST用DCT,Discrete Cosine Transform把动作序列转到频域,再用 BPE 压缩,形成Frequency-space Action Sequence Tokenization。如下图展示了流程:normalized action chunk → DCT frequency components → sparse frequency matrix → flatten → BPE → compressed action tokens。说白了,FAST就是“组合创新”:DCT 来自经典信号/图像压缩,BPE 来自文本 tokenizer,把“压缩式编码”应用到 VLA 的连续机器人动作 tokenization。
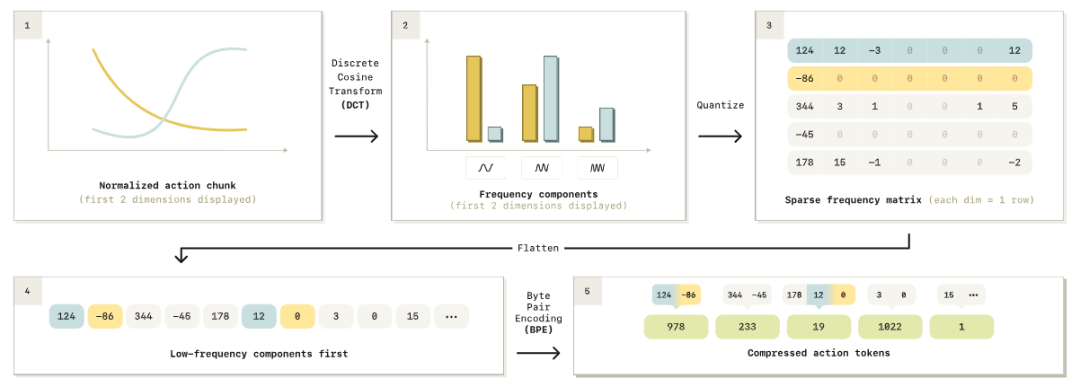
π₀ 原始路线更偏flow matching / diffusion VLA:用 action expert 输出连续 action chunk。而FAST 证明:如果 action tokenizer 做对了,autoregressive VLA也可以训练复杂、高频、灵巧任务。论文显示 FAST 可以让 π₀-FAST 在 dexterous / long-horizon manipulation 上匹配 state-of-the-art π₀ diffusion VLA,同时训练快 5 倍。同时,本文发布了可以作为 black-box tokenizer 使用的通用 action tokenizer:FAST+ 是一个 universal robot action tokenizer,训练在 100 万真实机器人动作轨迹上,可覆盖 single-arm、bi-manual、mobile robots、多种 action spaces 和 control frequencies。
FAST 将 VLA 的action representation 问题展示为机器人基础模型的核心问题。与 diffusion / flow VLA 相比,FAST 的优势是训练效率和 backbone 兼容性,π₀-FAST 可在保持相近表现的同时显著降低训练计算;但其代价是 autoregressive action decoding 带来较高推理延迟。因而,FAST 的定位不是替代所有连续动作生成方法,而是为 VLA scaling 提供 action-tokenization 基础设施。
作者:Rujia Yang等(清华等)
机器人操作肯定是在 3D 空间中,但当前很多model 主要依赖 2D 图像,因此其泛化能力必然有限(例如unseen scenarios、new objects、distractors 等情景上泛化能力有限)。如果机器人要在真实世界中泛化,不能只让模型“看见图像”,还要让模型“知道物体在三维空间中的位置、形状、尺度和相互关系”。为此,FP3 希望通过3D point cloud 可以把这些几何关系显式放进模型输入里,从而让 foundation policy 更容易泛化。
FP3 的核心创新是提出了3D point cloud-based language-visuomotor foundation policy (1.3B 参数的 3Dfoundation policy ):用 3D point cloud + language + proprioception 作为多模态输入,再用 diffusion transformer 输出 action chunk,也就是把 3D 几何感知和 diffusion policy 结合起来(如下图); 同时,采用 pre-training + few-shot post-training recipe:先在 DROID 60k trajectories 上预训练,再用每个任务 80 条高质量 demonstrations 做 LoRA fine-tuning。
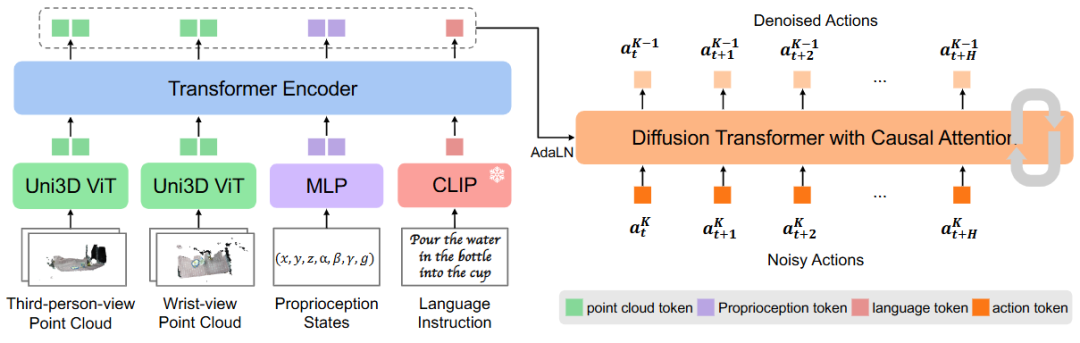
FP3用大规模预训练 3D encoder Uni3D ViT-L(Large):当前 point cloud-based robot policies 通常用 sparse point cloud 和小网络,而 FP3 增加输入点数到每视角 4000 points,并使用 300M 参数 Uni3D ViT。同时,它不是一次预测单步动作,而是 diffusion action chunk。这让它更接近 Diffusion Policy / RDT / π₀ 这类生成式动作模型,而不是传统 reactive controller。
在 2026 的 robotics ,VLA很多路线仍然是:2D image + language → action;但FP3 强调3D世界的交互,例如机器人不是只要“识别杯子”,还要知道:杯子在哪里?杯口朝哪里?能不能抓?手从哪边过去?等这些问题 3D 的问题。FP3 展示了从 2D VLA 向 3D foundation policy 的转向的可能。
作者:Zongzheng Zhang等(清华大学等)
当前 VLA 系统主要受限于两类:要么是 dual-arm low-DoF grippers,要么是 single-arm dexterous hand,无法同时处理双臂协作和高自由度双手灵巧操作。Dexora 的目标就是补上这个空白:构建第一个面向dual-arm, dual-hand, high-DoF manipulation的开源 VLA 系统。
Dexora的核心创新点: Dexora 是第一个原生面向 dual-arm, dual-hand, high-DoF manipulation 的开源 VLA 系统;embodiment-matched sim + real 大规模数据采集管线,也就是Dexora设计一个能高效采集“人类双手双臂动作”的数据机器(Hybrid teleoperation把控制拆成两部分: 粗粒度手臂运动【custom exoskeleton backpack 捕捉 shoulder-elbow-wrist 角度】,细粒度手指运动【Apple Vision Pro markerless hand tracking 捕捉 3D finger skeleton】);Data-quality-aware training:即使高自由度 teleoperation 也很难保证每条数据都好,Dexora 的做法不是简单地过滤掉数据,而是训练一个 discriminator,为每段 demonstration 打质量分,然后把这个分数变成 diffusion loss 的权重(高质量 clip → 权重大 → 多学,低质量 clip → 权重小 → 少学),如下图:
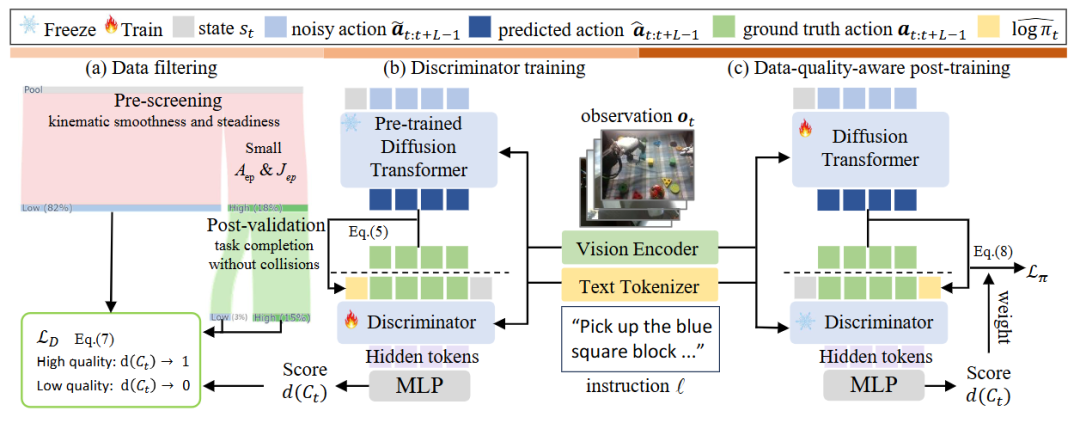
如上图,Dexora 如何处理真实 teleoperation 数据质量不稳定的问题, 第一步先做数据过滤:用加速度、jerk 等指标筛掉抖动大的轨迹,再通过 replay 检查任务是否成功、是否无碰撞,得到高质量 demo; 第二步训练一个 discriminator,让它根据 observation、language、action chunk 和 policy 兼容性分数,判断每段数据质量高低;第三步在训练 diffusion-transformer policy 时,把 discriminator 的质量分数变成 loss 权重:高质量数据多学,低质量数据少学。白话文,Dexora 不是盲目模仿,而是“有选择地学”。
为什么Dexora 值得推荐,是因为它是“高自由度双臂双手灵巧操作”的重要基础工作之一。现有 VLA 多集中在单臂夹爪、双臂低自由度夹爪,或单臂灵巧手,难以覆盖真实世界中需要双手协作和手指精细控制的任务。而Dexora 的核心 insight 是:与其从低自由度夹爪策略向上“补全”灵巧手动作,不如直接在 36-DoF 双臂双手平台上训练 rich embodiment policy,再向低自由度 embodiment 投影。实验显示,Dexora 在 basic tasks 和 dexterous tasks 上均优于 DP、π₀ 和 GR00T N1,并能跨 single-arm gripper、dual-arm grippers、single-arm low-DoF hand 泛化。它的意义是为高自由度机器人基础模型提供了硬件、数据、训练和跨 embodiment 泛化的提供诸多参考。
作者:Haozhan Li等(清华大学等)
当前 VLA 主要依赖大规模机器人demo数据做 SFT,但机器人轨迹昂贵、稀缺且覆盖有限,导致模型在长时程任务、分布外场景和真实部署中泛化不足。而SimpleVLA-RL 的想法是:借鉴LLM 的 RL中reward思路,VLA 也可以通过任务成功/失败的reward,学会action planning。
SimpleVLA-RL的核心创新点: 把 LLM 里的 rule-based online RL 思路迁移到 VLA,形成一个面向机器人闭环交互的 RL post-training 框架; 这是通过基于 veRL 而扩展出 VLA-specific trajectory sampling、parallel multi-environment rendering、training-inference-rendering 一体化框架和优化后的 loss computation;而奖励设计非常简单:一条轨迹任务成功就给 1,失败就给 0。 白话文,模型的学习由“行为驱动”变为“结果驱动”:以前的SFT(Demo演示“抓起来、移动、放下”, 模型就模仿这条路线)是行为驱动,关键看像不像;而SimpleVLA-RL是尝试不同动作,关键看成不成功。如下图:
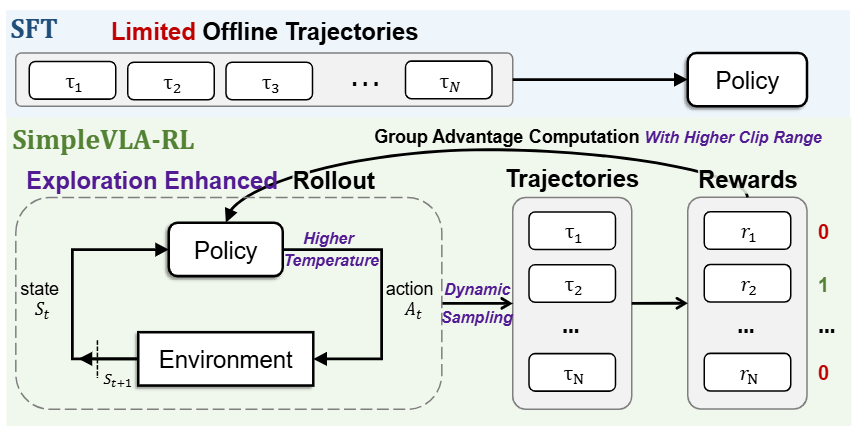
如上图,左边表示传统 SFT 只能利用有限离线 trajectories,而右边 SimpleVLA-RL 让 policy 和 environment 闭环交互,采样多条 trajectories。 每条轨迹根据任务是否成功获得 0/1 outcome reward,然后用 group advantage computation 更新 policy。图中还标出三个探索增强模块,旨在解决VLA 做 RL 时探索不够、奖励太稀疏、梯度容易消失的问题:dynamic sampling(SimpleVLA-RL会对同一个任务采样多条轨迹,例如 8 条,如果这 8 条全成功或全失败,GRPO 的 group advantage 会变成 0,模型学不到“哪条轨迹更好”。所以 dynamic sampling 会丢掉这种“全对/全错”的 group,只保留:同一个任务(有的轨迹成功,有的轨迹失败))、higher clip range(GRPO / PPO 会用 clip range 限制 policy 更新幅度,防止模型一下子改太猛。普通范围类似:[0.8, 1.2];SimpleVLA-RL 把上界调高到:[0.8, 1.28],其目的是:如果某些低概率动作最后导致任务成功,就允许模型更大胆地提高这些动作的概率。直觉是:机器人以前不敢试的动作,比如“直接推过去”而不是“抓起来再放下”,如果成功了,RL 应该更积极地奖励它)、higher rollout temperature(temperature 控制采样随机性。如果temperature 低,模型更保守,老是重复 SFT 学到的动作;temperature 高,模型会尝试更多不同动作。论文把 rollout temperature 从 1.0 提高到 1.6,让 VLA 在环境中探索更多轨迹。这有助于发现新策略,比如论文里提到的pushcut:模型不再模仿demo里的“抓-移动-放下”,而是学会直接“推过去”)。
为什么SimpleVLA-RL值得推荐,因为它是“通过 reinforcement learning 做 post-training”学习robot foundation model ,而不是SFT。现有 VLA 的核心瓶颈是机器人demo数据昂贵且有限,SFT 往往只能复制训练轨迹,遇到新场景、新物体或长时程任务时泛化不足。而SimpleVLA-RL 借鉴了 LLM reasoning model 的 RL 经验:不必为每一步设计复杂奖励,只需用任务成功/失败作为reward,就可以让 VLA 在环境交互中改进 step-by-step action planning。它的意义在于基于已有 SFT policy 基础上,通过仿真 RL 提升泛化、长时程执行和真实部署等能力。
作者:Chuning Zhu等(University of Washington等)
机器人学习依赖高质量demo,但demo昂贵且规模有限,而大量 video data 虽然便宜丰富,却没有 action 标注,难以直接用于 policy learning;同时,video world model 能学习未来画面变化,却通常和 action policy 分离,难以直接提升机器人控制。为此,本文UWM(Unified World Models)认为:policy learning 和 world modeling 不应该是两个模型,而可以是同一个 video-action diffusion model 的不同推理模式。
UWM(Unified World Models)的核心创新点:把action diffusion和video diffusion放进同一个 diffusion transformer 中。 它最关键的设计是给 action 和 future observation 分别设置独立 diffusion timestep:t_a和t_o'; 通过控制这两个 timestep,模型可以在推理时切换不同功能:policy、forward dynamics、inverse dynamics、video prediction;当把 future observation 的 timestep 设为最大噪声T,相当于“遮住未来图像”,模型就退化成 policyp(a|o); 这种设计还允许模型利用 action-free video data:没有动作标签时,就把 action 设成 fully noised / masked,仍然能训练视频动态理解。白话文,可以把 UWM 理解成一个“机器人因果关系学习器”(普通 imitation learning: 看到当前图像 → 预测动作;UWM: 当前图像 + 动作 + 未来图像→ 学习三者之间的关系→推理时按需要遮住某一部分→得到 policy / dynamics / inverse model / video predictor)。如下图:
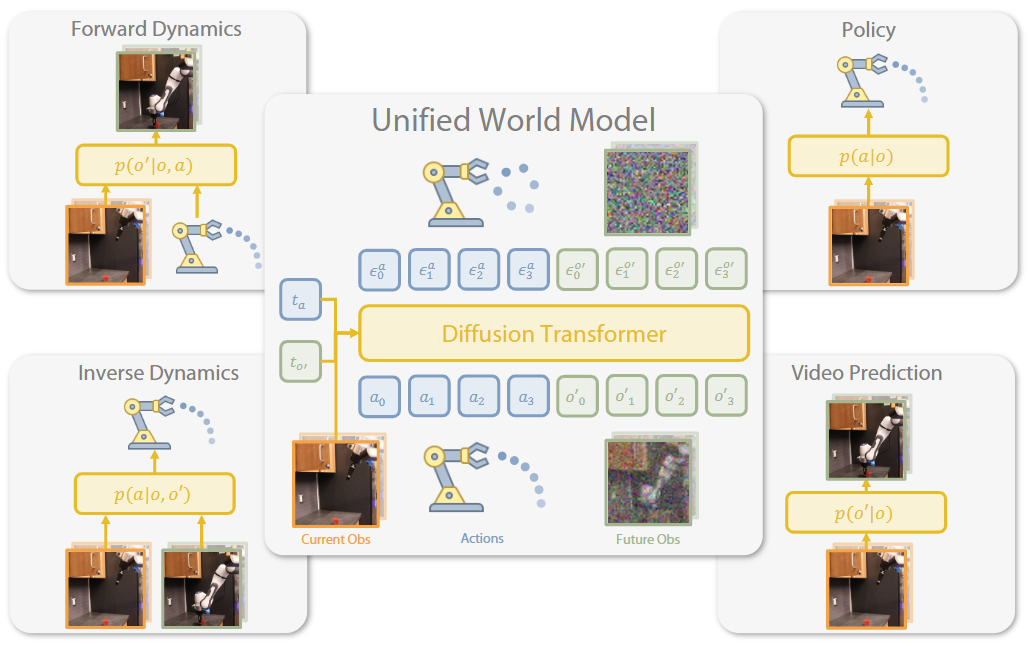
如上图,Unified World Model 可以通过不同 timestep 设置,同时扮演 policy、forward dynamics、inverse dynamics 和 video prediction 四种角色。图中间的 UWM 接收 current observation、actions、future observations,并分别对 action 和 future observation 做 diffusion。
为什么推荐UWM(Unified World Model )呢? 因为它把 imitation learning、world model、video prediction、inverse dynamics 这些原本分散的方向统一到一个 diffusion framework 中。 其重要意义在于证明 action-free video data 可以通过统一 diffusion timestep 机制进入 robot policy pretraining,而不是只能依赖昂贵 action-labeled robot trajectories。 实验上,UWM 在真实机器人任务和 LIBERO benchmark 中整体优于 DP、PAD、GR1,并且 co-training action-free videos 后进一步提升 OOD 鲁棒性。 对产业来说,它有可能降低了对大规模真实机器人demo的依赖,因为企业通常更容易获得视频数据。
作者:Shivansh Patel等(UIUC等)
过去从视频学机器人操作大致有三条路线:路线 1:真实人类视频 / 互联网视频(问题:视角、手型、物体、环境、机器人 embodiment 差距很大);路线 2:专门采集和机器人环境对齐的人类 demo video(采集麻烦,必须控制视角、物体、场景,很难 scale);路线 3:VLM 直接预测 keypoint / constraint / goal问题(太稀疏,缺少完整动作过程,容易丢掉关键几何与时序细节)。本文RIGVid:生成视频虽然不是机器人动作数据,但它包含了“物体应该如何运动”的视觉轨迹;只要能把视频中的物体运动稳定提取成 6D object pose trajectory,就可以绕过 action label,直接变成机器人可执行轨迹。虽然,本文和上一篇UWM旨在利用“没有动作标签的视频”来减少对真实 robot demo 的依赖,但上一篇UWM是“把 video data 变成 policy pretraining 信号”,本篇RIGVid是“把 generated video 直接变成 object trajectory”。
本文RIGVid的核心创新点:机器人只模仿 AI-generated videos,不需要真实 physical demo,也不需要 task-specific robot training。 它是把生成视频转成 6D object pose trajectory,而不是只提取稀疏 keypoint、dense flow 或 goal image。 具体,它使用 monocular depth estimation + 6D object tracking + object-to-robot retargeting,把视频里的物体运动变成机器人末端执行轨迹,并且支持 closed-loop execution:执行时实时追踪物体,如果偏离轨迹,就回退到最近成功点并继续执行。 白话文,普通 imitation learning是人类或机器人真实demo → 训练 policy → 机器人执行;而RIGVid是AI 生成一个操作视频 → 追踪视频中物体怎么动 → 机器人照着这个物体轨迹动。如下图:
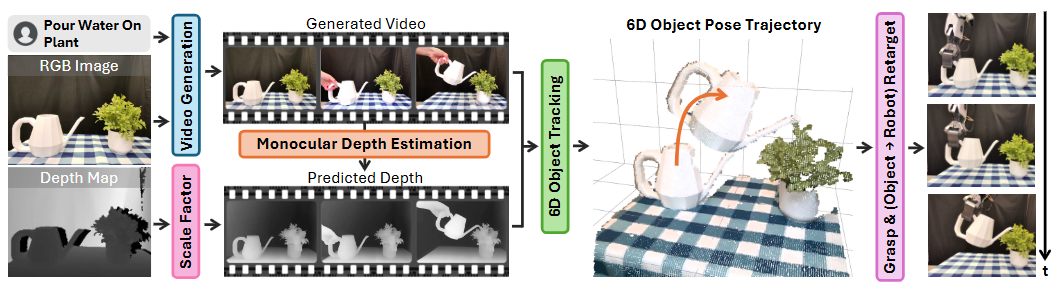
如上图,RIGVid 的完整 pipeline:输入初始 RGB-D 图像和语言命令,例如 “Pour Water On Plant”,视频生成模型先生成一段操作视频;随后单目深度估计器给每一帧补深度,6D object tracker 从 RGB-D 视频中提取物体位姿轨迹;最后系统先抓住物体,再把 object trajectory retarget 成 robot end-effector trajectory。本文不预测机器人动作,而是预测/提取“物体应该如何运动”,再让机器人去实现这个物体运动。
为什么推荐RIGVid呢?因为它说明了机器人可以从生成模型“想象出来”的视频中获得操作监督,而不必完全依赖真实机器人demo,这是generative model × robotics方向非常有代表性的论文。这意味中,有可能把生成式视频模型从“视觉内容生成工具”推进为“机器人操作监督来源”。这对服务机器人、家务机器人、轻工业操作、低频新任务适配都很有启发。
作者:Lei Xiao等(LiAuto Inc等)
现有 VLA 大多把每个时刻的图像单独处理,默认当前图像已经包含完整状态(这里隐含一个假设:当前 observation 足够代表完整世界状态,也就是把机器人操作当成 MDP( Markov Decision Process)),但真实情况是机器人操作往往是部分可观测的,需要记住过去动作、过去观察和交互历史。也就是,真实机器人控制更像 POMDP(Partially Observable Markov Decision Process):当前图像只是局部观察,很多信息可能被遮挡、被历史动作改变,或者需要从之前的交互中推断。本文指出,现有 VLA 逐帧独立处理视觉输入,会导致模型每一步都“重新看图”,无法利用过去上下文来关注关键区域。
AVA-VLA的核心创新点:以POMDP的角度去建立VLA policy learning:动作不只依赖当前 observation,也应该依赖历史 belief / recurrent state。 其中,提出 recurrent state:从上一时刻 action-related hidden state 中提取压缩表示,用来保存历史上下文。 同时,提出了 Active Visual Attention, AVA 模块:用 recurrent state + 当前视觉 token + 语言指令,动态计算每个视觉 token 的重要性,进而把重要性权重注入 LLM 的 attention matrix,让模型在所有层中增强任务相关视觉 token、削弱无关视觉 token。 训练上采用 truncated BPTT,避免完整长序列反传带来的显存和计算爆炸。 白话文,AVA-VLA 可以理解为给 VLA 加了一个“任务的记忆 + 聚光灯”:上一时刻 hidden state → recurrent state:我刚才做了什么、看到了什么、任务进展到哪里→Active Visual Attention→当前图像里哪些 token 更重要?→增强 stove switch / object / contact area→削弱背景、桌面、无关物体→预测当前 action chunk。
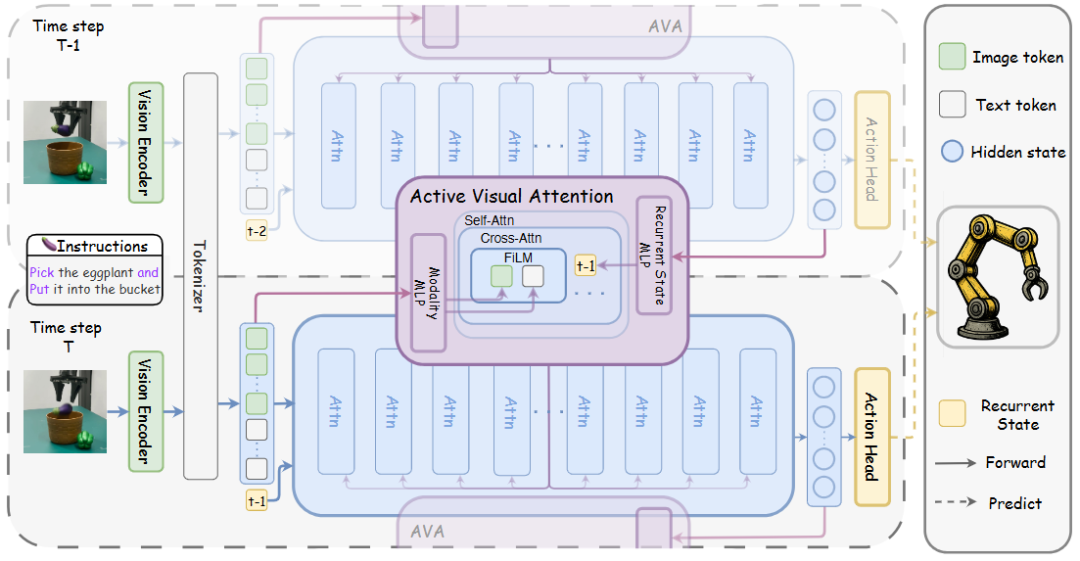
如上图,两个连续 timestep:上一时刻的 hidden state 经过 MLP 投影成 recurrent state,这个 recurrent state 一方面用于初始化当前 action placeholder,另一方面输入 AVA 模块。AVA 模块把 recurrent state 与当前视觉 token、文本 instruction 结合,通过 FiLM、cross-attention、self-attention 生成 soft importance scores。然后这些视觉 token 权重会调制 LLM backbone 内部 attention matrix,使模型在当前帧中主动关注与历史和任务相关的区域。本质上,AVA-VLA 就是把上一时刻的决策隐状态变成当前视觉处理的控制信号。
为什么推荐AVA-VLA呢 ?,因为本文揭示了VLA 不是单帧图像理解模型,而是具有闭环序列的决策系统。很多 VLA 论文关注更大的 backbone、更好的 action tokenizer、更强的 decoder、更大的数据集;AVA-VLA则说明,即使你的模型足够大,如果每一步都把当前图像当作完整状态,仍然会在丢失重要的上下文。对于实际部署的机器人而言,常面对遮挡、视角变化、动作执行错误或误差等等问题;这些都不是单帧 VLA 能正确解决的。
作者: Yanbiao Ji等(上海交大等)
Diffusion Policy 通过学习 demo进而生成复杂、多模态动作,但本质仍然是 behavior cloning:只学“怎么做”,没有学明白“为什么这个动作更好”。也就是说,它知道动作的数据大体分布,但不知道这些动作背后的偏好、成功的原因、动作好坏的排序等。本文指出,diffusion-based policies 通常模仿 trajectories,但没有显式学习到rewards。但同时,另一条路线是 IRL / reward learning,但传统 IRL 往往训练不稳定、计算开销大;而普通 energy-based imitation 又常常只是把 energy 当作 action score,不一定能解释为可识别的reward。为此,本文认为Diffusion Policy 可能已经隐含了专家策略的 reward gradient / soft Q-function gradient,也就是扩散模型学到的 score field,本质上可能包含“专家偏好往哪里提升”的方向。白话文,普通 Diffusion Policy:学一堆箭头,告诉动作从噪声往哪里去,最后生成像专家的动作;本文的EnergyFlow:不只学箭头,还学一张“能量地形图”。好动作在低能量谷底,坏动作在高能量区域(箭头是这张地形图的梯度)。
EnergyFlow的核心创新点:用一个 scalar energy functionEθ(s, a)来参数化扩散策略,而不是直接预测 denoising field; 通过自动微分得到 denoising score:Sθ = -∇aEθ(s, a),从结构上保证 learned field 是 conservative / integrable field。 同时,提出 centered shaping reward,通过减去 state-dependent baseline 来消除 energy 中无法识别的状态偏置,使其更适合作为下游 RL reward。 本质上,它把 diffusion-based imitation learning 和 inverse reinforcement learning 接起来,形成“生成动作 + 恢复 reward”的统一框架。白话文,普通 diffusion policy 像是:给你一个动作噪声,模型告诉你: 往左一点、往上点、再靠近专家动作一点;EnergyFlow 则像是:模型先学出一张能量地图( 好动作 = 山谷,坏动作 = 山坡 / 山顶),然后动作生成时( 沿着能量下降方向走到低能量动作),reward 提取时选择低能量( = 更像专家偏好的动作)。
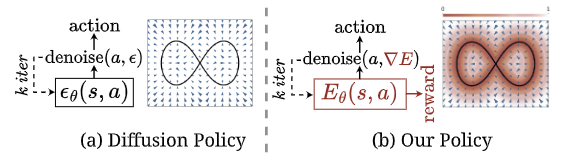
如上图,左边是普通的Diffusion Policy:模型直接预测 denoising vector fieldεθ(s, a),这个 field 可以把噪声动作一步步变成专家动作,但它没有显式能量函数,因此很难直接输出 reward。而右边是 EnergyFlow:模型先参数化 scalar energyEθ(s, a),再用其梯度∇Eθ作为 denoising field;这样同一个模型既能生成动作,也能输出 reward signal。概括而言,Diffusion Policy 只学“动作往哪里去”,EnergyFlow 学“为什么往那里去”的能量地形,也因此,EnergyFlow 把 diffusion policy 从纯生成模型推进到可解释的 preference / reward model。
为什么推荐EnergyFlow呢?因为一般的 Diffusion Policy能生成平滑、多模态、接触丰富的动作;但没有一个可解释的机制,而EnergyFlow有可能成为解释专家行为背后的reward的基础。也就是,它可能把如下三个方向连接起来:Diffusion Policy(动作生成)+Energy-Based Model(偏好建模)+Inverse Reinforcement Learning(reward)。真实场景里 reward engineering 很贵,人工设计 dense reward 很难,而 sparse success reward 又太弱。EnergyFlow 提供了一种可能路径:先用 demo训练 EnergyFlow→得到可生成动作的 policy→同时得到 energy-based reward signal→用于 downstream RL / online improvement / policy refinement;这对各种机器人都有价值,因为这样可能降低 reward 设计成本,并让demo数据不仅用于模仿,还能转化成后续强化学习的reward机制。
作者:Lujie Yang等(Amazon FAR (Frontier AI & Robotics)等)
人形机器人要学复杂动作,需要大量高质量的人类动作demo。但把人的动作转到机器人身上很难,现有方法常常会出现脚滑、穿模、接触不准等问题(现有方法大致有两类,第一类是teleoperation:可以利用人类实时反馈避免一些 retargeting 错误,但成本高、劳动密集、不适合大规模数据生成,而且人和机器人 embodiment gap 仍然存在;第二类是offline retargeting,通常依赖 keypoint matching、orientation matching 或 soft penalty,能把人类动作转成人形机器人动作,但经常忽视人-物体、人-地形之间的交互关系,容易出现各种问题【foot skating:脚应该贴地却在滑;penetration:机器人身体或手穿进物体/地形;contact loss:该接触时没有接触;object interaction mismatch:人类搬箱子的相对关系没有被机器人保持】)。结果是,机器人后续用强化学习训练时,不得不靠一堆复杂的奖励函数来弥补这些数据带来的问题。而本文认为:人形机器人 retargeting 不能只匹配人的关节点,而要保留“人—物体—地形”的空间关系和接触关系;只要demo足够干净,后续 RL 就可以用极简 reward 学到复杂 whole-body skills。白话文,白话说,传统 retargeting 像是在问:人的手在哪里?人的脚在哪里?机器人尽量把手脚放到类似位置;但本文 OmniRetarget 问的是:人的手和箱子是什么关系?脚和台阶是什么关系?身体、物体、地形之间的空间结构是否被保留下来?机器人这样做会不会穿模、脚滑、超关节限制?
OmniRetarget的核心创新点:用 interaction mesh 显式建模身体、物体和地形之间的空间/接触关系; 用 Laplacian deformation minimization 保持交互结构:不是简单匹配 keypoints,而是尽量保持 source interaction mesh 和 target interaction mesh 的局部几何关系。 同时,引入 hard kinematic constraints:包括 collision avoidance、joint limits、velocity limits、foot sticking,避免穿模、越界和脚滑;当生成高质量 reference motion 后,RL 训练可以极简化:只用 5 个 reward terms、4 个 robot domain randomization terms、纯 proprioceptive observation,就能完成复杂任务。 白话文,可以把 OmniRetarget 理解成一个“人形机器人动作翻译器”:Human motion + object + terrain→interaction mesh:记录人、物体、地形之间的相对关系→constrained optimization:找一个机器人姿态序列→既像人类动作,又不穿模、不脚滑、不超关节限制→生成 reference motion→RL policy 学会真实机器人可执行动作。如下图:
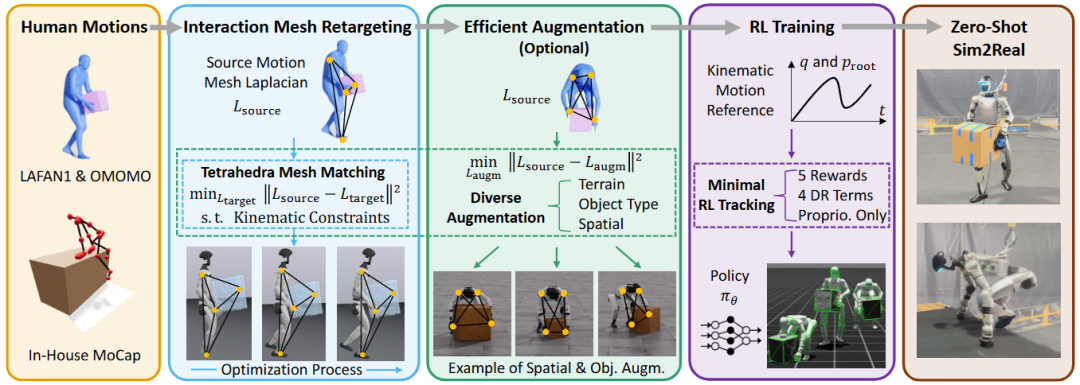
如上图,左边输入来自 LAFAN1、OMOMO 和 in-house MoCap 的 human motions;中间通过interaction mesh retargeting,最小化 source mesh 和 target mesh 的 Laplacian deformation,同时满足 kinematic constraints; 随后进入efficient augmentation:同一条demo可以变成不同 terrain、object type、object pose、spatial configuration 下的多条 reference trajectories ; 右侧是 RL training:使用生成的 kinematic reference,只需 5 个 rewards、4 个 domain randomization terms 和纯 proprioceptive observation,就能训练 policy ; 最右边显示 zero-shot sim-to-real:这些 policy 直接部署到真实 Unitree G1 上完成复杂场景交互任务。
为什么推荐OmniRetarget呢?因为很多人形机器人 RL 的困难来自demo (reference motion )数据有问题:脚滑、穿模、接触错位。于是大家不得不用大量 reward terms、contact schedule、foot air-time penalty、slip penalty 等东西补救。OmniRetarget 的工作说明:如果先把数据做好,后面的 RL 就可以简单很多。也就是,核心问题从“如何设计更复杂 reward”变成“如何生成更好的demo”问题,只要 reference motion 保留了关键交互关系,纯 proprioceptive policy 也可以完成很复杂的交互,进而可以显著简化 RL、提升 sim-to-real 成功率。
