


来源:空间视觉与三维建模
文章链接:https://mp\.weixin\.qq\.com/s/CAXFi4tyvYA3eKmhp8VomQ
✨导读: 来自 澳门大学、香港科技大学(广州)、密歇根大学 等机构的研究团队提出 Cyclops,尝试把低成本 Non-Repetitive Scanning LiDAR(NRS-LiDAR)直接变成一台“全天候相机”。方法只依赖 LiDAR Intensity:先将稀疏强度投影恢复成 Dense Intensity Image,再通过 Latent Bridge Matching(LBM) 将其快速转换为 RGB Video,同时加入 Temporal Attention 抑制连续帧闪烁,并利用可微 Reward 优化整条 ODE Generation Trajectory。最有意思的是,模型只在白天数据上训练,但到了 Near-dark 环境,真实相机已经严重退化,而 Cyclops 生成的 RGB 仍然可以直接交给 SAM 2、LaneATT 等现成视觉模型完成语义分割和车道线检测。
✨导读: 来自 澳门大学、香港科技大学(广州)、密歇根大学 等机构的研究团队提出 Cyclops,尝试把低成本 Non-Repetitive Scanning LiDAR(NRS-LiDAR)直接变成一台“全天候相机”。方法只依赖 LiDAR Intensity:先将稀疏强度投影恢复成 Dense Intensity Image,再通过 Latent Bridge Matching(LBM) 将其快速转换为 RGB Video,同时加入 Temporal Attention 抑制连续帧闪烁,并利用可微 Reward 优化整条 ODE Generation Trajectory。最有意思的是,模型只在白天数据上训练,但到了 Near-dark 环境,真实相机已经严重退化,而 Cyclops 生成的 RGB 仍然可以直接交给 SAM 2、LaneATT 等现成视觉模型完成语义分割和车道线检测。
机器人感知里,相机和 LiDAR 一直是两类非常互补的传感器。
相机擅长提供:
Color、Texture、Semantic Detail
但它有一个很明显的弱点:
高度依赖环境光。
高度依赖环境光。
到了夜间、弱光或者高动态范围场景,图像容易出现欠曝、过曝、噪声和细节丢失。 LiDAR 则恰好相反。
它主动发射激光,不仅可以获得 3D Geometry,还能测量 Intensity / Reflectivity。由于这个信号主要来自物体对激光的反射,而不是环境光,所以在白天和黑夜中通常更加稳定。
问题是:
LiDAR虽然不怕黑,但它“看到”的只是稀疏、单通道的世界。
LiDAR虽然不怕黑,但它“看到”的只是稀疏、单通道的世界。
大量 Foundation Vision Model,例如 SAM 2,本质上都是在 RGB Image 上训练的。直接把 LiDAR Intensity Image 喂进去,会产生非常大的 Modality Gap。
于是作者提出一个很反常识的问题:
与其让所有视觉模型重新适应LiDAR,为什么不直接把LiDAR翻译成它们熟悉的RGB?
与其让所有视觉模型重新适应LiDAR,为什么不直接把LiDAR翻译成它们熟悉的RGB?
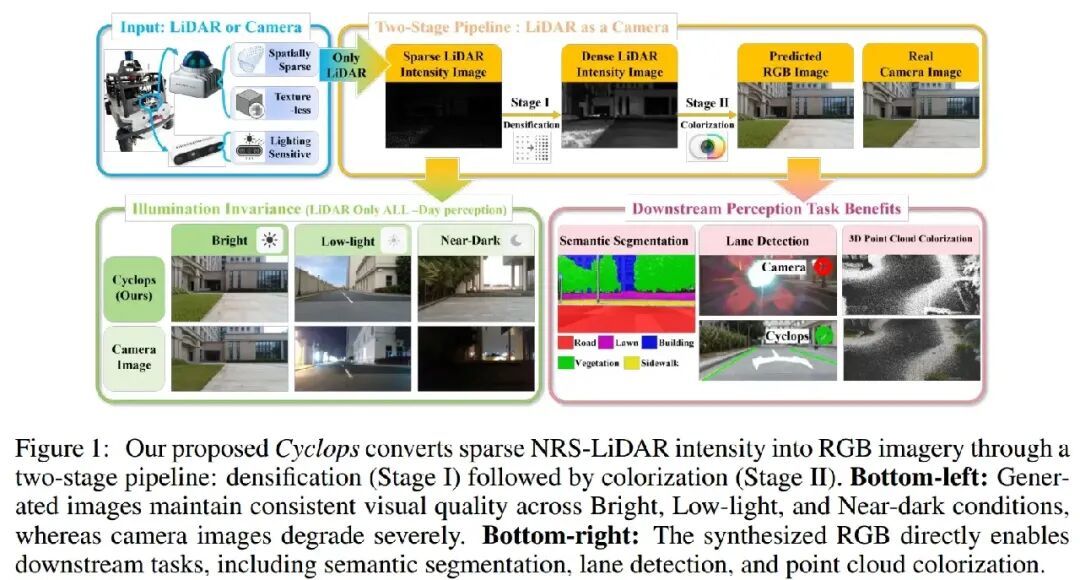
原文 Figure 1 给出了 Cyclops 的整体思路。
Sparse LiDAR Intensity → Dense Intensity → RGB Video → Existing RGB Perception Models
其中最关键的目标并不是生成“漂亮的图片”,而是让这些 RGB 保持:
Geometry正确、语义可用、时间稳定、推理足够快。
Cyclops 需要解决三个核心问题。
第一个是 Data Sparsity。
短时间的 NRS-LiDAR Projection 非常稀疏,Image Plane 中存在大量空洞。如果直接从这样的输入生成 RGB,网络同时承担 Geometry Completion 和 Appearance Generation,难度过高。
第二个是 Structural Fidelity。
LiDAR Intensity 和 RGB 在分布上差异巨大,但两者描述的是同一个真实场景。因此模型不能像普通 Image Generation 那样随意“脑补”,道路、建筑、树木等结构必须严格和 LiDAR Geometry 对齐。
第三个是 Temporal Stability and Efficiency。
如果每帧独立生成,即使单帧效果不错,连续播放时也可能出现颜色和纹理不断跳变。同时传统 Diffusion Model 需要几十步 Sampling,很难满足机器人在线部署。
Cyclops 因此采用了一个两阶段方案:
Intensity Densification → Temporal Latent Bridge RGB Synthesis
2.1 LiDAR Intensity in Robotic Perception
LiDAR Intensity 并不是一个全新的信息源。
此前研究已经将它用于:
Loop Closure、Place Recognition、Odometry、Terrain Classification 和 Semantic Segmentation。
这些工作说明 Intensity 确实包含一定 Texture / Material Information,而且具有较强的 Illumination Invariance。
但已有方法通常需要专门为 Intensity 设计网络,并且高质量表现往往依赖比较昂贵、分辨率较高的 LiDAR。
Cyclops 的路线不同:
它不重新设计一个“LiDAR版视觉模型”,而是把LiDAR主动转换成标准RGB接口。
它不重新设计一个“LiDAR版视觉模型”,而是把LiDAR主动转换成标准RGB接口。
这样就可以直接复用已经非常成熟的 RGB Foundation Models。
2.2 Cross-Modal Generation for Robotic Perception
LiDAR-to-RGB 本质上属于 Cross-modal Image Translation。
早期 Pix2Pix、CycleGAN 等 GAN 方法推理很快,但容易出现 Texture Hallucination、颜色偏移等问题。
Diffusion Model 的生成质量通常更高,但 Sampling Steps 多,实时性较差。
Video Diffusion 又进一步增加了时间维度计算,很多方法甚至需要 Future Frames,不适合 Streaming Robot。
作者因此选择 Latent Bridge Matching(LBM)。
传统 Diffusion 更像:
Gaussian Noise → RGB
而 Cyclops 已经拥有与目标场景高度对应的 LiDAR Intensity,因此没必要从纯随机 Noise 开始。
它真正需要学习的是:
Intensity Latent → RGB Latent
两者的 Geometry 已经大致一致,主要差异集中在 Appearance / Color 上,因此可以用更短的生成轨迹完成转换。
3.1 Problem Formulation and Pipeline Overview
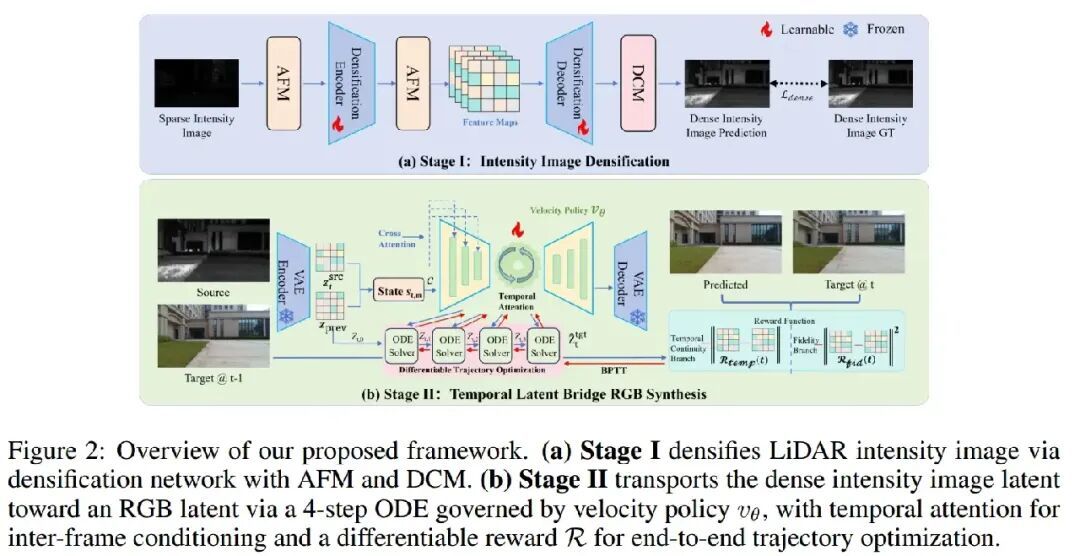
Cyclops 的完整框架如原文 Figure 2 所示。
给定连续稀疏 LiDAR Intensity:
模型希望生成对应 RGB Video:
整个流程分为两个 Stage。
Stage I:Sparse Intensity → Dense Intensity
Stage II:Dense Intensity Latent → RGB Latent → RGB Image
需要注意的是,训练时需要同步的 LiDAR / Camera Pair 作为监督。
但到了真正 Deployment 阶段:
系统只需要LiDAR,不再需要Camera。
系统只需要LiDAR,不再需要Camera。
这也是 Cyclops 所说的 “LiDAR as a Camera”。
3.2 Stage I: Intensity Image Densification
原文 Figure 3 很直观地展示了 NRS-LiDAR 的特点。
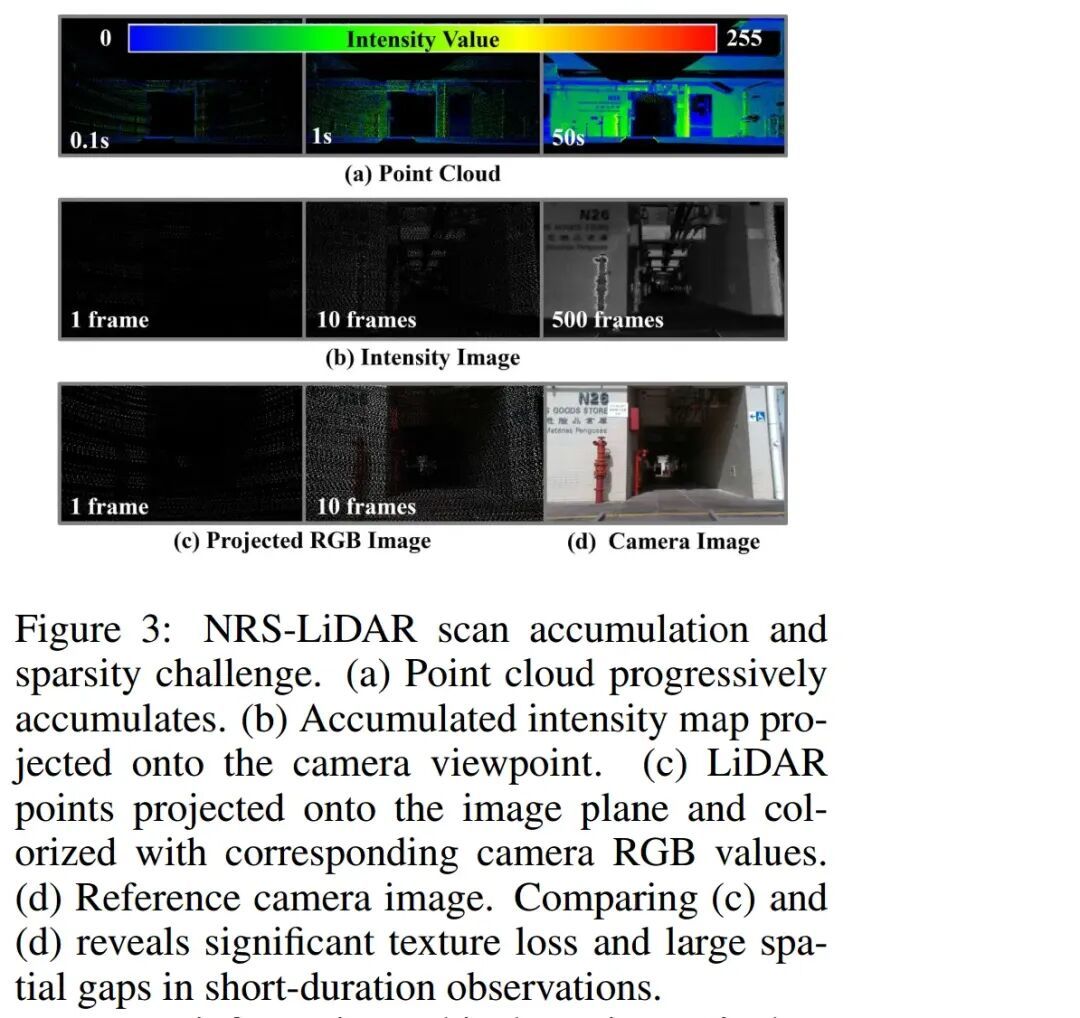
Non-Repetitive Scanning LiDAR 每一帧的扫描轨迹都不完全相同,因此随着时间累积,空间覆盖率会越来越高。
短时间:
大量空洞。
长时间累积:
逐渐形成Dense Intensity Map。
作者利用这个特点,为 Sparse Intensity 构造 Dense Ground Truth,并训练 Densification Network。
在 Cyclops 中,这个模型直接作为 Frozen Module 使用。
每次融合:
个连续 LiDAR Scans,再通过 Odometry 对齐并投影到 Image Plane。
Densification Network 主要包含两个关键模块。
Adaptive Fusion Module(AFM) 使用 Dilated Convolution 和 Deformable Convolution 聚合不同尺度的 Context,主要负责恢复大面积缺失区域,同时尽可能保留结构边缘。
Dynamic Compensation Module(DCM) 则利用 Range 和 Incidence Angle 等几何信息对 Intensity 进行校正。
因为 LiDAR Intensity 并不是一个完全固定的 Material Property,它还会受到距离和入射角影响。
因此 DCM 的作用是:
让恢复后的Dense Intensity不仅“填满了”,而且尽量符合真实LiDAR反射规律。
让恢复后的Dense Intensity不仅“填满了”,而且尽量符合真实LiDAR反射规律。
最后得到 Dense Intensity Image ,再由 VAE Encoder 转换成 Source Latent 。
可以把 Stage I 理解成:
? 先给RGB生成搭一个足够完整、可靠的几何骨架。
? 先给RGB生成搭一个足够完整、可靠的几何骨架。
3.3 Stage II: Temporal Latent Bridge RGB Synthesis
3.3.1 Preliminaries: Latent Bridge Matching
Stage II 真正负责给 LiDAR “上色”。
设 Dense Intensity Latent 为 ,Ground-truth RGB Latent 为 。
LBM 不从 Gaussian Noise 开始,而是在两种 Latent Distribution 之间构造一条 Bridge:
其中 表示当前所处的 Bridge Time。
当 时靠近 LiDAR Intensity;
当 时到达 RGB。
网络学习一个 Velocity Field ,告诉当前 Latent:
下一步应该向RGB Distribution的哪个方向移动。
下一步应该向RGB Distribution的哪个方向移动。
所以它并不是:
“从零画一张照片。”
而更像:
“在已有LiDAR结构上逐渐补出颜色、纹理和外观。”
Cyclops 只使用:
个离散 Bridge Steps。
训练和测试使用相同的时间离散位置,相当于一种 Implicit Distillation。
最终只需要:
4 Euler Steps
就可以完成 RGB Generation。
这也是它相比传统 Diffusion 更适合机器人 Deployment 的原因之一。
3.3.2 Temporal Conditioning Mechanism
单帧生成还有一个明显问题:
Frame N的树可能是深绿色,Frame N+1突然变成浅绿色。
Frame N的树可能是深绿色,Frame N+1突然变成浅绿色。
即使两张图分别看都合理,视频播放起来仍然会出现 Flickering。
因此 Cyclops 在生成当前帧时额外引入上一帧 RGB Latent。
这里有两条不同的 Attention。
Source Cross-Attention 使用当前帧 LiDAR Intensity Latent,主要保证:
当前生成结果必须服从这一帧真实LiDAR Geometry。
当前生成结果必须服从这一帧真实LiDAR Geometry。
Temporal Attention 使用上一帧生成的 RGB Latent,主要提供:
上一帧已经形成的Appearance / Color Memory。
上一帧已经形成的Appearance / Color Memory。
所以两条信息分别回答:
Source:这一帧东西在哪里?
Temporal:这些东西上一帧大概是什么颜色?
这种设计并不是直接把两帧 Pixel 对齐,而是通过 Attention 读取历史 Appearance Feature,因此对轻微 Camera Motion 更加宽容。
最终形成:
Current Geometry Anchor + Previous Appearance Memory
从而减少连续帧之间的颜色漂移。
3.3.3 Differentiable Reward-Guided Trajectory Optimization
普通 LBM Loss 主要监督中间 Velocity 是否合理。
但机器人真正使用的并不是某一个 Intermediate State,而是:
完整4步ODE走完之后的最终RGB。
完整4步ODE走完之后的最终RGB。
如果前几步都有一点小偏差,最终误差可能不断累计。
所以作者进一步把 Velocity Field 看成:
Velocity Policy。
第 个 Euler Step 可以写成:
每一步 Velocity 都决定下一步 Latent State。
因此整条 ODE 可以看作:
State → Action → State → Action → ... → Terminal State
作者在最终状态设计了两个 Reward。
第一个是 Fidelity Reward:
用于保证最终结果接近真实 RGB。
第二个是 Temporal Reward。
这里作者没有简单要求:
Frame N ≈ Frame N-1
因为这样会把真实运动也一起抹掉。
它真正约束的是:
Generated Temporal Change 应该接近 Ground-truth Temporal Change。
Generated Temporal Change 应该接近 Ground-truth Temporal Change。
也就是说:
该动的允许动,不该闪的不要闪。
最终:
虽然这里使用了 Policy 和 Reward 的概念,但它并不是传统 RL。
因为整个 ODE Solver 都是可微的。
作者直接使用:
Backpropagation Through Time(BPTT)
从 Terminal Reward 一直反向传播到前面4个 Euler Steps。
所以它更准确的定位是:
Differentiable Reward-guided Trajectory Optimization。
Differentiable Reward-guided Trajectory Optimization。
也就是说,不只是教模型“每一步走得像不像”,而是直接告诉它:
“你整条路最后走到了哪里,这才是我真正关心的。”
“你整条路最后走到了哪里,这才是我真正关心的。”
3.4 Training Strategy
Cyclops 采用两阶段训练。
第一阶段主要让模型学会:
Intensity → RGB
训练目标由 LBM Loss、LPIPS、Gradient Loss 和 Color Statistics Loss 组成。
其中:
LPIPS 保证 Perceptual Similarity;
Gradient Loss 保证 Edge Sharpness;
Color Loss 防止整体 Color Drift。
这一阶段 Temporal Attention 主要采用 Teacher Forcing,使用 Ground-truth Previous Frame。
第二阶段加入前面的 Terminal Reward,并采用 Scheduled Sampling。
也就是说,Previous Frame Conditioning 会逐渐从:
Ground-truth Frame
切换成:
Model-generated Frame。
Teacher-forcing Probability 从:
逐渐下降到:。
这是为了减少 Training / Inference Gap。
否则模型训练时永远看到完美上一帧,而实际推理时只能看到自己的生成结果,一旦前一帧有误差,就容易不断累积。
实验主要验证两个问题:
Cyclops生成的RGB本身是否足够稳定?
Cyclops生成的RGB本身是否足够稳定?
以及:
这些“假RGB”到底能不能真正服务机器人感知?
这些“假RGB”到底能不能真正服务机器人感知?
所有模型只使用 Bright Daytime Data 训练,Low Light 和 Near Dark 仅用于测试,因此夜间结果可以直接反映 Illumination Generalization。
4.1 Evaluation of Temporal Latent Bridge RGB Synthesis
相比 CycleGAN、Pix2Pix、BBDM 和 LDM,Cyclops 在 Image Quality 和 Temporal Consistency 上整体表现最好。
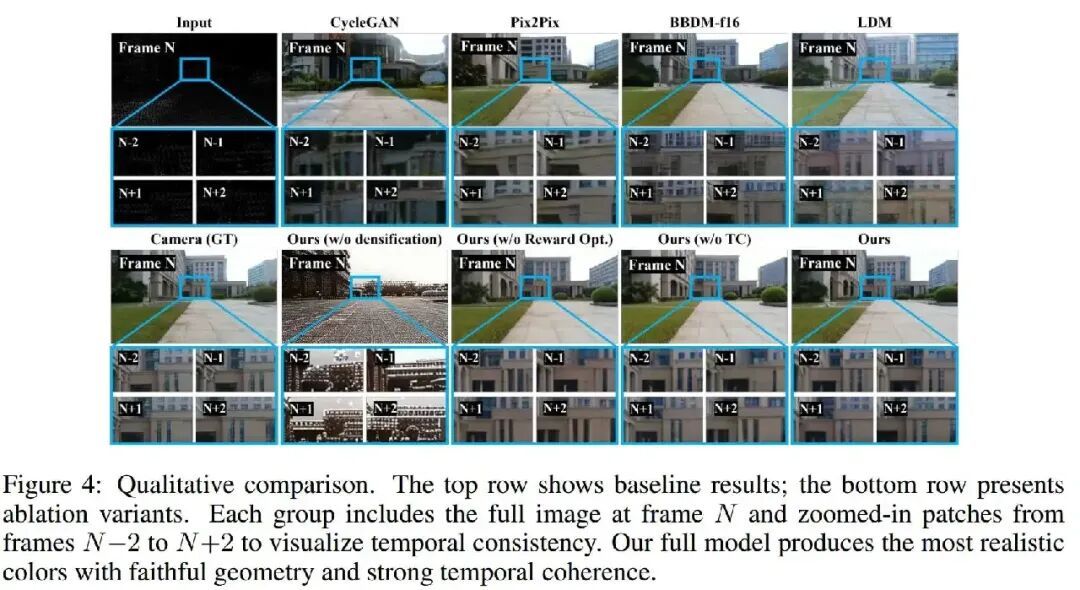
原文 Figure 4 可以看到,GAN 方法容易出现颜色失真或模糊,而独立 Diffusion Generation 虽然单帧效果较好,但连续帧仍存在明显 Flickering。
Cyclops 的完整模型在几何结构、颜色以及时间连续性上更加稳定。
消融实验也说明三个模块各自解决了不同问题:
Densification → 解决Sparse Input
Temporal Conditioning → 解决Video Flickering
Reward Optimization → 提高最终RGB Fidelity
4.2 Semantic Segmentation
作者直接将生成 RGB 输入 SAM 2。
这是整篇论文最有说服力的实验之一。
在 Bright 条件下:
Camera mIoU 为 ;
Cyclops 为 。
真实相机仍然更强。
但到了 Near Dark:
Camera 直接下降到 ;
Cyclops 仍然保持 。
也就是说:
? 环境越黑,真实Camera越看不清,而LiDAR生成的RGB几乎不受影响。
? 环境越黑,真实Camera越看不清,而LiDAR生成的RGB几乎不受影响。
更有意思的是,直接把 Dense Intensity Image 输入 SAM 2 只有约 mIoU。
这说明真正有价值的不只是 LiDAR 本身,而是:
把LiDAR信息转换成Foundation Vision Model熟悉的RGB Distribution。
把LiDAR信息转换成Foundation Vision Model熟悉的RGB Distribution。
4.3 Traffic Lane Detection
Lane Detection 上也出现类似现象。
Bright 条件下 Camera Accuracy 最高,为:
但 Near Dark 时下降到:
。
Cyclops 则仍达到:
。
说明 Lane Marking 的 LiDAR Reflectivity 对光照非常稳定,而 RGB Colorization 又补充了视觉模型能够利用的 Appearance Cue。
4.4 Point Cloud Colorization
Cyclops 还有一个很自然的副产品:
给3D Point Cloud直接上颜色。
给3D Point Cloud直接上颜色。
由于生成 RGB 与 LiDAR Projection 存在已知像素对应关系,RGB 值可以直接回填到原始3D Point。
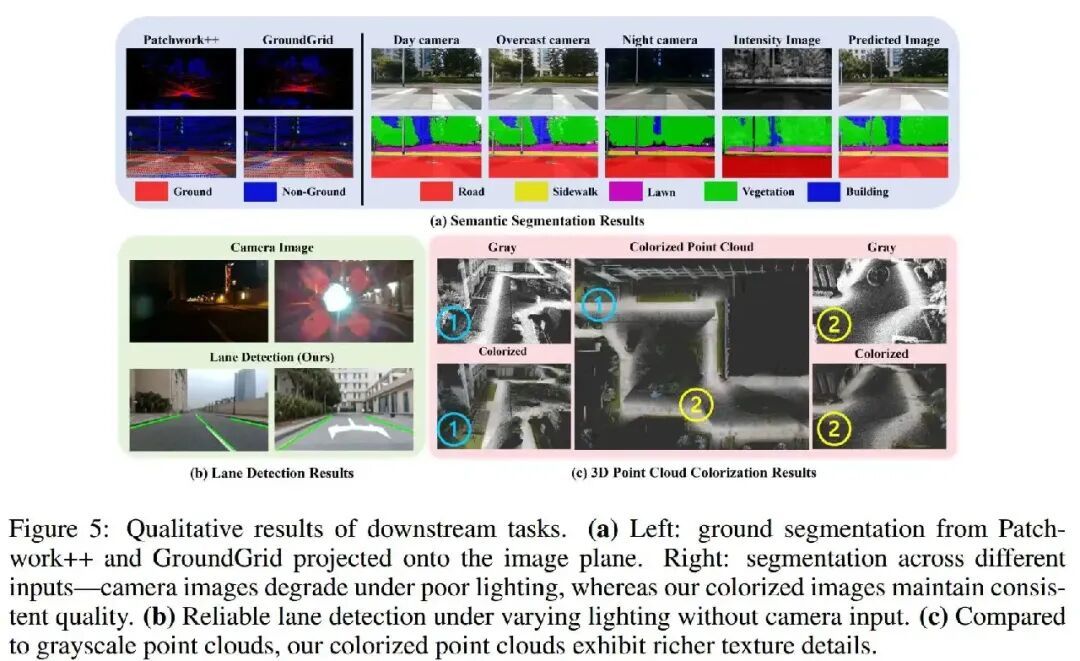
原文 Figure 5 中可以看到,Colorized Point Cloud 相比普通 Gray / Intensity Point Cloud 拥有更清楚的 Object Boundary 和 Surface Texture。
最终可以得到更加丰富的:
XYZ + RGB
3D Representation。
Cyclops 走了一条非常有意思的路线:
不是让视觉模型适应LiDAR,而是让LiDAR主动变成视觉模型熟悉的RGB。
不是让视觉模型适应LiDAR,而是让LiDAR主动变成视觉模型熟悉的RGB。
通过 Intensity Densification、Latent Bridge Matching、Temporal Conditioning 和 Reward-guided ODE Optimization,低成本 NRS-LiDAR 可以生成具有稳定结构和时间一致性的 RGB Video。
更加重要的是,这些 RGB 不只是“看起来像照片”,而能够直接用于 Semantic Segmentation、Lane Detection 和 Point Cloud Colorization。
这篇论文最核心的观点可以概括成:
? Camera的优势是看得丰富,LiDAR的优势是不怕黑;Cyclops尝试让一个不怕黑的LiDAR,也学会用Camera的方式看世界。
? Camera的优势是看得丰富,LiDAR的优势是不怕黑;Cyclops尝试让一个不怕黑的LiDAR,也学会用Camera的方式看世界。
Cyclops 最大的限制来自:
Intensity → RGB 本质上是一对多映射。
两个完全不同颜色或材质的物体,可能产生相似 LiDAR Reflectivity。
因此模型生成的颜色可能“合理”,但不一定是真实颜色。
这对于 Semantic Segmentation 等主要依赖结构的任务影响有限,但对于 Traffic Light Recognition 等强依赖真实 Color 的任务风险更大。
另外,远距离 Point Cloud 本身更加稀疏,即使经过 Densification,Thin Structure、Pole、Wire 和 Distant Pedestrian 仍可能出现模糊或 Hallucination。
最后,在快速 Ego-motion 或 Fast-moving Object 场景中,上一帧 Appearance Memory 可能与当前场景对应不上,从而重新出现 Temporal Artifact。
因此 Cyclops 目前更加适合:
依赖Geometry、Structure和粗粒度Semantic的全天候视觉任务,而不是要求颜色具有严格物理真实性的应用。
依赖Geometry、Structure和粗粒度Semantic的全天候视觉任务,而不是要求颜色具有严格物理真实性的应用。
原文链接: https://www.leiphone.com/category/private/SrL1t2wcUprq1Rk9.html
