


来源:遥感与深度学习
原文链接:https://mp.weixin.qq.com/s/vZ6MEu5IEEI3WvnSv4bdow
题目:RoadBench: Benchmarking MLLMs on Fine-Grained Spatial Understanding and Reasoning under Urban Road Scenarios
会议:European Conference on Computer Vision(ECCV 2026)论文:https://arxiv.org/abs/2511.18011
GitHub:https://github.com/tsinghua-fib-lab/RoadBench
年份:2026
单位:清华大学、北京中关村学院、高德地图
ECCV2026遥感方向合集:ECCV2026
创新点
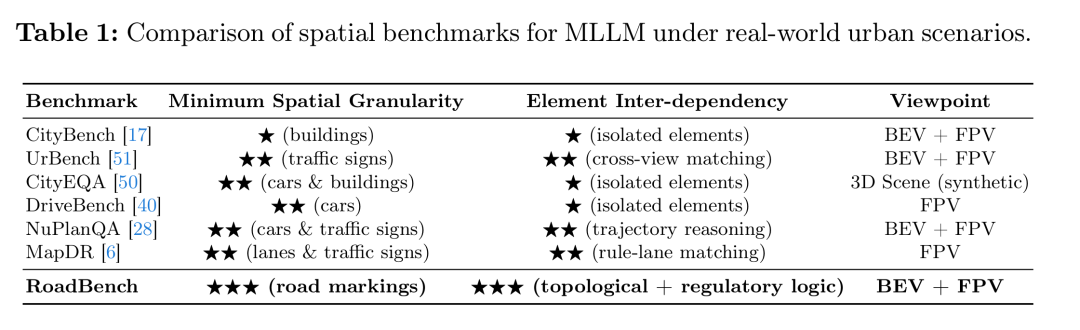
首次聚焦于道路标线这一城市场景下的细粒度空间元素,提出系统性基准 RoadBench,填补现有城市空间理解基准在细粒度层面的空白。 设计了从局部到全局、涵盖鸟瞰视角(BEV)与第一人称视角(FPV)的八大任务体系,并引入跨视角联合推理任务。 构建了3,040个经过严格人工核验的测试样本,数据来源涵盖卫星影像、地图服务商数据库及车载摄像头照片,覆盖多城市、多光照、多季节场景。 对20个主流开源与闭源MLLM进行系统评测,揭示其在细粒度空间理解与推理上的显著短板,部分任务表现甚至不如简单规则或随机基线。
背景
多模态大语言模型(MLLM)在通用空间理解与推理方面展现出强大能力,并逐渐在卫星影像识别、自动驾驶、具身智能等领域替代专用模型。已有城市空间理解基准主要聚焦于整图级理解或孤立目标识别(如地标识别、车辆检测),但缺乏对城市场景中细粒度空间结构元素的关注。
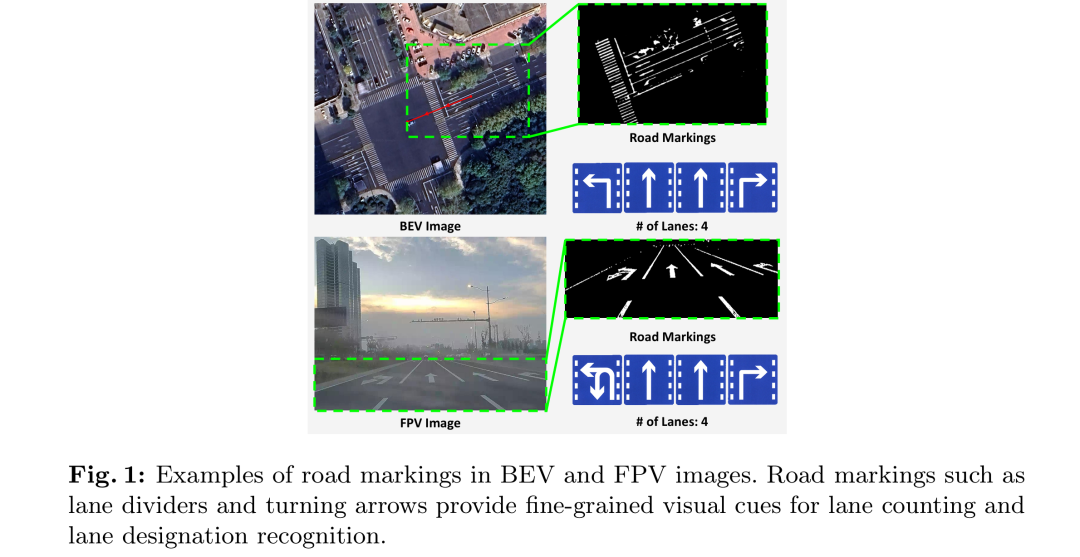
城市道路标线作为典型的细粒度空间元素,具有窄长、跨图像分布的特点,其理解需要模型具备全局尺度识别、多元素联合推理以及图像信息与交通领域知识融合的能力,这对现有MLLM构成了显著挑战,也是当前基准评测体系中的空白。
数据
RoadBench 数据集
数据规模:共3,040个测试样本,包含2,137张BEV唯一图像与721张FPV唯一图像,来自五个交通规则较为一致的中国城市。 数据来源:BEV参考线坐标与实际车道数来自OpenStreetMap及一级在线地图服务商数据库;FPV图像来自众包车载摄像头照片数据库。 任务划分:涵盖BEV车道计数、BEV车道指向识别、BEV路网校正、FPV车道计数、FPV车道指向识别、FPV道路类型分类,以及跨视角车道计数与跨视角车道指向识别共八项任务。 隐私处理:所有ID随机化为UUID,地理坐标转换为图像像素坐标,FPV图像中可能暴露隐私的信息均已人工遮罩处理。
方法
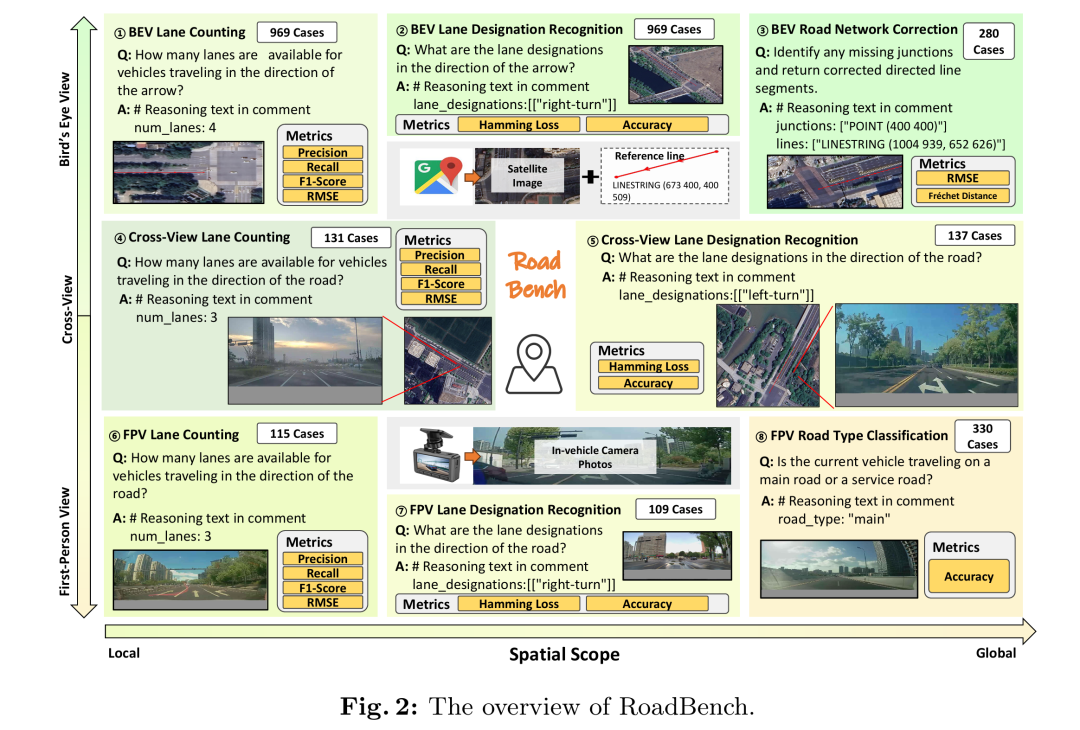
基准任务设计
单视角任务
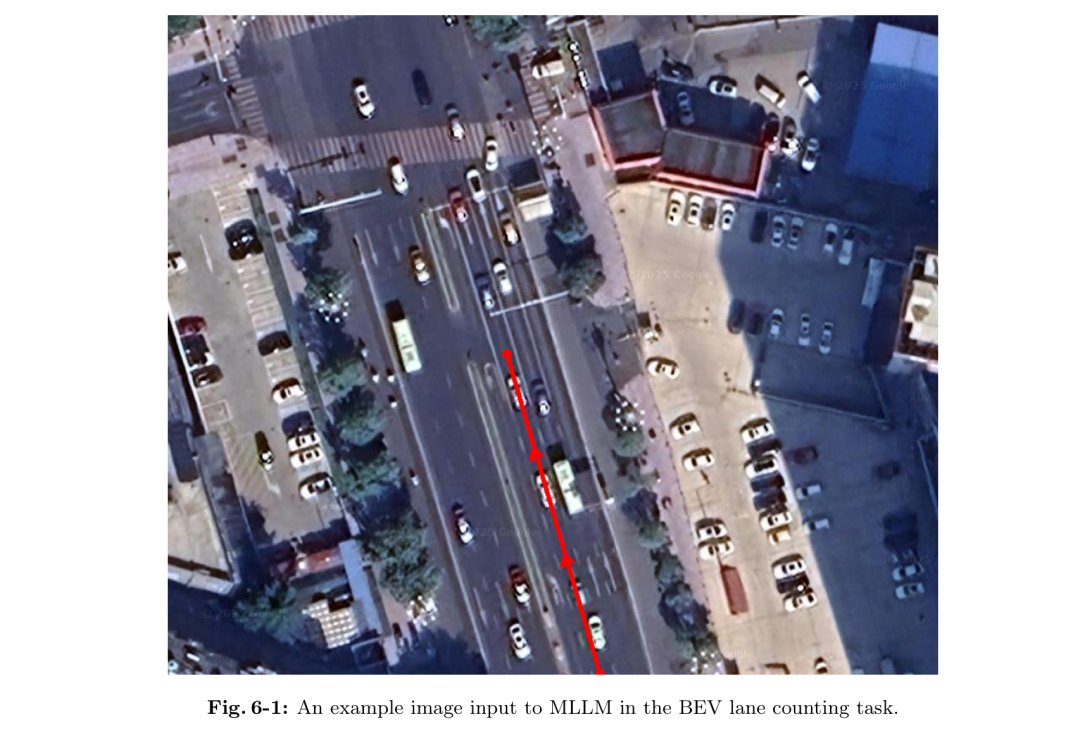
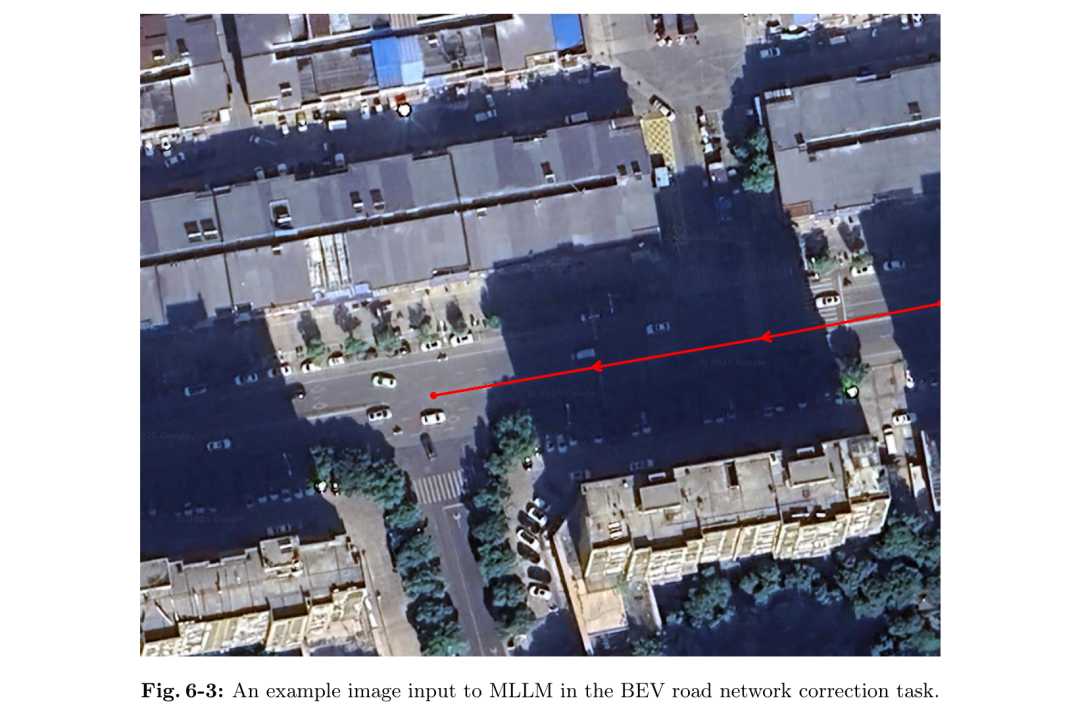
BEV/FPV车道计数:要求模型根据参考线或道路场景判断指定方向可通行车道数。 BEV/FPV车道指向识别:要求模型基于路面箭头等标线识别各车道的转向类型(直行、左转、右转、掉头等),按每车道多标签分类处理。 BEV路网校正:输入存在缺失路口等误差的参考线,要求模型识别缺失路口并输出修正后的有向路段几何。 FPV道路类型分类:要求模型判断车辆当前行驶于主路还是辅路,需综合环境语义线索进行常识推理。
跨视角任务
跨视角车道计数与跨视角车道指向识别:提供地理配对的BEV与FPV图像,要求模型建立两视角间的空间对应关系,融合拓扑结构信息与自我中心视觉细节完成联合推理。
基准构建流程
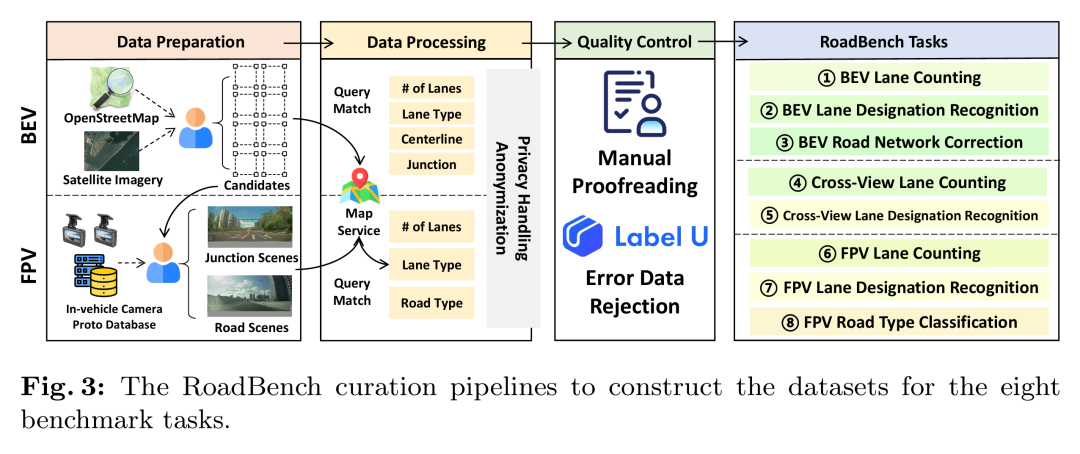
数据准备:基于OpenStreetMap路口与卫星影像分辨率确定候选区域,人工筛选剔除无效图像;FPV图像按地理一致性从相同路口候选区提取。 数据处理:将候选区域与地图服务商数据库匹配,提取车道数、车道方向、路口位置等真值标签,并完成隐私匿名化处理。 质量控制:由五位领域专家使用LabelU平台对全部样本进行人工审核,对存在歧义或错误的样本采取剔除而非重标注的保守策略。
评测设置
评测对象包括LLaMA-3.2-Vision、Qwen2.5-VL、Qwen3-VL系列、Gemma-3、GLM-4.5V等开源模型,以及Gemini-2.5系列、GPT-5系列等闭源模型,并对部分小规模Qwen3-VL模型进行了任务微调。 针对不同任务分别采用精确率/召回率/F1、Hamming Loss、准确率、RMSE、Fréchet距离等指标,并设置规则或随机基线用于对比。
结果与分析
评测结果表明,即使是当前最强的闭源与开源MLLM在RoadBench各项任务上表现均不理想,且在多个任务上难以超越简单规则或随机选择基线,反映出其在细粒度空间理解、跨视角对齐及结构化坐标输出方面存在明显局限。总体而言,闭源模型相对开源模型具有一定优势,且模型微调可显著提升小模型表现,但与顶尖闭源模型仍存在差距。
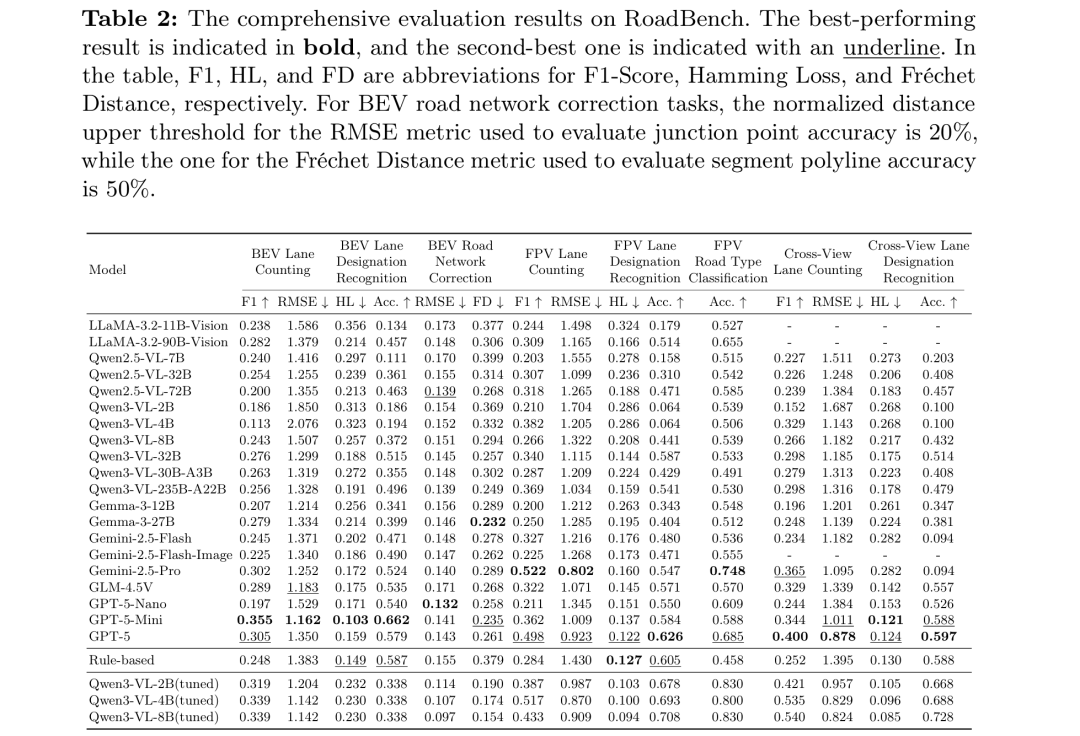
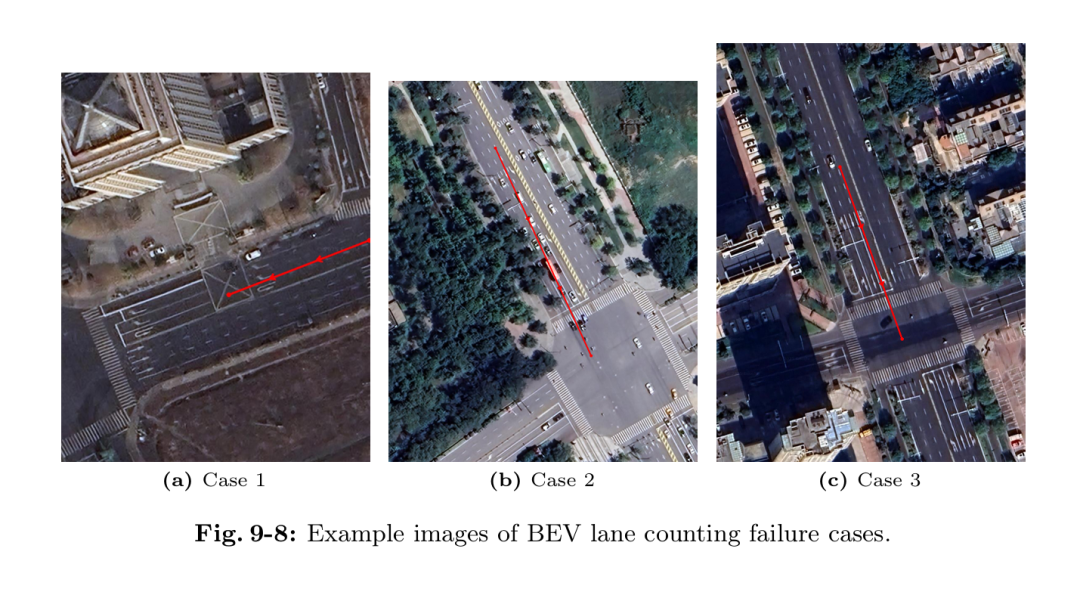
图9-8 案例对应正文中描述的GPT-5-Mini的三个典型错误:
Case 1:把非机动车道误计为机动车道,导致车道数高估
Case 2:忽略了没有车辆停留的最左侧车道,导致车道数低估
Case 3:混淆了对向车道的箭头标线,错误地把对向车道计入当前方向
