


来源:我爱计算机视觉
原文链接:https://mp.weixin.qq.com/s/3xekNy_ObCYtS2-mFkos1g
扩散Transformer(Diffusion Transformers, DiT)如今已成为高保真视觉生成领域的黄金标准,像广为人知的 FLUX.1 和 HunyuanVideo 等模型,其生成效果确实令人惊叹。然而,这种惊艳效果的背后,是极其高昂的推理延迟——在单张 A100 显卡上,FLUX.1-dev 生成一张图片需要耗费将近 24 秒。这种顺序(sequential)的去噪机制,严重制约了它的实时部署。
为了攻克这一瓶颈,学术界近期涌现出了许多“缓存并预测”的免训练加速方案(如 TaylorSeer、HiCache 等),试图通过多项式来预测特征轨迹。然而,这些方案在面对高加速比(比如 5 倍加速)时,往往会遭遇画质“雪崩式”的退化。
浙江大学的研究团队在最新被 ECCV 2026 录用的论文中,深入剖析了这一失败的根源,并提出了一种名为ResilPhase 的免训练、即插即用加速框架。它不仅在 FLUX.1-dev 和 HunyuanVideo 上实现了近 5 倍的无损加速,而且将额外显存开销降到了近乎为零的0.27 GB。
论文标题: ResilPhase: Plug-and-Play Phase Mapping and Noise-Resilient Macro-Trajectory Extrapolation for Diffusion Acceleration 论文地址: https://arxiv.org/abs/2606.26769 代码地址: https://github.com/zqc214/ResilPhase (代码已开源)
背景与动机:传统外推方案的三大硬伤
要理解 ResilPhase 为什么有效,需要先审视传统的外推加速方案卡在了哪里。作者指出,现有的预测缓存方案在空间、时间和数值逼近三个维度上存在硬伤:
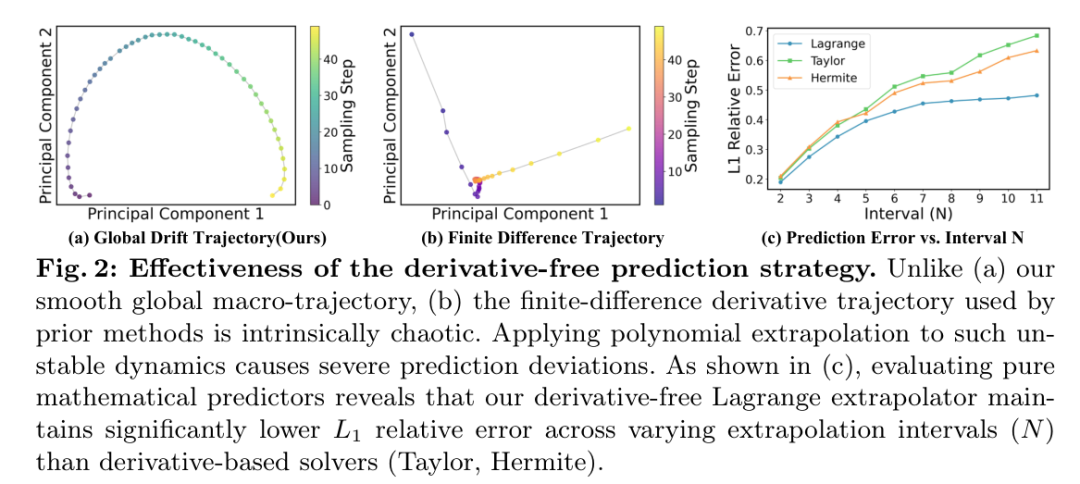
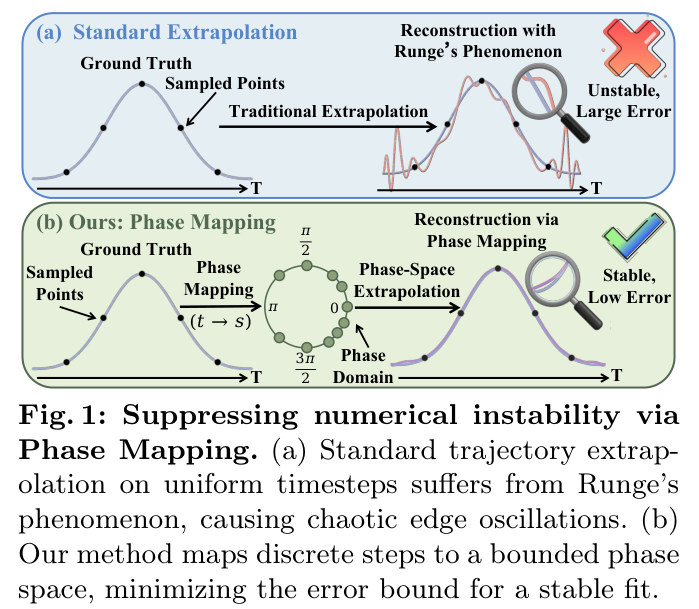
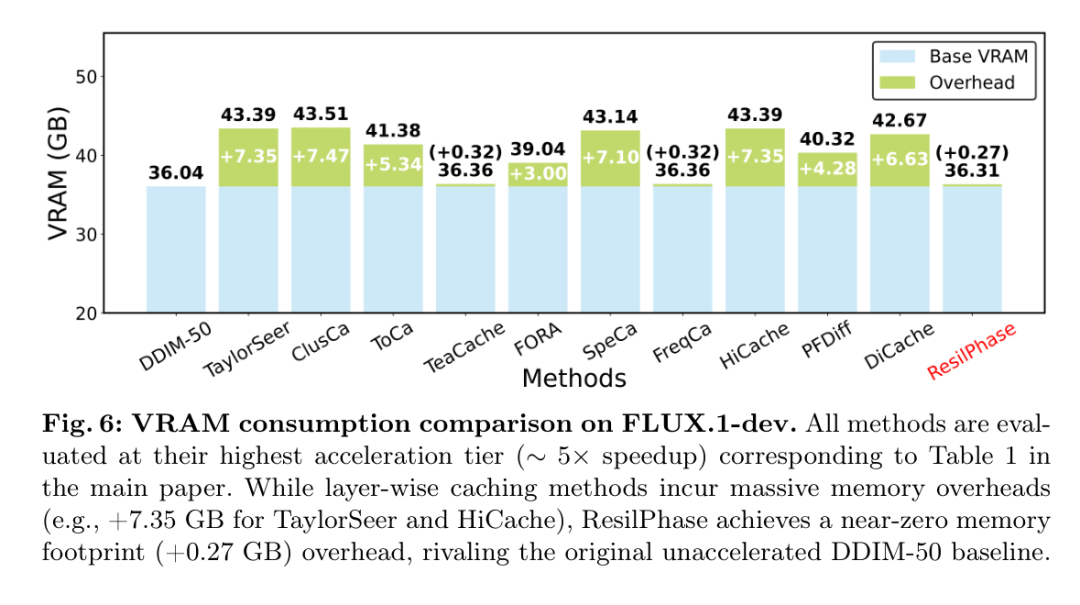
空间维度(层级累积误差):大多数方法(如 TaylorSeer、HiCache)采用“逐层预测(layer-wise)”的范式。在 Transformer 块内部,微观特征(micro-features)往往极其不规律且波动剧烈。对这些高频信号硬套多项式拟合,会导致预测误差在网络深处呈指数级累积,同时缓存每一层的特征会带来高达 7GB 以上的庞大显存开销。 时间维度(导数谬误):现有的预测器高度依赖基于导数的近似(如泰勒展开或埃尔米特插值)。然而,虽然扩散模型的宏观轨迹是平滑的,但其特征在时间维度上的高阶导数其实充满了混沌噪声。用有限差分去估计这些导数,无异于在噪声上做高通滤波,会成倍放大预测偏差。 数值逼近维度(龙格现象):在均匀分布的离散时间步上进行高阶多项式外推,会不可避免地触发数值分析中经典的龙格现象(Runge's Phenomenon)。这会导致外推区间边缘的误差呈指数级振荡,直接导致高加速比下生成的图像出现严重的伪影和语义漂移。
方法详解:重构无导数的有界相位空间外推
为了彻底解决上述痛点,ResilPhase 抛弃了传统的逐层预测和导数逼近,从空间、时间和数值逼近三个维度对加速推理进行了重构。
1. ODE对齐的宏观轨迹目标(Global Drift)
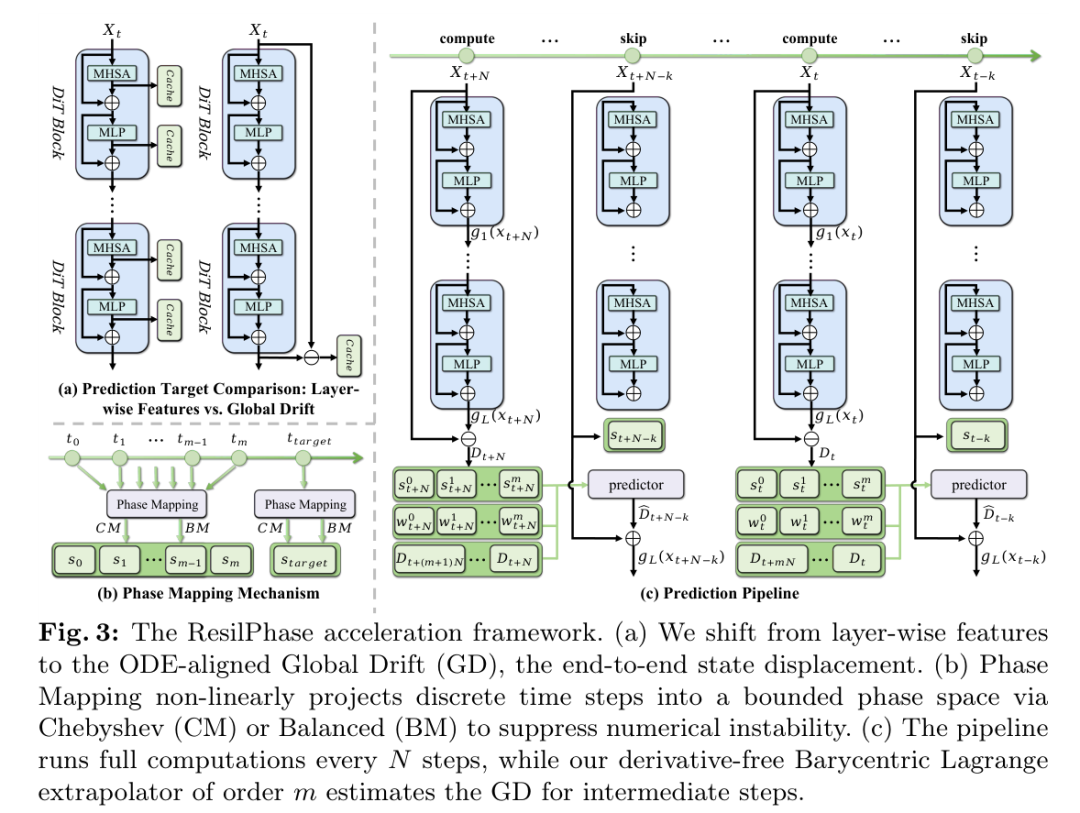
为了斩断空间上的误差累积,ResilPhase 将预测目标从“逐层的微观特征”提升到了“全局的常微分方程(Ordinary Differential Equation, ODE)状态演化”。
作者定义了全局漂移(Global Drift, GD),记为。它表示模型的最终输出 与初始输入 之间的端到端状态位移:
在跳过的推理步骤中,推理过程不再去计算或预测那几十层 Transformer 块的中间特征,而是直接用一个宏观预测器 来外推这个全局漂移。最终的输出直接通过简单的加法重建:
输入与输出流程:
输入:当前时间步的潜空间输入。 处理:直接通过外推器预测端到端的全局漂移,无需任何中间层的特征缓存。 输出:重建后的模型最终输出。
这种设计将空间误差的累积上界从 降到了,不仅彻底避免了误差在层间的放大,还因为不需要缓存任何中间层特征,将缓存的显存开销降到了近乎为零。
2. 无导数的重心拉格朗日外推
虽然全局漂移(GD)的轨迹非常平滑,但其高阶时间导数依然嘈杂。为了绕开导数计算,ResilPhase 引入了无导数的重心拉格朗日插值法(Barycentric Lagrange Interpolation)。
对于 个历史数据点,其插值多项式为:
其中,重心权重 仅与时间步的相对位置有关。这意味着在推理前,可以直接预计算并缓存这些权重,在实际推理时,外推的计算复杂度仅为,且完全避开了不稳定的有限差分导数。
输入与输出流程:
输入:历史时间步 对应的全局漂移值(即),以及目标外推时间步。 处理:利用预计算的重心权重,通过重心拉格朗日公式直接计算外推值。 输出:预测的目标时间步全局漂移。
3. 即插即用的相位映射(Phase Mapping)
为了从根本上抑制龙格现象引起的边缘振荡,ResilPhase 首次提出将物理时间步 投影到一个有界的连续相位空间 中进行外推。
输入与输出流程:
输入:物理时间步。 处理:通过切比雪夫映射或均衡映射,将 非线性投影到有界相位空间中的坐标。 输出:有界相位空间坐标,作为重心拉格朗日外推的实际自变量。
论文中设计了两种映射机制:
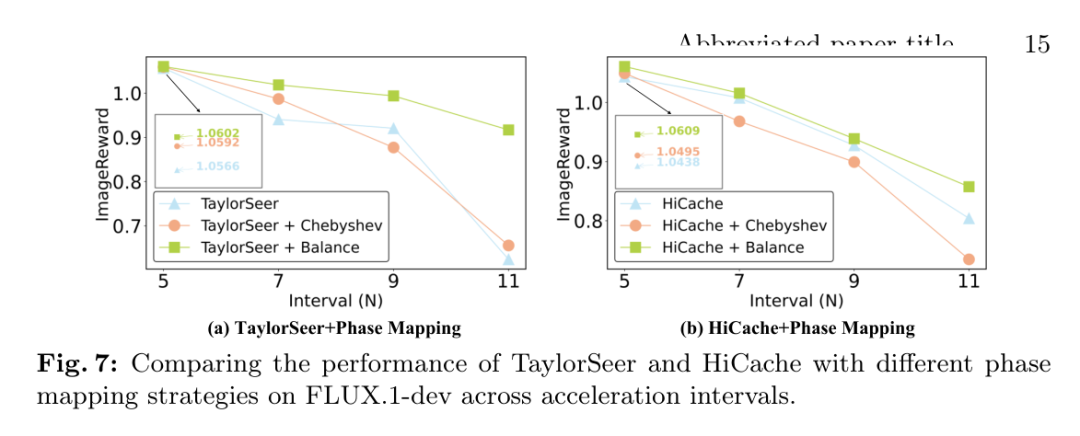
切比雪夫映射(Chebyshev Mapping):利用切比雪夫节点 来重新分布时间步。在数学上,切比雪夫节点能够最大程度地压低多项式插值的最大误差上界,非常适合类别条件生成任务。 均衡映射(Balanced Mapping):针对复杂的文生图和文生视频任务,作者设计了一种数据驱动的非线性映射:其中 和 分别是当前历史时间窗内时间步均值和最大绝对偏差, 为缩放因子(默认设为 0.55)。通过双曲正切函数,将离散的时间步动态收敛到有界空间中,极大地增强了外推的稳定性。
实验与结果:5倍加速下的无损神话
研究团队在 FLUX.1-dev、HunyuanVideo 和 DiT-XL/2 等主流模型上进行了广泛的测试。
1. FLUX.1-dev 文生图表现
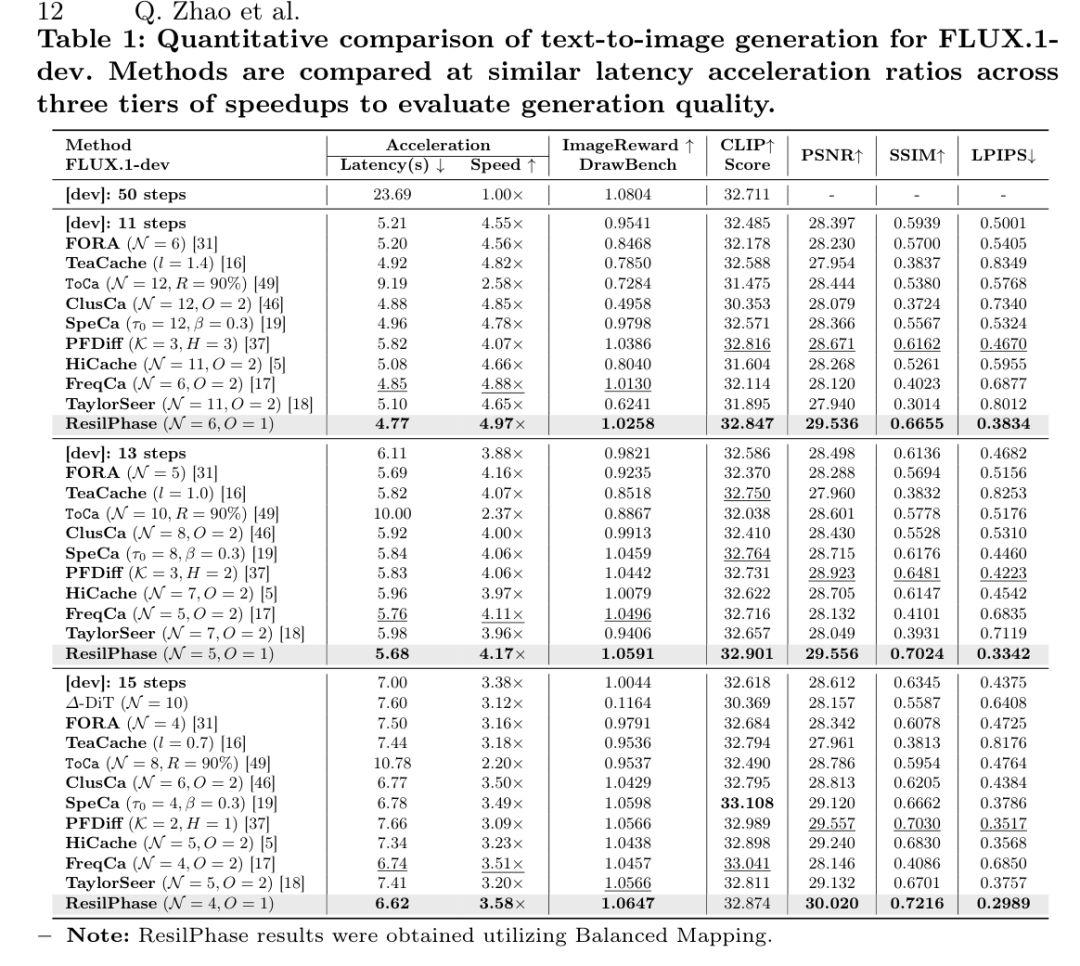
在 FLUX.1-dev 上,未加速的 50 步采样耗时 23.69 秒。
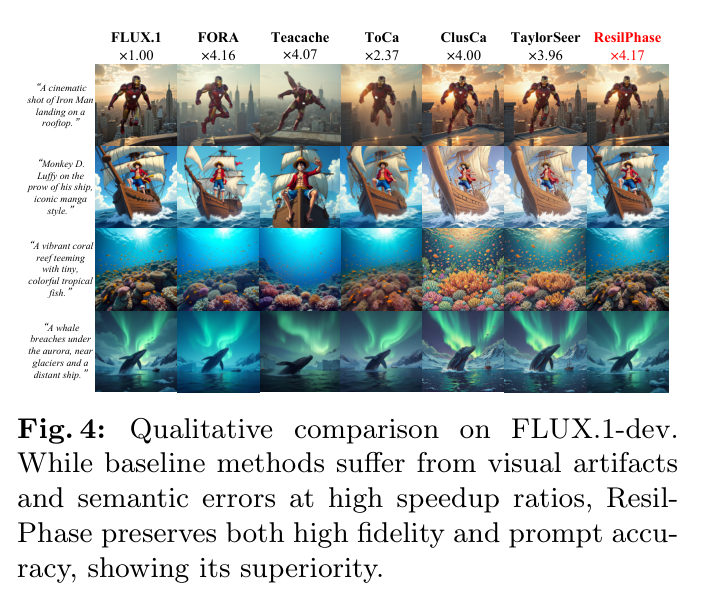
如 Table 1 所示,在相似的加速比下,ResilPhase 的表现令人惊艳。在4.97倍 的高加速比下(耗时缩短至 4.77 秒),ResilPhase 依然保持了1.0258 的 ImageReward 和29.536 的 PSNR。而同等加速比下的 TaylorSeer,其 ImageReward 跌落至 0.6241,LPIPS 飙升至 0.8012,画面出现了严重的语义崩坏和伪影。
2. HunyuanVideo 文生视频表现
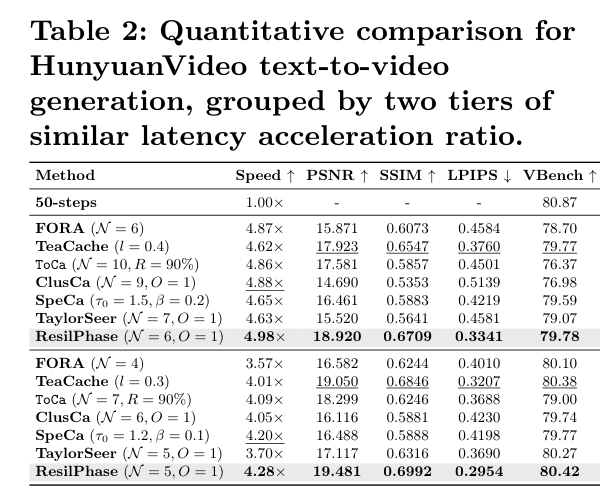
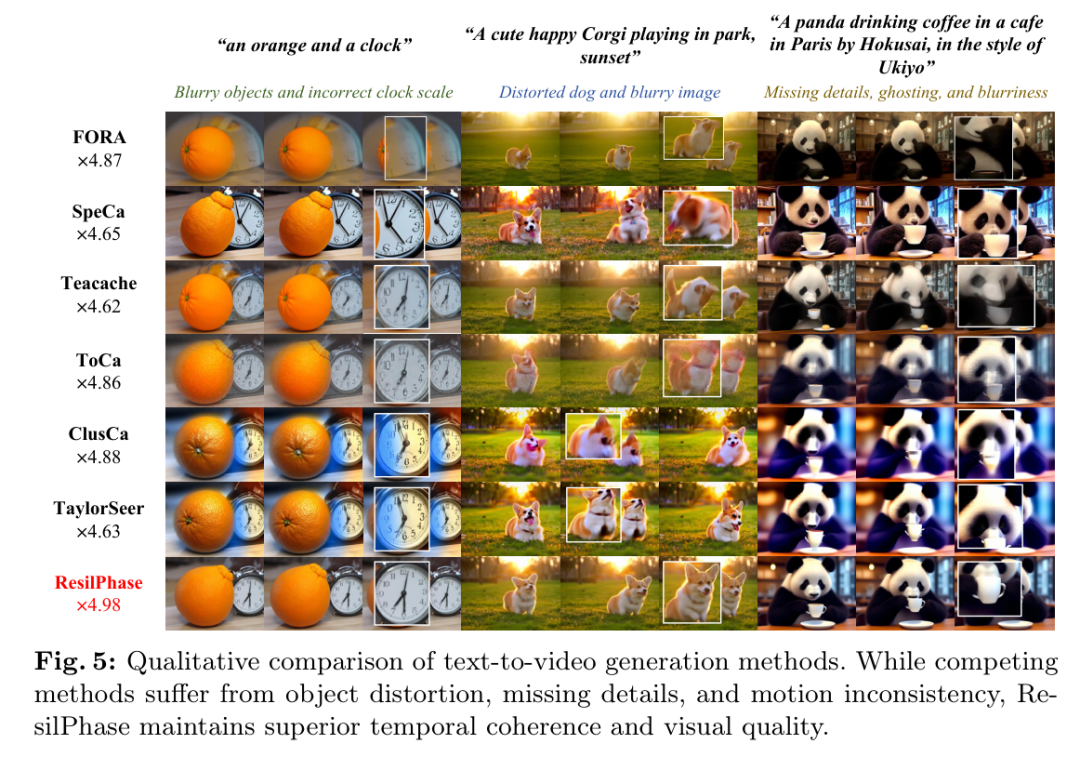
在 HunyuanVideo 的文生视频任务中,ResilPhase 同样展现出了统治级的画质保持能力。在4.98倍 加速下,其 VBench 得分高达79.78,PSNR 达到18.920,在运动一致性和细节保留上显著超越了 TeaCache 和 ToCa 等强劲基线。
3. 极低的显存开销与强大的即插即用性
得益于Global Drift 的宏观设计,ResilPhase 避开了对逐层特征的缓存。实验表明,传统方案(如 TaylorSeer、HiCache)在运行 FLUX.1-dev 时会带来额外的+7.35 GB 显存开销,而 ResilPhase 仅增加了+0.27 GB,几乎是零开销,这让消费级显卡部署 5 倍加速的 FLUX 变为了现实。
值得一提的是,Phase Mapping 具有极强的普适性。将其作为即插即用的稳定器直接嵌入现有的 TaylorSeer 或 HiCache 中,能让这些原本在高倍率下崩溃的算法,其 ImageReward 和 LPIPS 指标得到立竿见影的巨大提升。
写在最后
ResilPhase 是经典数值分析理论与现代深度学习推理优化的结合,回归到数学模型的探讨,用拉格朗日插值和切比雪夫节点这样经典的工具,同样能优雅地解开“高加速比下画质崩溃”的死结。
目前该项目已在 GitHub 开源,如果想要在本地体验 5 倍加速且近乎不占额外显存的 FLUX.1,不妨先去给作者点个 Star 再体验一下。
