


来源:华科大认知计算与智能信息处理
原文链接:https://mp.weixin.qq.com/s/6UFoqi4no67hk1uHomaPmg
近日,计算机视觉领域的顶级国际会议ACM MM 2026论文录用结果揭晓,华中科技大学认知计算与智能信息处理实验室共有3篇论文被录用The 34th ACM International Conference on Multimedia (ACM MM 2026)是计算机视觉领域的顶级国际会议,是中国计算机学会CCF推荐的A类国际学术会议。ACM MM 2026计划于2026年11月10日至14日在巴西里约热内卢市召开。这次ACM MM 2026 共有7,053篇投稿。
论文介绍
01
1.标题:不只看注意力分数:RankKV将KV压缩转化为“选出互补Token”的数学问题,1%极限压缩率下性能提升9.2%!
论文标题:Rank-Preserving KV Cache Compression for Large Vision-Language Models (Main Track)
论文作者:Chuming Shen(25级博), Wei Wei*(导师), Kaihe Xu, Yuanyuan Fu
论文概述:随着大视觉语言模型(LVLM)在高分辨率图像、长视频及超长多模态上下文处理上的不断突破,推理阶段急剧膨胀的键值(KV)缓存正成为制约显存开销、批处理规模和推理效率的“隐形天花板”。 现有的KV缓存压缩方法多采用注意力分数进行逐Token的贪心Top-k保留策略,但由于视觉Token具有显著的空间连续性和语义相似性,这类策略容易反复保留同质区域,导致保留表示的有效秩下降,进而丢失角落文字、稀有物体及跨帧变化等关键的长尾信息。
针对这一痛点,CCIIP团队提出了全新的RankKV,在完全不改变原始物理Token、完美兼容RoPE位置编码与高效注意力算子的前提下,RankKV致力于选择少量彼此互补的Token,以最大化覆盖原始特征子空间。具体而言,RankKV采用了“粗筛选+精去冗”两阶段策略:(1)结合观测窗口内任务相关注意力与基于CountSketch随机投影的子空间投影敏感度,从长上下文中高效筛出候选Token;(2)随后利用带主元QR分解剔除候选集中冗余,保留线性独立性更强的信息。更进一步,RankKV能够不同注意力头的内在信息容量动态分配缓存预算,让有限的显存优先服务于信息密度更高的注意力头,实现由“保留高分Token”的局部判断转向“选择共同表示全局特征空间Token”的结构化选择。
实验覆盖6种主流大视觉语言模型和7类多模态基准任务,包括文档与图表理解、多模态长上下文推理以及视频理解等典型场景。在极其严苛的 64-token 缓存预算条件下,RankKV相较对比方法最高提升了9.2个百分点;在MMBench-Video仅1%缓存极限保留率下,其总分达1.71,并在感知、推理两大能力维度均取得最佳表现。进一步表明,即使压缩99%的KV缓存,RankKV在面向特征子空间的非冗余Token选择上依然能够有效保留视频时空信息和细粒度多模态语义信息,为视觉语言大模型的高效推理提供了新的解决思路。
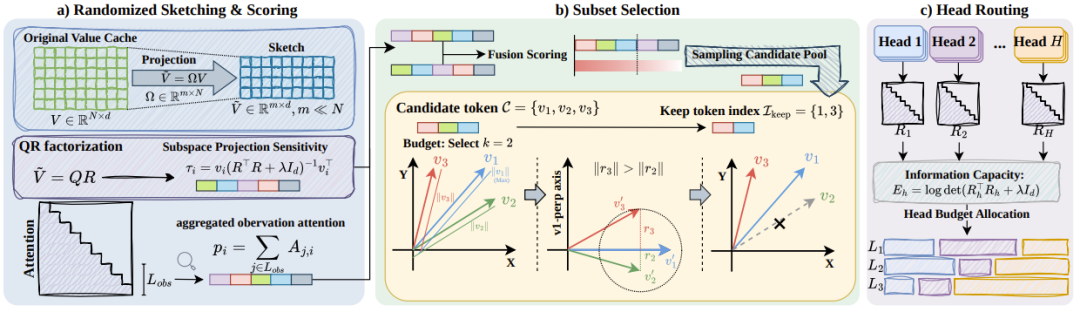
图1:RankKV框架图
该研究突破了传统基于注意力分数的局部筛选范式,将KV缓存压缩提升到全局特征子空间优化层面,为大模型在长上下文、多模态和视频场景下的高效部署提供了新的理论基础和技术路径,也为下一代高效视觉语言模型的发展提供了重要支撑。
02
2.标题:破解MLLM“细看”难题:RumiA让多模态大模型真正“看清”细节
论文标题:Ruminative Contrastive Attention Calibration for Training-Free Fine-Grained Visual Reasoning in MLLMs (Main Track)
论文作者:Chuming Shen#(25级博), Sichen Liu#, Wei Wei*(导师), Xiaoye Qu
论文概述:多模态大语言模型(MLLM)已在通用视觉问答等任务中展现出强大能力,但面对文档阅读、图表理解、细粒目标识别以及复杂多区域关系推理时,仍容易遗漏关键信息,影响推理准确性。现有的“多轮推理+感兴趣区域裁剪”思路不仅计算代价高昂,且固定形状的单一裁剪范式难以同时兼顾分散于图像不同位置、形态各异的关键线索。
针对这一痛点,CCIIP团队提出 Ruminative Contrastive Attention Calibration(RumiA)——一种无需重训练的推理阶段细粒度视觉增强轻量化方法,研究首次将视觉注意力受背景噪声干扰导致关键信息被淹没的现象定义为“注意力稀释”问题,并将任务相关语义焦点的提取建模为变分推断问题,基于这一理论推导出视觉token的层间注意力对比可近似条件点互信息。形象地说,浅层注意力提供通用视觉先验,深层注意力则聚焦任务相关区域,二者的对数差能有效抑制背景噪声,突出真正与问题相关的多个区域,实现对模型视觉关注的“语义锐化”。 在此基础上,RumiA 利用小型 MLLM 生成稳定的对比注意力图并转化为软校准系数,对大型目标模型的视觉 Token KV 缓存进行重加权。这一机制实现了由小模型引导大模型的“弱到强推理”,全程无需多轮裁剪,也无需昂贵微调。
实验在三个主流MLLM系列、十项细粒度视觉理解与复杂推理基准上开展。在Qwen2-VL-7B模型上,RumiA在TextVQA和ChartQA上分别较原模型提升4.07%和10.48%;仅利用2B小模型辅助7B目标模型,即可在InfoVQA上取得接近双7B两阶段推理的性能,同时相比现有方法ViCrop降低约64%的计算开销。
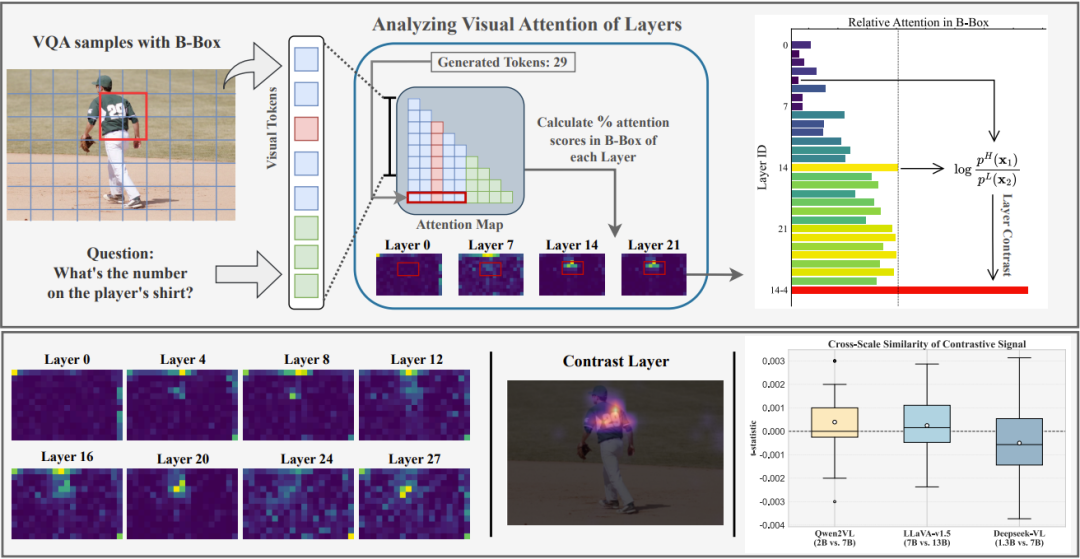
图2. RumiA框架图
研究表明,RumiA突破了传统依赖区域裁剪增强视觉推理的思路,通过层间对比驱动的软注意力校准,在无需重新训练模型的前提下,实现了细粒度感知能力、复杂推理精度与推理效率的协同提升,为多模态大语言模型在智能文档分析、图表理解、教育问答及智能办公等场景中的高效部署提供了新的技术路径。
03
3.标题:破解MLLM“细看”难题:RumiA让多模态大模型真正“看清”细节
论文标题:Mitigating Hallucinations in Large Multimodal Reasoning Models by Regulating Parametric Prior Drift (Main Track)
论文作者:Xiaoye Qu# (24级博), Yanzhe Wu#, Zhihao Xie, Daizong Liu, Wei Wei*(导师)
论文概述:大视觉语言推理模型(LMRMs)凭借长链思维(Long CoT)攻克复杂推理任务,却也陷入一个矛盾困境:推理链条越长,多模态幻觉越严重——模型会“脑补”出并不存在的视觉细节。现有的缓解策略(如对比解码或注意力调整)往往治标不治本,难以从模型内部机制上解决长推理过程中隐藏状态逐渐偏离原始视觉信息的根源。
针对这一挑战,CCIIP团队从模型内部状态演化的角度重新分析多模态幻觉形成机制,发现了一种由参数化先验(Parametric Prior)驱动的“视觉漂移(Visual Drift)”现象:随着推理不断深入,隐藏状态逐渐减少对图像信息的依赖,而更多受到 FFN(Feed-Forward Network)中存储的语言知识影响。其中,FFN残差更新是导致视觉信息逐步“脱锚”的关键因素,而注意力残差通常具有恢复视觉信息的作用。这一发现揭示了多模态幻觉产生的重要内在原因,为提升模型推理可靠性提供了新的理论视角。基于上述发现,团队提出无需额外训练的推理阶段控制方法——Adaptive Fine-grained Residual Gating(AFRG),用于动态抑制有害的 FFN 更新。该方法通过比较 FFN 更新前后的隐藏状态与相关视觉 token 的一致性,动态衡量模型视觉偏移程度,并依据推理阶段自适应调节残差门控强度,仅抑制会削弱视觉一致性的参数更新,同时保留复杂推理所需的有效信息,实现对模型内部状态演化的精细化控制。
实验覆盖Qwen3-VL、InternVL3.5等主流模型,以及MMHal、CHAIR、HallusionBench、MME等多模态幻觉基准和MMBench、MMStar、MMVP等通用多模态任务。结果表明,AFRG能够在保持甚至提升模型整体性能的同时显著降低多模态幻觉,如在Qwen3-VL-4B-Thinking模型上,MMHal幻觉率由0.34降至0.26,并同步提升MME总分,充分验证了该方法在可靠推理方面的优势。
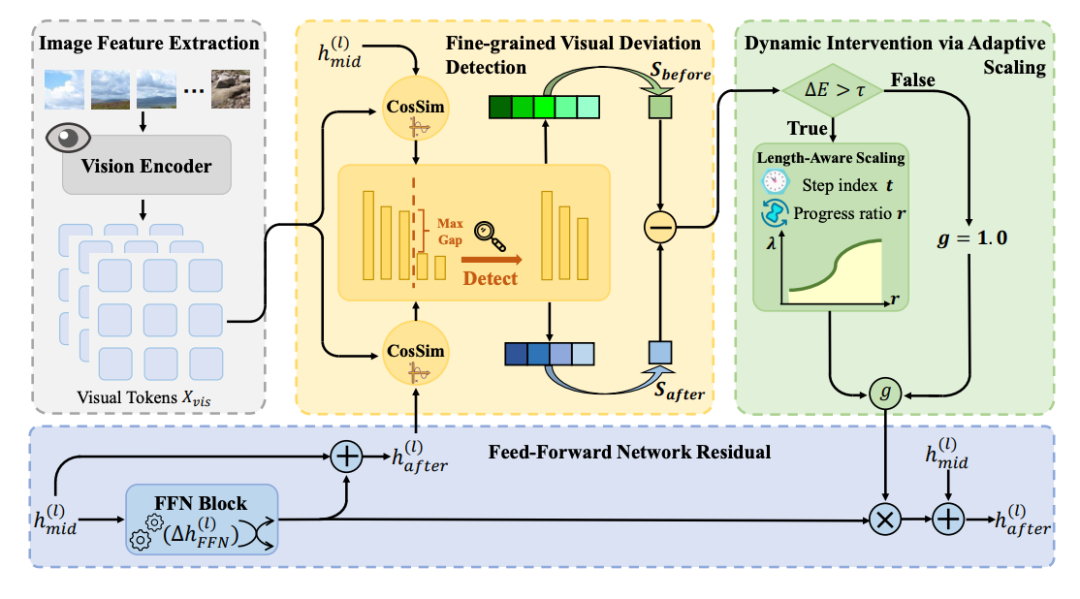
图3:AFRG框架图
该研究突破了传统多模态去幻思路,首次揭示了长链推理过程中“参数化先验逐渐取代视觉证据”的内部问题,并提出基于残差状态调控的推理控制新范式,为构建更加可信、可解释、高可靠的视觉语言推理大模型提供了新的理论基础和技术路径,也为多模态人工智能在复杂真实场景中的安全应用奠定了重要基础。
