


来源:BUPT老张
原文链接:https://mp\.weixin\.qq\.com/s/0lzNPWq7eAR\-YnEocyNjyA?scene=1
近日,团队张跃老师指导、参与的 2 篇论文被 ECCV 2026 接收。ECCV 是与 CVPR、ICCV 并称的计算机视觉三大会议,将于 2026 年 9 月 在瑞典马尔默举办。
论文一(S-GRACE)聚焦文生图大模型编辑:让 AI 精准彻底地"忘记"不该画的敏感概念,仅用 32 个样本就把消除性能提升了超 26%;论文二(RED-Aes)重新思考图像美学评估:不再给照片打"绝对分",而是教 AI 在"比较"中理解美,零样本刷新 5 大公开基准。
论文1:S-GRACE:语义引导的鲁棒对抗概念消除,把「概念消除」从"删不干净"做到"精准彻底"。
你让一个文生图模型"从此不许再画苹果",它真的会照做吗?
大概率不会。你只是删掉了"红苹果"——换句 prompt 说"来一个青苹果",它照样画得出来。这不是玩笑,而是「概念消除」领域最棘手的难题。
为了让大模型守住安全底线,研究者们发展出一个专门方向:概念消除(Concept Erasure)——把 NSFW 内容、受保护的艺术家风格、商标物体等"不该生成的东西",从模型参数里"抹掉"。听起来直接,做起来却难:抹除之后,攻击者只要换个措辞、换种外观,被删掉的内容就"复活"了。
为什么删不干净?我们在论文里找到了病根:既有的对抗式消除方法,靠随机采样构造对抗样本来逼近目标概念,但随机样本只覆盖了概念语义空间的一小片角落。就像想从记忆里抹去"苹果",却只删掉了"红苹果","青苹果"依然完好。
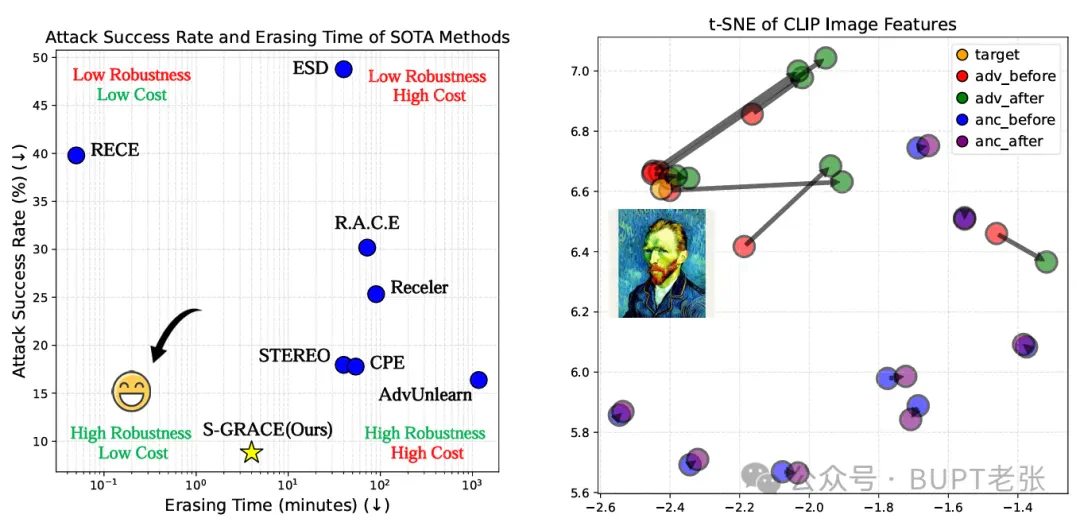
S-GRACE(Semantic-Guided Robust Adversarial Concept Erasure,语义引导的鲁棒对抗概念消除)的思路,就一句话:先摸清概念的全部"长相",再定点清除。
第一步,让大语言模型当"侦察兵"。LLM 天生通晓概念的方方面面,让它系统梳理目标概念的全部语义关联词——颜色、形态、场景、相近风格……把"苹果"拆成红苹果、青苹果、苹果树、苹果派。这一步,把"模糊的概念"变成"一份完整清单"。
第二步,以语义关联词为锚点构建样本空间,引导对抗样本生成。传统方法靠"随机瞎猜"逼近概念空间,S-GRACE 用语义引导,仅需单个样本就能生成更贴近目标概念空间的对抗嵌入——删除精准、彻底,而且不会误伤无关概念(删"苹果"不会殃及"水果"之外的物体)。
效果怎么样?更彻底、更快、更省。
消除鲁棒性提升超 26%;
训练时间压缩 90%;
所需样本从数千个骤降到仅 32 个。
在 NSFW 内容、艺术风格、物体概念三类场景上全面验证,S-GRACE 达到当前最优的消除鲁棒性,同时保持图像生成质量几乎不受影响——"删得干净"与"画得好",不再是单选题。
安全不是给模型贴膏药,而是让它真正理解边界。S-GRACE 给我们的启示是:与其和概念"硬碰硬",不如先和它"对话"——当 AI 真正明白"苹果"是什么,它才真正懂得如何忘掉"苹果"。
论文题目:Rethinking Robust Adversarial Concept Erasure in Diffusion Models(S-GRACE)
作者:Qinghong Yin, Yu Tian, Heming Yang, Xiang Chen, Xianlin Zhang, Yue Ming, Xueming Li, Yue Zhang
链接:arXiv:2510.27285 | 代码开源
论文2:RED-Aes:不再让 AI 给照片打绝对分数,而是教它学会「比较」与「因果推理」。
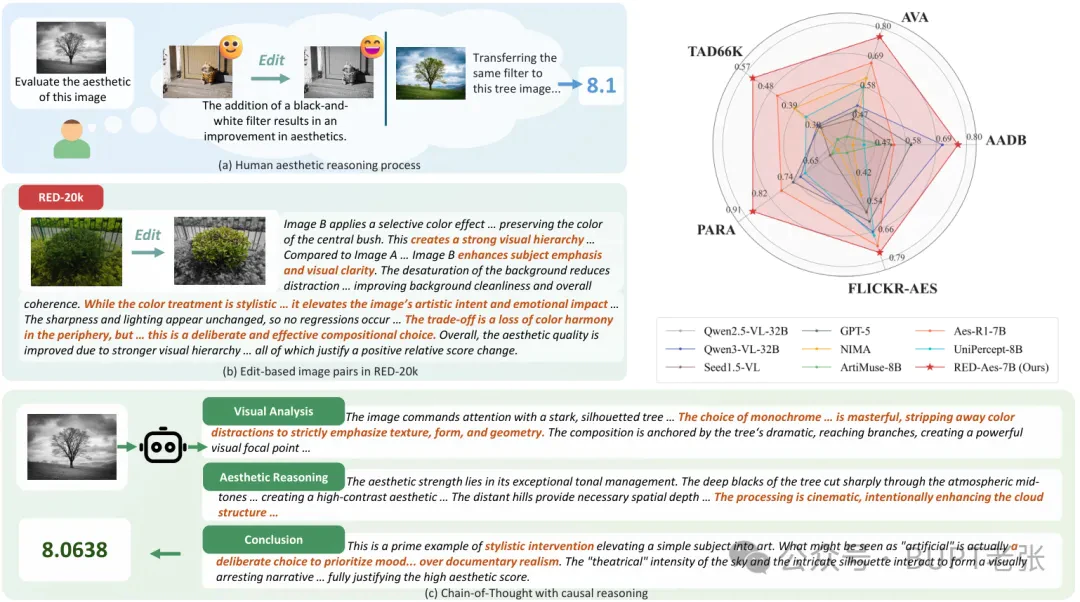
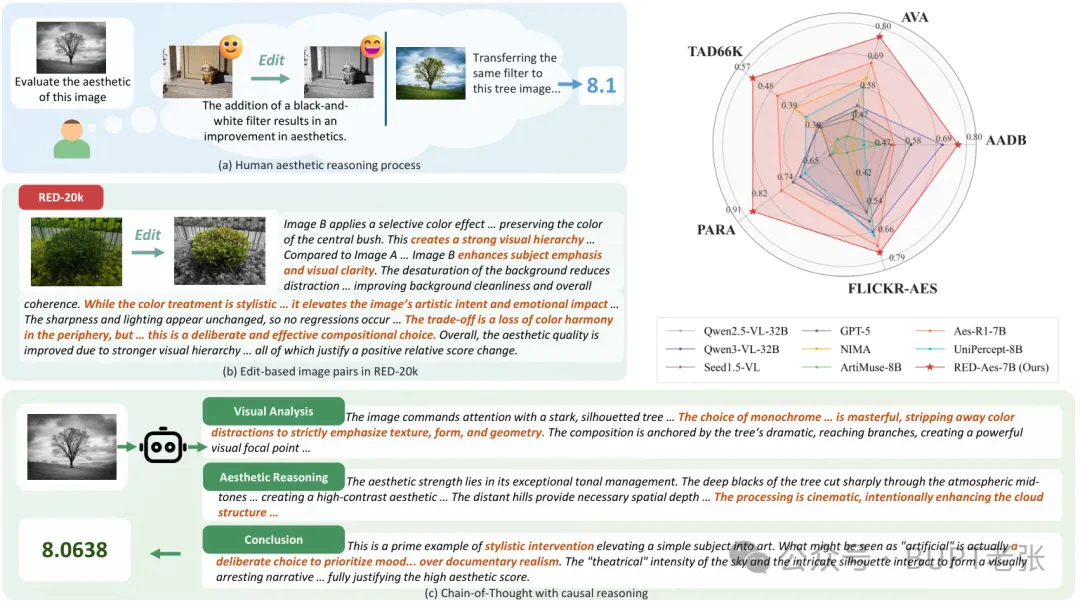
你有没有过这样的经历:给朋友发照片,对方几乎从不说"这张 7.8 分",而是——
这其实是人类审美最真实的模样:我们很少孤立打分,而是在比较中形成判断。可如今几乎所有 AI 美学评估(IAA)模型,都在干一件反人类的事:让模型回归一个绝对的平均意见分数(MOS)。模型记住了"什么样的图通常分高",却没学会"什么样的变化让图变美"——一旦遇到没见过的场景就露馅:一张严重模糊的小狗照片,GPT-5 竟打了 8.22 分(真实只有 1.72)。模型被"内容"骗了,而不是在"审美"。
怎么让 AI 学会比较?答案是:利用可控图像编辑模型。 加滤镜、提饱和度、调构图——这些操作与审美变化之间存在清晰的因果关系。我们据此搭建全自动数据流水线:从摄影网站收集 50 万张图片,用 5 个编辑模型生成"原图-编辑图"配对,再由 3 个大模型独立评估每对图片的美学差异,要求三人一致才保留,并用思维链(CoT)写出推理过程。最终得到 RED-20k:2 万组带定量差异评分、带因果推理文本的编辑图像对——业内首个这样的资源,全程无需人工标注。
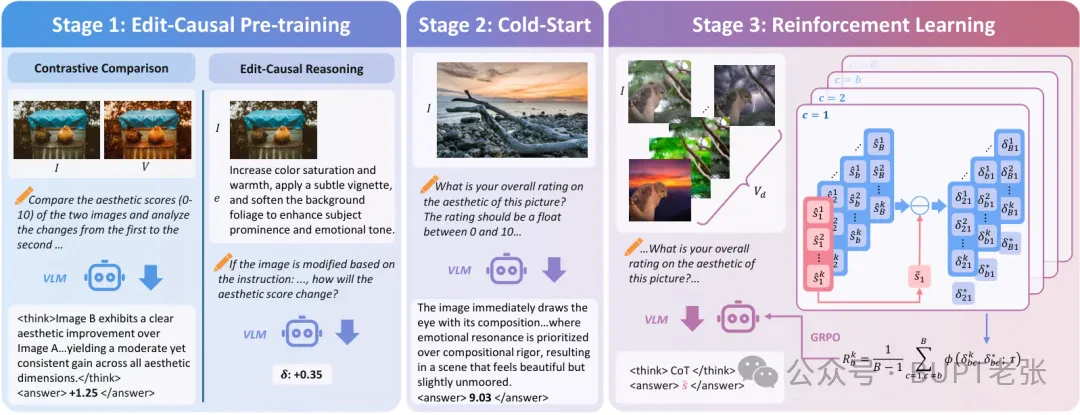
有了数据,我们设计了"从对比到推理"的三阶段训练。 第一步,编辑因果预训练:让模型看"原图+编辑图"学会对比(PT-O1),再进阶到只看编辑指令、预测审美变化(PT-O2),把"修改→美学变化"的因果链内化;第二步,只用 200 个样本冷启动校准,学会输出绝对分数;第三步,用 GRPO 加上我们提出的相对排序一致性奖励,让模型在同一组"1 张原图+7 张编辑图"中保证排序正确——全程只用相对监督,不碰绝对分数。
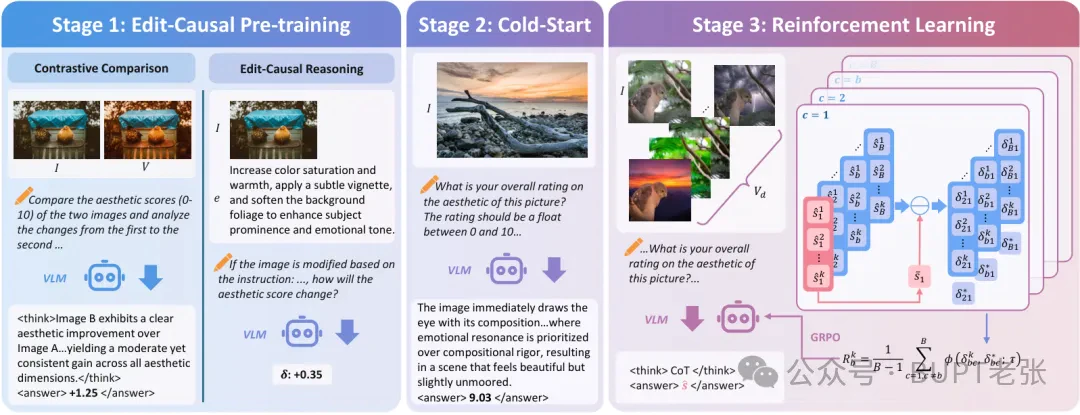
结果:零样本打遍 5 大基准。 在 TAD66K、AVA、FLICKR-AES、PARA、AADB 五大基准的零样本设置下,平均 PLCC 达 0.7442、SRCC 0.7322,全面超越所有基线——包括在目标域数据上训过的专用模型 Aes-R1,以及 GPT-5 这样的通用大模型。最轻量的 2B 版本同样超越所有基线,这对端侧部署意义重大。
我们始终相信:审美不是一道孤立的单选题,而是一连串有因果的判断题。 让 AI 真正"懂美",我们迈出了第一步。
论文题目:Beyond Absolute Scores: Relative Edit-induced Difference for Generalizable Image Aesthetic Assessment(RED-Aes)
作者:Qifei Jia, Xintong Yao, Yasen Zhang, Minghao Li, Yajie Chai, Qiming Lu, Baoyue Shen, Runyu Shi, Ying Huang, Yue Zhang
链接:arXiv:2606.05778
关于我们
北邮智能计算实验室由「李学明教授」创建,主要成员包括张跃、柳杨、李荣锋、张宪林、符强等,长期聚焦人工智能技术研究。
欢迎项目合作,欢迎学生加入!
邮箱: zhangyuereal@bupt.edu.cn
原文链接: https://www.leiphone.com/category/private/kd1zNWwny9MgSobF.html
