


来源:我爱计算机视觉
原文链接:https://mp\.weixin\.qq\.com/s/2pGGqmJAUvmP\_nflnXBh3g
背景与动机:医疗推理一定要“把思考过程说出来”吗?
经验丰富的医生在看到医学影像时,往往不会先生成一段冗长的逐步推理,再得到诊断结论。更多时候,他们会迅速调用长期积累的解剖知识、病灶模式和病例经验,在极短时间内完成感知匹配与诊断记忆激活。
然而,当前医疗视觉语言模型主要依赖两类范式:
1. SFT、RAG 与提示注入依赖离散文本载体:医学知识被压缩成固定词表中的 token,难以完整表达病灶密度渐变、组织纹理异质性和空间拓扑关系等连续视觉特征;当上下文变长时,早期视觉证据还会逐步衰减。
2. 强化学习增强的显式 CoT 容易产生“幻觉级联”:模型一旦在推理链前部虚构了错误征象,后续逻辑可能在错误前提上不断自洽,最终形成篇幅很长、语言流畅但诊断错误的回答。
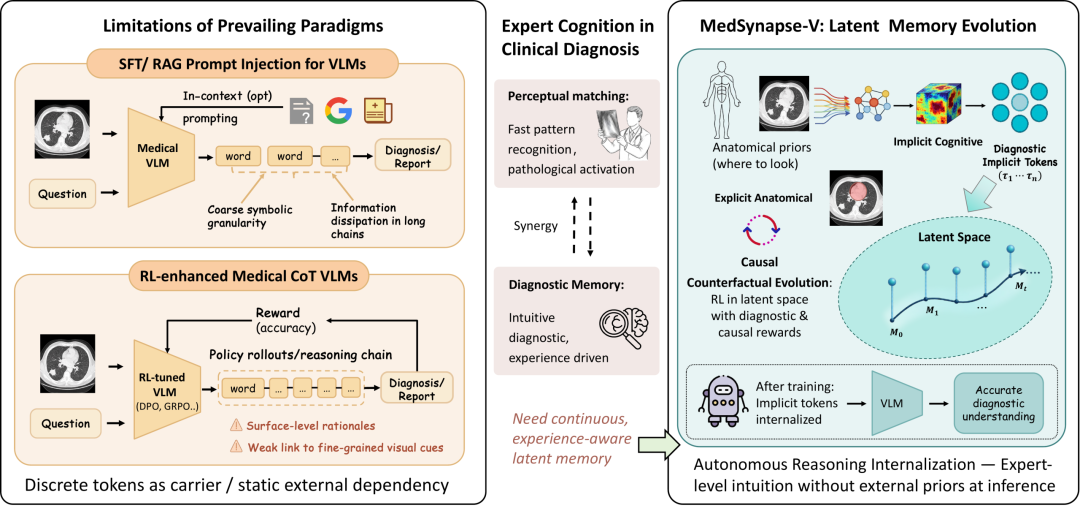
论文由此提出一个关键问题:能否让医疗 VLM 在隐空间中形成病例自适应的“诊断记忆”,像临床专家一样快速调用视觉经验,同时保证这些记忆真正与病灶区域和诊断决策存在因果联系?
核心思路:让诊断记忆经历“提取—校准—内化”
MedSynapse-V 将诊断推理从显式文字链转移到连续隐空间中。模型不再依赖数百个 CoT token 展开推理,而是生成一组紧凑的诊断隐式 token,让它们参与 VLM 的 self-attention,并在答案生成过程中提供视觉诊断线索。
整个训练流程分为三个阶段:
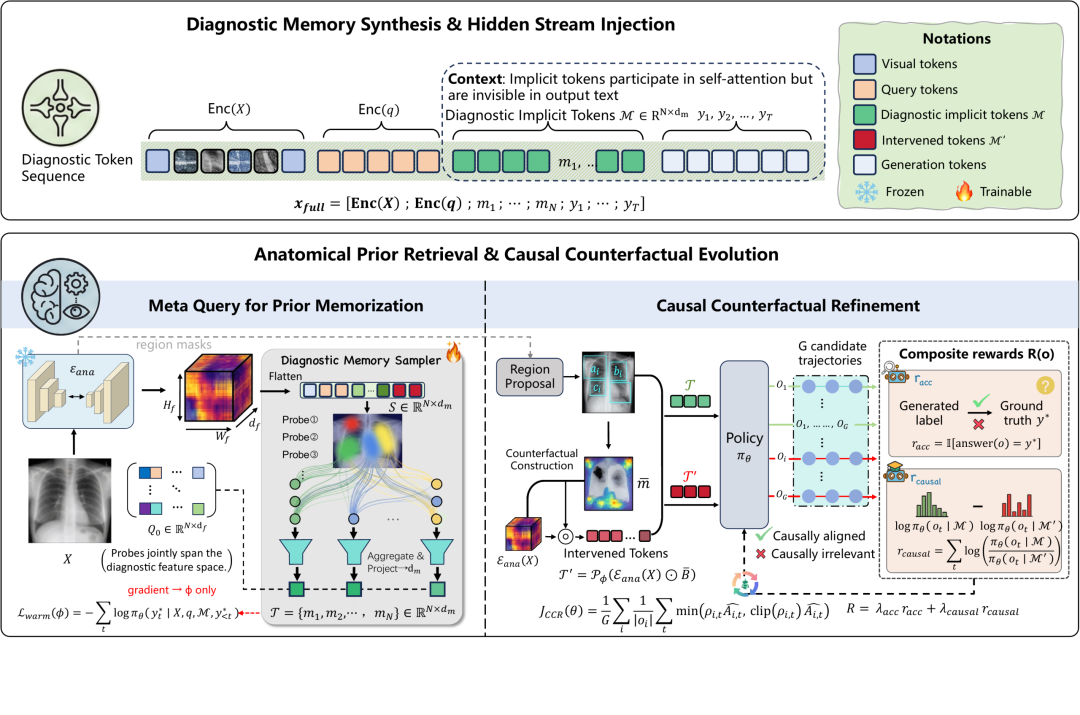
这些隐式 token 被插入在问题编码之后、答案 token 之前:
其中, ... 是连续向量,不对应 tokenizer 中的词表 ID,因此不会被解码为自然语言。它们只作为 self-attention 中可被答案 token 读取的隐式上下文,直接改变后续 token 的概率分布。
阶段一:MQPM——从解剖先验中“唤醒”诊断记忆
Meta-Query Probes 如何提取信息?
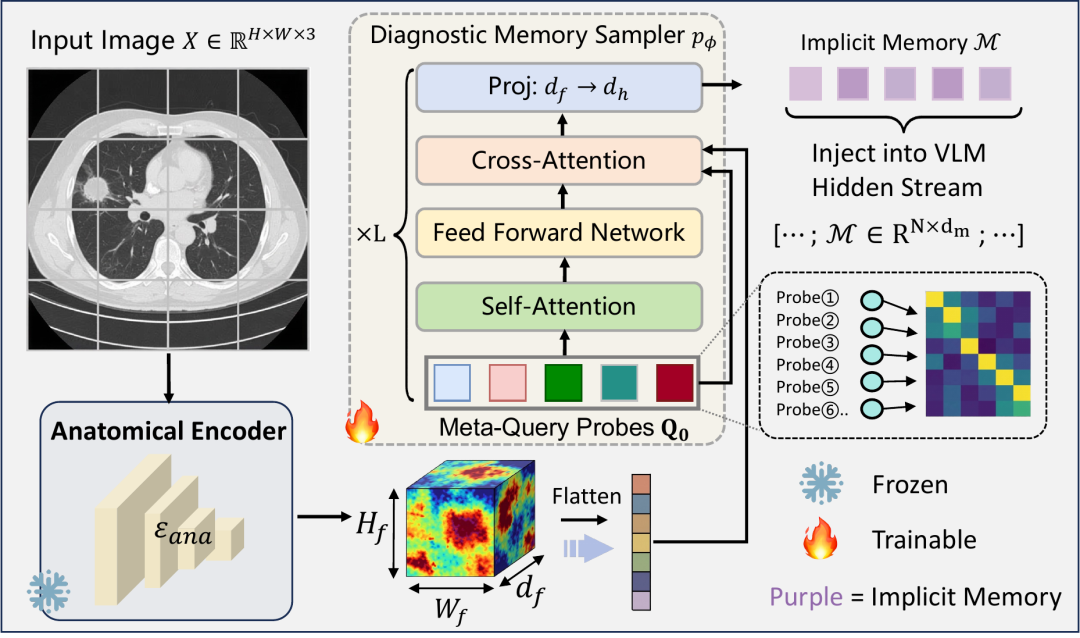
给定医学图像 ,冻结的解剖编码器 MedSAM3 首先输出具有空间结构的特征图,其中包含器官拓扑、病灶边界和组织纹理等信息。随后,Diagnostic Memory Sampler 使用 个可学习的 Meta-Query Probes 对这些特征进行交叉注意力聚合:
不同 Probe 会学习关注不同的诊断语义,例如边界不规则、密度异质性或血管—组织空间关系。最终,多条记忆向量共同覆盖当前病例所需的诊断特征子空间。
为什么需要 Warmup?
Diagnostic Memory Sampler 初始是随机参数,它输出的向量与 VLM 原有语义空间并不匹配。若直接进入强化学习,随机记忆会扰乱答案生成,使奖励信号极不稳定。
因此,Stage I 冻结 VLM 和解剖编码器,仅训练 ,使用 next-token prediction loss 完成语义对齐。实验也表明,跳过 MQPM Warmup 后,平均性能仅为 52.9%,甚至低于零样本 Qwen3-VL-8B 的 54.2%。
阶段二:CCR——用因果反事实奖励筛掉“伪记忆”
经过 Warmup 后,隐式记忆已经能表达基本医学语义,但模型仍可能绕过这些记忆,直接从图像和问题中寻找数据捷径。此时即使答案正确,也无法证明记忆真正参与了诊断。
CCR 使用 GRPO 对 VLM 的 LoRA 参数进行优化。每个样本采样 条候选轨迹,并使用两部分奖励:
具体而言,MedSAM3 提供高置信度病灶区域 mask。模型将关键区域特征置零,构造干预后的记忆 ,再比较同一输出轨迹在 与 条件下的概率:
若遮挡关键区域后输出概率显著下降,说明原始记忆确实编码了对诊断有因果贡献的信息;若前后几乎不变,则说明该记忆可能只是冗余表示,模型也可能仍在走捷径。
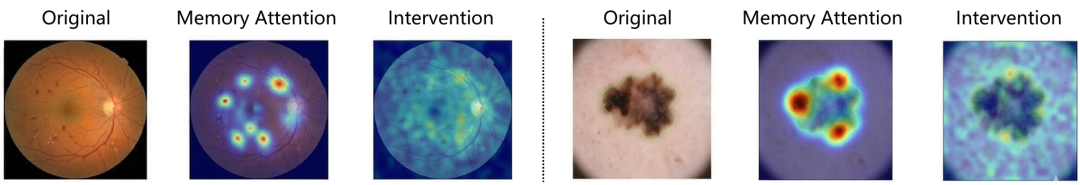
这一奖励的意义在于:它不只问模型“答对了吗”,还进一步追问——模型是否因为看到了正确的医学证据而答对?
阶段三:IMT——把外部诊断经验写回模型自身
经过 CCR 后,模型在解剖编码器提供的高质量记忆条件下已经具备较强诊断能力,但若推理阶段一直保留 MedSAM3,会增加延迟和显存占用。
IMT 构建了两条共享 VLM Backbone 的分支:
学生分支先进行 on-policy 采样,再在每个生成位置上,对教师与学生的完整词表概率分布计算 Jensen–Shannon Divergence。训练过程中只更新 ,教师分支保持冻结。
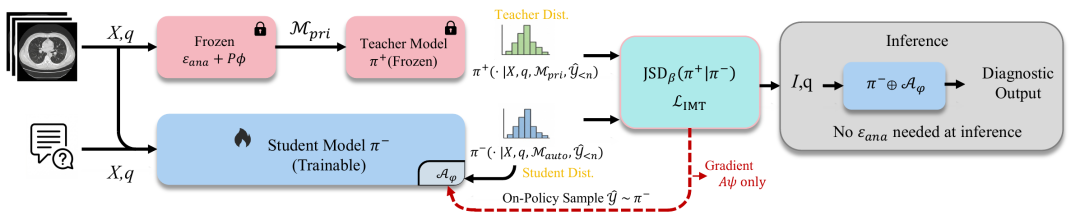
相比只对最终答案或少量 token 进行模仿,全词表分布包含了教师对所有候选诊断表达的相对偏好,因此能够把更完整的诊断行为写入学生的隐式记忆模块。
实验设置:七个基准、八种医学影像模态
论文在七个医疗多模态基准上进行评测,包括:
训练采用渐进式数据配置:
覆盖 CT、MRI、X-ray、皮肤镜、眼底、OCT、病理和超声等八种模态。
主结果:不生成长 CoT,准确率仍超过所有基线
在七个基准的平均结果上:
推理阶段不使用 MedSAM3 的 IMT 版本,仍比最强 RL-CoT 基线 MMedExpert-R1 高 3.9pp。在高度依赖视觉定位的 VQA-RAD、SLAKE 和 PathVQA 上,分别领先 9.0pp、7.0pp 和 6.7pp。
更重要的是,MedSynapse-V 不需要生成数百个显式推理 token。16 个连续记忆向量在一次前向过程中即可为答案提供诊断依据。
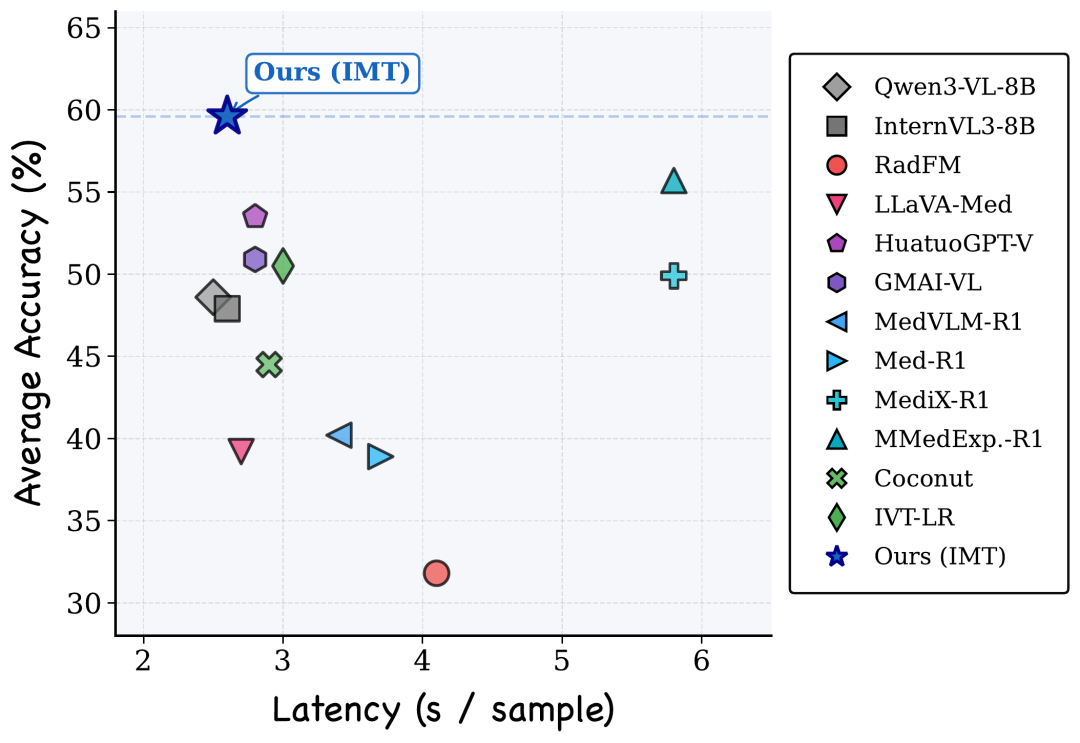
论文还比较了保留与移除解剖编码器的性能:IMT 仅损失约 1.8pp 的七基准平均得分,同时显著降低额外计算开销。在五项核心消融指标上,移除编码器使延迟从 168 ms/token 降至 102 ms/token,峰值显存从 22.8 GB 降至 16.5 GB。
案例分析:长推理不等于可靠推理
CT、MRI 与超声案例
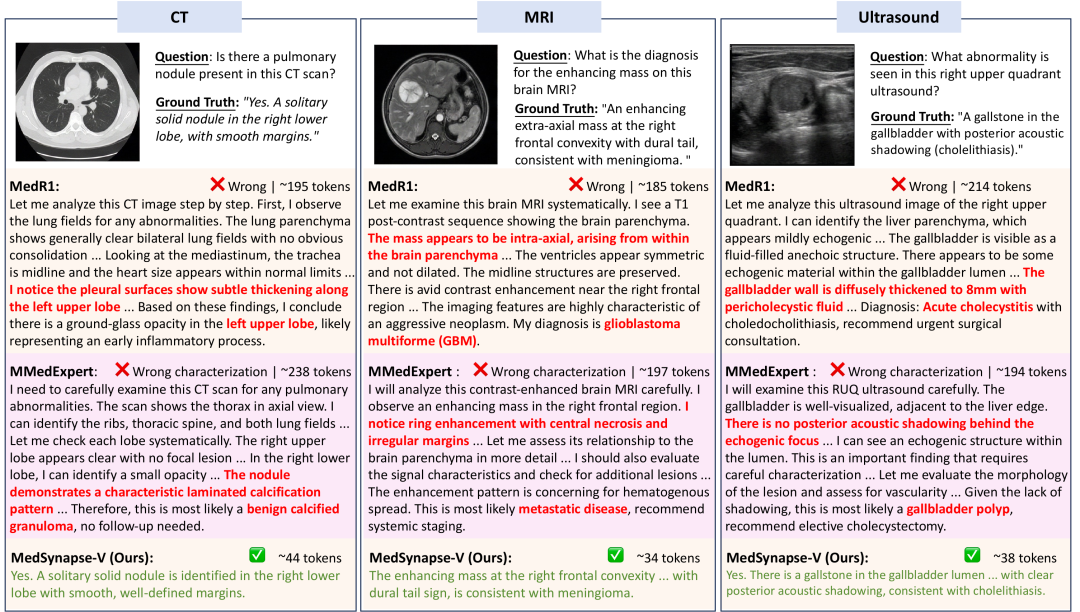
在肺结节 CT 案例中,Med-R1 虚构了左上肺胸膜增厚,MMedExpert-R1 则将右下肺结节错误描述为具有层状钙化的良性肉芽肿;MedSynapse-V 直接识别出右下肺孤立性实性结节。
在脑 MRI 案例中,两种 CoT 模型分别将脑膜瘤误判为胶质母细胞瘤和转移瘤,其错误均来自推理链前部虚构的“脑内生长”“环形强化”和“中央坏死”等征象。
X-ray、病理与头颅 CT 案例
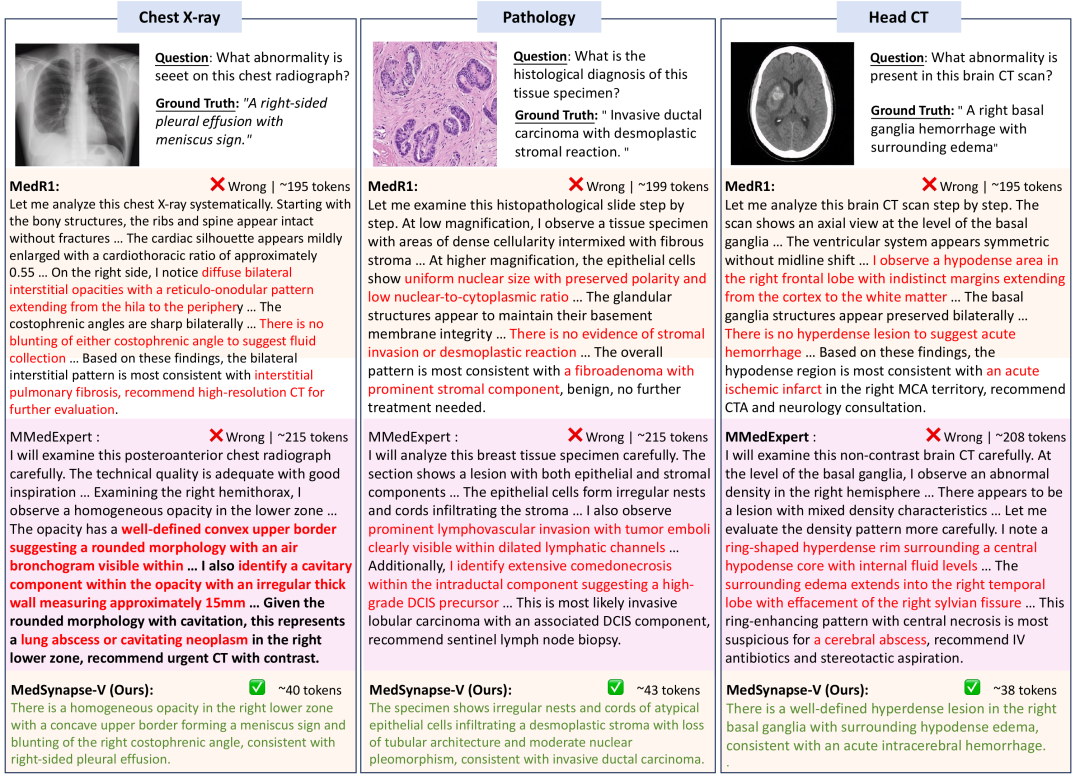
这些案例揭示了显式 CoT 的一个核心风险:文字链可以让错误变得更完整,却无法自动让错误变得更少。 MedSynapse-V 将关键诊断过程压缩到隐空间,有效减少了错误观察在长文本链中的传播。
为什么有效:因果奖励让隐空间形成“诊断流形”
诊断 Probe 数量并非越多越好
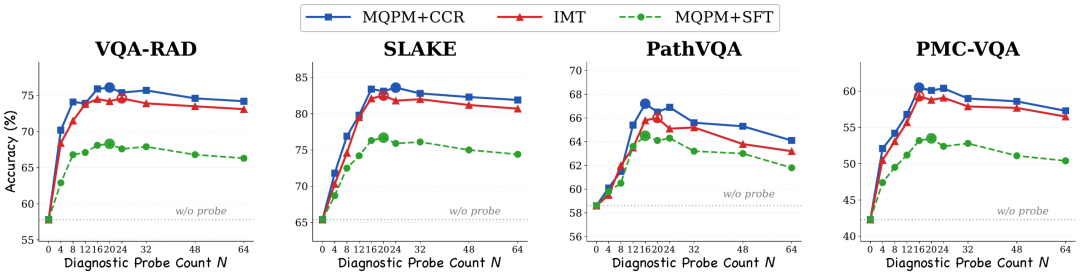
当 太小时,隐式记忆容量不足,难以覆盖多种病灶语义;当 过大时,模型更容易绕过记忆或把无关信息写入记忆池。实验最终采用 16 个 Probe,在表达能力和冗余之间取得平衡。
改变了强化学习动态
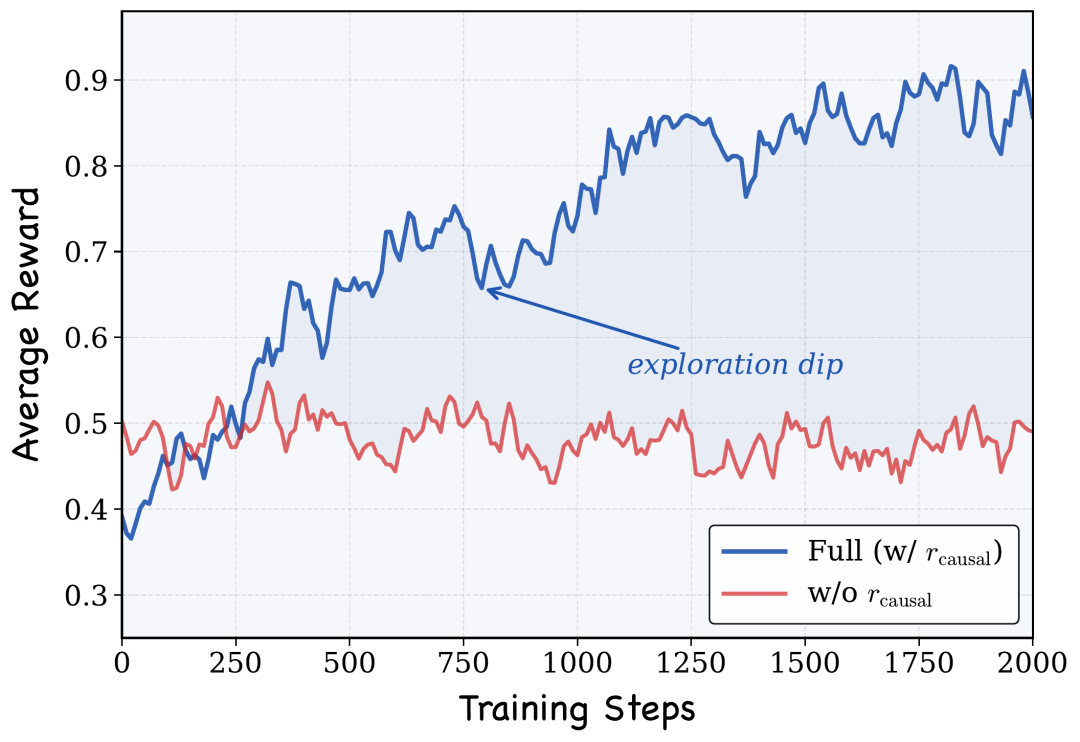
仅使用答案正确性奖励时,模型可能继续依赖图像—答案之间的捷径,隐式记忆逐渐退化成“无效填充”。加入 后,策略需要主动探索如何利用病灶相关记忆,因此在训练中出现短暂回落,随后达到更高奖励。
消融结果显示,加入因果奖励使五项核心基准平均性能从 63.6% 提升至 67.7%,贡献达到 +4.1pp。
隐式记忆形成有医学语义的层次结构
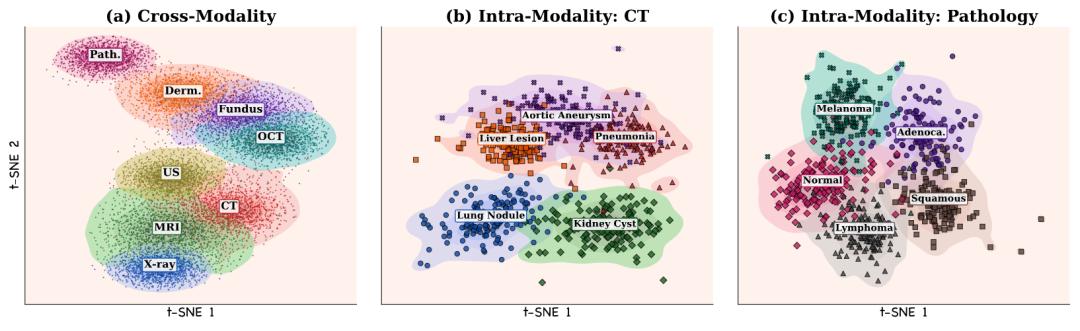
在跨模态层面,CT 与 MRI 等临床相关模态彼此邻近;在同一模态内部,肺结节、肝脏病变、肾囊肿、肺炎和主动脉瘤等疾病形成独立区域。病理模态中的腺癌、鳞癌、淋巴瘤和黑色素瘤同样能够分离。
这说明 的作用不只是提高最终准确率,还真正将连续隐空间重塑为具有临床意义的诊断表征流形。
消融实验:三个阶段分别解决不同问题
完整流程 在五项核心基准上的平均得分为 67.7%。关键消融结论如下:
三个阶段形成了清晰分工:MQPM 负责语义落地,CCR 负责因果校准,IMT 负责能力内化与高效推理。
局限性与未来方向
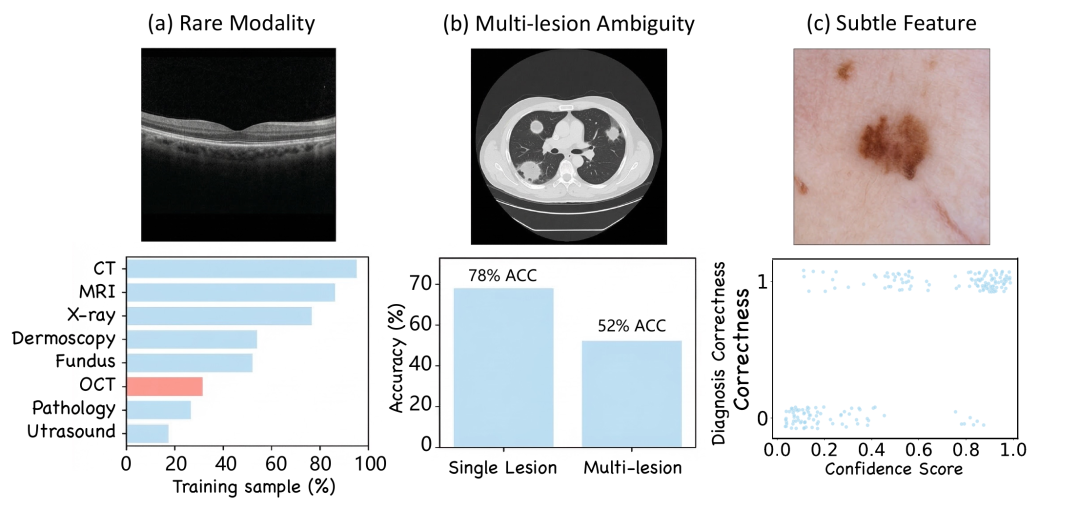
MedSynapse-V 仍存在三类明显局限:
对应的未来方向包括:更加均衡的多模态采样、根据病例复杂度动态调整记忆 token 数量,以及引入更可靠的不确定性校准机制。
写在最后:从“展示推理”走向“内化推理”
MedSynapse-V 最值得关注的地方,是它重新思考了医疗多模态推理的载体。
过去,许多方法默认推理必须表现为一段可见的自然语言链条。但临床专家的快速判断并不总能被还原为逐字展开的逻辑步骤。真正重要的能力,可能是模型能否在内部形成与解剖结构、病灶区域和诊断决策一致的连续表征。
MedSynapse-V 通过结构化先验提取、因果反事实校准和在线记忆蒸馏,将外部医学知识逐步转化为模型自身可调用的隐式诊断记忆。它证明了一个很有价值的方向:
医疗 AI 不一定需要“想得更长”,更需要“在正确的视觉证据上形成更紧凑、更可靠的内部判断”。
医疗 AI 不一定需要“想得更长”,更需要“在正确的视觉证据上形成更紧凑、更可靠的内部判断”。
对于医疗视觉推理、隐空间推理、GRPO 奖励设计以及 On-policy Distillation 研究者而言,这篇工作提供了一套结构清晰且实验完整的新范式,值得深入研读。
原文链接: https://www.leiphone.com/category/private/R28QVHJgB3KfPNMA.html
