


来源:公众号“强化学习CASIA”
原文链接:https://mp.weixin.qq.com/s/qo-2ViC3UV8GXYscXcpRwA?scene=1&click_id=7
中科院自动化所深度强化学习团队提出了一种新的面向具身基础模型长期持续学习的强化学习后训练方法——LifeLong-RFT。该方法针对现有视觉-语言-动作模型(Vision-Language-Action, VLA)在后训练阶段普遍面临的数据需求高、学习新任务后容易遗忘旧技能等问题,提出了一种无需在线环境反馈、无需预训练奖励模型的强化学习微调框架。LifeLong-RFT 通过动作块级 On-policy 强化学习与多维过程奖励机制,将离线专家示范转化为可用于策略优化的细粒度反馈,从而提升 VLA 模型在多任务学习、少样本新任务适应和持续学习中的表现。
目前,该工作“Towards Long-Lived Robots: Continual Learning of VLA Models via Reinforcement Fine-Tuning”已被机器人领域顶级会议 Robotics: Science and Systems(RSS 2026)接收。
主页:https://yuan-liu-lifelong-rft.github.io/
近年来,VLA模型通过在大规模、多样化数据上预训练,逐渐成为构建通用机器人策略的重要方向。与传统分层机器人系统不同,VLA模型能够直接将视觉观测与语言指令映射为机器人动作,在操作泛化、语言条件控制和跨任务迁移方面展现出潜力。
然而,预训练模型真正落地到具体机器人平台和下游任务时,仍然需要后训练。当前主流方式是监督微调(Supervised Fine-Tuning, SFT),即利用专家示范数据让模型模仿正确动作。SFT简单有效,但在长期运行场景下存在两个关键瓶颈:一方面,新任务适应往往需要大量示范数据;另一方面,模型在学习新任务时容易出现灾难性遗忘,导致旧任务性能下降。
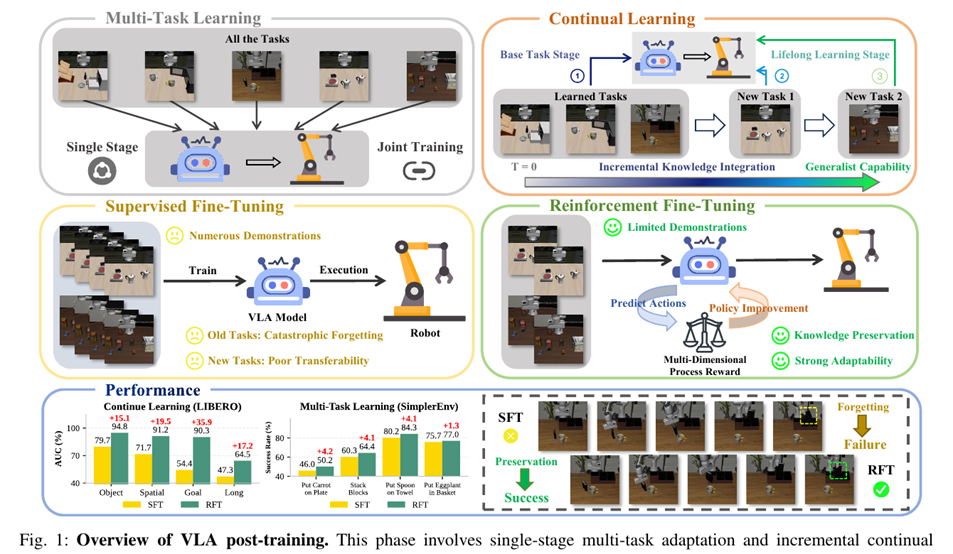
图1VLA 后训练中的多任务学习、持续学习与 SFT/RFT 对比
长期服役机器人需要具备持续成长能力:它不仅要能在有限示范下快速掌握新技能,还要尽可能保留已经学会的旧技能。这对应持续学习中的稳定性与可塑性权衡问题。若模型过度适应新数据,旧知识会被覆盖;若模型过度保持旧知识,新任务又难以学好。
大语言模型领域的近期研究表明,基于模型自身采样结果进行优化的On-policy强化学习,在持续后训练中可能比SFT 更具抗遗忘能力。这一观察自然引出一个问题:能否将On-policy强化学习引入VLA 后训练,使机器人模型在持续学习中学新不忘旧?
直接照搬现有VLA-RL方法并不容易。目前主流的强化学习微调通常依赖仿真器、真实机器人交互或世界模型提供奖励或反馈,需要完整轨迹rollout,训练成本高,奖励稀疏且不易扩展。对于大规模任务和真实机器人场景,这种依赖会显著限制方法的可用性。
为解决上述问题,LifeLong-RFT采用了一条更轻量的思路:在离线专家示范数据给定的观测和语言指令上,让当前策略模型自行采样动作块,而不是直接复制数据集中动作;随后,根据采样动作块与专家动作块之间的差异,为每个动作块计算过程奖励,并通过GRPO 进行策略优化。
整体框架
如图2所示,该框架的核心是多维过程奖励(Multi-Dimensional Process Reward, MDPR)。MDPR 并不等待机器人完成完整任务后才判断成败,而是在动作生成过程中,从离散 token、连续轨迹和输出格式三个维度评估动作块质量。
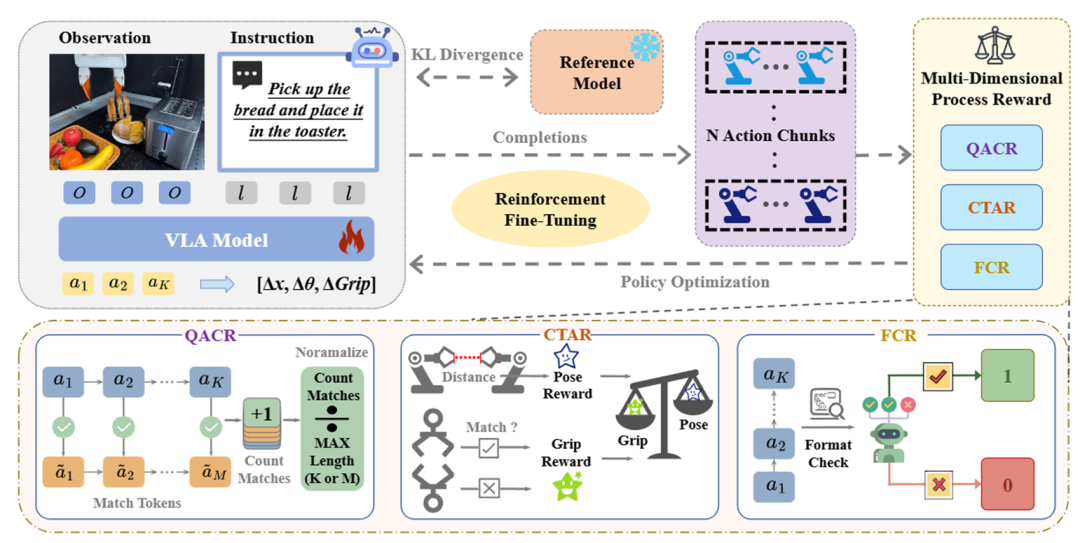
图2 Lifelong-RFT框架图
离散动作一致性奖励(QACR)
VLA模型通常基于视觉语言模型骨干生成离散动作token。QACR 通过逐位置比较预测动作token与专家动作token 的一致性,奖励更接近专家动作的输出,并惩罚动作遗漏或幻觉生成,提升离散动作空间中的预测准确性。
连续轨迹对齐奖励(CTAR)
仅在token层面对齐并不一定意味着机器人动作可以精确执行。CTAR将动作token解码为连续动作块,进一步比较末端位姿和夹爪状态与专家轨迹的偏差,为动作控制层面提供更密集的奖励信号。并且消融实验显示,去掉CTAR会导致LIBERO平均成功率大幅下降,说明连续轨迹对齐是动作可执行性的关键。
格式合规奖励(FCR)
由于生成式VLA可能输出动作维度不匹配、预测horizon不一致等无效格式,FCR用二值奖励约束输出结构,使生成结果满足动作tokenizer的解码要求,保证后续动作块能够被机器人执行。
论文在SimplerEnv、LIBERO和真实Franka机器人平台上进行了系统验证,覆盖多任务学习、持续学习、消融实验和少样本新任务适应等设置。整体结果表明,LifeLong-RFT不仅能够提升当前任务性能,也能显著改善持续学习过程中的抗遗忘能力。
多任务联合后训练实验
在多任务学习实验中,LifeLong-RFT 在 SimplerEnv 上相较 NORA-Long SFT 基线,在 WidowX 平台平均成功率提升 3.4 个百分点,在 Google Robot 平台提升 4.3 个百分点。在 LIBERO 四类任务上,LifeLong-RFT 取得 95.6% 的平均成功率,较基线提升 3.8 个百分点。
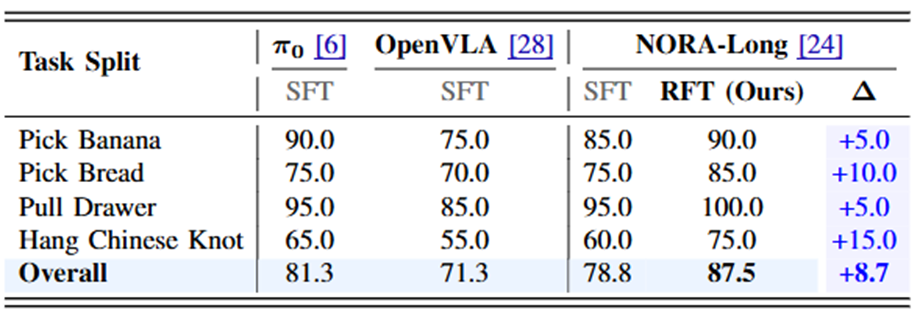
在真实机器人实验中,方法在拾取香蕉、拾取面包、拉抽屉和挂中国结四个任务上均优于对比方法。以NORA-Long为基座时,RFT后的平均成功率由78.8%提升至87.5%,提升8.7个百分点;其中“挂中国结”任务提升15.0个百分点。
表1 Lifelong-RFT与SFT方法在Simpler Env Benchmark上性能对比
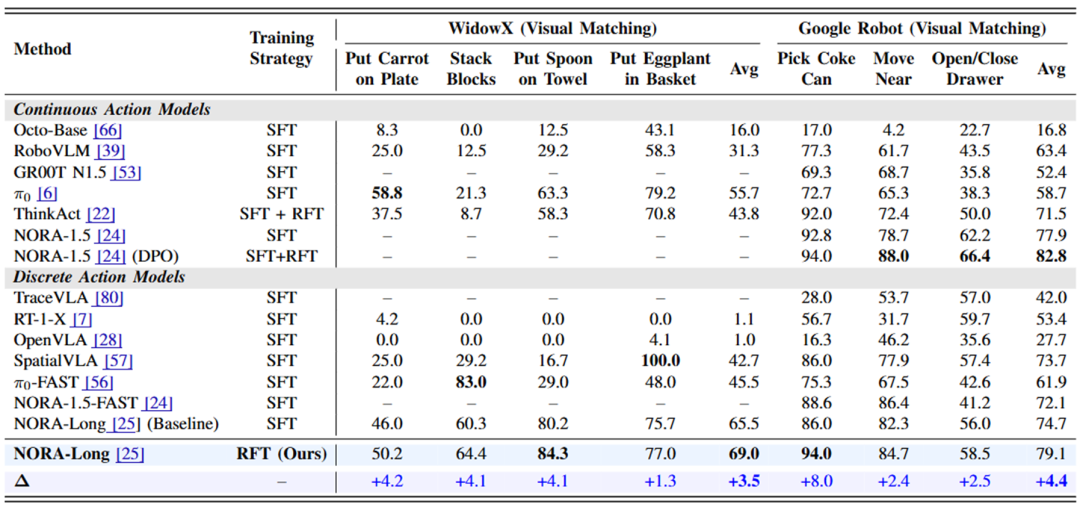
表2 Lifelong-RFT与SFT方法在LIBERO Benchmark上性能对比
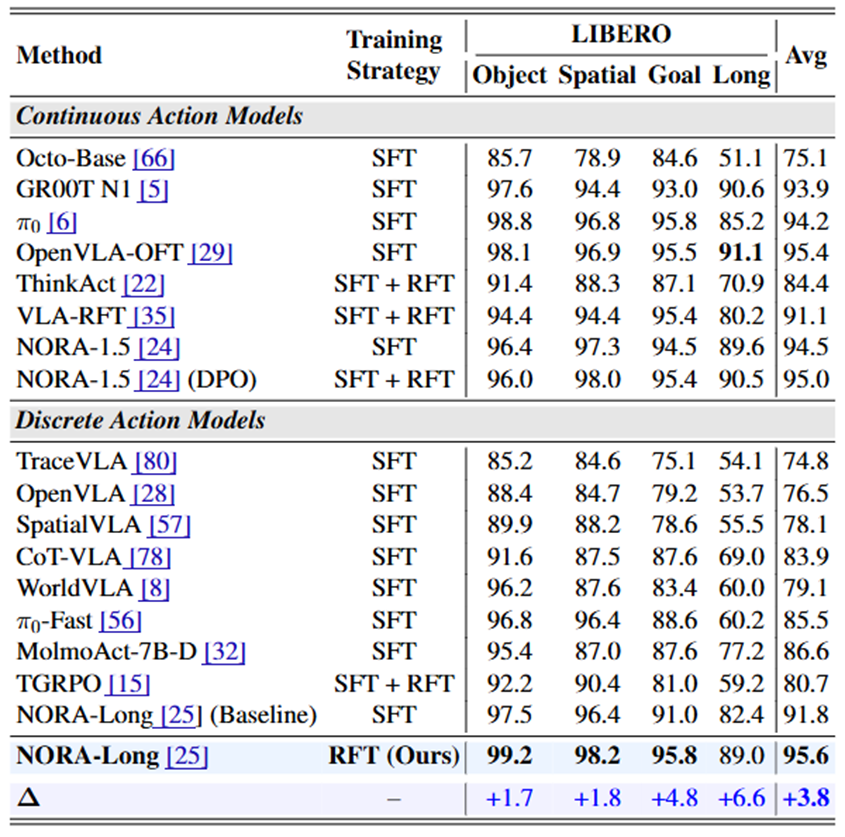
表3 Lifelong-RFT与SFT方法在真实机器人实验上性能对比
持续学习后训练实验
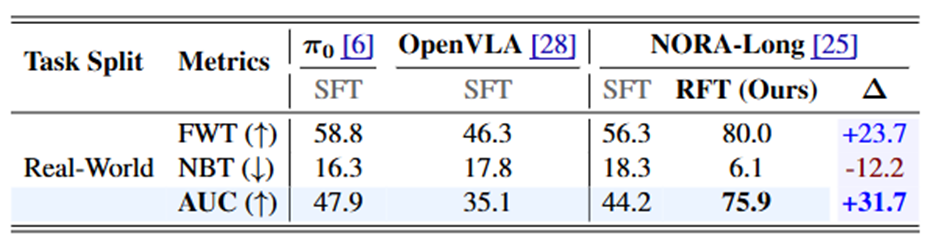
在持续学习实验中,模型先学习基础任务,再按顺序接收新任务。LIBERO中每个新任务仅提供10条示范,并为旧任务保留少量经验回放数据;真实机器人实验中每个任务使用20条示范。结果显示,LifeLong-RFT在前向迁移(FWT)、负向后向迁移(NBT,越低越好)和学习周期平均表现(AUC)上均显著优于SFT基线。例如在真实机器人持续学习中,FWT从56.3提升至80.0,NBT从18.3降至6.1,AUC从44.2提升至75.9,说明模型在学习新任务的同时能够更好地保留旧任务能力。
表4 Lifelong-RFT与SFT方法在LIBERO Benchmark上性能对比
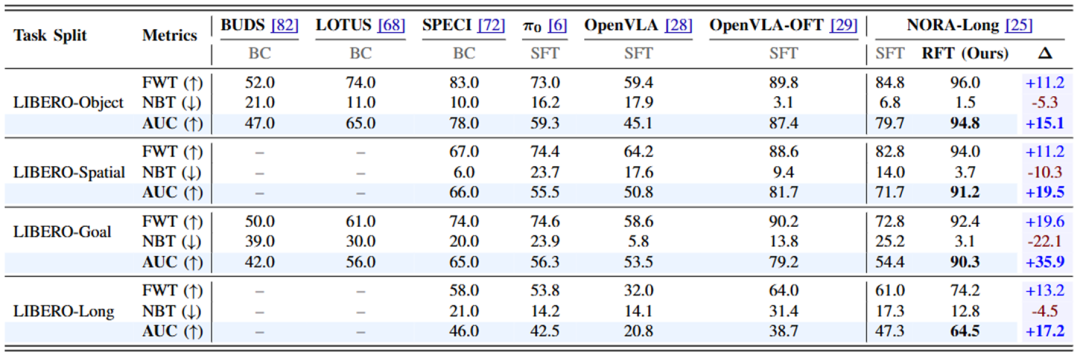
表5 Lifelong-RFT与SFT方法在真实机器人实验上性能对比
此外,LifeLong-RFT 在少样本新任务适应中也表现突出。在“Pick Orange Juice”任务上,仅使用 5 条示范即可达到 100% 成功率,而 SFT 使用 50 条示范时为 98%;在“Pick Bowl”任务上,LifeLong-RFT 使用 5 条示范即可匹配 SFT 使用 50 条示范的表现,并在 10 条示范时达到 100%。
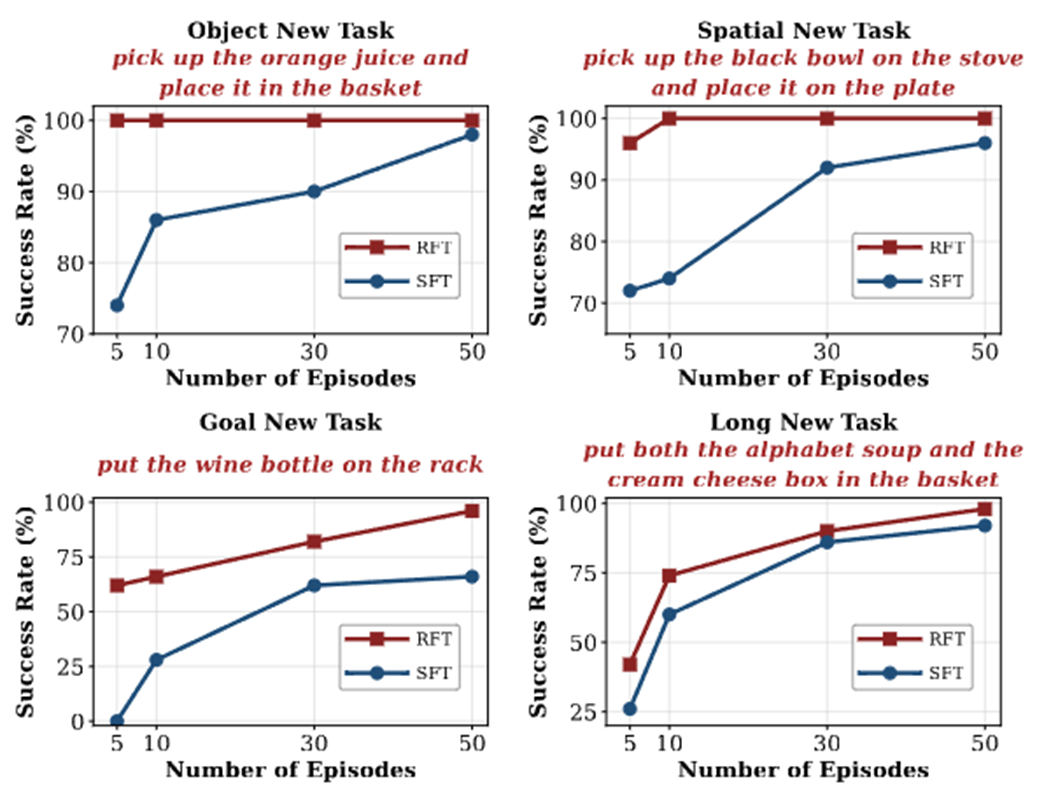
图3 新任务少样本适应效率对比更详细的实验结果可查看论文。
在本研究中,LifeLong-RFT将VLA后训练从单阶段任务适配推进到面向长期服役机器人的持续学习范式。该方法利用动作块级on-policy强化学习和多维过程奖励机制,在不依赖在线环境反馈和预训练奖励模型的情况下,为策略优化提供了可验证、细粒度且可扩展的奖励信号。实验结果表明,LifeLong-RFT能够在多任务学习中提升成功率,在持续学习中有效缓解灾难性遗忘,并显著降低新任务适应所需的数据量。该工作为VLA模型从“完成已训练任务”走向“长期学习与持续成长”的机器人智能体提供了一条有价值的后训练路径。
当然,当前方法主要面向离散动作模型,未来若能进一步扩展到连续动作VLA,并与更复杂的真实机器人部署场景结合,将有望推动具身基础模型更快走向实际应用。
