


来源:具身江河
原文链接:https://mp.weixin.qq.com/s/prlEip4pav6iyOtw95BIuw
导语
传统具身强化学习受限于真实世界交互成本高、复位繁琐及安全隐患,难以高效提升VLA模型在复杂动态任务中的鲁棒性。RISE框架通过构建解耦的“组合式世界模型”,将动力学预测与价值评估分离,实现了完全在想象空间中的高效在线强化学习。该方法避免了高昂的物理试错,在传送带抓取、软物打包和双臂盒盖等高难度任务中均取得了显著的性能跃升,为具身智能策略的自主自进化开辟了可行路径。
论文信息
论文题目:RISE: Self-Improving Robot Policy with Compositional World Model 中文题目:RISE:基于组合式世界模型的自进化机器人策略 代码链接:https://github.com/OpenDriveLab/RISE 论文作者:Jiazhi Yang¹ ²*†, Kunyang Lin²*, Wencong Zhang²*, Jinwei Li²⁶*, Tianwei Lin⁵, Longyan Wu⁴, Ya-Qin Zhang⁶, Hao Zhao⁶, Ping Luo³, Zhizhong Su⁵, Hongyang Li³, Xiangyu Yue¹♮, Li Chen³♮作者单位:香港中文大学¹,Kinetix AI²,香港大学³,上海创新研究院⁴,地平线⁵,清华大学⁶(*同等贡献,†项目负责人,♮共同指导) 发表年份:RSS 2026
一、论文摘要
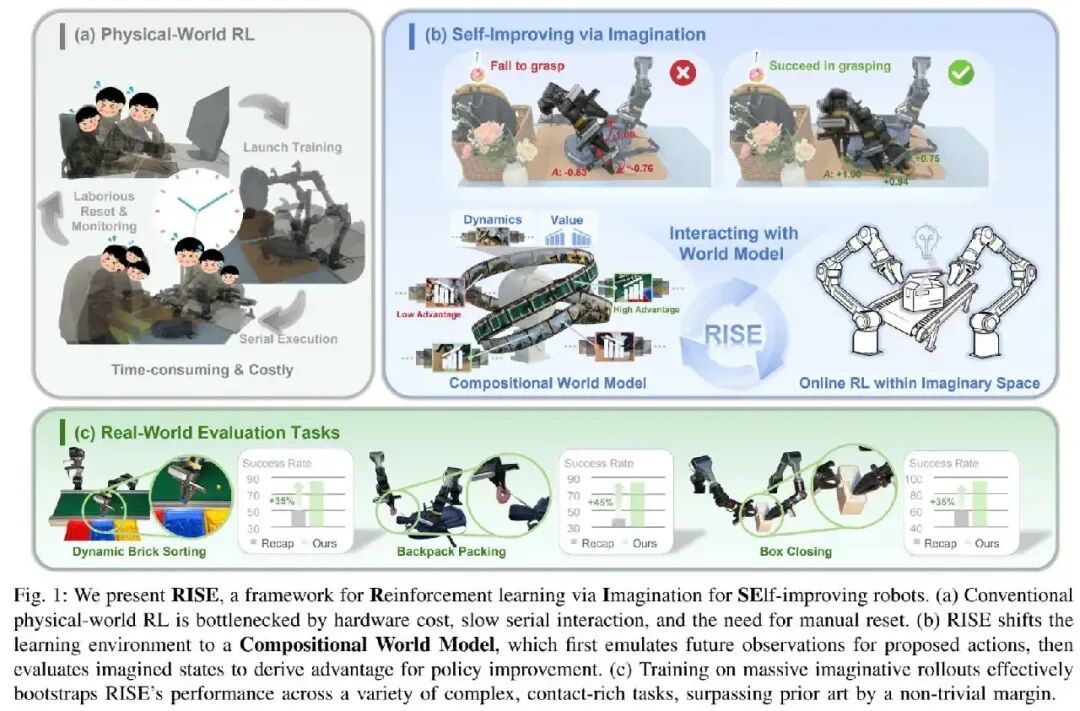
尽管模型容量与数据规模持续增长,视觉-语言-动作(VLA)模型在面对富接触(contact-rich)与动态操控任务时依然表现脆弱,极小的执行偏差就可能累积为最终的失败。强化学习(RL)虽能从根本上提升策略的鲁棒性,但真实世界中的在线RL受到安全风险、硬件磨损以及环境复位成本高的严重制约。为了打破这一瓶颈,本文提出了RISE,一个基于想象的机器人强化学习可扩展框架。
RISE的核心在于构建了一个组合式世界模型(Compositional World Model):一方面利用可控动力学模型预测多视角未来图像,另一方面利用进度价值模型对想象出的结果进行评价,从而为策略改进提供高质量的优势(Advantage)信号。这种组合式设计允许动力学状态与价值函数由最适合各自目标的独立架构分别建模。这些组件被整合进一个闭环自进化管线中,无需昂贵的物理交互,即可在想象空间内连续生成想象轨迹(rollouts)、估计优势信号并更新策略。在三项高难度的真实机器人操控任务中,RISE均大幅超越了现有方法,其中在动态传送带积木分拣任务中绝对成功率提升了35%,在背包打包任务中提升了45%,在双臂盒盖任务中提升了35%。
应用前景该技术不仅为通用机器人自主进化提供了新范式,在空天与遥感领域同样展现出巨大的落地潜力。例如,在空间站特种机械臂抓取高速漂移废弃物、无人机在复杂气流环境中的无损软着陆、遥感无人系统在灾害现场复杂地形的自主避障与探索等任务中,RISE可以在合成的物理仿真与生成式想象环境中完成高风险试错,大幅降低真实设备损耗与试错风险。
二、介绍
1. 论文要解决的核心问题是什么?
当前VLA模型在具身操控中的核心短板在于应对动态环境和富接触物理交互时的鲁棒性不足。在实际操作中(如抓取移动物体、双臂柔性物体协调等),机器人微小的位移偏差就会迅速累积成系统性失败。模仿学习(IL)极度依赖专家示范的质量和覆盖度,存在严重的分布偏移(exposure bias)问题,一旦脱离演示轨迹便难以自主纠错。
2. 已有方案存在什么局限性?
基于真实物理世界的在线强化学习(Physical RL)虽然理论上能够通过试错学习纠错技能,但面临三大现实物理壁垒:硬件损耗高昂、串行交互极其耗时、以及需要大量人工监视与环境复位。这导致以往的真实世界RL方法大多局限于离线数据(Offline RL),存在严重的策略分布偏移。而在仿真器中训练的方法又面临不可避免的Sim-to-Real(仿真到真实)鸿沟。此外,现有的生成式世界模型虽然视觉生成质量高,但动作可控性差、生成推理速度慢(例如Cosmos模型合成25帧多视角预测需10分钟以上),且缺乏长时程、高敏感度的中间奖励评价信号,难以直接用于RL在线循环。
3. 本文提出的方法是如何解决这些问题的?
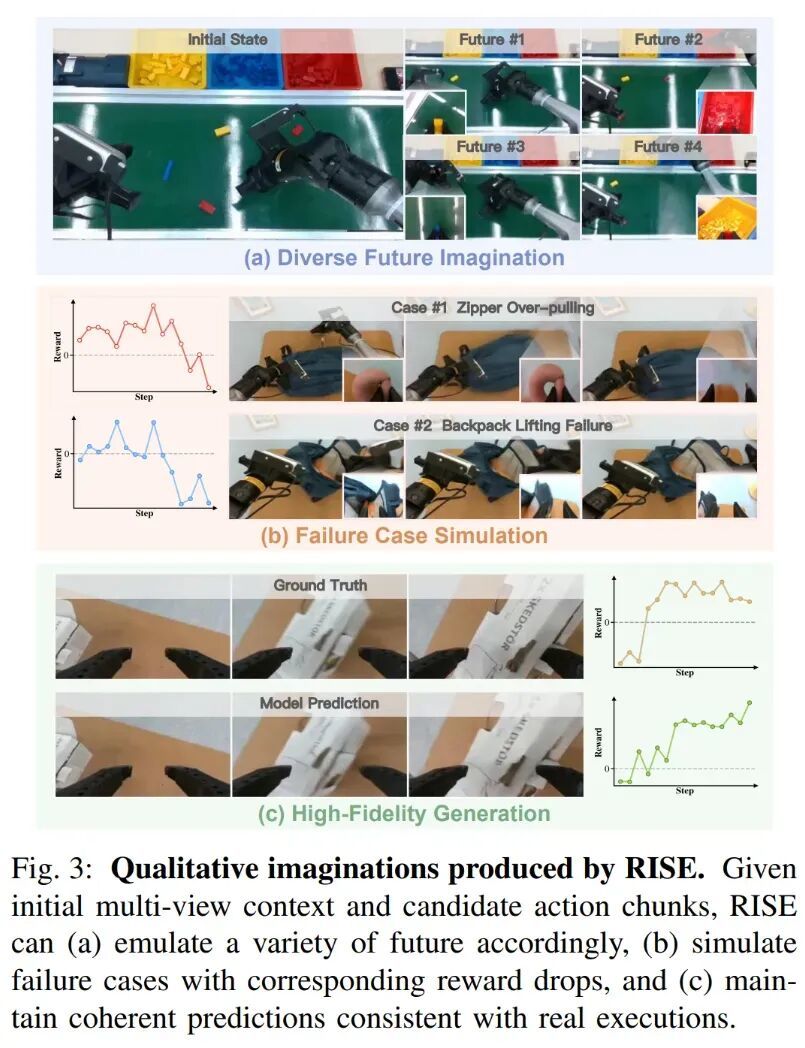
RISE提出了“在想象空间中进行在线强化学习”的思路,用高保真、高效率的生成式世界模型替代真实的物理环境。为了解决单一模型难以兼顾动力学预测与价值评估的问题,RISE设计了组合式世界模型:
动力学模型基于高效率的视频扩散架构(Genie Envisioner),结合任务中心批处理(Task-Centric Batching)策略,实现毫秒级的动作可控多视角未来画面预测; 价值模型基于预训练VLA骨干初始化,融合时序进度估计与 Temporal-Difference (TD) 学习,提供对富接触失败高度敏感的密化评价信号; 自进化闭环通过在想象空间中交互生成轨迹、评估优势值,并通过优势条件化(Advantage-Conditioned)训练策略,使得策略在不接触真实物理环境的情况下实现在线自我演进。
三、核心创新
RISE的核心设计逻辑在于“解耦”与“优势驱动”。世界模型并非单一庞大的神经网络,而是将“未来会变成怎样(动力学)”与“这个状态好不好(价值)”拆分为两个解耦的模块,分别采用最适合其目标的网络架构与训练目标进行独立优化。
在组合式世界模型中,动力学模型利用快速视频扩散模型架构,结合专门设计的任务中心批处理(Task-Centric Batching)策略。与传统的混合任务批训练不同,任务中心批处理在单个训练批次中聚焦于同一场景下的多样化动作探索,优先保障模型对不同动作指令的物理响应敏感度,从而大幅提升了动作可控性与泛化效率。
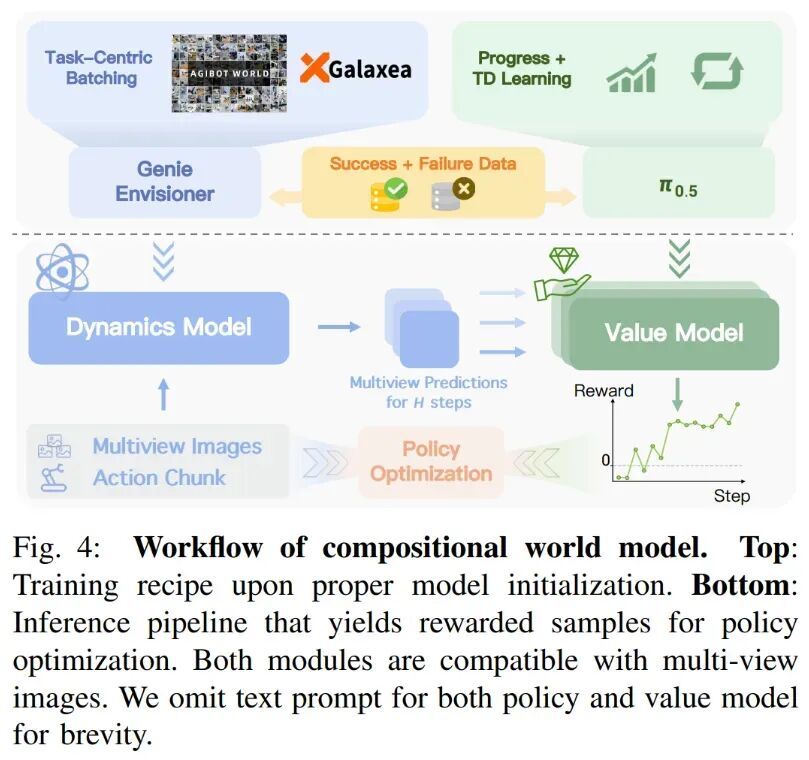
价值模型则直接利用预训练VLA(如 )作为初始化骨干,继承其丰富的具身先验知识。为了解决单一进度损失对接触失败不敏感的问题,RISE创新性地结合了进度估计损失(Progress Loss)与时序差分损失(TD Loss):前者提供全局单调递增的密化奖励,后者通过引入成功与失败轨迹的终端信号,大幅提高了对微小物理接触失败(如抓取滑脱、拉链未拉紧)的敏感度。
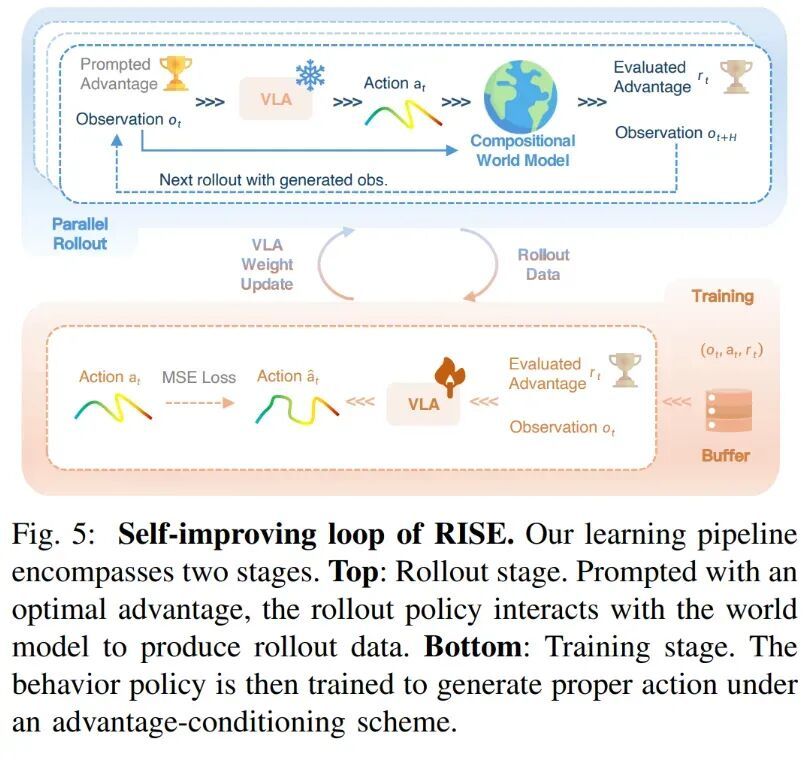
在自进化循环阶段,策略首先在离线数据上进行预热(Policy Warm-up),赋予其优势条件生成能力。随后进入“试错-自我提升”迭代:交互策略以最高优势提示(Advantage = +1.0)引导动作生成,动力学模型据此预测未来连续多帧图像,价值模型对预测图像进行离散化优势评估,并将这些在想象空间中采样的(状态, 动作, 优势)数据送入训练缓冲区,对策略进行流匹配(Flow Matching)优化,实现闭环自主进化。
四、实验结果
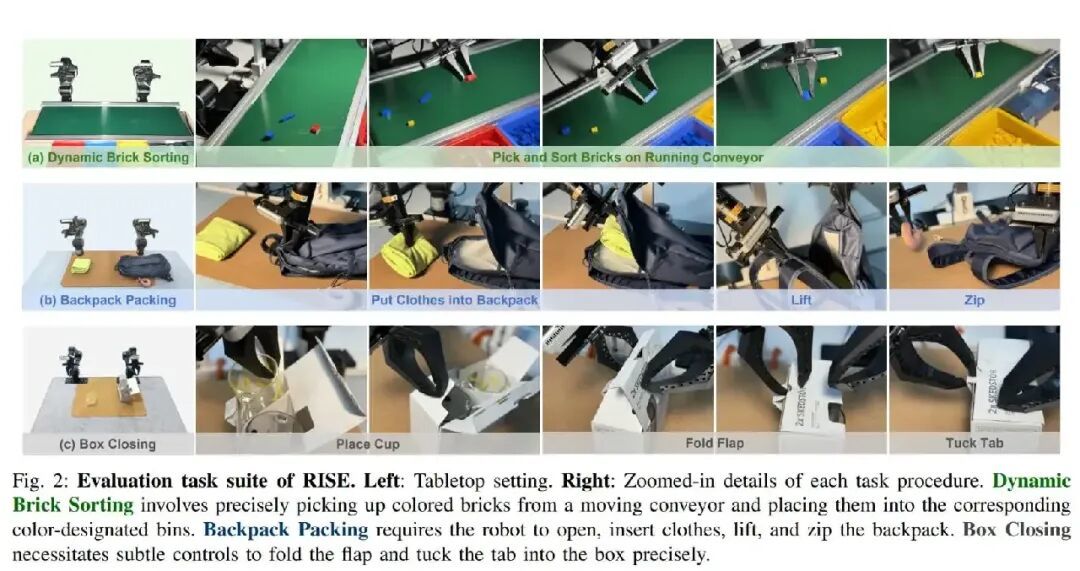
研究团队在 AgileX 双臂7自由度机器人平台上针对三项极具挑战性的真实操控任务进行了系统评估:传送带动态积木分拣(Dynamic Brick Sorting)、衣物打包(Backpack Packing)以及双臂盒盖(Box Closing)。评估指标包含终态成功率(Success Rate)与阶段性过程得分(Score)。
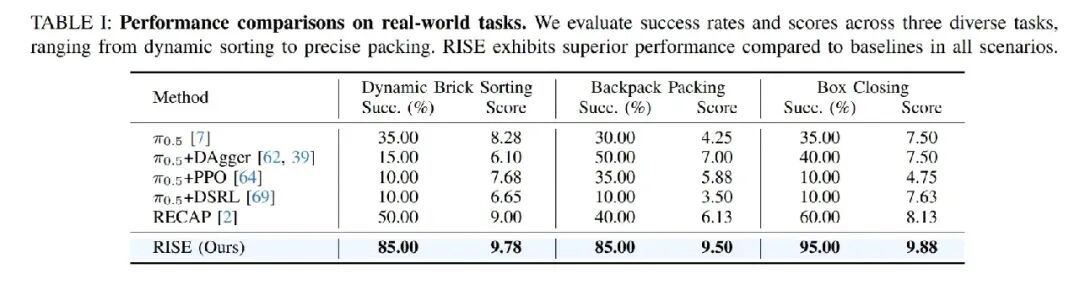
实验数据表明,RISE在所有任务上均大幅超越了包括 模仿学习基线、DAgger 交互式基线、PPO 在线强化学习、DSRL 以及离线 RL 方法 RECAP 在内的所有对照组。特别是在动态传送带分拣任务中,标准在线RL(PPO、DSRL)因为物理环境交互的不稳定性导致性能急剧衰减(成功率降至10%),而RISE达到了85%的成功率;在软物打包和盒盖任务中,RISE分别取得了85%和95%的极高成功率。
在动力学预测性能的定量对比中,RISE与当前主流的 Cosmos 和 Genie Envisioner (GE) 模型进行了评测。指标涵盖图像感知质量(PSNR, LPIPS, SSIM, FVD)以及反映运动光流预测精度的端点误差(EPE)。
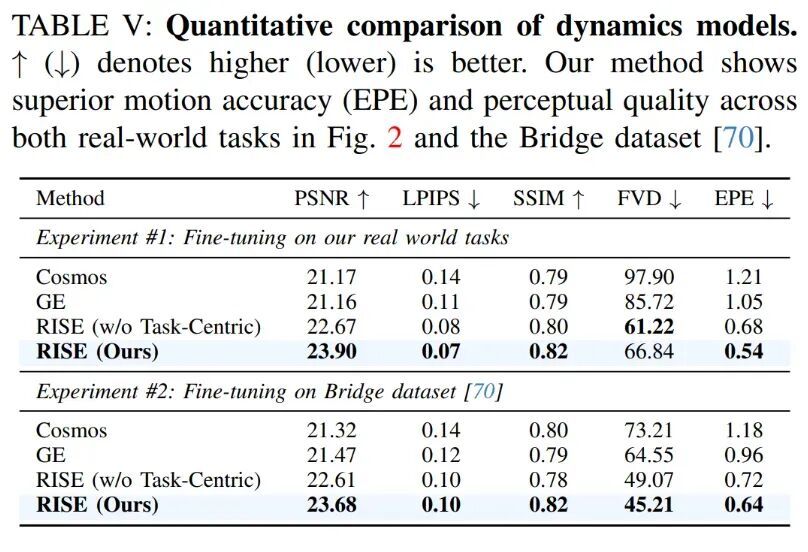
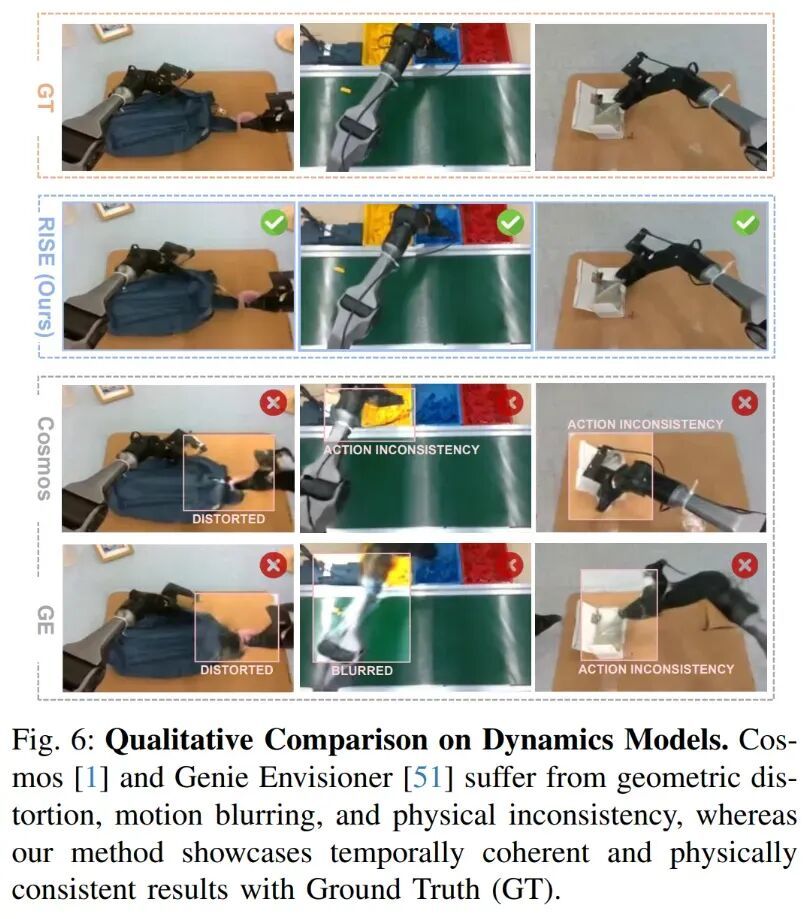
结果显示,得益于任务中心批处理和针对性的动作编码设计,RISE的动力学模型在运动端点误差(EPE)上显著低于 Cosmos 和基础 GE 模型(例如在真实任务中 EPE 从 1.21/1.05 降至 0.54),这说明 RISE 能够极高保真地模拟机器人动作引起的物体运动物理规律。
五、结论
RISE框架成功证明了基于生成式世界模型的想象强化学习是突破真实机器人强化学习瓶颈的有效途径。通过设计解耦的组合式世界模型,RISE兼顾了极高的动作预测控制精度、高效的推理速度以及敏感的密化价值评估,将原本极其耗时且高风险的物理试错转移至虚幻的想象空间中进行。该方法在不需要额外真实物理交互的前提下,实现了VLA策略在复杂动态与富接触任务中的大幅自主进化。
六、实际应用与意义
在具身智能迈向大规模工业化与服务场景落地的过程中,RISE展现出重要的实用价值:
大幅降低物理试错成本与标注开销:传统真实世界强化学习需要人工反复整理实验桌、复位物品和监控安全,而RISE将99%以上的探索转移到世界模型中,极大解放了人力资源与硬件磨损。 极高的训练吞吐量与实时性:相较于生成25帧预测需要10分钟以上的 Cosmos 模型,RISE的动力学模型仅需不到2秒即可完成多视角未来预测,实现了300倍以上的生成加速,使在线强化学习循环在计算端变得可行。 解决富接触与动态跨域难题:通过强化学习中的优势条件控制,策略学会了从想象的失败中提炼“纠错技能”,大幅提升了机械臂在高速传送带抓取、柔性衣物折叠拉扯等难以精确建模场景下的动作成功率。
七、未来展望
基于论文的讨论,未来基于世界模型的机器人自进化方向可以在以下几个方面继续深耕:
缩小想象与真实的物理鸿沟(Imagination-to-Real Gap):尽管组合式设计提升了可控性,但在极其罕见或复杂的接触边界下,视频生成模型仍可能产生违反物理直觉的视觉瑕疵。引入显式几何约束与不确定性感知(Uncertainty-Aware Imagination)将是关键突破点。 探索离线数据与想象数据的最佳配比:消融实验表明,在RL训练中保留适当比例的真实离线经验(如60%)对锚定策略行为分布至关重要,如何根据策略演进状态动态调整真实/虚幻数据采样率仍需深入探索。 从物理成本向算力成本的平滑转移:RISE将具身智能提升的瓶颈从“物理试错”转变为“计算算力”,未来针对专用具身世界模型的设计与推理加速,将进一步推动低成本、高效率的终端策略自我演化。
声明
本文内容为论文学习收获分享,受限于知识能力,本文对原文的理解可能存在偏差,最终内容以原论文为准。本文信息旨在传播和学术交流,其内容由作者负责,不代表本号观点。文中作品文字、图片等如涉及内容、版权和其他问题,请及时与我们联系,我们将在第一时间回复并处理。
