


来源:AI智沿前线
原文链接:https://mp\.weixin\.qq\.com/s/4C6xdnLvW5RiE\-uiHRQ1bA
华中科技大学与 VIVO AI Lab 提出 Moebius:一个只有 0.22B 参数的轻量级图像修复框架,却能在图像补全任务上接近甚至超过 10B 级工业大模型 FLUX.1-Fill-Dev。它没有继续沿着“模型越大越好”的路径堆参数,而是把扩散模型的骨干网络重新设计了一遍,用 Local-λ Mix Interaction 模块压缩注意力和卷积结构,再通过自适应多粒度蒸馏,把大模型的修复能力迁移到小模型中。最终,Moebius 用不到 FLUX.1-Fill-Dev 百分之二的参数,实现了超过十五倍的总推理加速。
一句话速览:Moebius 把“10B 级大模型图像修复能力”压进了一个 0.22B 的专家模型里。它的关键不是粗暴裁剪大模型,而是用 Local-λ 和 Interactive-λ 两类轻量交互模块,分别处理图像内部上下文和外部语义先验,再用只发生在 latent 空间中的自适应多粒度蒸馏,让小模型继承教师模型的结构理解、纹理生成和感知质量。最终,Moebius 在自然场景、人像修复和真实物体移除任务中,以极低计算成本达到接近甚至超过工业级大模型的效果。
一句话速览:Moebius 把“10B 级大模型图像修复能力”压进了一个 0.22B 的专家模型里。它的关键不是粗暴裁剪大模型,而是用 Local-λ 和 Interactive-λ 两类轻量交互模块,分别处理图像内部上下文和外部语义先验,再用只发生在 latent 空间中的自适应多粒度蒸馏,让小模型继承教师模型的结构理解、纹理生成和感知质量。最终,Moebius 在自然场景、人像修复和真实物体移除任务中,以极低计算成本达到接近甚至超过工业级大模型的效果。
一、背景与动机:10B 大模型很强,但太重了
? 核心观点:要让小模型达到大模型级图像修复质量,不能只靠删层、减通道、换轻量算子。真正关键的是避免小模型的表示瓶颈,并用蒸馏把大模型的语义理解和细节生成能力补回来。
? 核心观点:要让小模型达到大模型级图像修复质量,不能只靠删层、减通道、换轻量算子。真正关键的是避免小模型的表示瓶颈,并用蒸馏把大模型的语义理解和细节生成能力补回来。
二、方法:Moebius 怎么把大模型能力压进小模型
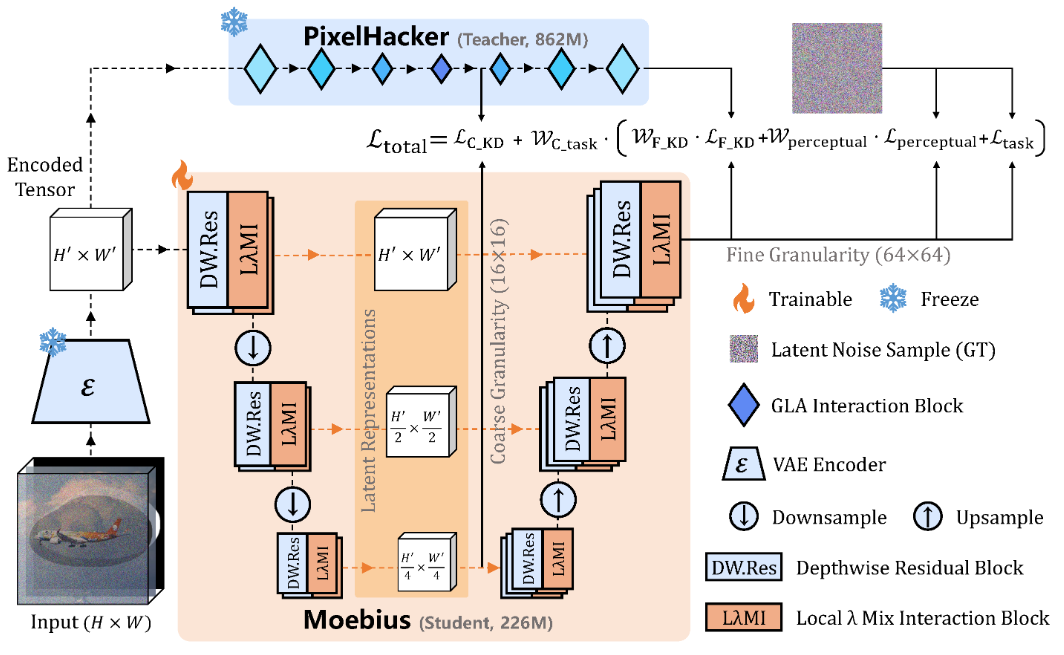
Moebius 的方法可以概括为两条主线。第一条主线是架构重构。作者提出 Local-λ Mix Interaction 模块,也就是 LλMI,用它替代重型扩散模型中的昂贵交互结构。第二条主线是能力迁移。作者提出自适应多粒度蒸馏,只在 latent 空间中对齐教师模型和学生模型,从而避免昂贵的像素空间解码训练。这两条主线必须一起看。单独轻量化会损失质量,单独蒸馏也无法弥补糟糕结构带来的表达瓶颈。Moebius 的成功来自二者的协同。
1. 整体框架:仍然是 latent diffusion,但骨干网络被重做了
Moebius 仍然基于 latent diffusion 框架。也就是说,它不是直接在像素空间里做扩散生成,而是先用预训练 VAE 把图像编码到 latent space,再在更紧凑的潜空间里完成去噪和修复。这本身就是扩散图像模型中常见的高效做法。同时,Moebius 继承了 PixelHacker 中的 Latent Categories Guidance 思路。这个机制可以为修复过程提供全局语义先验,帮助模型判断缺失区域可能属于什么类别、应该具有什么结构和语义内容。通俗地说,它像是给模型额外提供了一份“语义导航图”,让模型不只是看局部像素猜内容,而是能结合更高层的类别和场景理解来修复。
不过,PixelHacker 本身仍然接近十亿参数,对轻量部署来说还不够小。Moebius 的目标更激进,要把模型压到 0.22B 参数,同时尽量保住高质量修复能力。论文首先分析了直接压缩为什么会失败。作者发现,如果只是删除部分冗余结构,可以从 PixelHacker 的八亿多参数压到五亿多参数,质量损失还比较可控。但如果进一步把标准卷积换成深度可分离卷积,把前馈网络换成轻量版本,把注意力模块换成常见高效算子,模型质量就会明显下降。尤其在图像修复这种需要空间、语义、纹理多层交互的任务中,普通轻量算子很容易让模型表达力不足。
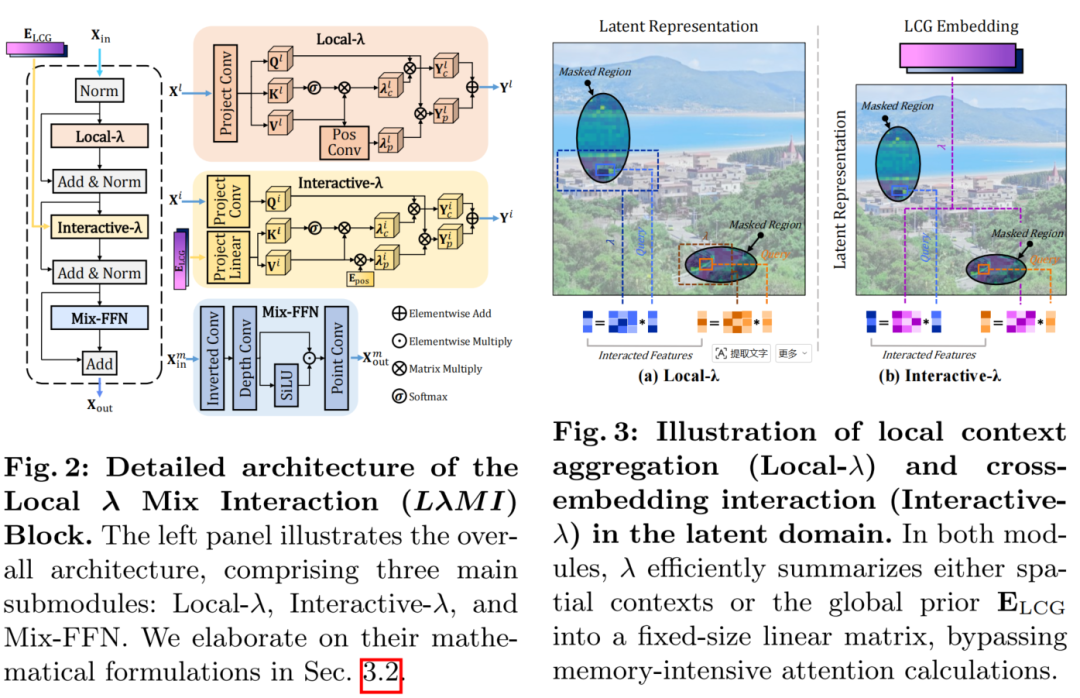
为了解决这个问题,Moebius 提出了整篇论文最关键的结构:Local-λ Mix Interaction Block,也就是 LλMI 模块。这个模块可以理解为一种专门为轻量图像修复设计的信息交互单元。它主要包含三个部分:Local-λ、Interactive-λ 和 Mix-FFN。Local-λ 负责建模图像内部的局部空间上下文和语义连续性;Interactive-λ 负责把外部的全局语义先验注入到图像 latent 特征中;Mix-FFN 则用更轻的方式完成通道变换和非线性表达。
传统注意力机制通常需要显式计算大规模 token 之间的相互关系,代价比较高。Moebius 的思路是,不直接计算庞大的注意力图,而是把局部上下文和全局语义先验压缩成固定大小的线性映射,再让当前图像特征和这些映射进行交互。这样一来,模型仍然能获得类似 attention 的上下文建模能力,但计算量和参数量显著降低。Local-λ 的作用更像是轻量版 self-attention。它关注图像内部信息,让模型知道遮罩区域周围的纹理、结构、边界应该如何延续。比如修复墙面时,它要知道砖块线条如何继续;修复草地时,它要知道草的方向和密度如何保持一致;修复人脸时,它要知道五官之间的位置关系不能乱。
Interactive-λ 的作用更像是轻量版 cross-attention。它解决的是另一个关键问题:如何把 Latent Categories Guidance 提供的全局语义先验高效注入模型。论文指出,原先一些高效线性注意力机制适合 self-attention,但并不天然适合 cross-attention。Moebius 通过 Interactive-λ 重新设计了这种跨信息源交互方式,让小模型也能利用外部语义先验,而不是只靠局部图像内容硬猜。
Mix-FFN 和深度可分离残差块则进一步承担压缩职责。它们减少了卷积和前馈网络中的冗余参数,使整个网络真正进入 0.2B 参数级别。但关键是,这些轻量模块不是孤立替换,而是和 Local-λ、Interactive-λ 协同使用。论文的消融实验也证明,只有完整组合起来,才能同时获得高效率和高质量。这一点非常重要。Moebius 的成功不是“某个模块特别神”,而是结构设计形成了闭环。Local-λ 保局部和空间上下文,Interactive-λ 保语义先验交互,Mix-FFN 和深度可分离卷积负责极致压缩。它们共同构成了一个适合图像修复的小型扩散骨干网络。
2. 蒸馏策略:把大模型能力迁移到小模型里
仅靠结构设计还不够。论文很清楚地展示了一个现象:同样的 0.22B 架构,如果不用蒸馏,质量会明显下降;加入自适应多粒度蒸馏后,模型表现会大幅提升。这说明 Moebius 的真正秘诀是 架构压缩和知识蒸馏的协同。结构设计让小模型有能力承载复杂信息,蒸馏策略则负责把教师模型的生成经验迁移过来。
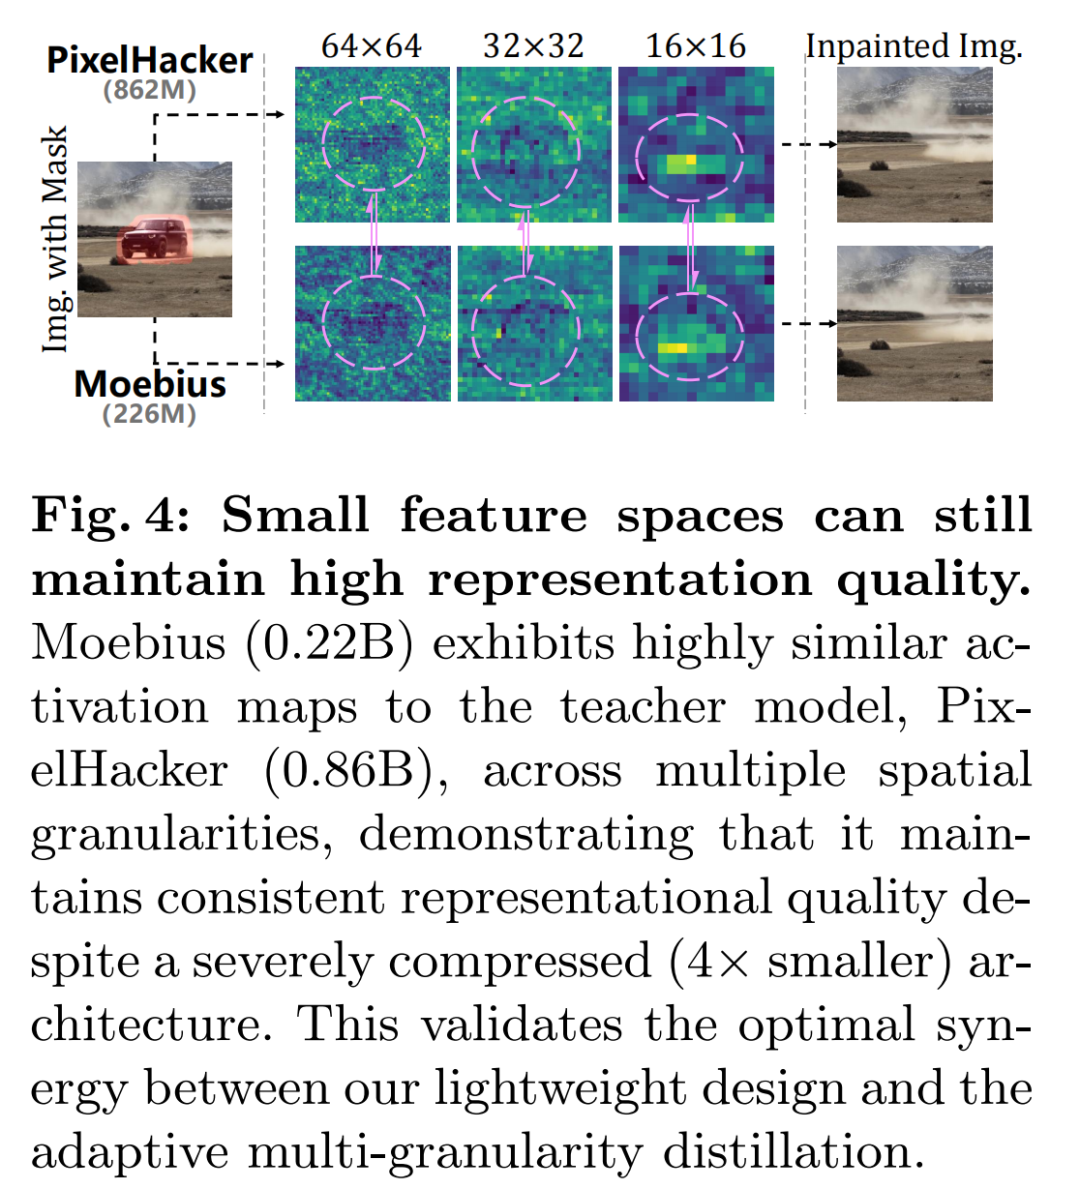
Moebius 使用 PixelHacker 作为教师模型。PixelHacker 本身是一个更大的 LCG-based 图像修复模型,拥有较强的语义和结构修复能力。Moebius 作为学生模型,要在训练过程中模仿教师模型在不同层级上的表现。这里的蒸馏不是简单让学生输出模仿教师输出,而是分成多个粒度进行对齐。在较粗的空间粒度上,Moebius 对齐中间 bottleneck 特征。这一层更关注全局结构和高层语义。可以理解为,学生模型先学习教师模型如何判断整体场景布局,知道缺失区域应该服从怎样的大结构。在较细的空间粒度上,Moebius 对齐最终 latent 输出。这一层更关注局部细节、纹理、边界和颜色连续性。它让学生模型学习教师模型如何把修复区域做得更自然、更真实。
除此之外,Moebius 还引入了 latent perceptual distillation,也就是在 latent space 中进行感知质量约束。很多图像生成方法会把 latent 解码回像素空间再计算感知损失,但这会带来额外显存和计算开销。Moebius 的目标是轻量高效,所以它把感知约束也放在 latent space 里完成。这样既能保留对视觉质量的约束,又不会破坏整体训练效率。
更巧妙的是,Moebius 没有给这些损失项固定权重,而是使用基于梯度范数的自适应平衡机制。因为粗粒度蒸馏、细粒度蒸馏、任务监督、感知约束的量级和梯度贡献都不一样,如果手动调权重,很容易顾此失彼。权重太偏向全局结构,细节可能不够好;太偏向局部细节,整体语义可能不稳定。自适应平衡机制会根据不同损失对关键参数的梯度大小,动态调整它们的影响力。直观理解就是,哪一项监督信号当前过强或过弱,训练过程会自动做平衡,而不是靠人工反复试超参数。
这套蒸馏策略和 LλMI 架构之间形成了很强的互补关系。LλMI 让小模型具备承载复杂交互的结构基础,多粒度蒸馏则把大模型的语义、结构、纹理能力注入进去。论文把这种关系称为一种 synergy,也就是协同效应。
? Insight:Moebius 不是单纯“小模型模仿大模型”。它先用结构设计减少表示瓶颈,再用多粒度 latent 蒸馏补偿容量损失。小模型不是被动压缩出来的,而是被重新设计、重新训练、重新对齐出来的。
? Insight:Moebius 不是单纯“小模型模仿大模型”。它先用结构设计减少表示瓶颈,再用多粒度 latent 蒸馏补偿容量损失。小模型不是被动压缩出来的,而是被重新设计、重新训练、重新对齐出来的。
三、实验与结果
实验设置
Moebius 在自然场景、人像场景、真实世界物体移除和 OOD 泛化上都做了系统实验。论文主要使用 FID 和 LPIPS 作为质量指标,同时比较参数量、计算量、单步延迟和总推理时间。
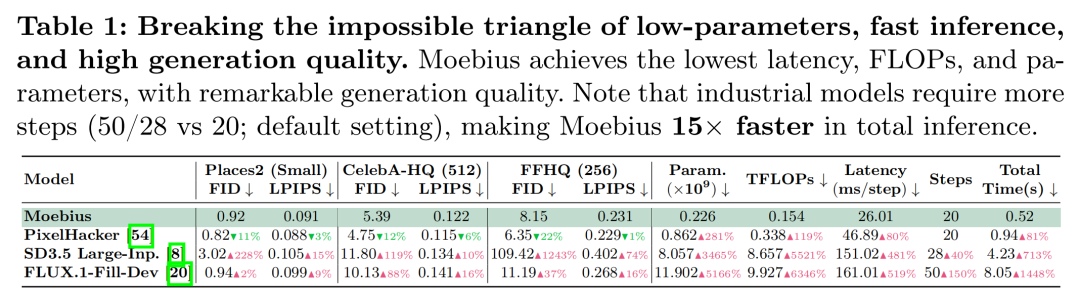
最直观的结果来自效率对比。Moebius 只有 0.226B 参数,而 FLUX.1-Fill-Dev 有 11.902B 参数。也就是说,Moebius 的参数量不到 FLUX 的百分之二。更关键的是,Moebius 的单步推理延迟是 26.01 毫秒,而 FLUX.1-Fill-Dev 是 161.01 毫秒。再考虑采样步数,Moebius 默认只需要 20 步,而 FLUX.1-Fill-Dev 默认需要 50 步。最终总推理时间上,Moebius 约为 0.52 秒,FLUX.1-Fill-Dev 约为 8.05 秒,速度差距超过十五倍。这意味着 Moebius 的优势不是论文表格里的“参数小”而已,而是完整推理链路真的更快。对于实际图像编辑系统来说,这种差距非常关键。用户等半秒和等八秒,体验完全不是一回事。
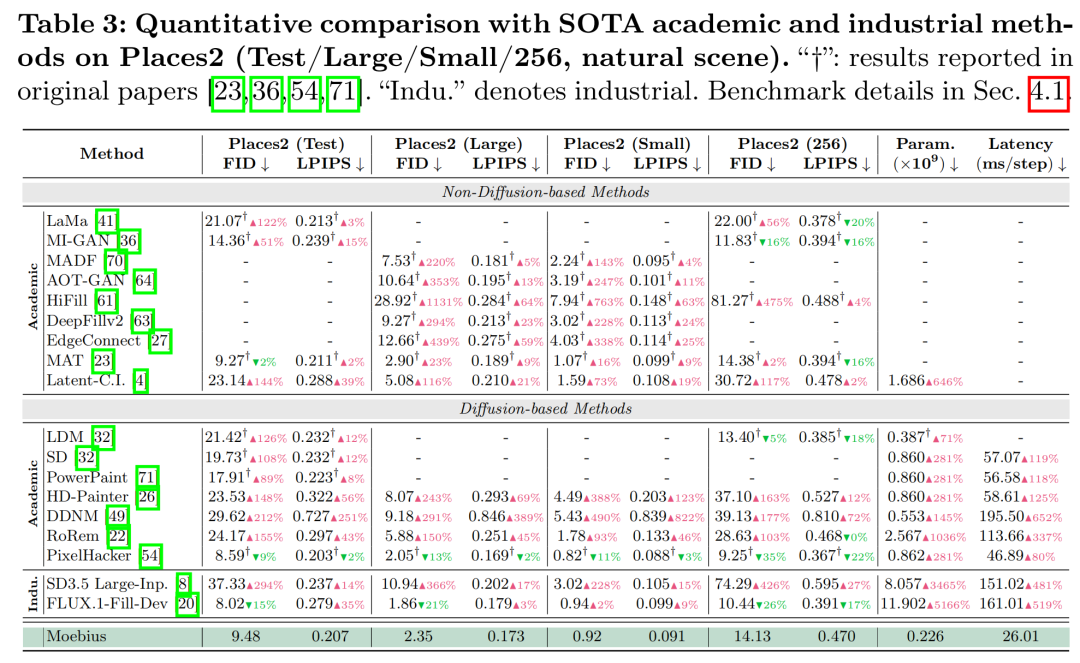
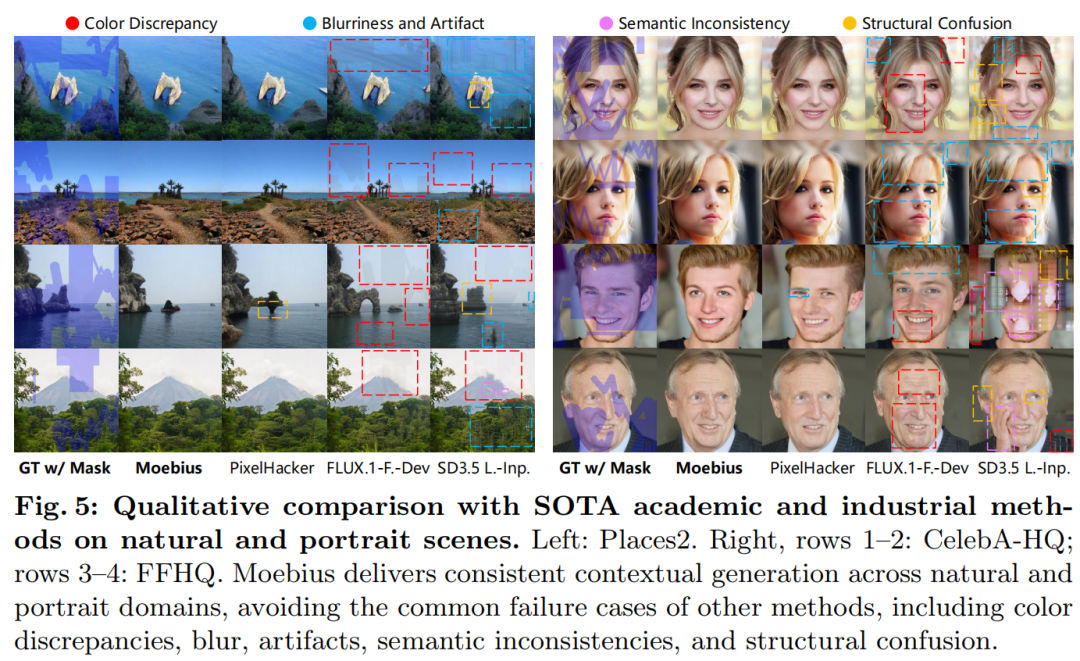
在自然场景 Places2 上,Moebius 表现接近甚至超过工业大模型。在 Places2 Small 设置中,Moebius 的 FID 和 LPIPS 都优于 FLUX.1-Fill-Dev。论文中的可视化结果显示,FLUX 和 SD3.5 在一些复杂自然场景中会出现颜色偏差、纹理模糊、结构断裂或者语义不一致,而 Moebius 能更稳定地保持背景连续性。
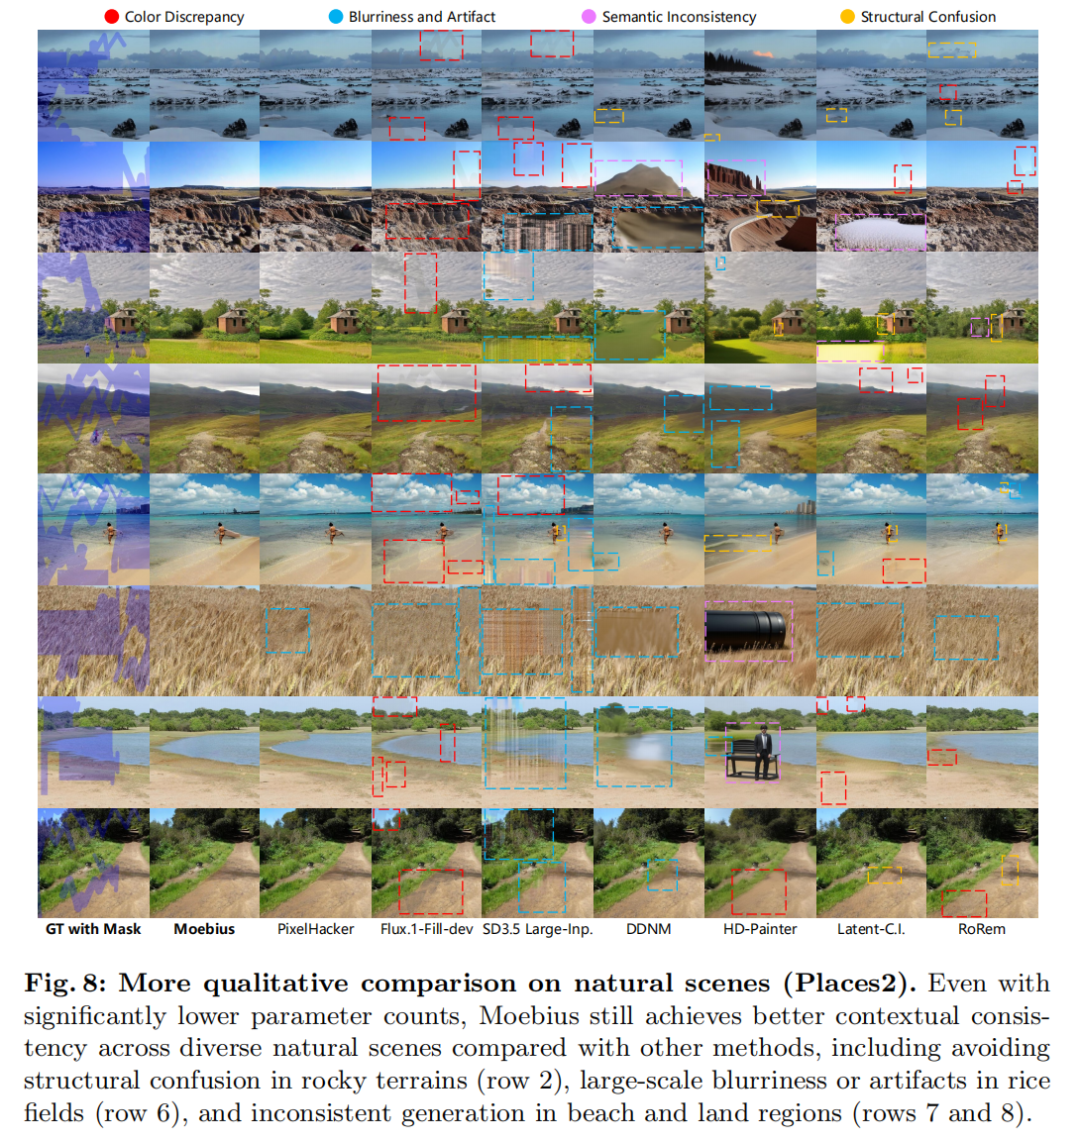
这背后的原因并不难理解。工业大模型虽然通用能力强,但并不是专门为某个修复 benchmark 或特定修复分布优化的。Moebius 则是一个任务专家模型,它专注于 image inpainting,并通过教师模型蒸馏和结构优化充分适配这个任务。因此在特定修复场景中,小专家反而可能比大通才更稳定。
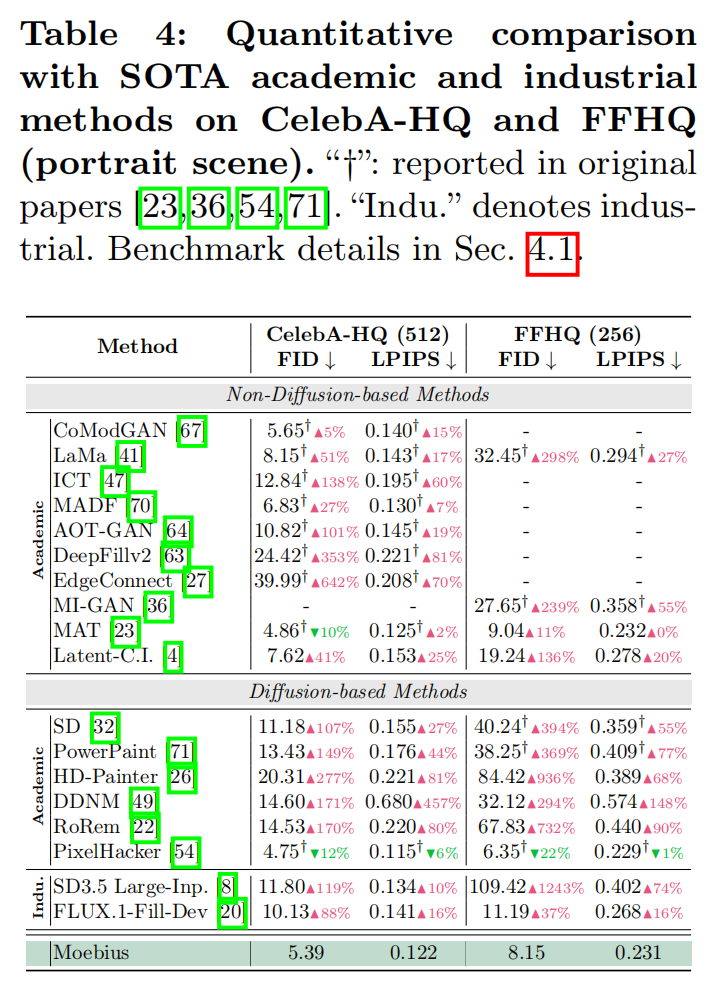
在人像场景中,Moebius 的优势更加明显。CelebA-HQ 和 FFHQ 都是对人脸结构要求很高的数据集。修复人脸时,模型必须保持五官对称、眼神自然、嘴部结构合理、皮肤纹理连续。工业大模型在这些任务上有时会出现眼睛错位、嘴部模糊、牙齿结构混乱、发丝语义不一致等问题。
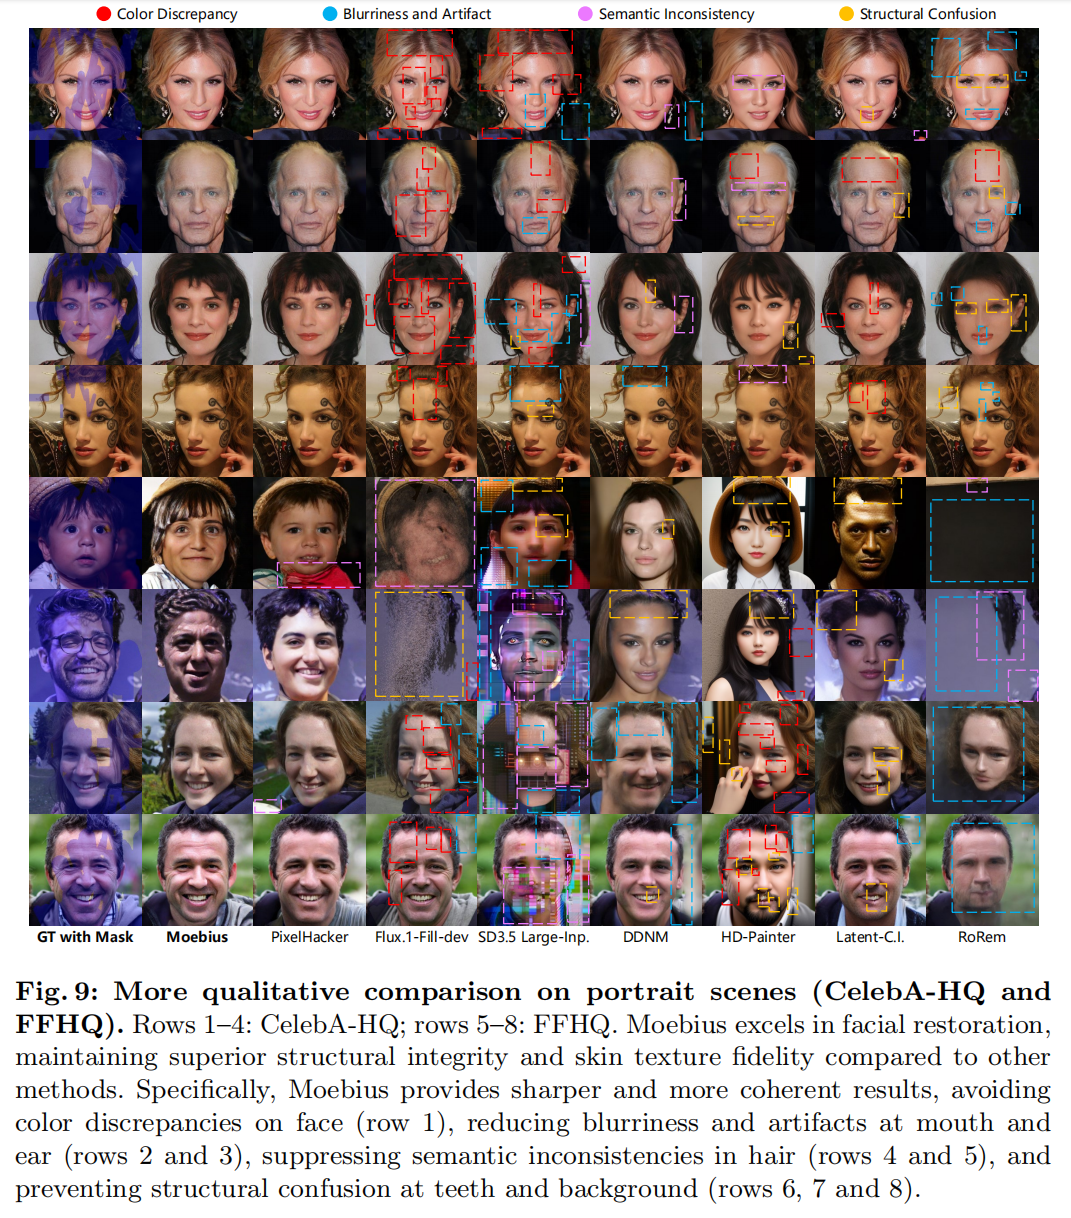
Moebius 在 CelebA-HQ 上取得了 5.39 的 FID 和 0.122 的 LPIPS,在 FFHQ 上取得了 8.15 的 FID 和 0.231 的 LPIPS。相比之下,FLUX.1-Fill-Dev 在 CelebA-HQ 和 FFHQ 上的 FID 都更高,SD3.5 Large-Inpainting 在 FFHQ 上表现尤其差。这个结果说明,Moebius 对高度结构化的人像修复任务非常适合。
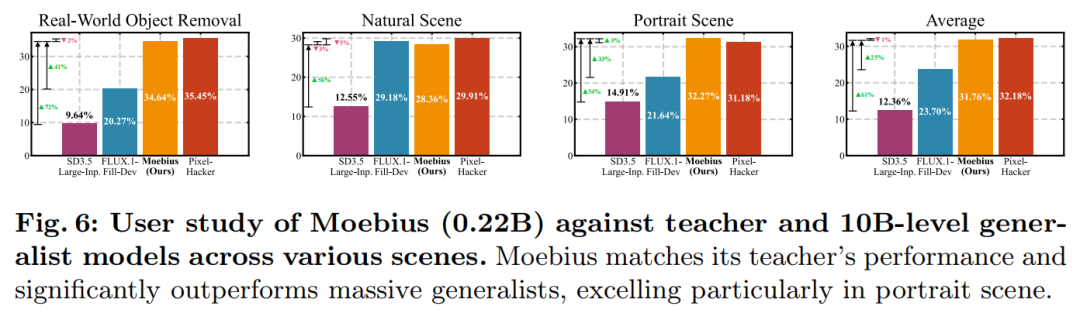
论文还做了双盲用户研究。参与者需要在自然场景、人像场景和真实世界物体移除中选择视觉质量最好的结果。最终 Moebius 的平均偏好率达到 31.76%,几乎追平教师模型 PixelHacker 的 32.18%,明显超过 FLUX.1-Fill-Dev 和 SD3.5 Large-Inpainting。尤其在人像场景中,Moebius 的偏好率甚至最高,说明它在人眼主观感知上也非常有竞争力。
消融实验:结构和蒸馏缺一不可
论文的消融实验非常有说服力,因为它证明 Moebius 不是靠单个技巧撑起来的。
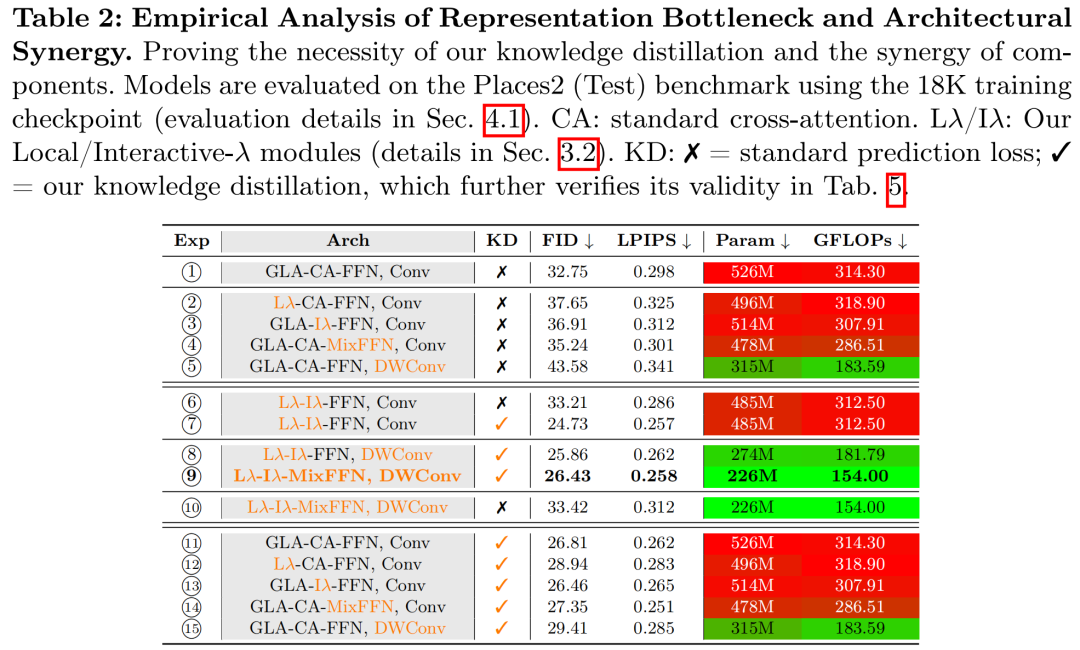
如果只做结构压缩,不加蒸馏,0.22B 模型的质量会明显下降。加入自适应多粒度蒸馏后,FID 和 LPIPS 都有显著改善。这说明极致压缩必然带来容量损失,而蒸馏正是补回这部分能力的关键。如果只替换某一个轻量模块,比如只换卷积、只换前馈网络、只替换某类注意力,也无法达到最优结果。论文表明,只有 Local-λ、Interactive-λ、Mix-FFN、深度可分离卷积和多粒度蒸馏一起使用,才能获得最佳质量与效率平衡。
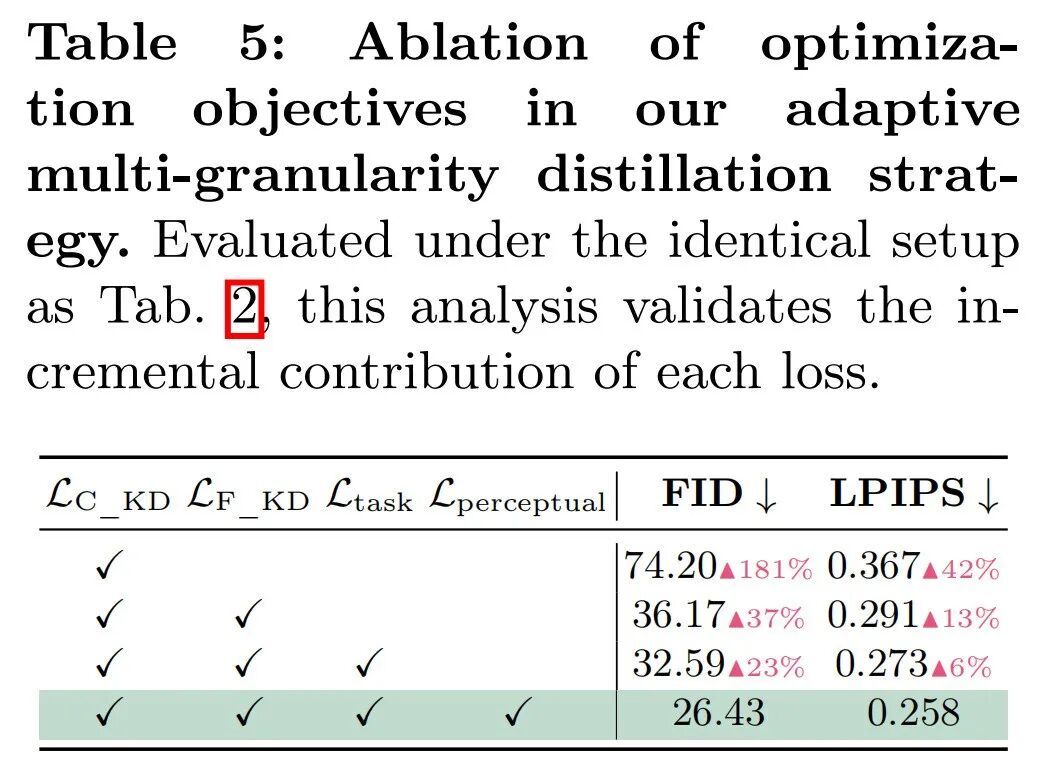
蒸馏目标本身也经过了细致验证。只使用粗粒度蒸馏时,效果很差;加入细粒度蒸馏后,质量明显提升;再加入任务监督和 latent 感知约束后,结果进一步改善。这说明多粒度设计确实必要。全局结构、最终输出和感知质量分别提供了不同层面的监督信号,缺少任何一部分都会影响最终表现。
真实世界应用:物体移除也能稳住
除了标准数据集,论文还展示了真实世界物体移除结果。这类任务通常比 benchmark 更复杂,因为用户画的 mask 不规则,背景可能包含建筑、河流、道路、电线杆、人物、植物等复杂结构。
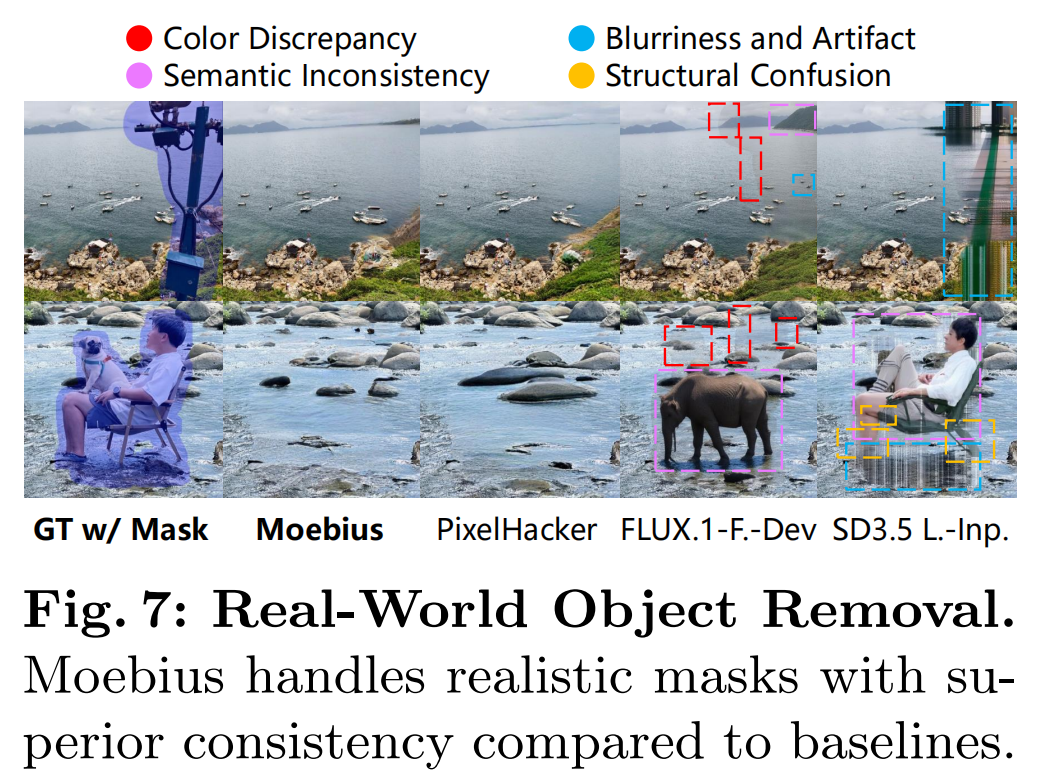
实验显示,FLUX.1-Fill-Dev 和 SD3.5 Large-Inpainting 有时会在真实物体移除中留下残影,或者在背景重建时出现颜色不一致、语义错乱和结构断裂。Moebius 则能更稳定地理解整体场景,把被移除物体背后的背景补得更自然。这说明 Moebius 不只是为了刷分设计的模型,它具备较强的实际图像编辑价值。尤其考虑到它的推理速度和参数规模,它更适合部署在低成本、高吞吐或交互式编辑场景中。
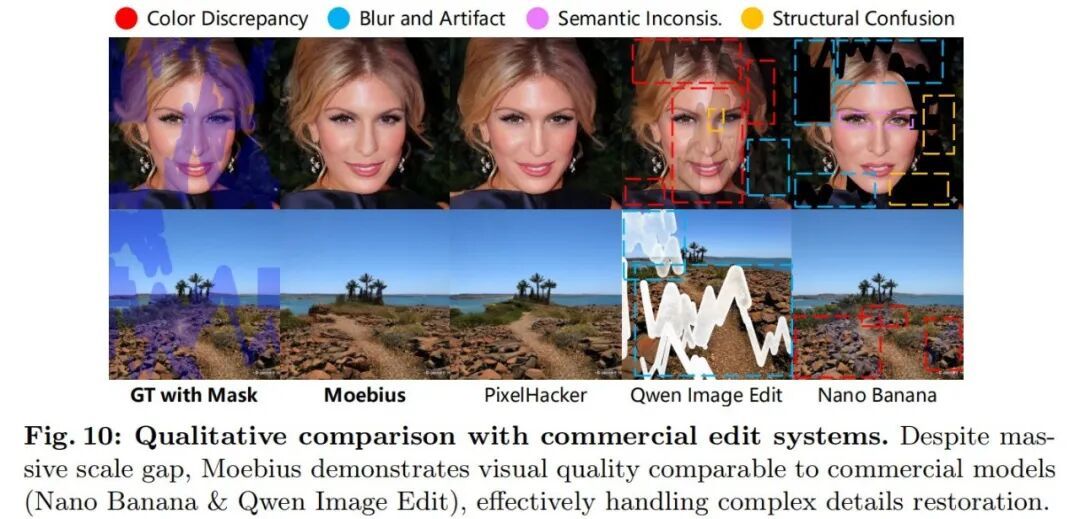
论文补充材料还将 Moebius 与商业图像编辑系统进行了比较,包括 Nano Banana 和 Qwen Image Edit。这些系统通常背后有更大规模的模型和算力支持,但 Moebius 在多个样例中仍然表现出接近商业系统的视觉质量。对于一个 0.22B 参数的开源轻量专家模型来说,这个结果很有冲击力。
当然,Moebius 也不是没有边界。论文展示了一些失败案例。在极小背景区域、可参考上下文非常有限、需要恢复极精细几何纹理的场景中,Moebius 相比教师模型 PixelHacker 可能会出现细节不足或局部纹理不够真实的问题。这是模型容量压缩后的自然代价。毕竟它只有 0.22B 参数,而教师模型接近 0.86B 参数,更不用说 10B 级工业模型。
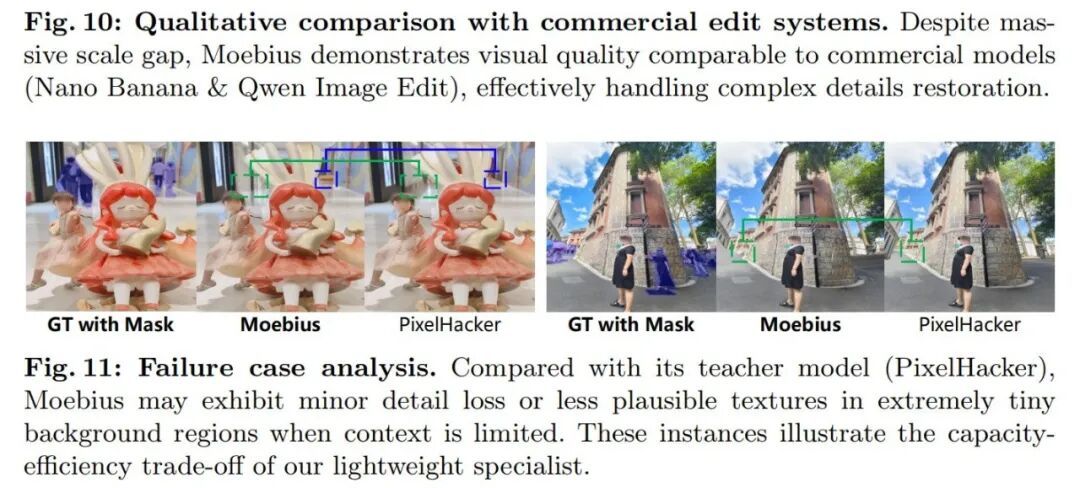
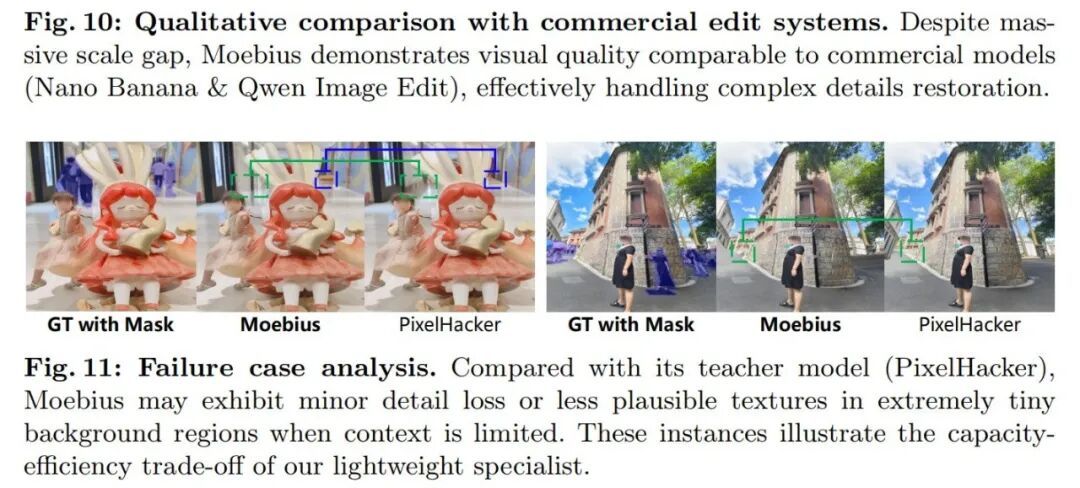
不过从整体结果看,这种损失是可接受的。Moebius 用极小的容量换来了接近大模型的修复质量和大幅提升的推理效率,这是一个非常划算的 trade-off。
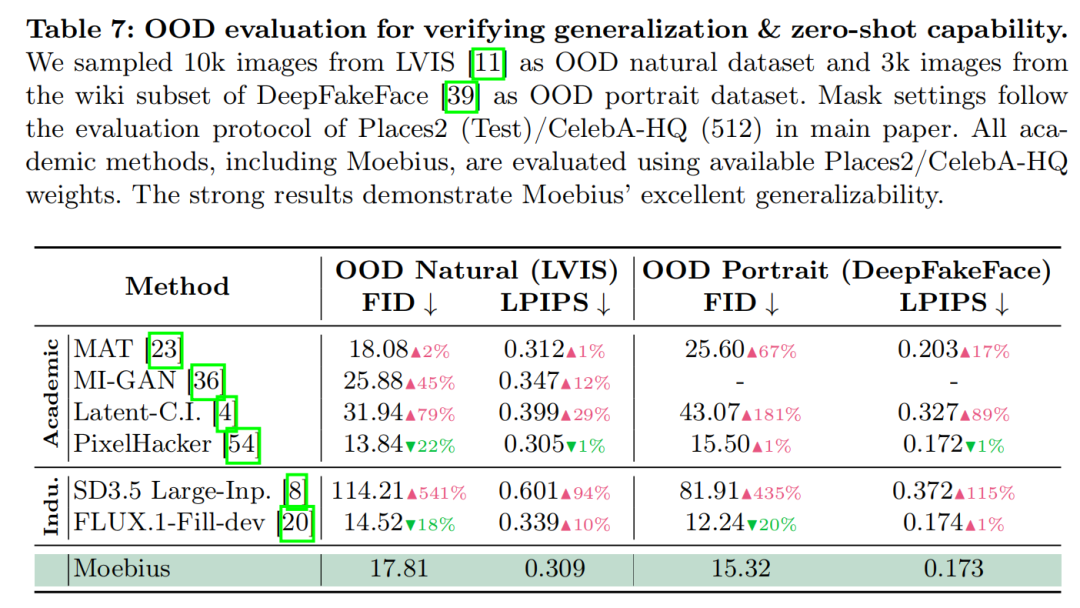
论文还做了 OOD 泛化测试,在 LVIS 自然图像和 DeepFakeFace 人像数据上评估模型零样本能力。结果显示,Moebius 在 OOD 场景中仍然保持较强表现,尤其在人像 OOD 数据上接近甚至略优于 PixelHacker 的部分指标。这说明 Moebius 并不是简单记住训练集模式,而是具备一定泛化能力。
实验结论:Moebius 的成功不是简单压缩,也不是简单蒸馏。它靠的是结构和训练目标之间的精密配合。架构负责让小模型“有能力学”,蒸馏负责让小模型“学到大模型会的东西”。
实验结论:Moebius 的成功不是简单压缩,也不是简单蒸馏。它靠的是结构和训练目标之间的精密配合。架构负责让小模型“有能力学”,蒸馏负责让小模型“学到大模型会的东西”。
四、总结
Moebius 面向高质量图像修复的轻量化部署,把 inpainting 从“依赖 10B 级通用大模型”推进到“0.2B 级任务专家模型”,靠一套结构压缩与能力蒸馏相互配合的机制实现:
它的意义有两点:一是把高质量图像修复的部署成本大幅打了下来——过去依赖 FLUX.1-Fill-Dev、SD3.5 Large-Inpainting 这类 10B 级工业模型的修复能力,被一个 0.22B 参数的专家模型逼近甚至超过,推理速度和显存友好度都大幅提升;二是证明了轻量化不是简单删层、减通道或替换便宜算子,而是要重新设计小模型的信息交互方式,再用蒸馏补回极致压缩带来的容量损失。
实验上,Moebius 在 Places2、CelebA-HQ、FFHQ 等自然与人像修复基准上展现出极强的质量效率平衡。相比 FLUX.1-Fill-Dev,它参数量不到百分之二,总推理时间快十五倍以上,却能在多个指标和用户偏好实验中接近甚至超过 10B 级工业大模型。
原文链接: https://www.leiphone.com/category/private/4sqLbFer8uP15MEv.html
