来源:公众号“AI上分搭子”
原文链接:https://mp.weixin.qq.com/s/26c4oCUgjQueMImEspWBow
In-context segmentation 想做的事情并不复杂。
给一张带标注的参考图,再去目标图里把同一个概念分出来。
这个概念可以是一个物体。也可以是一个部件。甚至可以是某个特定实例。
难点在于,现在主流方法基本都卡在两条路里。
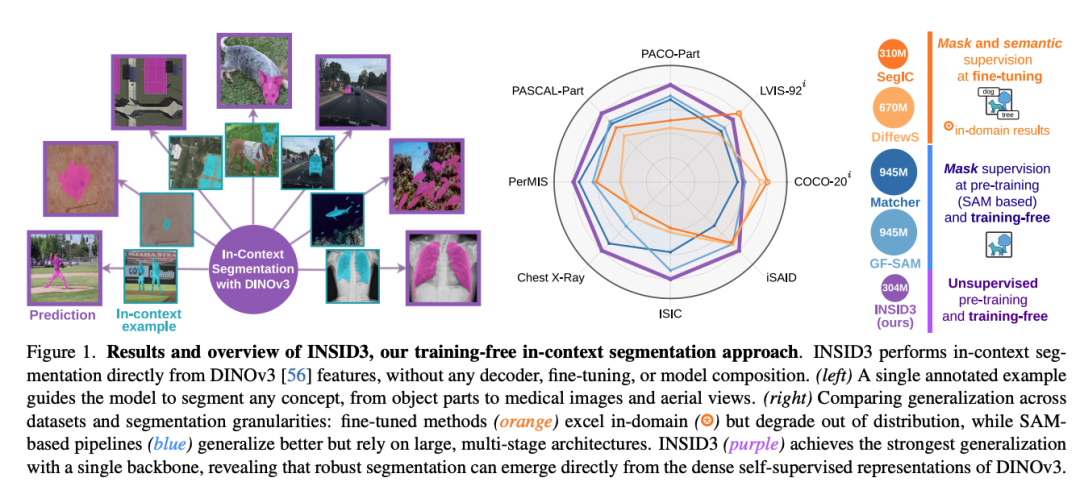
一条路是 fine-tune foundation model,或者额外挂一个 decoder。这样做,in-domain 分数通常会比较高。但一换数据域,或者一换语义粒度,泛化就容易掉。
另一条路是 training-free。常见做法是让 DINO 负责匹配,让 SAM 负责出 mask。这一套的泛化会稳一些,但链路更重,也天然受制于 SAM 的 mask prior。
所以真正的问题其实是:
如果 backbone 本身已经有足够强的 dense self-supervised feature,分割能力能不能直接从表示里长出来?
这正是 INSID3 想回答的事。
它不想再加模块。也不想再做 task-specific training。它想试试看:只靠一个 frozen self-supervised backbone,能不能把 ICS 真正做起来。
INSID3 的关键,不是“再设计一个更复杂的 segmentation head”。
它真正抓住的是 DINOv3 里的两种能力。
第一,DINOv3 的 dense features 已经有很强的局部结构。这意味着,同一物体或部件,本来就很容易在特征空间里聚成比较连贯的区域。
第二,它确实也能做跨图语义匹配。但这里混着一层明显的positional bias。也就是:两个图里相同坐标附近的 patch,哪怕语义不对,也会更容易互相“看上”。
这篇工作的想法很干脆:
先把这层偏置从跨图匹配里拿掉。然后把“跨图语义对得上”和“图内结构也连得上”这两件事放到一起看。
这样一来,单 backbone 也能把 reference-guided segmentation 做出来。
Figure 1 传递的信息很直接:INSID3 不是在某个单一 benchmark 上刷高,而是在不同数据域、不同语义粒度下都能保持住。
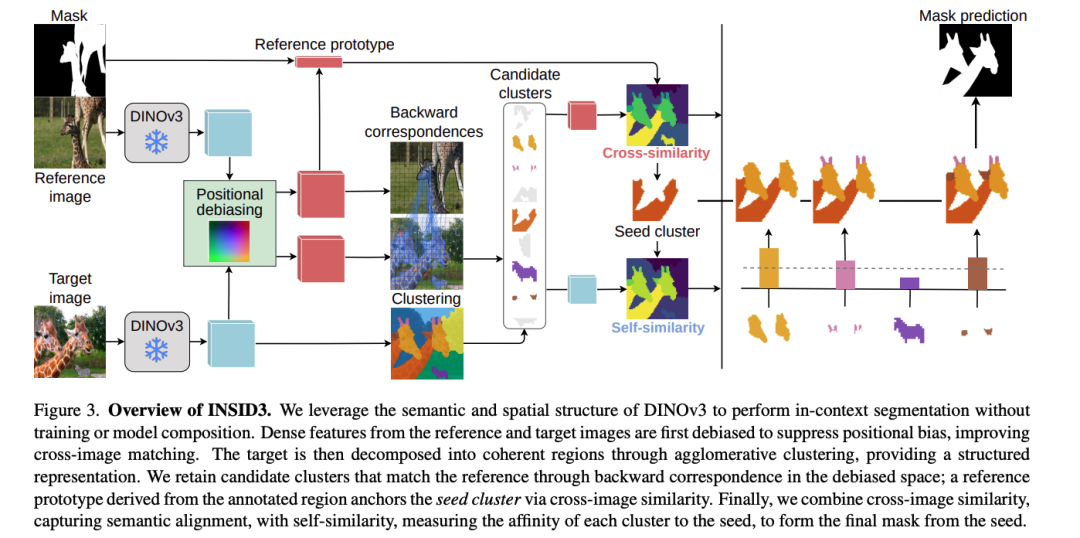
整个方法可以压成三步。
作者先用 DINOv3 特征在目标图里做 agglomerative clustering。
目的不是直接出 mask。而是先把图像拆成一块一块语义上更连贯的区域。
这一步很重要。因为它给后面的匹配提供了更稳定的“候选单元”。
接着,用去偏之后的跨图匹配去找 seed cluster。
你可以把它理解成:在目标图里,先找到和参考区域最对得上的那一小块。
这里用的是 debiased feature space。因为跨图匹配最怕的,恰恰就是坐标偏置把不相关的区域也点亮。
只找到 seed 还不够。很多时候,seed 只会落在最显眼的局部。
比如人的头、长颈鹿的脖子,或者器官里最稳定的那一小块。
所以后面还得再做一步 aggregation。
INSID3 会把图内和 seed 在结构上也贴得近的 cluster 一起并进来。最后得到完整 mask。
整条线最关键的设计,其实就两个:
也正因为这样,它不再依赖 SAM 提供 mask prior,也不需要任何 task-specific supervision。
如果只留两条公式,其实就够了。
这条式子的意思很直接。
先估计一块主要承载绝对位置偏置的子空间。然后把特征投影到它的正交补里。
做完这步之后,跨图匹配更看语义,不容易再被“同一坐标位置”误导。
这里也很好理解。
一个 candidate cluster 只有在两件事都成立时,才应该被并进最终 mask:
INSID3 用乘法把这两个条件绑在一起。
这一步其实就是整篇方法最核心的判断。
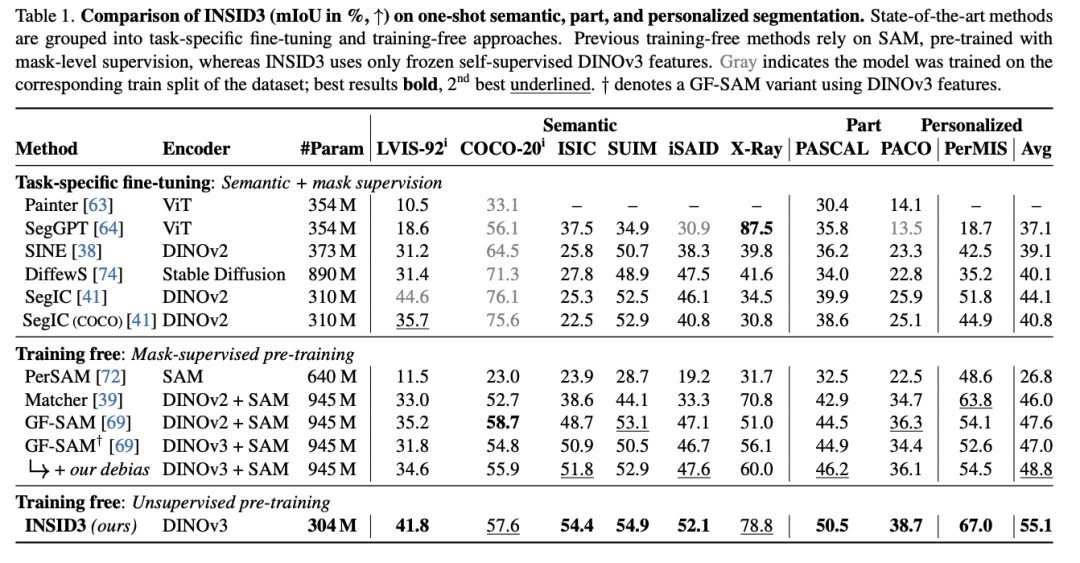
Table 1 是整篇论文最硬的一张表。
因为它不是只看 one-shot semantic segmentation。它把 semantic、part、personalized 三类任务一起放进来了。
这很关键。
因为 INSID3 的价值本来就不在某一个点。它最强的地方,是整体 generalization。
先看平均分。
和最强的 training-free baselineGF-SAM相比,INSID3 的平均 mIoU 从47.6拉到55.1。
就算把 GF-SAM 升级成 DINOv3 版,再加上作者的 debias,平均也只有48.8。
更重要的是,这不是靠更重的结构换来的。
换句话说,它不只是更强,也更轻。
先抓几组关键数字:
再往下看,会更清楚。
如果只盯 COCO-20i 这种更接近训练分布的 benchmark,INSID3 并不是所有格子都第一。这恰好说明,它的追求并不是单个 in-domain 峰值。
真正该看的,是它在不同域、不同粒度上的稳定性。
比如:
这张表还有一个很值得记住的判断。
像 SegIC 这种 fine-tuned 方法,在 COCO-20i 上能到76.1。看上去很强。
但一旦换到别的域,或者 finer granularity,掉得就很快。
INSID3 的强项正好相反。
它追的不是“最熟悉 benchmark 上的最高点”。它追的是:
换域之后,还能不能站住。
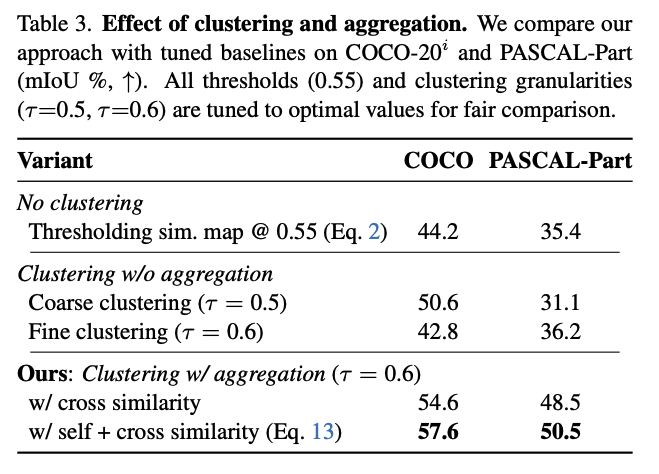
消融部分最好的一点,是它没有停在“完整模型最好”这种结论上。
作者真正拆开去看了两件事:
Table 3 很直白。
如果不做 clustering,只是对 similarity map 直接阈值化,COCO-20i / PASCAL-Part 只有44.2 / 35.4。
如果加了 clustering,但不做 aggregation,问题还是没解决。你还是得在 object-level 和 part-level 之间二选一。
直到把 cross-image similarity 和 intra-image self-similarity 真的合到一起,结果才到57.6 / 50.5。
这说明什么?
INSID3 不是“先找一个最像的局部,再把它当完整 mask”。
真正起作用的,是后面的 aggregation。
只靠 seed cluster 不够。尤其在 part 和 object granularity 不一致的时候,更不够。
还有一个补充点也值得看。
去偏这件事不是装饰项。
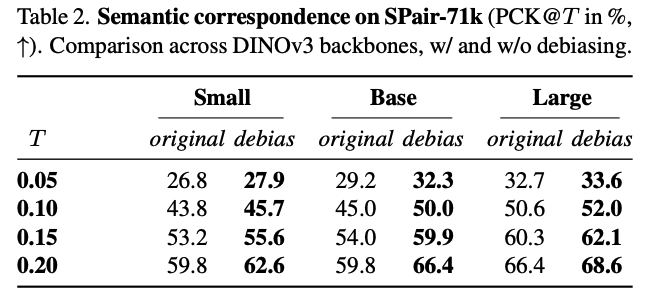
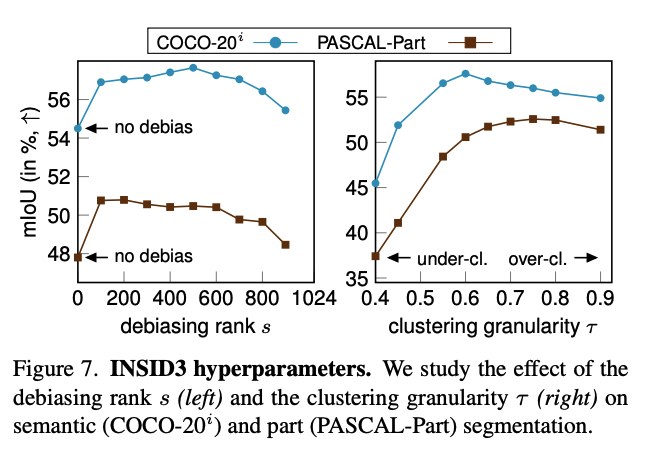
正文和 Table 2、Fig. 7 都在说明这一点。
作者固定 debias rank 之后:
所以这里提出的两个核心部分,其实都有效:
INSID3 真正往前推的,不只是一个新的 training-free segmentation trick。
更重要的是,它把一个原本很像默认共识的假设,硬生生掰开了。
以前大家会默认:
INSID3 说明,事情不一定非得这样。
如果 backbone 的 dense feature 足够强,再把跨图匹配里的 positional bias 处理好,单 backbone 也能把 in-context segmentation 做得很能打。
这不是一句轻飘飘的“training-free 也行”。
它更像是在提醒我们:
self-supervised dense representation 可能已经比很多人以为的更接近分割本身。
代码 / 项目页: