


来源:公众号“EvolGroup“
动机
元黑盒优化(Meta Black-Box Optimization, MetaBBO)是一种新兴且颇具潜力的范式,例如EvoIGroup的早期工作POM/EPOM,它借助元学习来自动配置底层黑盒优化器(多为可学习的进化算法)的参数,避免了传统优化器的手工算子设计,且具备更强的泛化能力。然而,尽管前景广阔,但在面对未知的复杂任务时,MetaBBO的泛化能力仍受到较大限制。我们发现,这一瓶颈主要源于现有训练机制固有的性能上限:由于低层可学习优化器采用自监督或无监督方式从零开始学习,其从未接触过先进且高质量的优化行为,因此最终往往收敛于次优策略。为此,本文提出MetaDistill,一种通用的MetaBBO训练框架,旨在通过预训练和测试时微调来突破策略性能的上限。在预训练阶段,我们将经典算法中的高质量策略提炼为专家优化轨迹,并借助知识蒸馏,使可学习优化器得以学习先进的优化行为。在可选的微调阶段,我们采用自监督微调作为“热启动”(warm-start)过程,在未见过的复杂任务上实现蒸馏策略的高效迁移。我们在BBOB测试集以及若干控制任务上对MetaDistill进行了评估。结果表明,相较于原始训练范式,MetaDistill显著提升了多种可学习优化器的泛化能力。
方法
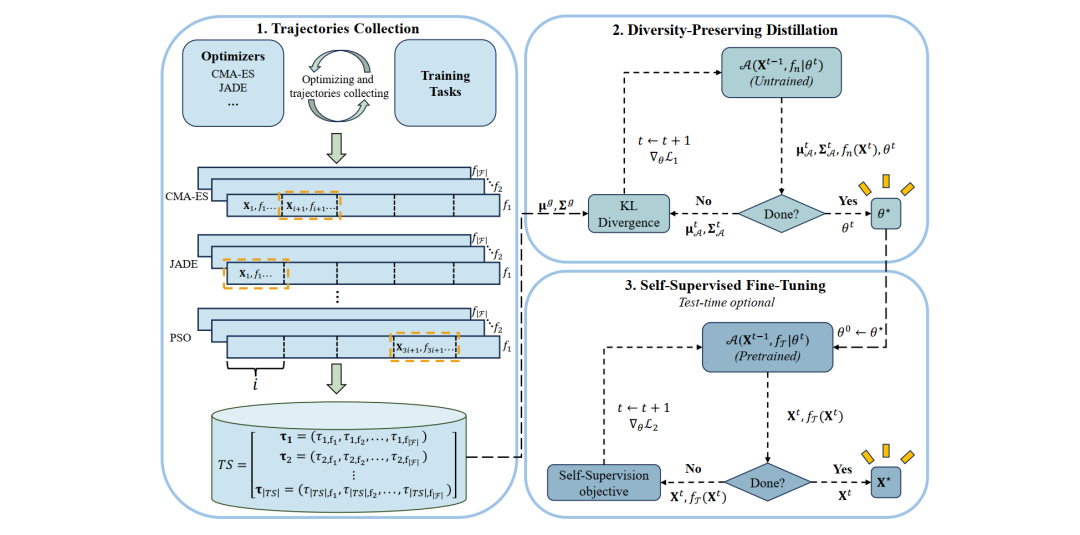
MetaDistill的核心流程包括:(1) Trajectory Collection,在预训练任务集上收集多种经典进化算法的优化策略,并将其提炼、表示为统一的(与具体优化策略无关的)优化轨迹。(2) Diversity-Preserving Distillation (DPD),利用知识蒸馏,在(1)中收集的优化轨迹上训练可学习优化器。 (3) Self-Supervised Fine-Tuning (SSFT, 测试时可选),在(2)的基础上进行热启动,实现蒸馏策略的高效迁移。
Trajectory Collection
为了让低层优化器从高质量优化策略中学习,我们首先需要构建包含大量优化策略的数据集(知识库)。一种很容易想到的方法是:在预训练任务上运行CMA-ES、DE、PSO、GA等经典进化算法,并收集其策略轨迹,例如,CMA-ES(协方差自适应进化策略)和JADE(一种自适应的差分进化)在问题上的策略轨迹可分别表示为:
其中表示最大优化代数。
不过,这种方法存在两个棘手的问题:(1) 策略空间不统一。如果将具体算法的优化策略作为蒸馏目标,则MetaDistill难以进行策略无关(跨策略)的蒸馏训练。例如,基于进化策略的student只能学习Eq. (1)中CMA-ES的策略轨迹,而基于差分进化的student仅能学习其中JADE的轨迹。(2) 策略冗余。同一个问题对应了条策略轨迹(表示teacher数量),但并非所有轨迹都是高质量的,需要一种简单、有效的筛选方法。
针对问题(1),考虑到进化算法在第代的策略实际上已隐含在第代种群中,即:
因此,我们进一步将Eq. (1)中的策略轨迹表示为通用于任意进化算法的种群分布轨迹:
通过Eq. (3)的统一表示,MetaDistill即可在多个teacher和任意student优化器间进行策略无关的蒸馏(multi-teacher, any-student architecture-agnostic distillation)。
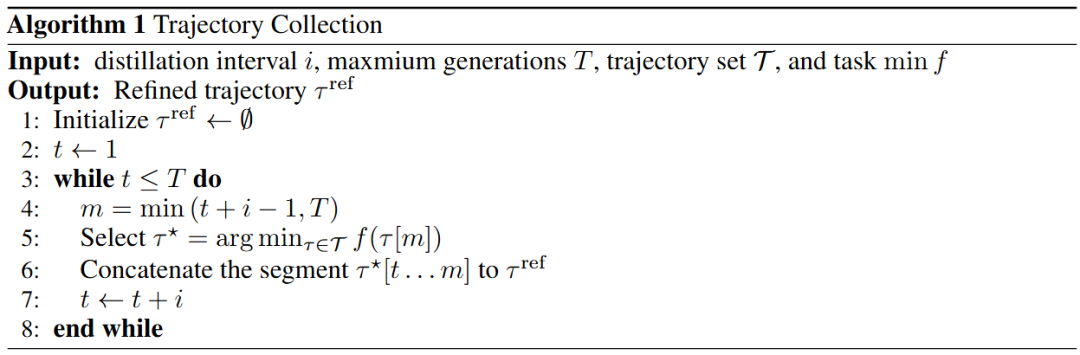
针对问题(2),我们通过基于适应度的轨迹筛选构建精细化的优化轨迹。具体地,给定问题上个算法的种群分布轨迹和蒸馏间隔,详细轨迹筛选过程过程可由以下简洁的伪代码描述。
Diversity-Preserving Distillation
在通过上述轨迹收集方法得到的优化轨迹集上,MetaDistill通过前向KL散度训练student优化器拟合teacher优化器的种群分布:
其中,为可学习优化器,其参数为,表示问题上经过Algorithm 1过滤的teacher轨迹,表示第代student种群的蒸馏目标。使用前向KL散度作为蒸馏目标的优势包括:(1) 不受种群规模限制的训练:分布层面的匹配使MetaDistill能够无缝衔接不同种群规模的教师与学生模型。(2) 超越僵化模仿的泛化:通过蒸馏分布,学生模型能够避免对特定教师种群的点对点拟合,从而更有利于习得更通用的优化策略。 (3) 多样性保持:由于前向KL散度具有覆盖全局分布的特性,学生模型在探索教师密度为零的区域时不会受到惩罚。这有助于学生模型维持种群多样性,而不会坍缩为单一的狭窄模式。
然而,在实践中,student和teacher的分布参数可能存在较大差异(特别是训练初期),直接使用作为训练目标会导致损失震荡和参数更新不稳定。因此,我们使用系数和对进行两阶段缩放,其中, 为问题维度 的平方根的倒数;为student与teacher的均值向量和协方差矩阵的逐元素最大绝对值的倒数。最终的训练目标为:
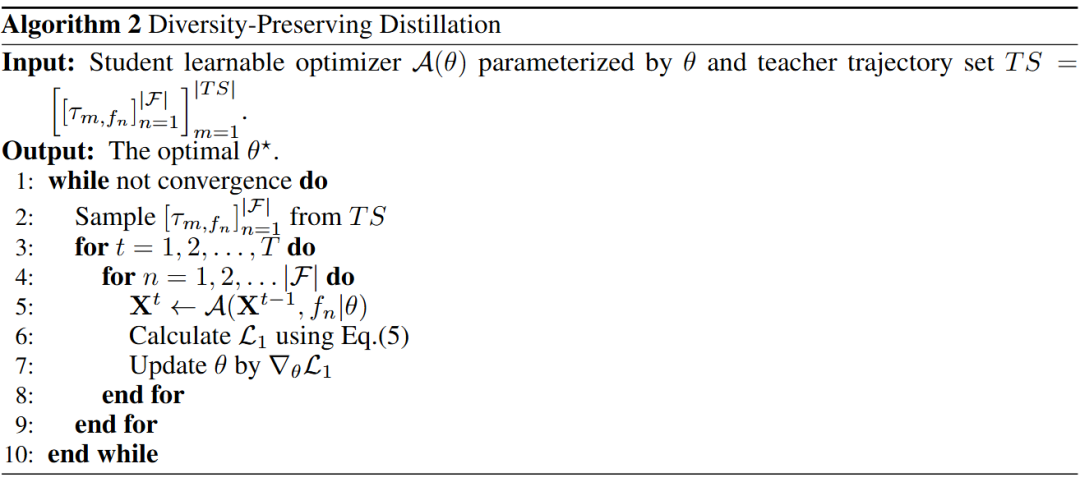
DPD的主要流程可由以下伪代码概括:
Self-Supervised Fine-Tuning
SSFT作为可选阶段,在DPD的基础上进行热启动,实现蒸馏策略在复杂、未见过任务上的快速适配。针对可微目标任务,我们利用如下自监督目标实现低层优化器参数的微调:
对于不可微(黑盒)目标任务,我们无法通过微调优化器参数,但可利用优化器策略本身的可微性构建以下损失函数:
其中,表示当代种群均值,表示精英种群(Elite)均值,可通过在当代进行选择或收集历代top-最优个体等方法构建。
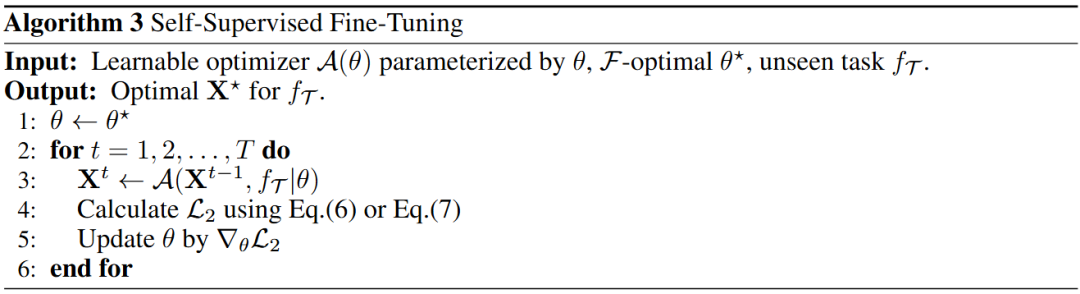
最后,SSFT的主要流程可由伪代码概括如下:
实验
对比实验
在BBOB和LunarLander、BipedalWalker两个控制任务上,MetaDistill训练的POM、LES、LDE和LGA (LGA)四种可学习进化算法变体均显著超越了其各自的原训练框架(Baseline),详细结果分别如下表所示。
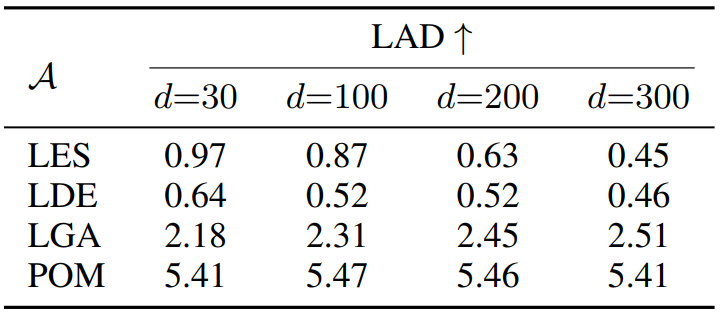
BBOB with problem dimensions set at
BBOB with problem dimensions set at
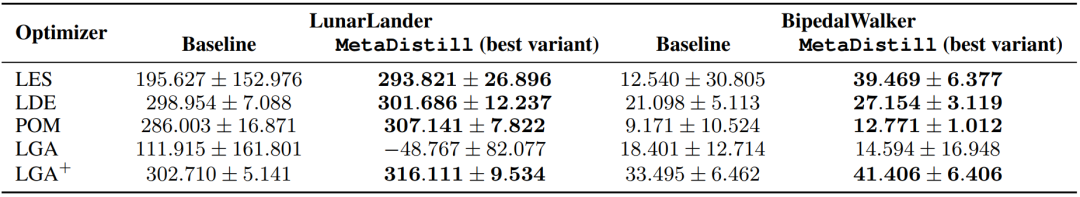
LunarLander and BipedalWalker
LunarLander and BipedalWalker
参数分析
我们分别对teacher优化器和训练任务规模进行了参数分析,结果如下表所示。
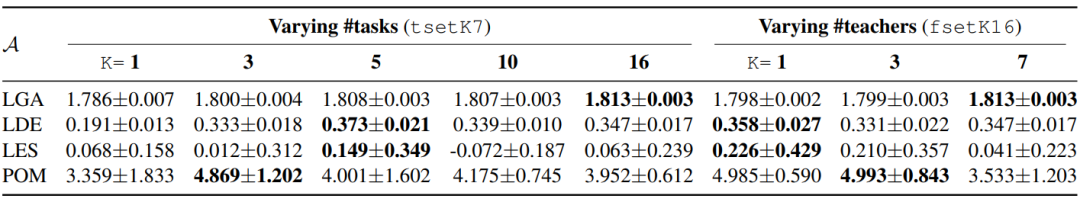
表中的数据表明,teacher优化器、训练任务的规模和student优化器的性能之间并未出现类似Scaling Laws的现象,即并非所有student的性能都能够随着teacher优化器和训练任务的多样性增加。具体地,我们将参数分析中发现的现象总结如下:(1) 增加训练任务对提升student性能的作用有限。增加训练任务数量往往能带来性能提升,但效果因具体student架构而异。例如,LGA的性能随着训练任务的增加而提升,而LDE在5个训练任务时已达到性能饱和。(2) 多样性悖论。 一味增加teacher优化器的多样性可能导致student性能退化。例如,POM在student数量从3增至7时性能出现下降。(3) 最优多样性取决于具体的student架构。例如,LGA在任务多样性较高时表现最佳,LDE倾向于适中的任务多样性,而POM则在任务与教师多样性均处于中等水平时达到峰值性能。LES在低维条件下更偏好任务多样性,而在高维条件下则倾向于单一教师训练。
结论
本文提出了MetaDistill,一个通用且高效的蒸馏训练框架,旨在提升可学习黑盒优化器的性能上限。MetaDistill构建外部知识库作为蒸馏源,并采用Diversity-Preserving Distillation策略,使可学习优化器在多个具有挑战性的基准测试上均取得了显著的性能提升。同时,在测试阶段引入Self-Supervised Fine-Tuning,使MetaDistill的各类变体能够在复杂环境中进一步提升搜索效率和鲁棒性。
尽管如此,仍有若干开放性问题亟待解答。例如,可学习优化器的性能、计算预算、教师优化器的具体设置以及训练任务设置(分配给教师优化器的调优预算、教师优化器与训练任务的多样性等)之间复杂的量化关系值得深入探讨。此外,可学习优化器的自优化也是一个有前景的研究方向。我们将上述课题视为未来工作的重要方向。
原文链接: https://www.leiphone.com/category/private/zhEZMhjkIxco9v3e.html
