


来源:我爱计算机
原文链接:https://mp\.weixin\.qq\.com/s/QaJ\-STPtVDLPX\-4j\-1UuCg?scene=1
在复杂现实场景下的半监督视频目标分割(Semi-supervised Video Object Segmentation, VOS)任务中,严重遮挡、目标频繁消失与重现、微小尺度以及密集同类干扰物等极端情况,长期困扰着现有的视觉模型。尽管以 SAM3 为代表的视觉大模型具备强大的通用提示分割与时序记忆传播能力,但在单一推理路径下,面对极端微小目标或高度依赖高阶语义区分的目标时,仍容易发生跟踪丢失或身份漂移。
为此,来自哈尔滨工业大学(深圳)、南洋理工大学以及深圳河套研究院的研究团队提出了 VOS-Agent(Video Object Segmentation Agent,视频目标分割智能体框架)。该框架采用“分而治之”的模块化协同策略,保留 SAM3 作为底层统一的密集像素级掩码生成器,并基于感知路由机制按需激活针对微小目标的单目标跟踪专家(SUTrack)以及针对语义歧义目标的多模态大模型专家(Qwen3.5-397B-A17B)。在 ECCV 2026 第 8 届 LSVOS 挑战赛(The 8th LSVOS Challenge)的 MOSEv2 复杂赛道中,VOS-Agent 以 69.82% 的 综合成绩斩获 全球冠军。
背景与动机:单一推理路径的异质失效
半监督视频目标分割旨在给定视频首帧目标掩码的前提下,预测其在后续所有视频帧中的精确像素掩码。随着 MOSE 及更具挑战性的 MOSEv2 基准的提出,评测重心从传统孤立清晰物体的跟踪转向了极端复杂的非受限真实场景。
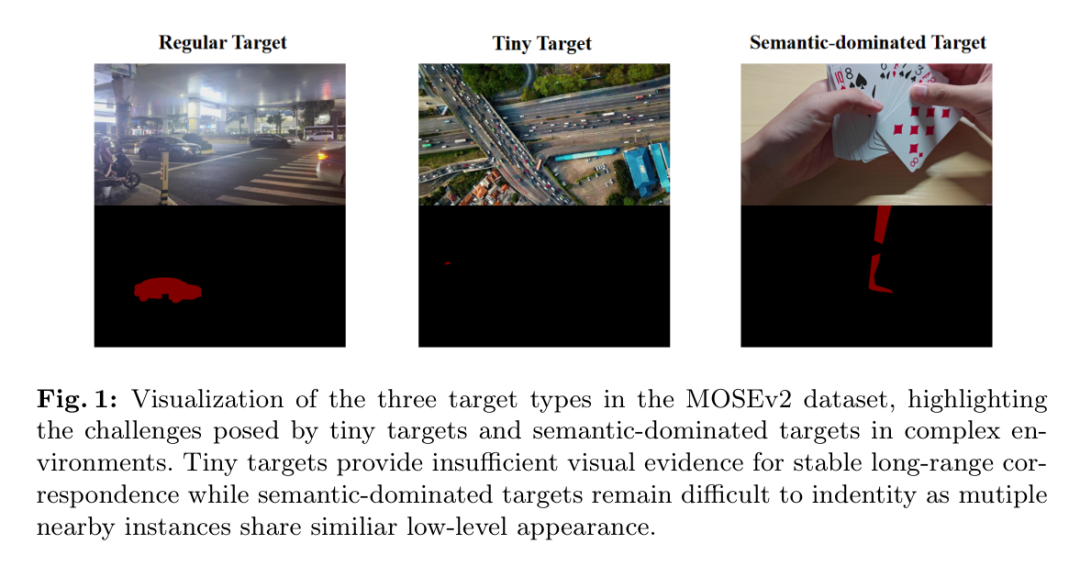
研究团队深入分析了现有代表性方案(如 SAM3)在 MOSEv2 上的瓶颈,发现复杂的视频目标分割存在两类异质失效模式(Heterogeneous Failure Modes,见图 1):
这两种失效现象的根源在于:SAM3 等模型主要依赖视觉特征与时序记忆进行传播。当目标分辨率极低或外观视觉极度模糊时,模型缺乏足够的信息来判定“目标在哪里”或“应当保留哪一个实例”。
方法详解:VOS-Agent 多智能体协同架构
针对上述问题,VOS-Agent 构建了一套无需额外参数微调(Training-free)的任务导向型多智能体协同推理系统。系统由四个核心智能体组成:目标感知与路由智能体(Target Perception and Routing Agent)、SAM3 分割智能体(SAM3 Segmentation Agent)、视觉跟踪智能体(Visual Tracking Agent)以及多模态语义智能体(Semantic Agent)。
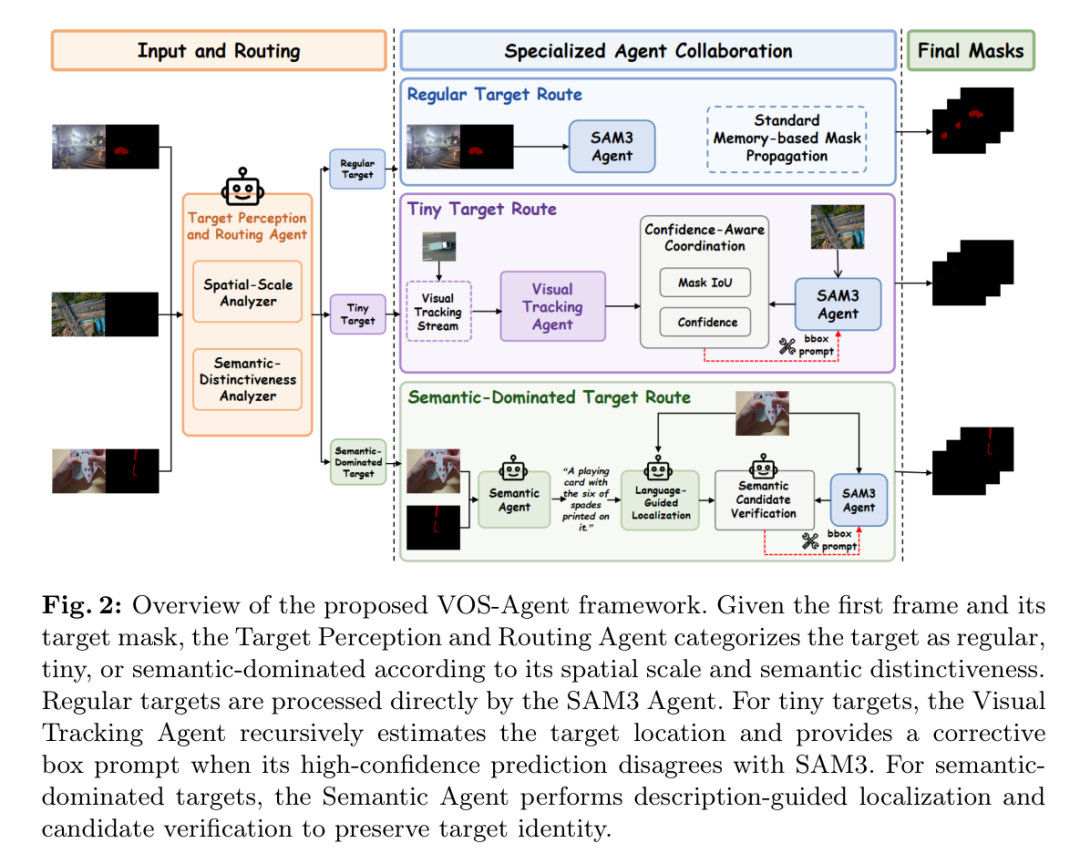
1. 目标感知与路由智能体(Target Perception and Routing Agent)
在接收到首帧图像 与初始目标掩码 后,路由智能体首先对目标进行两项正交维度的分析:
最终将输入序列分配到三条专门处理路径之一:tiny(微小)、semantic(语义主导)或 regular(常规)。
2. SAM3 分割智能体(SAM3 Segmentation Agent)
SAM3 Agent 作为全流程共享的密集像素掩码生成与时序记忆传播底座。对于常规目标,SAM3 依靠自身的视频记忆库(Memory Bank)执行端到端连续传播;而对于微小与语义主导目标,SAM3 仅在接收到专家智能体的高置信度纠偏边界框提示(Box Prompt)时更新当前帧掩码及记忆状态。
3. 微小目标协同:视觉跟踪智能体(SUTrack)
微小目标更契合单目标跟踪(SOT)中基于模板与局部搜索区域的定位机制。团队选用 SUTrack 作为视觉跟踪专家:
4. 语义主导目标协同:多模态语义智能体(Qwen3.5-397B-A17B)
对于外观高度混淆的实例,团队引入多模态大模型进行身份级判别推理:
实验与结果:斩获 LSVOS 竞赛冠军
MOSEv2 数据集包含 5,024 个视频片段、超 10,000 个标注对象以及超过 70.1 万张高质量掩码,涵盖了频繁消失重现、密集同类遮挡等极端挑战。
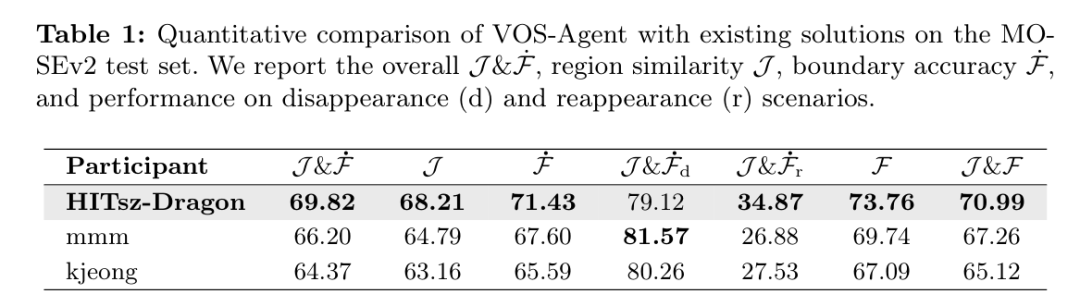
如表 1 所示,在第 8 届 LSVOS 挑战赛 MOSEv2 赛道测试集上,团队(参赛队伍名:HITsz-Dragon)提交的 VOS-Agent 以 69.82% 的 综合得分夺得第 1 名,超出第二名 3.62 个百分点。在最具挑战性的目标重现子场景()下,VOS-Agent 取得了 34.87% 的成绩,相较于第二名(26.88%)领先幅度接近 8 个百分点。
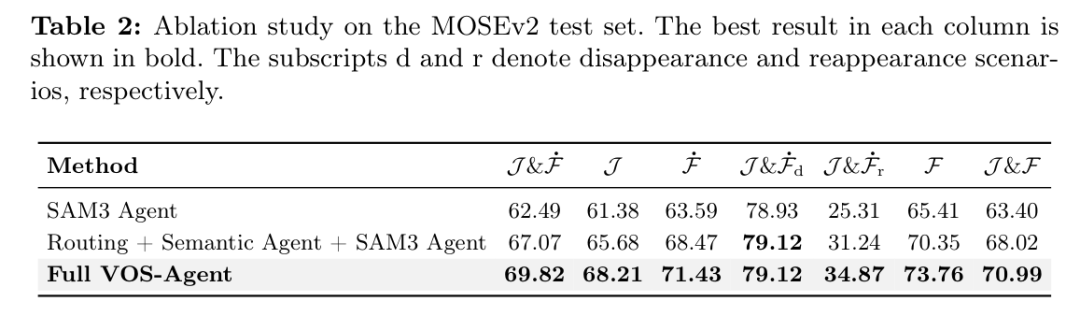
从表 2 的消融实验数据可以观察到:
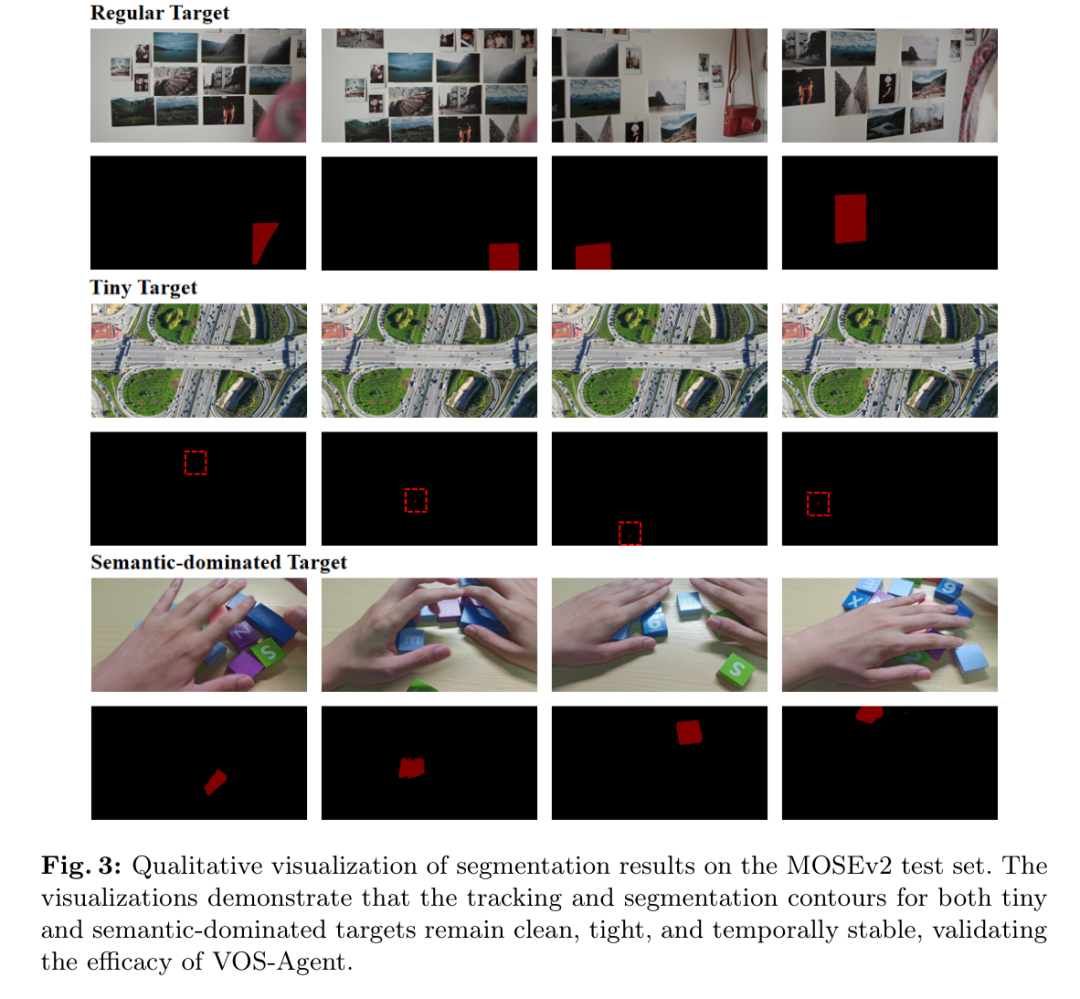
图 3 的定性可视化结果表明,在微小物体穿梭及相似同类并行的复杂场景中,VOS-Agent 均能输出边缘紧致、时序连贯且无身份漂移的高质量掩码。
写在最后
VOS-Agent 提供了一种清晰且极具工程实效的解题思路:面对非受限复杂环境中的多样化失效模式,单一主干网络往往难以兼顾所有场景。通过“路由分流 + 领域专家定位/判别 + 基础大模型密集掩码生成”的多智能体协同范式,既保留了基础视觉模型的泛化能力,又有效攻克了极小目标与语义混淆两大长尾痛点,为视频理解与分割系统的构建提供了有益参考。
原文链接: https://www.leiphone.com/category/private/o9zzm5gBQlGs0jDb.html
