


来源:公众号HKBU计算机系
原文链接:https://mp\.weixin\.qq\.com/s/jPIQO5Xuo1pvZ\_xWOk6rcw?scene=1
香港浸会大学计算机系博士生宋奇、博士后研究员罗梓源、博士生韩昊亮与导师万人杰教授的最新研究成果 “Generating Multi-view Adversarial Examples for Visual Geometry Grounded Transformer” 已被 ECCV 2026 接收并入选Oral环节。该工作提出 MVAP-G,首次面向视觉几何基础 Transformer 构建实时、跨视角一致的生成式对抗攻击。欧洲计算机视觉会议(European Conference on Computer Vision,ECCV)是计算机视觉领域的顶级学术会议。本项研究聚焦快速发展的 3D 基础模型安全问题:当统一处理多视角图像、深度、相机位姿与点云重建的模型进入真实应用后,肉眼难以察觉的输入扰动是否会系统性破坏其几何推理能力?
背景和动机
视觉几何基础 Transformer(Visual Geometry Grounded Transformer,VGGT)能够从多视角图像中一次前向推理完成统一的三维重建。然而,高性能也伴随着新的安全风险。传统对抗扰动需要针对每个场景反复优化,计算成本高;通用对抗扰动只使用一张固定噪声图案,又难以适应多视角场景中复杂的几何变化。为解决这两个问题,本文提出多视角对抗扰动生成器 MVAP-G:它直接读取一组多视角图像,通过一次前向传播生成视觉上难以察觉、且在不同视角之间保持一致的扰动,无需在测试阶段进行迭代优化。实验表明,MVAP-G 能够显著破坏 VGGT 的点云、深度与相机位姿输出,并在实时性、显存开销和跨场景泛化方面展现出明显优势。近年来,VGGT 将三维重建、定位、跟踪等多项几何任务统一到一个前馈模型中,为机器人、自动驾驶和空间智能等应用提供了高效基础。但现有对抗攻击在多视角场景中存在明显矛盾:逐场景优化的 AP 攻击虽然有效,却要为每组新输入运行多轮梯度更新;“一张扰动适配所有输入”的 UAP 更高效,却无法根据场景内容和视角关系进行动态调整,因此难以稳定攻击 VGGT。
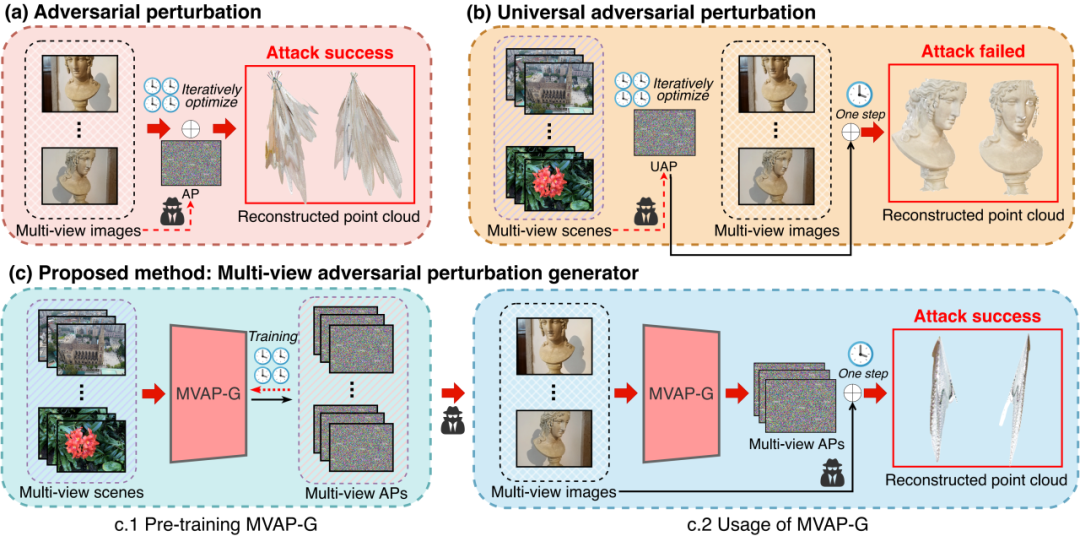
图 1:传统 AP、通用 UAP 与 MVAP-G 的对比。MVAP-G 在测试时只需一次前向推理,即可生成面向当前多视角场景的扰动。
关键挑战并不是简单地给每张图片叠加噪声,而是让多张图像中的扰动同时满足两点:一方面,扰动需要足够隐蔽;另一方面,它们必须理解并利用不同视角之间的对应关系,从而在 VGGT 融合多视角几何信息时仍能持续产生破坏。基于这一观察,本文将攻击过程从“为每个场景优化一组像素”转化为“学习一个能理解多视角场景的扰动生成器”。
方法概述
MVAP-G 以 Transformer 为主体,将每个视角切分为图像块并编码为特征序列,同时加入可学习的相机嵌入。其核心模块是跨视角对抗对齐 (Cross-view Adversarial Alignment,CAA):模型在每个视角内部执行自注意力,并在不同视角之间执行交叉注意力,使每张图像的扰动都能够参考其他视角的内容。随后,DPT 解码头融合多层特征并恢复到像素分辨率,为每个视角输出对应的对抗扰动。
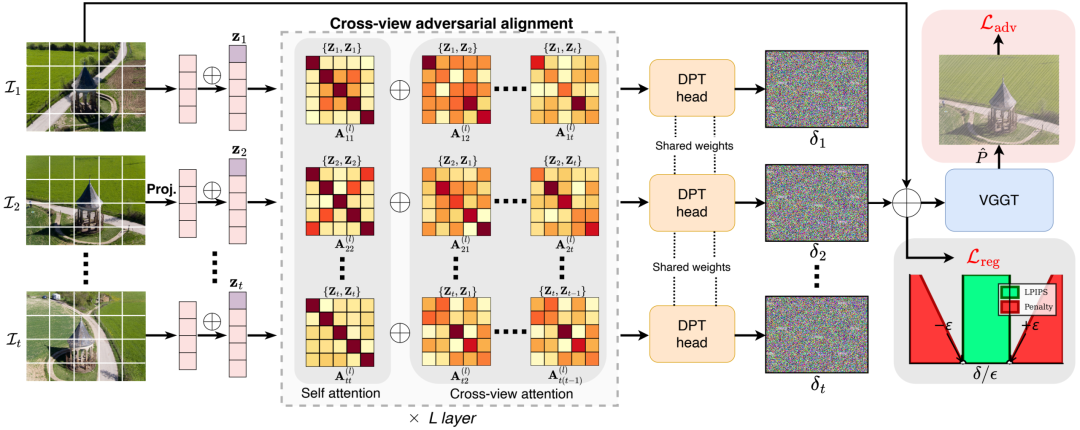
图 2:MVAP-G 整体框架。CAA 在多个视角之间交换信息,DPT 头生成像素级扰动,并通过攻击损失与正则项联合训练。
跨视角对抗对齐
CAA 同时建模同一视角内的纹理结构和不同视角之间的几何联系。随着输入视角增加,缺少 CAA 的生成器会产生彼此不协调的扰动,VGGT 可以利用多视角融合部分恢复原始几何;加入 CAA 后,攻击强度能够在更多视角输入下保持稳定,并利用额外视角进一步增强破坏效果。
攻击目标与扰动约束
训练时,MVAP-G 将添加扰动后的多视角序列送入冻结的 VGGT,并以输出点云为主要攻击目标,使三维点逐步向坐标原点塌缩。与此同时,正则化损失联合使用 LPIPS 感知距离和 ℓ∞ 幅度约束,控制扰动的视觉可见性。最终目标在攻击强度与图像质量之间取得平衡:输入图像几乎不变,但模型恢复出的三维结构发生严重偏移或坍塌。
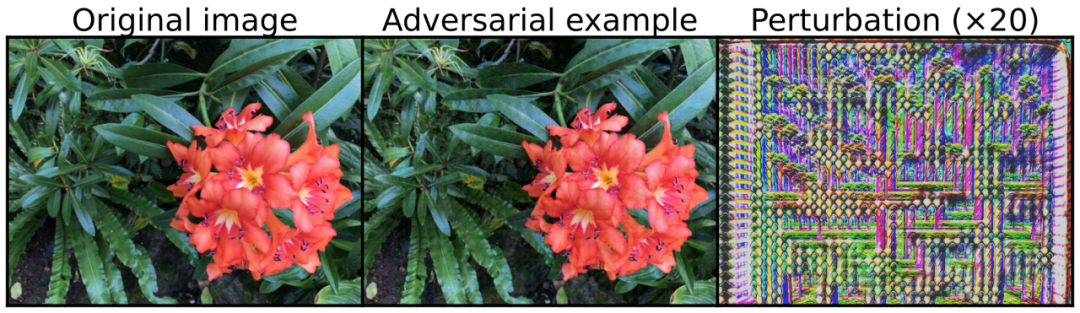
图 3:原始图像、对抗样本与放大 20 倍后的扰动。实际对抗样本与原图在视觉上高度接近。
两阶段训练策略
为降低多视角训练成本,作者首先在 COCO 单视角图像上进行预训练,让生成器学习 VGGT 的通用对抗脆弱性;随后在 CO3Dv2、BlendMVS、ScanNet、Virtual KITTI、DTU、ETH3D 和 FlyingThings3D 等七个数据集上进行多视角微调。训练时随机采样每个场景的 2 至 10 帧,使模型同时覆盖室内、室外、真实与合成数据。
主要实验结果
实验覆盖 COCO、ImageNet、LLFF 与 CO3D,并比较高斯噪声、UAP、迭代 10 次和 20 次的传统 AP。评价指标为干净输入与受攻击输入所产生点云之间的 Shifted Chamfer Distance(CD),数值越高表示攻击造成的几何偏移越严重。MVAP-G 仅使用一次前向推理,就在 12 组测试设置中的 11 组取得最佳结果;例如在 CO3D 的 25 视角输入中,MVAP-G 的 CD 达到 2.047,高于 AP(20 次迭代)的 2.000 和 UAP 的 0.659。
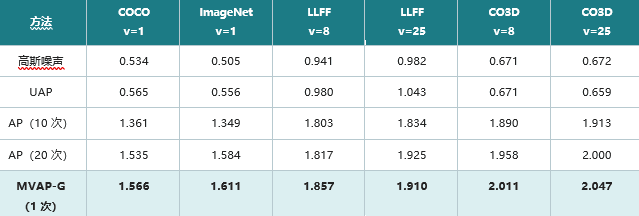
表 1:不同扰动方法对 VGGT 的攻击效果(Shifted CD ↑)。表中选取代表性视角数量。
定性结果
从可视化结果看,高斯噪声与 UAP 对重建结构影响有限;迭代 AP 能够破坏点云,但需要为当前场景反复优化。MVAP-G 生成的输入图像仍保持自然观感,而重建点云出现明显拉伸、错位与塌缩。在八视角场景中,MVAP-G 通过一次前向传播即可产生与强迭代攻击相当或更明显的几何破坏。
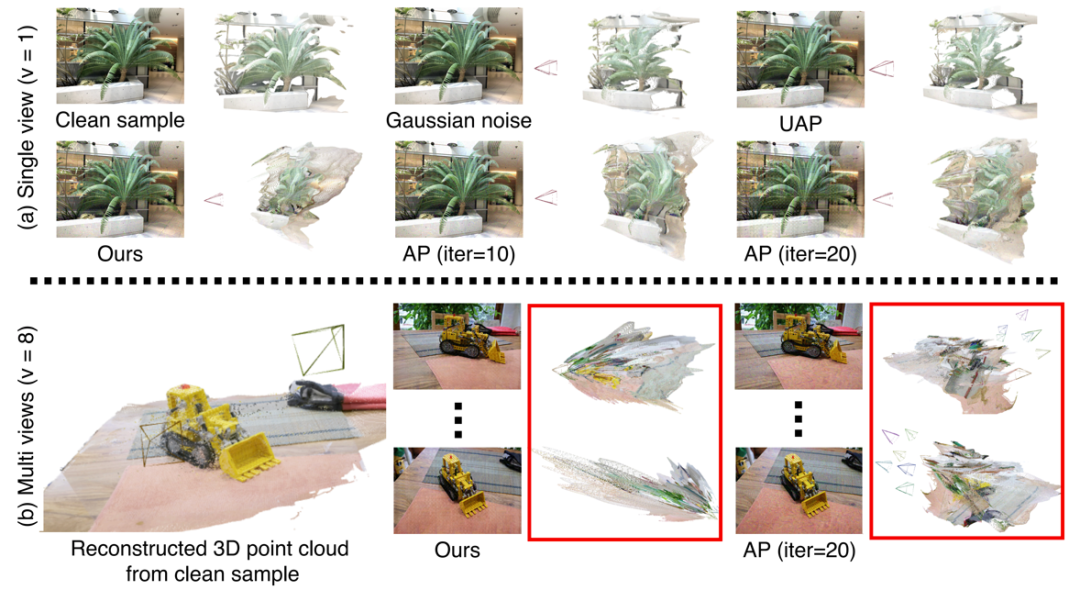
图 4:VGGT 在不同攻击下的三维点云重建结果。上:单视角比较;下:八视角场景中的 MVAP-G 与 20 次迭代 AP。
实时性与显存效率
传统 AP 的逐场景优化需要约 25 至 200 秒,并随着视角数量增加带来显著时间和显存开销。MVAP-G 将这一过程压缩为一次前向传播,多视角输入下的推理时间约为 50 至 500 毫秒;峰值显存低于 14 GB,而传统 AP 在高视角数量下接近 30 GB。这意味着攻击可以跟随动态场景实时生成,而无需预先知道测试图像。
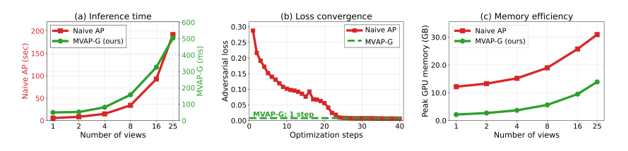
图 5:推理时间、损失收敛与峰值显存对比。MVAP-G 以一次前向推理实现毫秒级、多视角攻击。
跨任务影响
虽然 MVAP-G 只使用点云损失进行训练,攻击仍会沿着 VGGT 的共享几何骨干传播到其他输出。CO3D 八视角测试中,相机旋转误差由 2.3° 增至 44.4°,归一化平移误差由 0.05 增至 0.43,焦距偏移达到 18.7 像素;深度预测也出现明显结构性失真。这一结果说明,多视角 3D 基础模型的共享表示可能形成跨任务的共同脆弱点。
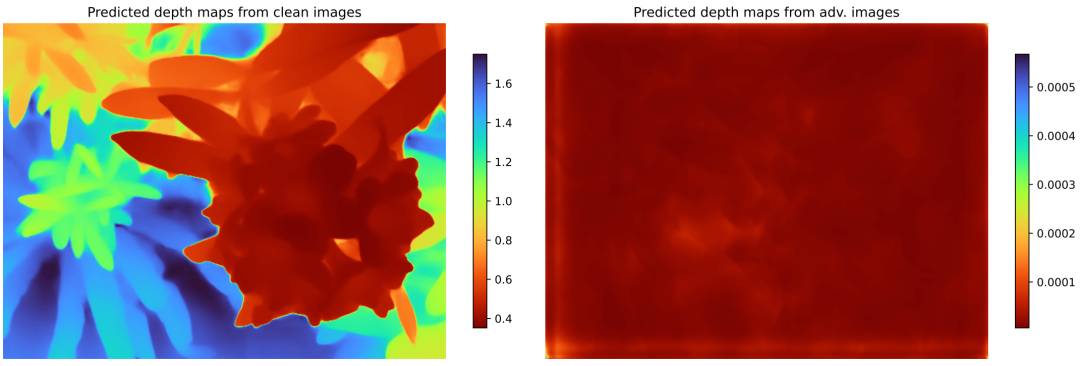
图 6:同一 MVAP-G 模型对 VGGT 深度输出的影响。模型训练时仅以点云为攻击目标。
消融实验
消融结果显示,单视角预训练为攻击强度带来最大幅度提升,DPT 头进一步增强像素级扰动表达能力;CAA 的优势随着输入视角数量增加而更加明显。加入正则化损失后,PSNR 从 20.3 dB 提升到 29.8 dB,LPIPS 从 0.512 降至 0.107,同时 CD 由 1.75 提升到 1.78,说明扰动可见性得到显著控制,而攻击能力没有被削弱。
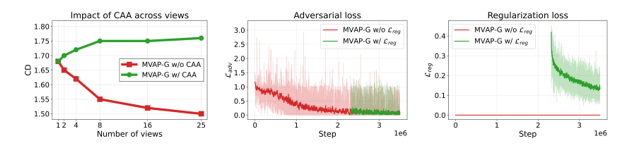
图 7:CAA、攻击损失与正则化损失分析。CAA 尤其有利于视角数量增加时维持攻击强度。
总结
本文提出 MVAP-G,将多视角 3D 基础模型的对抗攻击从高成本的逐场景迭代优化,推进为可泛化的一次前向生成。通过跨视角对抗对齐、DPT 像素级解码以及动态扰动正则化,MVAP-G 在不可感知性、攻击强度和运行效率之间取得了有效平衡。更重要的是,实验揭示了 VGGT 在点云、深度和相机位姿等多种输出上的系统性安全风险,为后续研究 3D 基础模型的鲁棒训练、攻击检测与安全部署提供了新的问题设定和实验基线。
作 者 简 介
宋奇
香港浸会大学计算机科学系博士生。
罗梓源
香港浸会大学计算机科学系博士后。
韩昊亮
香港浸会大学计算机科学系博士生。
万人杰
香港浸会大学计算机科学系助理教授。
原文链接: https://www.leiphone.com/category/private/8jljOeJCtwwC29QJ.html
