


来源:3DCV
原文链接:https://mp.weixin.qq.com/s/Ba6RgK1gjOQsi6BQuM4hLw
- 西安交通大学人机混合增强智能全国重点实验室 × 江苏细胞壁智能科技有限公司联合团队的最新工作 ChunkFlow 被机器人领域旗舰会议 IROS 2026 接收。该工作直击 VLA 模型分块执行(action chunking)中的时序不连续问题,提出"接缝感知"的训练-执行一体化框架:LIBERO-Long 成功率 93.4% ,单步推理延迟仅 4.43 ms,真机任务 9/10* 成功。
一、问题:Chunk 拼起来的动作,为什么会"抖"?
当前主流 VLA(Vision-Language-Action)模型为了满足实时控制需求,普遍采用动作分块(action chunking)输出头:每次推理不预测单步动作,而是一次吐出一段短动作序列(chunk)。这种设计摊薄了推理成本,是 OpenVLA、GR-2、Octo 等模型的标配。
但它带来一个被长期低估的失效模式——边界抖动(boundary jitter)。相邻两个 chunk 是在略有偏移的观测和历史下分别预测的,重叠区域的动作往往互相"打架":轨迹在 chunk 交界处出现速度、加速度尖峰,轻则动作不连贯,重则直接导致任务失败。
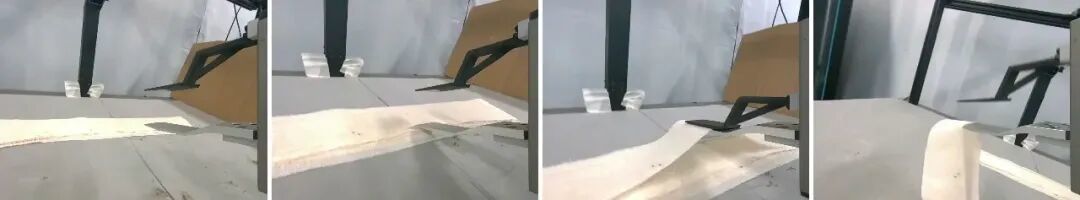
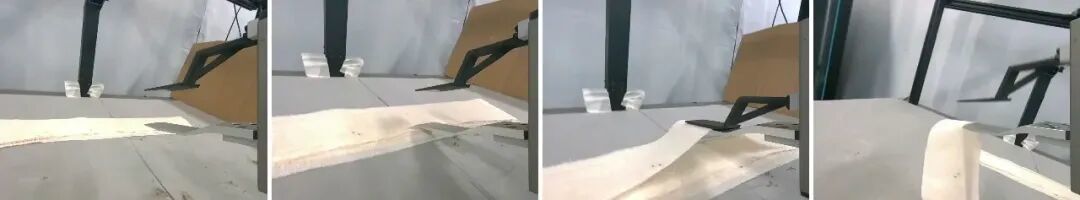
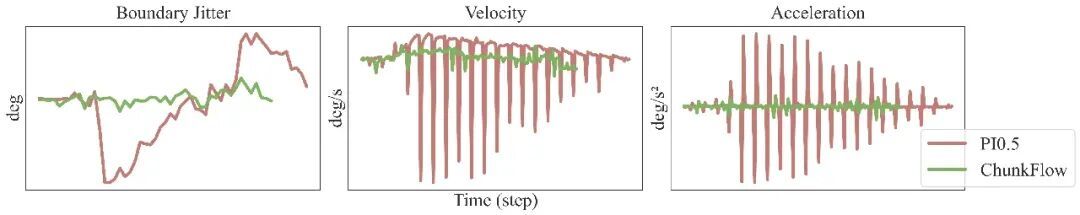
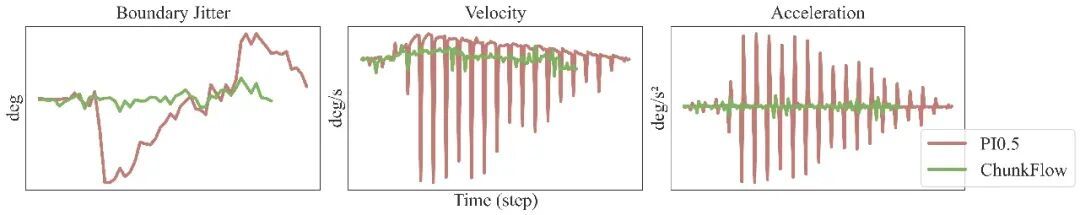 布条抓取任务真机部署。下图为末端 roll 角前 200 步的一阶/二阶/三阶差分曲线,ChunkFlow(对比 PI0.5)显著抑制了 chunk 边界处的尖峰和高频毛刺。
现有的缓解手段基本停留在推理时打补丁:比如 RTC 在推理阶段对接缝做在线插值平滑。但插值只是对两个"互相矛盾"的预测重新加权,并没有修正预测本身的错误——在历史信息有噪声或偏差时,误差会持续累积。更根本的问题在于,主流 VLA 训练管线对 chunk 施加均匀的逐步损失,训练阶段完全没有接缝监督,模型从未学过"如何让相邻 chunk 彼此对齐"。
这就引出了本文的核心问题:能否让策略在训练时就内化"可拼接"的结构,而不是执行时再缝缝补补?
二、方法:ChunkFlow 的三板斧
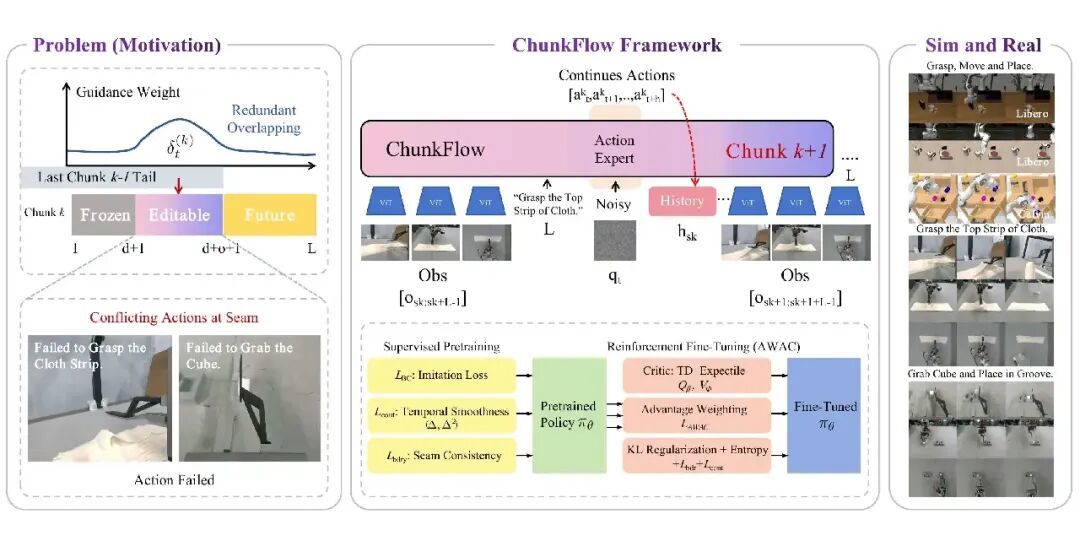 ChunkFlow 框架总览。每个 chunk 被划分为 frozen(已提交)、editable(可编辑接缝)、future(未来)三个语义区段,训练融合连续性正则与强化微调。
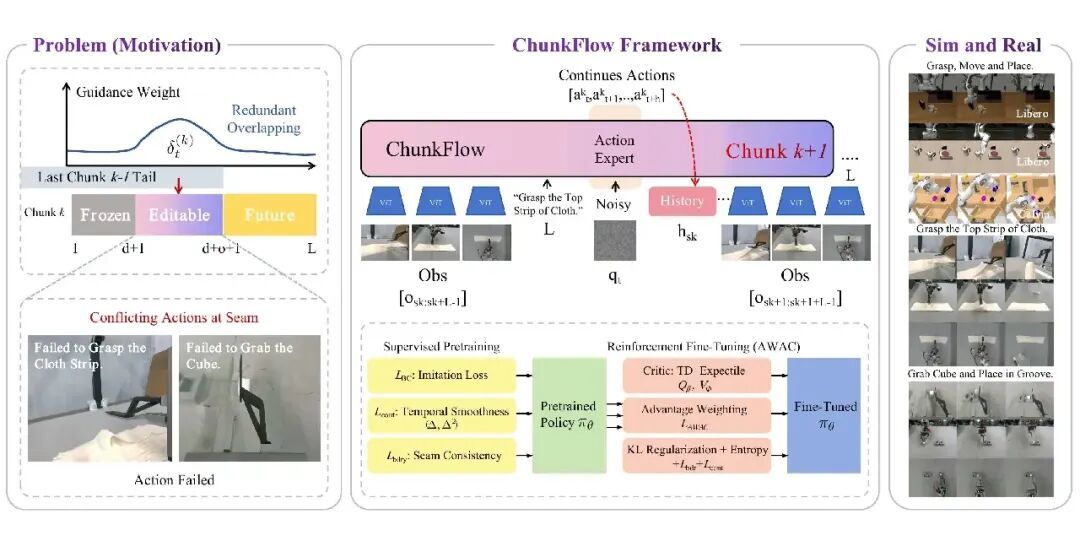
ChunkFlow 是一个"接缝感知"(seam-aware)的分块策略训练与执行框架,由三个相互耦合的组件构成。
① 结构对齐的重叠融合:零延迟的确定性拼接
ChunkFlow 首先给 chunk 引入执行语义:每个长度为 L 的 chunk 被划分为三个区段——frozen(因延迟/执行已提交的前缀)、editable(与上一 chunk 重叠、可融合的接缝区,长度 O)、future(本次预测但下轮才执行的后缀)。
在重叠区,相邻 chunk 的预测通过线性权重做确定性融合——无参数、无需额外的一次策略前向,每步开销仅 O(d) 次浮点运算,因此完全不增加推理延迟。与推理时才平滑的方法不同,这个重叠结构在训练阶段就被暴露给模型:一个作用在融合前原始预测上的接缝一致性损失(boundary loss),直接惩罚相邻 chunk 在重叠区的分歧,让"对齐"成为策略自身的能力而非事后修补。
理论上,团队证明了在策略局部 Lipschitz 连续等温和假设下,接缝误差的期望满足 **O((L−O)²)**——重叠长度 O 越大,边界失配以二次速率被压制,与消融实验观测一致。
② 连续性正则的策略优化:从源头抑制高频噪声
在监督训练阶段,ChunkFlow 在行为克隆损失之外叠加一阶(总变差)与二阶(曲率/jerk)时序连续性惩罚,从源头抑制轨迹的高频不稳定分量。
同时,考虑到策略以最近 p 步动作历史为条件,而部署时历史必然带噪,训练中引入随机历史腐蚀(高斯扰动 + 随机置零)与scheduled sampling,模拟不完美 rollout、降低暴露偏差(exposure bias)。理论分析给出:在连续性正则诱导收缩率 ρ<1 的条件下,长程累积偏差有 L_π/(1−ρ)·T·ε 的上界,将局部正则与长时程稳定性联系了起来。
③ 保结构的优势加权微调:让 RL 不破坏接缝
模仿学习受限于示教数据的覆盖度。ChunkFlow 引入基于 AWAC + expectile critic 的强化微调阶段:critic 在实际执行的(融合后)动作历史上估计优势,用截断的指数权重放大高优势动作;同时全程保留接缝损失与连续性正则(配合 stop-gradient 避免跨 chunk 循环依赖),再辅以 KL 约束与熵正则稳定更新。
消融显示这一步至关重要:不带连续性约束的裸 AWAC 虽能降低频谱噪声,但无法修复边界失配;而带约束的 Safe RL-FT 将 CALVIN 成功长度从 4.10 拉回 4.30,HF_ratio 从 1.000 降到 0.431。
三、实验:成功率与平滑度可以兼得
CALVIN ABC-D:最优的成功-平滑权衡
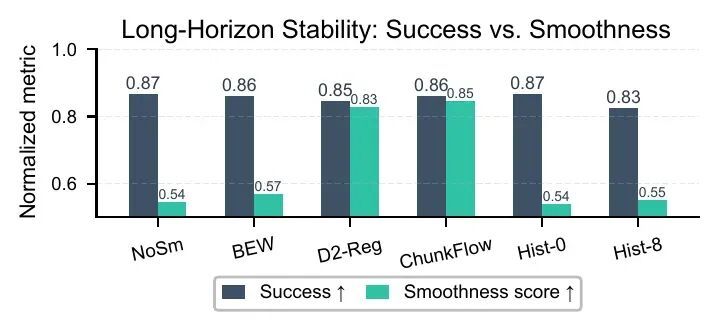
对比经典 BC/RL、扩散/流策略与自回归 VLA 三类方法,ChunkFlow 取得平均任务序列长度 4.30,同时拿下一阶/二阶动作平滑度(MSD-Δa=0.075 / MSD-Δ²a=0.154)、接缝跳变 Bjump(0.209)、高频能量占比 HF_ratio(0.431)和 TV-L1(0.001)等多项指标最优。
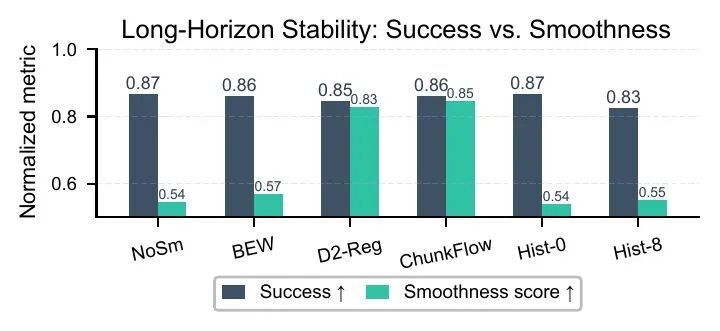 归一化成功率 vs. 平滑度。ChunkFlow 位于 Pareto 前沿。
LIBERO-Long:93.4% 成功率 + 4.43 ms 延迟
跨数据集泛化实验中,ChunkFlow 达到 93.4% 长程成功率,超过 PI0.5(92.6%)、OpenVLA(53.7%)等强基线,且所有平滑度指标同时最优。
这里有个耐人寻味的对照:PI0.5-RTC 用推理时融合确实降低了边界伪影,但成功率反而从 92.6% 跌到 83.7%——印证了本文核心假设:推理时平滑无法修复接缝处错位的预测,只会让偏差继续累积。而 ChunkFlow 因为融合是免费的确定性操作、推理均摊在重叠 chunk 上,平均动作推理延迟仅 4.43 ms,约为 RTC(18.47 ms)的 1/4。
真机部署:布条抓取 + 积木插装
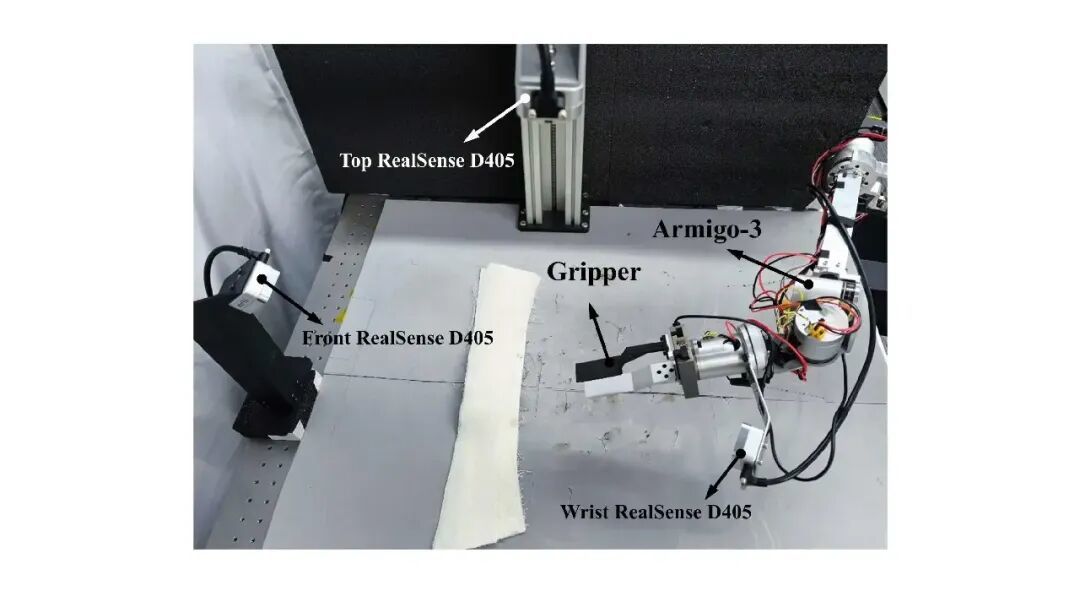 自研 6 自由度协作臂 Armigo-3 实验平台,配备顶部/前置/腕部三路 RealSense D405。
团队在自研 6-DoF 协作臂上部署了两个组合操作任务:从布料堆中抽取单根布条(需要精细视觉辨别和一致的运动以避免缠绕),以及将积木插入紧配合卡槽(需要接触感知与平滑对准)。两项任务合计取得 9/10 的成功,末端轨迹的各阶差分曲线均明显干净于基线。
消融:为什么"训练时焊接"不可替代?
论文的消融实验系统地排除了各种"捷径"。推理时才加 overlap,重叠越大反而越差(O=8 时成功长度掉到 3.60)——因为模型没学过对齐,冗余预测互相冲突;Savitzky-Golay、Butterworth 等经典滤波器能磨平高阶抖动,却压不住接缝伪影(Bjump ≥ 0.228)和频谱混叠;超参数扫描确认 L=10、O=8 的配置在 3 Hz 以上高频能量抑制最好,且 ±100 ms 控制延迟下性能几乎无退化。
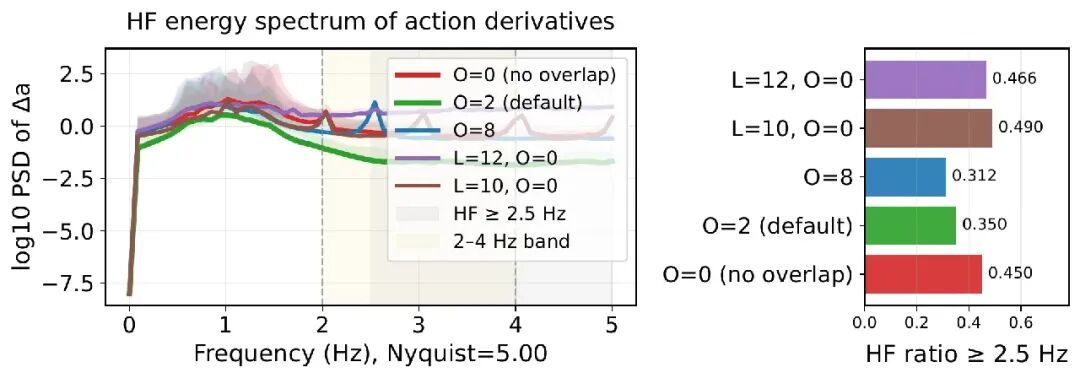 不同 overlap/chunk 长度下动作导数的功率谱密度。默认配置(L=10, O=8)在 3 Hz 以上保持低能量。
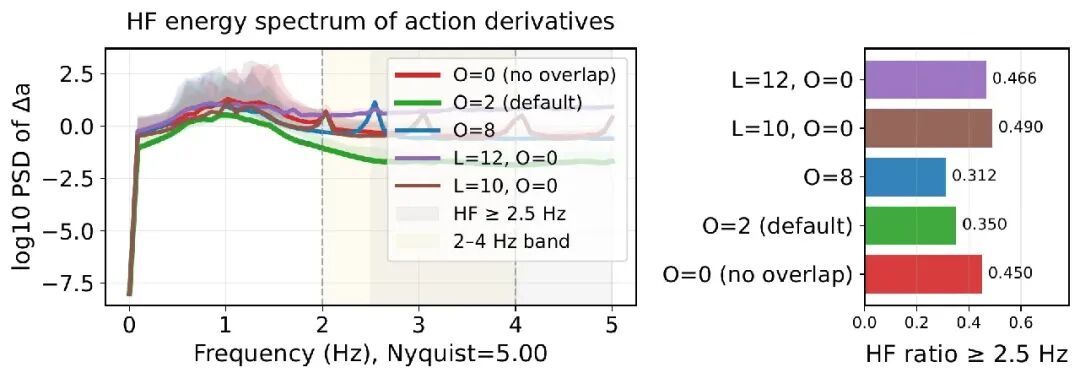
结论指向同一点:结构性的不连续,必须用结构性的训练来解决——事后去噪替代不了训练时的接缝监督。
四、总结
ChunkFlow 的贡献不在于又一个 VLA backbone,而在于回答了一个所有分块策略都绕不开的系统性问题:chunk 与 chunk 之间的接缝该由谁负责。它给出的答案是三位一体的:执行语义分区 + 零延迟确定性融合(执行层)、接缝与连续性联合正则(训练层)、保结构的优势加权微调(部署适配层),并配有接缝误差随重叠二次衰减的理论保证。
对于任何采用 action chunking 的 VLA 系统,这套方法即插即用、不改 backbone、不加推理开销——这可能是它最实用的地方。
团队介绍
本工作由 CyboPal Research Team 完成,团队来自西安交通大学人工智能与机器人研究所、人机混合增强智能全国重点实验室与江苏细胞壁智能科技有限公司,真机实验基于自研 Armigo-3 协作机械臂完成。团队近期量产的首款产品CyboPal ONE :https://cybopal\.com是全球首个**桌面级机器人**。
本文仅做学术分享,如有侵权,请联系删文。
原文链接: https://www.leiphone.com/category/private/ZQZ8eLy2OEqmMCWt.html
