


来源:PRML Research Group
原文链接:https://mp.weixin.qq.com/s/FHqth37DK0PvaLWGQvE3Sg?scene=1&click_id=72
在长程机器人操作领域,Vision-Language-Action(VLA)模型虽然展现了强大的潜力,但始终面临一个核心瓶颈:累积误差传播。随着任务步骤的增加,早期的微小偏差会不断放大,最终导致任务失败。这一限制很大程度上源于现有的静态特征融合机制。传统模型通常不考虑任务进度,在整个任务执行过程中无差别地学习对视觉、语言和动作表示等信息的注意力融合权重,无法根据任务执行的不同阶段(如精准定位、高层规划)来灵活调整对视觉、语言和动作表示的关注度。针对这一痛点,我们提出了S2-VLA框架,如图1所示。该框架通过引入状态空间引导的自适应注意机制(SSGAA),为机器人提供了一个能够随任务进度动态调整的“大脑”。
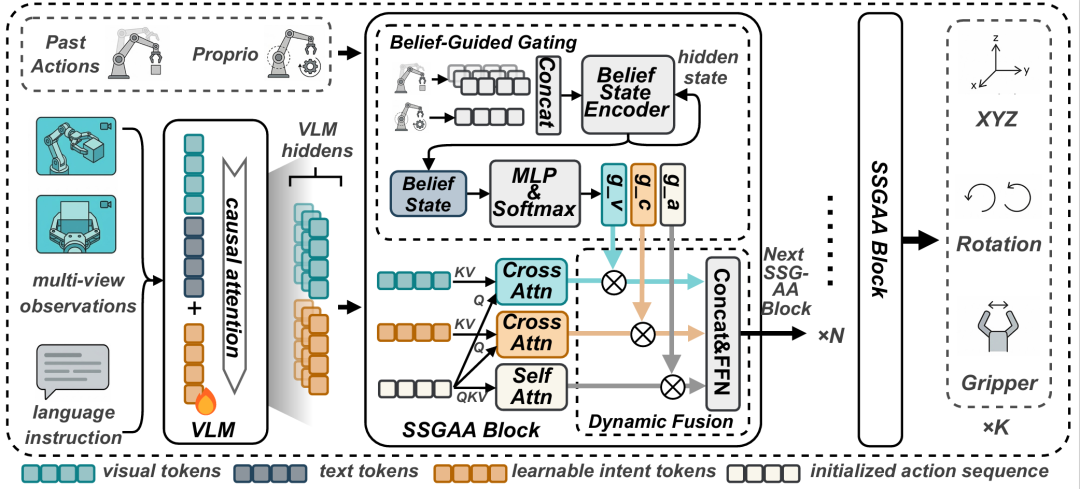
图1 S2-VLA框架图
在S2-VLA框架中,我们通过模型内部维护的一个紧凑隐含信念状态,实现了对当前执行进度与历史信息的递归汇总。这一机制使机器人能够敏锐地察觉自身所处的任务阶段,并具备检测执行偏差的能力。基于该信念状态,SSGAA模块能够动态生成门控权重,从而实时、精准地调节三类关键信息的融合配比,如图2所示。
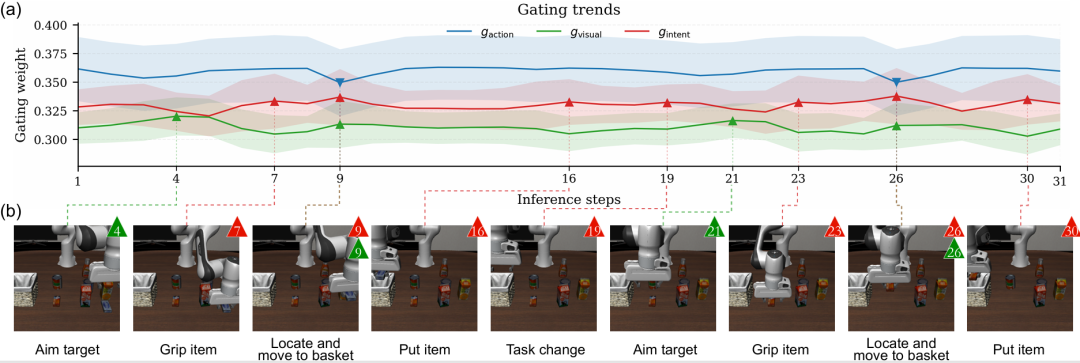
图2 可视化解释SSGAA模块
从图2的可视化结果中可以看出:在需要精准物体定位和空间对齐的阶段(如接近目标时),模型会自动提升低阶视觉权重的比例,以强化空间感知;在子任务切换或触发抓取、释放等关键决策点,模型则会显著加强对语义意图的理解,确保规划的准确性;而在长距离的稳态运动中,系统通过维持动作序列的权重来保证操作的连贯性与一致性。通过上述任务阶段引导的自适应权重调整,有效抑制了长程任务中的累积误差。
在实验评估方面,我们在LIBERO、SimplerEnv以及真实世界的ALOHA平台上进行了广泛验证,结果表明S2-VLA在多个维度上均实现了显著突破。首先,该模型成功刷新了SOTA记录,尽管其参数量仅为2B,但在LIBERO等基准测试中的成功率一致超越了众多7B规模的大模型,尤其在极具挑战性的LIBERO-Long任务中,更是取得了96.4%的成功率。其次,在真实世界的泛化表现上,S2-VLA在ALOHA双臂平台执行抓取、堆叠及餐具分发等复杂任务时展现出卓越的性能,证明了其强大的现实迁移能力。最后,在部署效率上,该模型展现了极高的实用价值,推理时仅需7GB显存,且吞吐量高达80.8Hz,在性能与速度上均显著优于OpenVLA-OFT等现有主流方法。S2-VLA真机ALOHA表现如图3所示,各项测试结果如表1和表2所示。
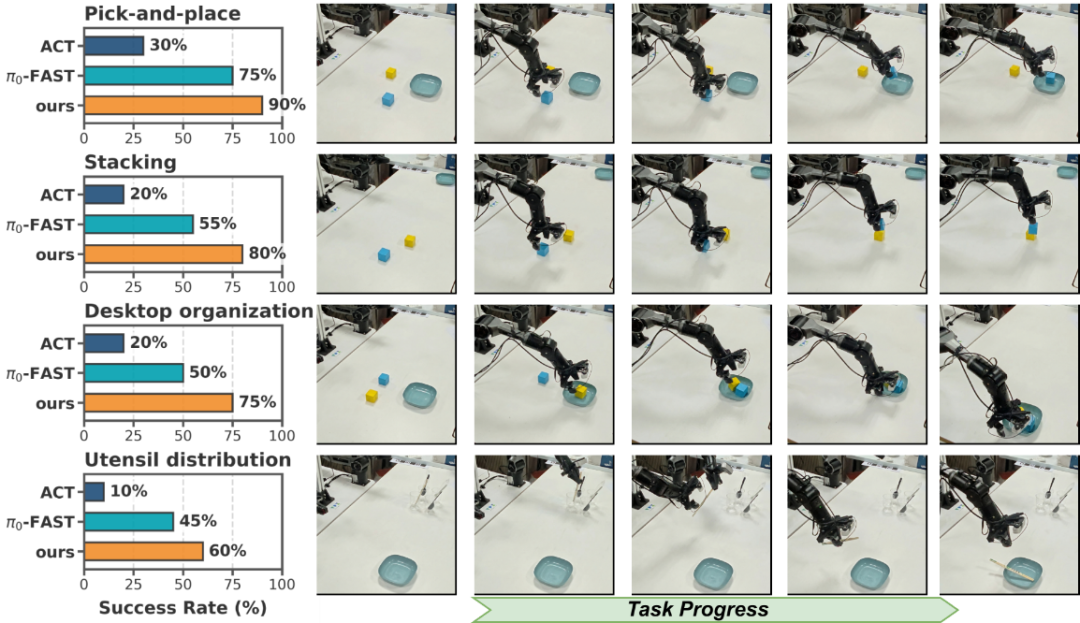
图3S2-VLA真机ALOHA表现
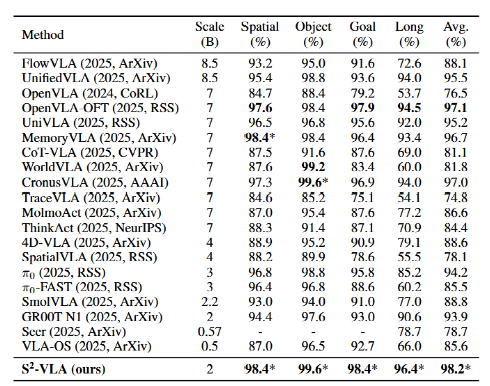
表1 S2-VLA在LIBERO Benchmark的表现
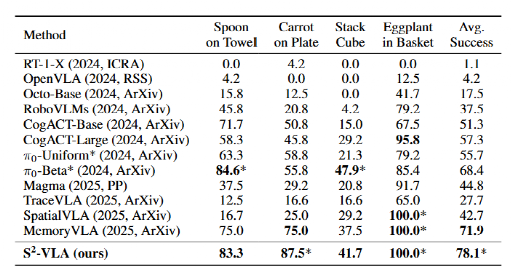
表2 S2-VLA 在SimplerEnv-Bridge的表现
整体而言,S2-VLA成功突破了静态融合方法的性能瓶颈,证明了相位感知能力在长程机器人任务中的关键作用。通过将大模型的语义能力与实时状态预测相结合,模型能更稳健地应对复杂环境下的误差积累问题。未来,我们将探索将这一核心思想扩展到扩散模型等不同生成框架中,进一步提升机器人的动作建模能力。
详见论文:
论文标题:S2-VLA: State-Space Guided Vision-Language-Action Models for Long-Horizon Manipulation
作者:Zhipeng Xie, Zongyi Han, Xiangyi Wei, Shiliang Sun, Yang Li, Jing Zhao
研究机构:华东师范大学、上海交通大学
